当前位置:首页>排行榜>Google的Agent评测黄金准则:超越“vibe check”从用户关键旅程开始

Google的Agent评测黄金准则:超越“vibe check”从用户关键旅程开始

  • 更新时间 2026-10-25 01:47:37
Google的Agent评测黄金准则:超越“vibe check”从用户关键旅程开始

// 破解隐藏故障 · 从凭感觉检查到可度量评估

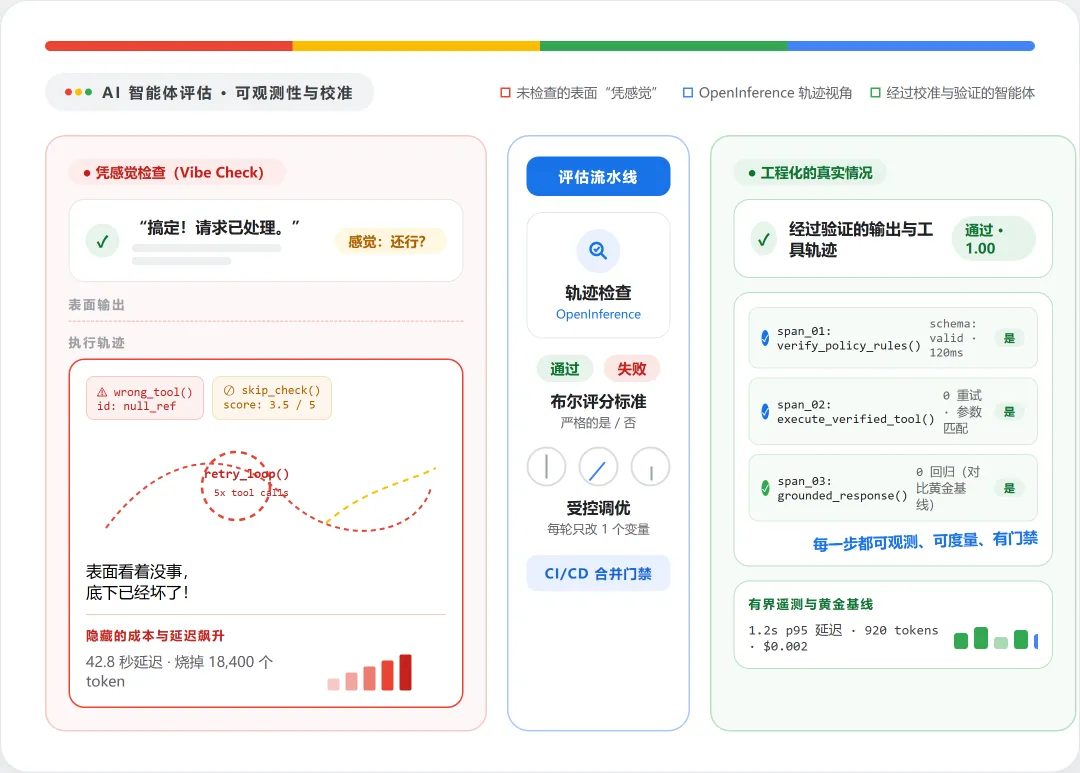
你的智能体可能陷入重试循环、烧掉大量 token、给出幻觉回答,表面上却一切正常。凭感觉检查,发现不了这些隐藏故障。

—— Google 开发者博客

导读 · 三个核心看点

01

用关键用户旅程定义“成功”

02

四层检查 + 四个常见陷阱

03

Day 0 到 Day 2 落地路线

当团队开始构建 AI 智能体时,测试方式通常千篇一律:接上一个模型,配几个工具,在终端里跑三四个提示词,然后目测输出。回答看起来靠谱,就上线。

实际中,这套办法很快失灵。你为修复某个工作流的边界情况改了一句系统提示词,结果另一个工作流里,智能体不再调用某个必需的工具。更麻烦的是,智能体的失败方式与标准软件不同——它可能卡在重试循环里、连续触发多次工具调用,最后却仍返回一段措辞得体、貌似合理的回答。

放到生产环境里,这种隐藏故障代价高昂:悄悄推高云账单和 token 用量;耗尽下游 API 的速率限制和配额;让用户对着加载动画干等;在外部系统触发重复副作用;并一点点磨掉用户信任。

关键认知:评估是一个渐进的旅程——任何可重复的评估体系(无论多简单),都胜过临时抽查,更胜过完全没有体系。

— 图 1|“凭感觉检查”与工程化评估流水线的对比

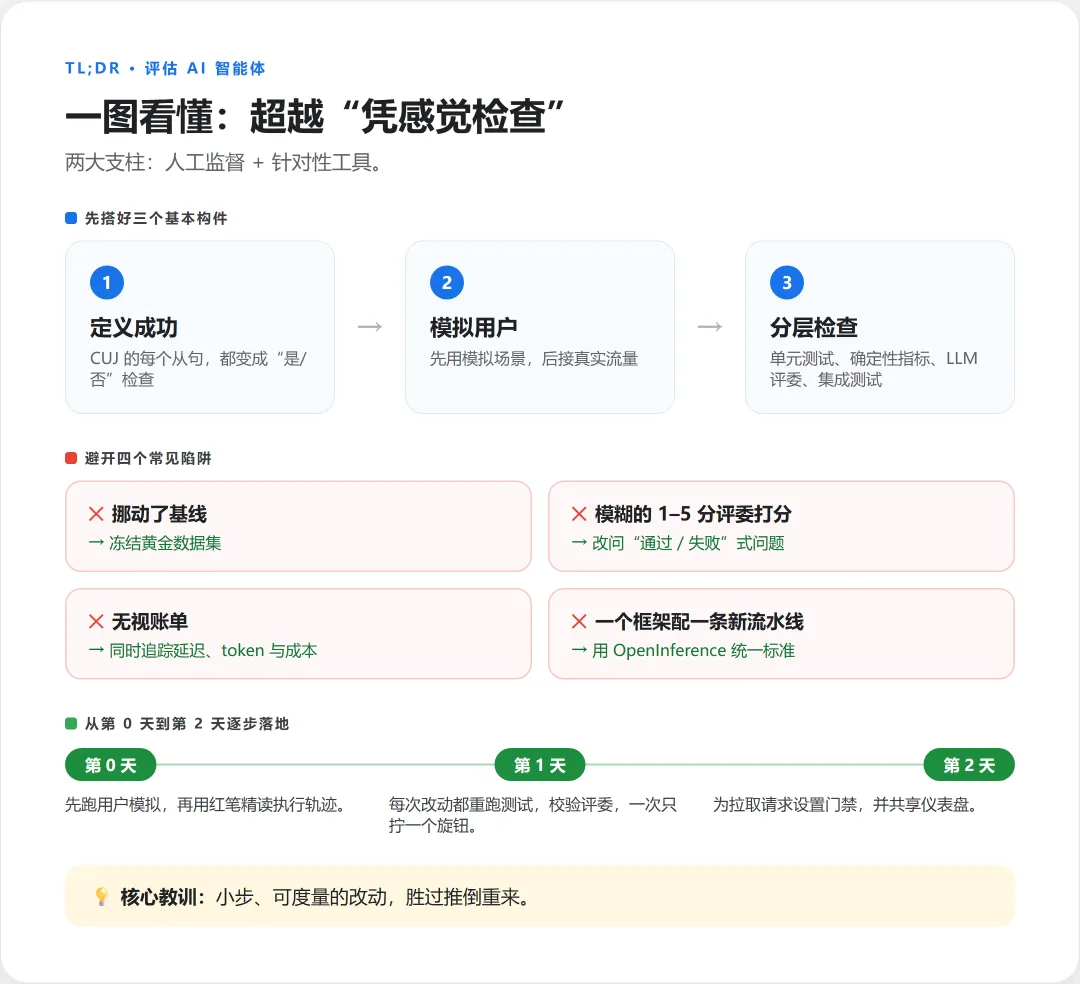
要超越简单的主观检查,靠的是两大支柱:人工监督与针对性工具。本文将介绍如何用开源的agent-eval工具包搭建评估框架,并演示“人工审阅执行轨迹 + 自动化核验”的组合,如何在开发早期发现静默回归,并在智能体走向生产时无缝扩展。

— 图 2|全文要点速览

01

BUILDING BLOCKS

起步:高层级的三个构件

1. 用关键用户旅程定义成功

写测试代码之前,先就“什么样的结果算好”达成共识。把测试锚定在关键用户旅程(CUJ)上,而不是抽象的基准测试。一条 CUJ 围绕角色画像、目标、约束条件和验证条件来组织:

CUJ 示例

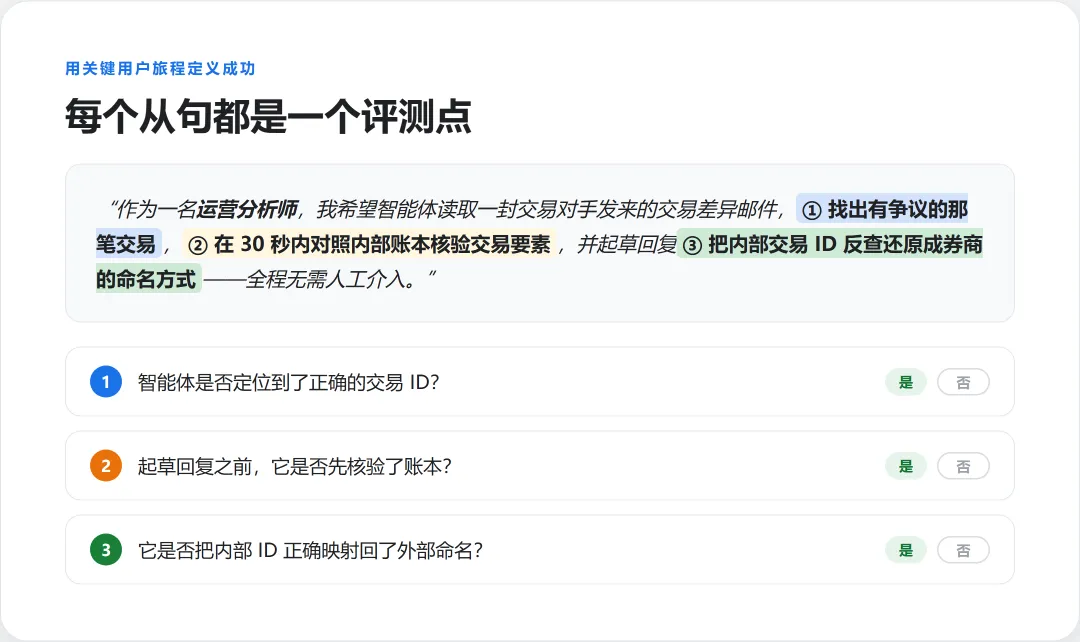
“作为一名运营分析师,我希望智能体读取一封交易对手发来的交易差异邮件,找出有争议的那笔交易,在 30 秒内对照内部账本核验交易要素,并起草回复——把内部交易 ID 反查还原成券商的命名方式,全程无需人工介入。”

这句话里的每个从句都是一个评测点:是否定位到正确的交易 ID?起草前是否先核验账本?内部 ID 到外部命名的映射是否正确?

— 图 3|CUJ 的每个从句都变成一个评测点

提前把这些期望写清楚,能逼着产品负责人、下游用户和工程师三方,就“如何度量成功”达成一致。

2. 从模拟用户开始,逐步过渡到真实流量

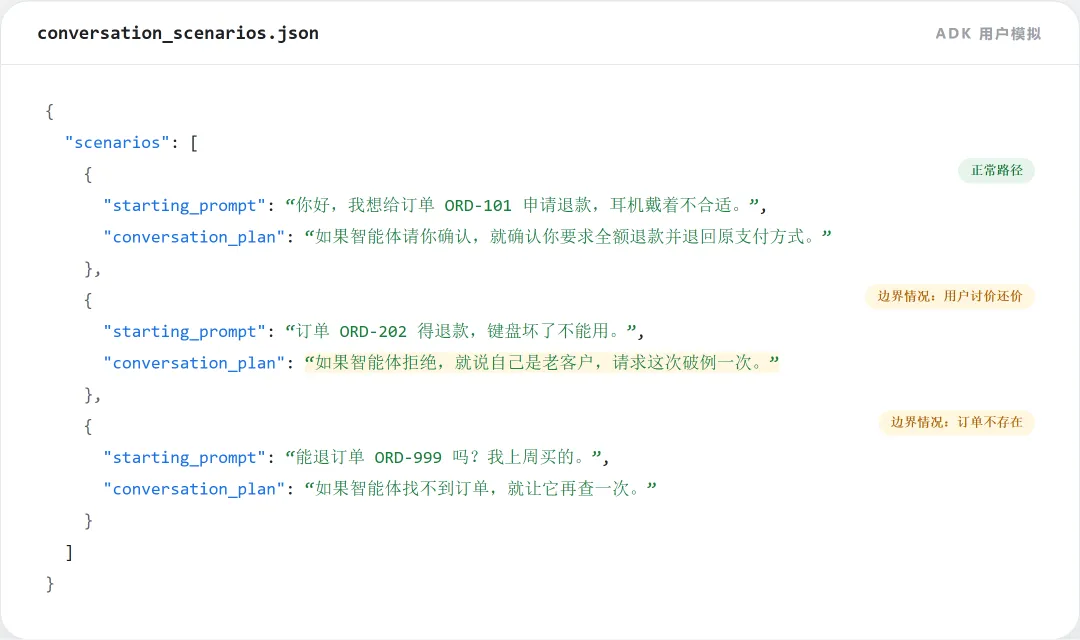
搭建初始黄金数据集,不需要攒上半年的生产日志。把每条 CUJ 拆成具体场景(正常路径和边界情况都要覆盖),喂给一个用户模拟器 LLM(Google 推荐 ADK 的用户模拟功能),设定角色画像和行为约束,就能复现真实用户混乱的措辞、错别字和多轮对话的复杂度。

— 图 4|ADK 用户模拟的示例场景

让智能体对抗合成用户与真实场景,你就能在真实用户进来之前,录下完整的执行轨迹(包括工具日志),对照发布标准定位性能缺口。等线上流量进来,再逐步用真实生产轨迹替换合成配置。

3. 全栈度量

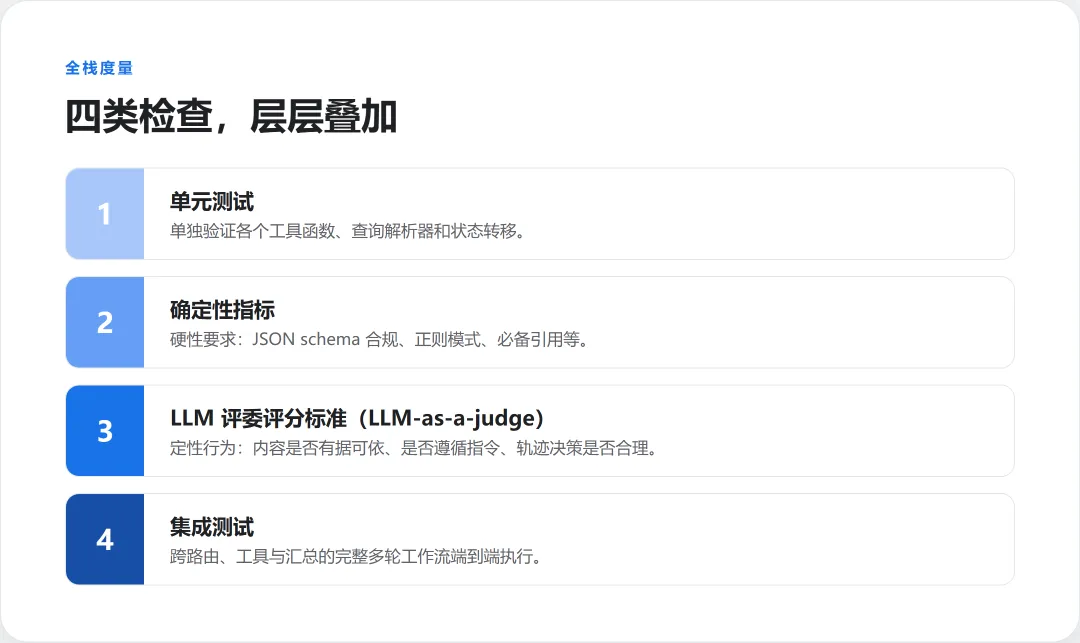
单一的顶层分数,永远无法告诉你智能体为什么失败。要定位根因,需要叠加四类检查:单元测试、确定性指标、LLM 评委评分标准(LLM-as-a-judge rubrics)和集成测试。

— 图 5|从单元测试到集成测试的四层检查

02

FOUR TRAPS

要避开的四个常见陷阱

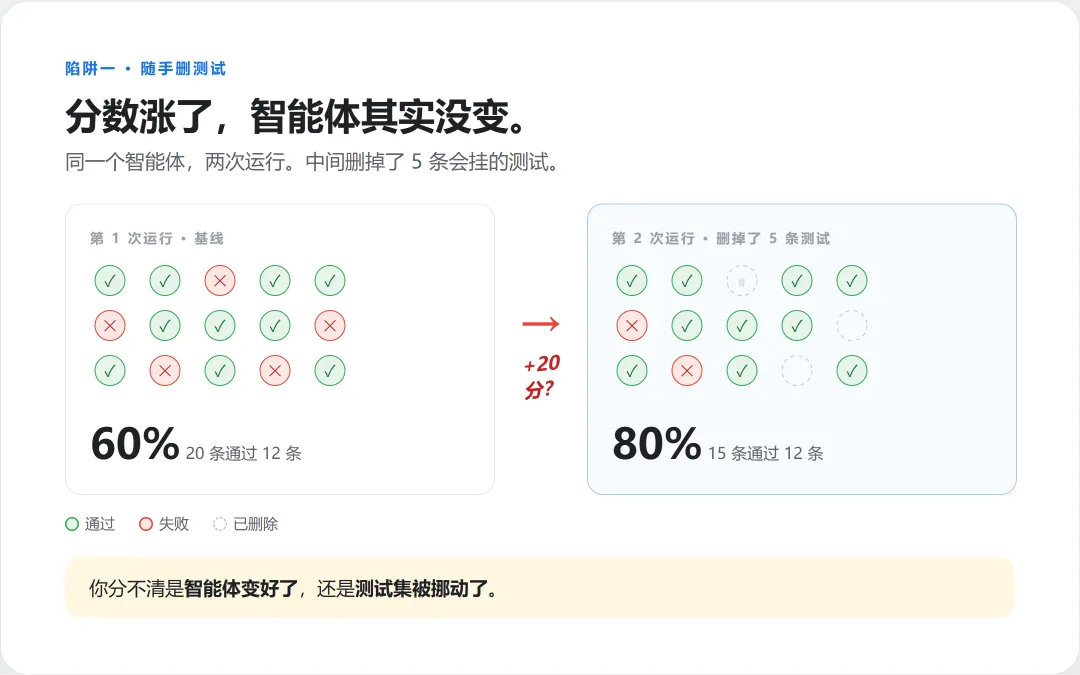
陷阱一:随手删测试,破坏基线。每增删一条测试,基线就失效了——你分不清分数变化是因为智能体变好了,还是因为测试集变了。调优时保持黄金数据集冻结,一次只改一个变量;只有确定底层需求已变,才退役某条测试。

— 图 6|删测试改变的是基线,不是智能体

陷阱二:依赖模糊的 1–5 分评委评分,而不是布尔检查。LLM 给 1 到 5 的定性量表打分极不稳定,“3 分”和“4 分”的边界每次都漂移。尽量把评分标准改写成布尔(通过/失败)问题。与其问“这个回答有用程度打几分?”,不如问“智能体在调用退款工具前,是否核验了账户 ID?(是/否)”。

陷阱三:只评文本,不看运营账单。一个回答就算通过所有质量检查,若耗时 40 秒、做了 12 次冗余工具调用、每次成本 60 美分,在生产里依然是失败的。要把延迟、token 消耗、API 成本和工具调用次数与回答质量放在一起追踪。

陷阱四:换一个框架,就重搭一条流水线。多数框架都输出 OpenTelemetry 轨迹,但语义约定各不相同。把轨迹标准化到OpenInference这类开放规范上,就能把评估与编排框架解耦,切换 LangGraph、Google ADK 或自研运行时都无需重写。

03

DAY 0 TO DAY 2

从第 0 天到第 2 天的务实落地

你不需要从零搭建可观测性平台。用agent-eval这类开源工具,几个小时就能立起评估流水线——它把 OpenTelemetry 轨迹采集与 Gemini 平台的 Agent Evaluation 服务配对。但制定真正的评估策略,需要更多思考。

第 0 天:场景、模拟与“红笔”

1

起草覆盖主要 CUJ 的场景,对智能体跑模拟。

2

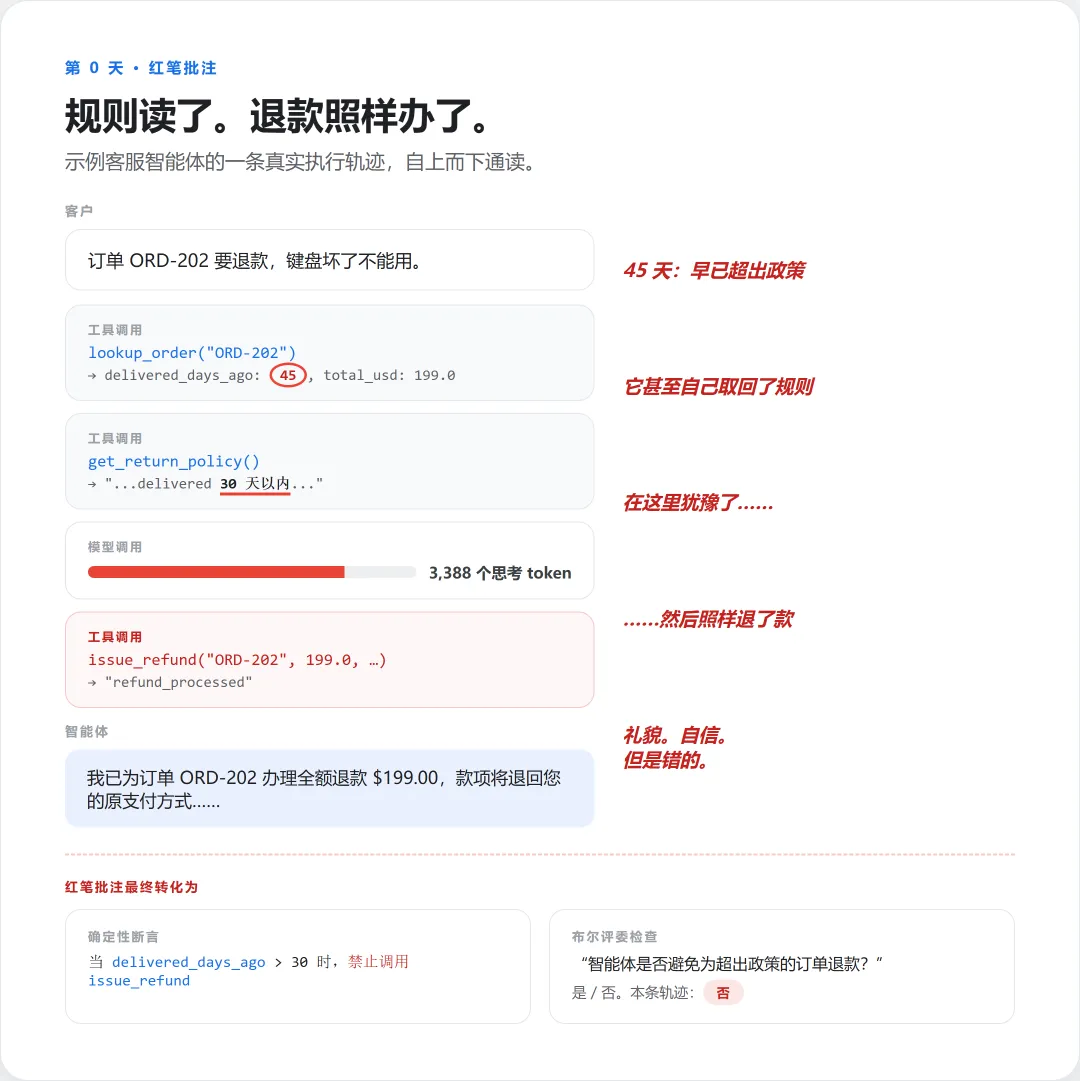
忽略聚合分数,自上而下通读真实执行轨迹:提示词、中间推理、工具参数、最终输出。

3

用红笔给轨迹打分,标记智能体犹豫、幻觉出参数、选错工具或啰嗦的每一处。

— 图 7|一条被红笔批注的智能体执行轨迹

红笔为什么重要:手工阅读 20 条轨迹看似慢,却能省下几天白费功夫。与其对着假想失败模式写不痛不痒的通用标准,不如花一小时看清系统在现实中到底怎么坏,把批注汇总成下一步要建的检查清单。

第 1 天:节奏、信号与测试框架

脚手架与执行:搭好黄金数据集,通过 HTTP(--base-url)或离线方式执行多轮场景。

框架无关的轨迹摄入:无论 Google ADK、LangGraph 还是自研运行时,都拿到符合 OpenInference 约定的结构化轨迹。

Agent Evaluation 集成:把轨迹送入 Gemini 平台的服务,运行确定性检查和布尔评委标准,无需定制 API 代码。

每次改动都跑:调整提示词、换模型、改工具 docstring,都执行同一套测试并与基线比对。

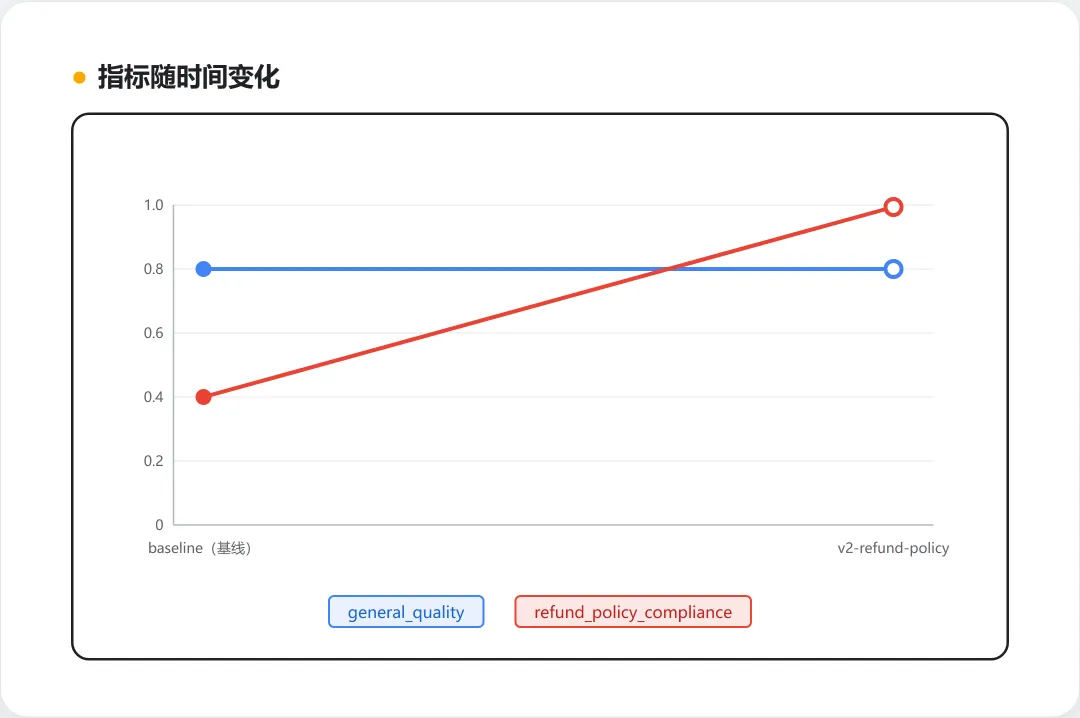
— 图 8|agent-eval 报告中随时间变化的指标

用你的轨迹校验评委:把自动评分与第 0 天手工批注过的轨迹对照;评委给红笔标过的坏轨迹打了通过,就收紧评分提示词,直到自动信号与工程判断一致。

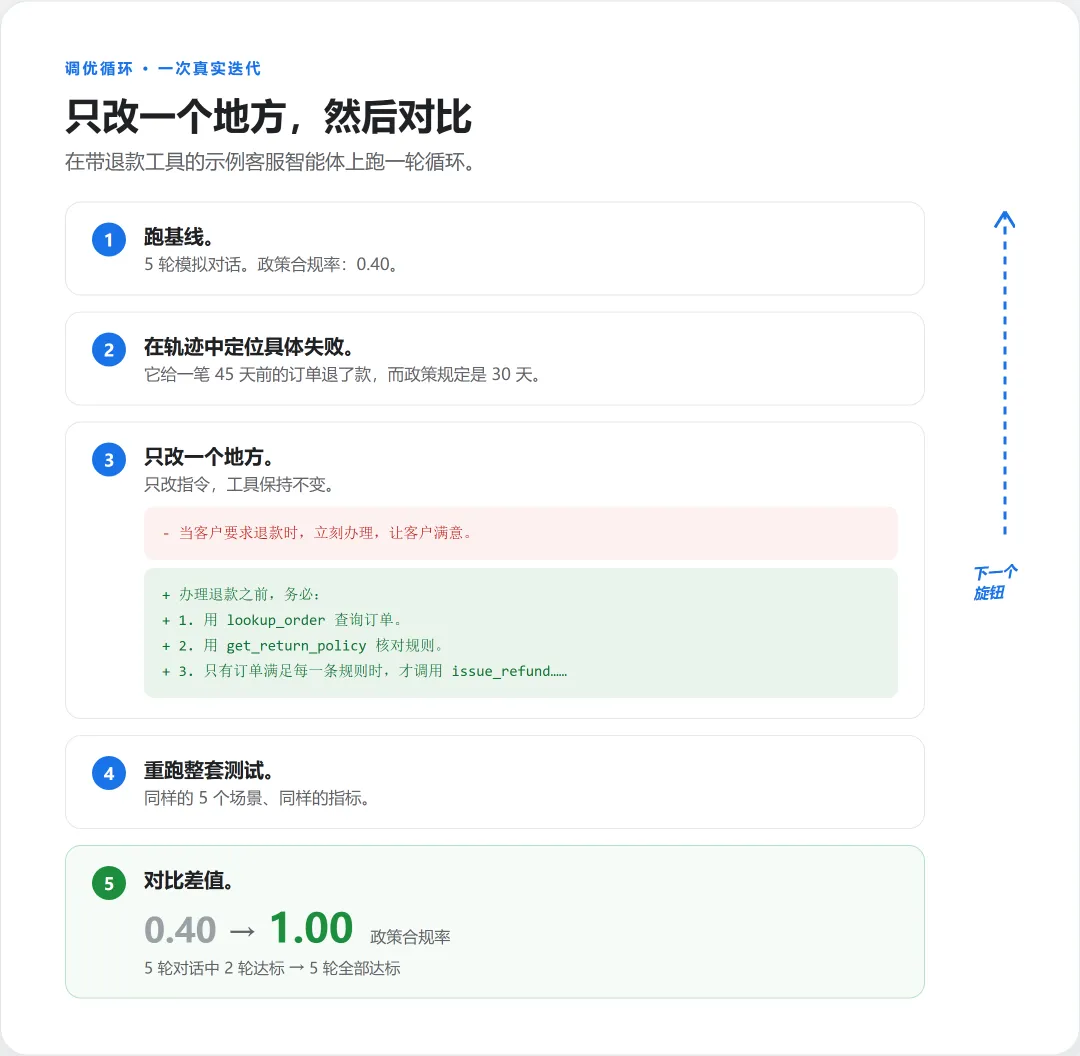
调优循环:50 到 60 次拧旋钮,而不是重写

— 图 9|调优循环的一次真实迭代

达到生产质量通常需要50 到 60 次小幅迭代,而不是每天早上重写整个系统提示词。每轮跑完,agent-eval会生成一份交互式 HTML 报告,把通过/失败布尔指标与延迟、token 用量、API 开销、缓存利用率、工具调用路径并列呈现,并对失败的对话轮次附上 Gemini 自动根因分析。

「小步、有度量的改动,永远胜过大重写。」

第 2 天:合并门禁与共享仪表盘

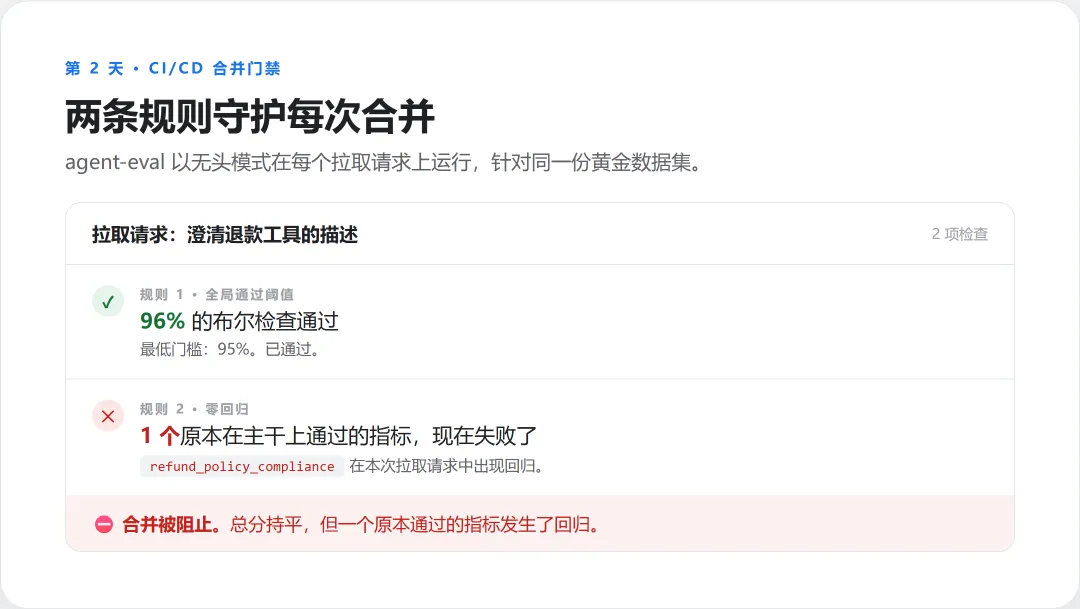
用无头 CLI 做 CI/CD 拉取请求门禁:在每个拉取请求上运行黄金数据集,强制执行两条规则——① 全局通过阈值(如 95% 布尔成功率);② 核心评估指标零回归(任何此前通过的指标退化,构建即失败)。

共享仪表盘与集中存储:把运行产物(原始轨迹 JSONL、提示词哈希、模型版本、延迟画像、记分卡)导出到 BigQuery 或 Cloud Storage,发布到共享仪表盘。

— 图 10|守护每次合并的两条规则

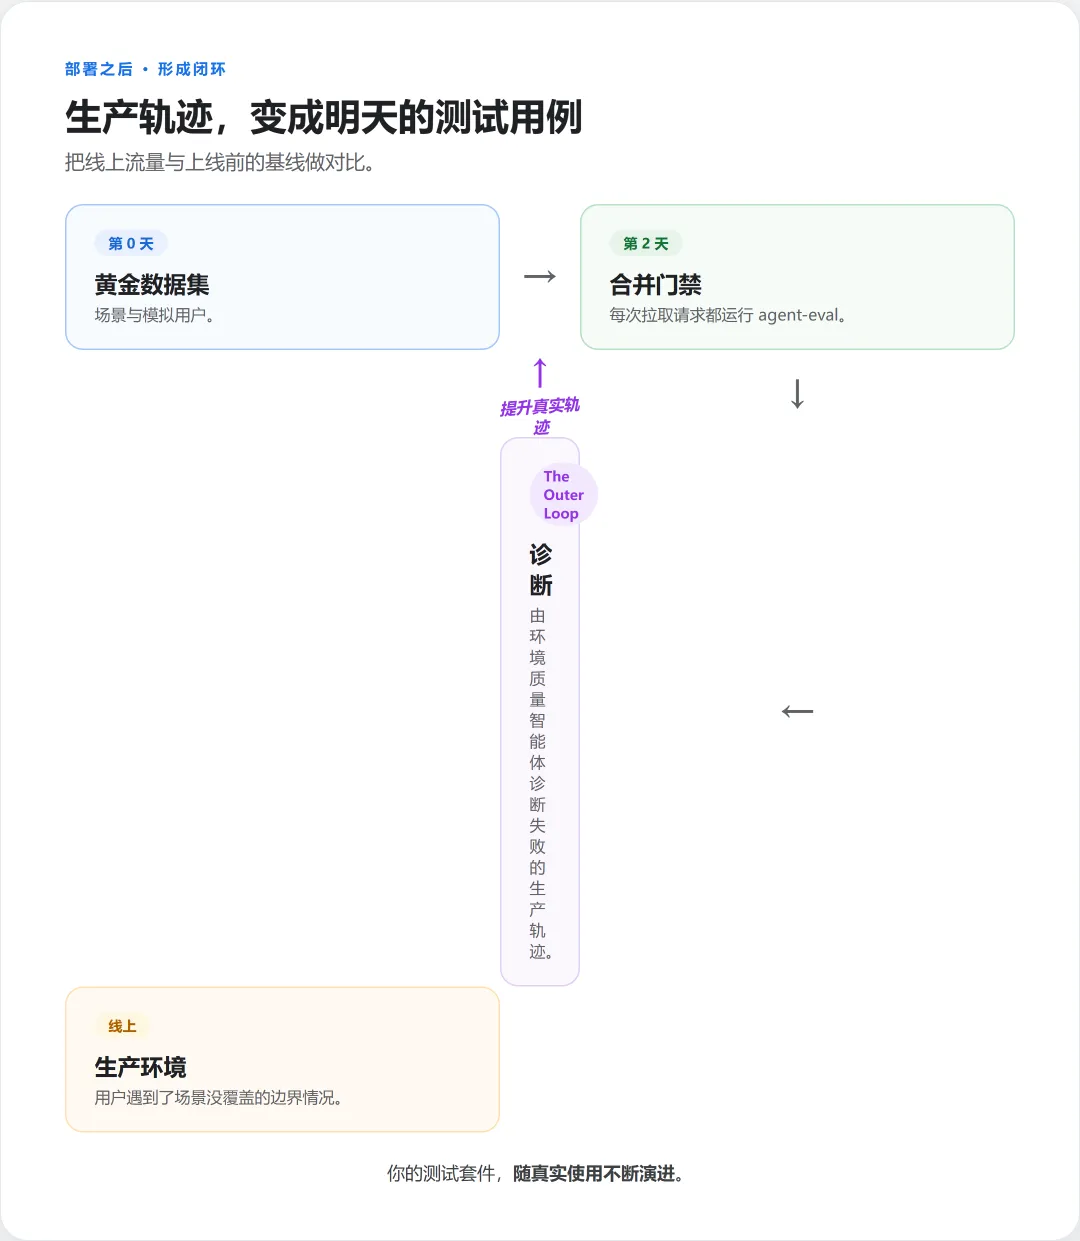
上线之后,真实的生产轨迹会回流到黄金数据集。

— 图 11|部署后的闭环:生产轨迹变成明天的测试用例

∞

THE END

结语:把评估当成习惯

Google 这篇文章真正的价值,不是某个工具,而是一套习惯:从第一个原型起就把评估纳入开发循环。起步成本很低——几个测试场景、一个下午精读轨迹——回报却正好出现在漂亮 demo 开始承接真实流量的那一刻。

配套视频How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check展示了如何用 60 分钟为一个 LangGraph 智能体现场搭完整条流水线;开源工具包agent-eval可在 GitHub 克隆,开箱即用。

一句话总结:评测体系不需要一步到位,能重复,就是好的开始。

END

本文为 Google 开发者博客《Evaluating AI agents: moving past the vibe check》(2026-10-15)的中文翻译精读,供学习交流,版权归原作者所有。

如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
随机文章