【全模态评测】腾讯混元推出Triad,揭示全模态大模型「逐题答对」却在「看场景」上远逊人类
- 更新时间 2026-10-25 01:44:40
【全模态评测】腾讯混元推出Triad,揭示全模态大模型「逐题答对」却在「看场景」上远逊人类
把文本、图像、音频**同时**给模型,它能把题目答对;但只要把问题从「这一题」换成「这一场景下的所有题」,它的表现就断崖式下跌。这篇 NeurIPS 2026 论文用 327 道手工题、14 个全模态系统,系统性地量出了这个落差。
论文:Triad: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models
机构:腾讯混元、北京大学
会议:NeurIPS 2026 评测与数据集(Evaluations and Datasets)Track
论文:https://arxiv.org/abs/2610.30841
现有 benchmark 测的是「已确定的输入」
自然交流里,歧义是常态:一句话、一张图、一段声音,单独看往往都是未充分指定的,要等到其他通道的证据进来,含义才收窄。作者指出,当前的多模态 benchmark 大多测的是感知、识别,或在已经确定的输入上做推理——于是留下一个空白:全模态大模型能否消解分布在不同模态上的歧义?
Triad 就是为填这个空白设计的。它的每一项是一个 「文本—图像—音频」三元组,配一个问题与一组选项。构造方式非常考究:完整三元组能确定唯一答案,而任意拿掉一个模态,一致选项集就不再唯一。
规模上:Triad 含 327 道手工编写的查询,归入 86 个场景组(scene groups),覆盖跨三种模态的 18 个歧义类别。评测了 14 个全模态系统。
方法(一):用「互为消歧」把「必须三个通道一起用」写成硬条件
先形式化。每项查询是一个元组:
x = ( 𝒞, ℐ, 𝒜, 𝒬, 𝒴 )
其中 𝒞 是文本上下文,ℐ 是图像,𝒜 是音频片段,𝒬 是问题,𝒴 是有限选项集且 |𝒴| ≥ 2。模型要选出意图答案 y* ∈ 𝒴。
Triad 刻意不奖励「靠一个主导通道识别出答案」。它的构造要求是:每个模态都在收窄合理答案的集合,但任何两模态视角都不充分。文本可以留着指代不明确,图像可以限定场景却不锁定意图解读,音频可以提供韵律、说话人线索、语音证据或环境上下文来改变读法——只有三者合起来,答案才唯一。
这被写成一个定义。记三种模态集合 ℳ = { 𝒯, 𝒱, 𝒜 }。对子集 S ⊆ ℳ,令 x_S 为只保留 S 中模态的输入,并令:
𝒴_S(x) = { y ∈ 𝒴 : y 与 x_S 一致 }
定义 1(良置的三模态消歧):一个查询 x 是良置的(well posed),当且仅当完整三元组恰好确定一个答案,而每一个严格的两模态视角都仍不唯一:
| 𝒴_ℳ(x) | = 1
∀ S ⊂ ℳ, |S| = 2 : | 𝒴_S(x) | > 1
两个条件各司其职:第一条排除欠定样本——完整输入必须支持唯一标注答案;第二条排除可归约样本——如果「文本+图像」或「文本+音频」或「图像+音频」已经能定位答案,那这项就测不到三模态消歧。
论文特意澄清了一个容易误读的点:这个判据是关于「选项集」的,而不是关于「每个模态单独看是否明显歧义」的。一个模态可以局部看很清晰,却仍然必需——因为它排除了另外两个模态留下的某个选项。 这纠正了一种过于直观但错误的构造思路。
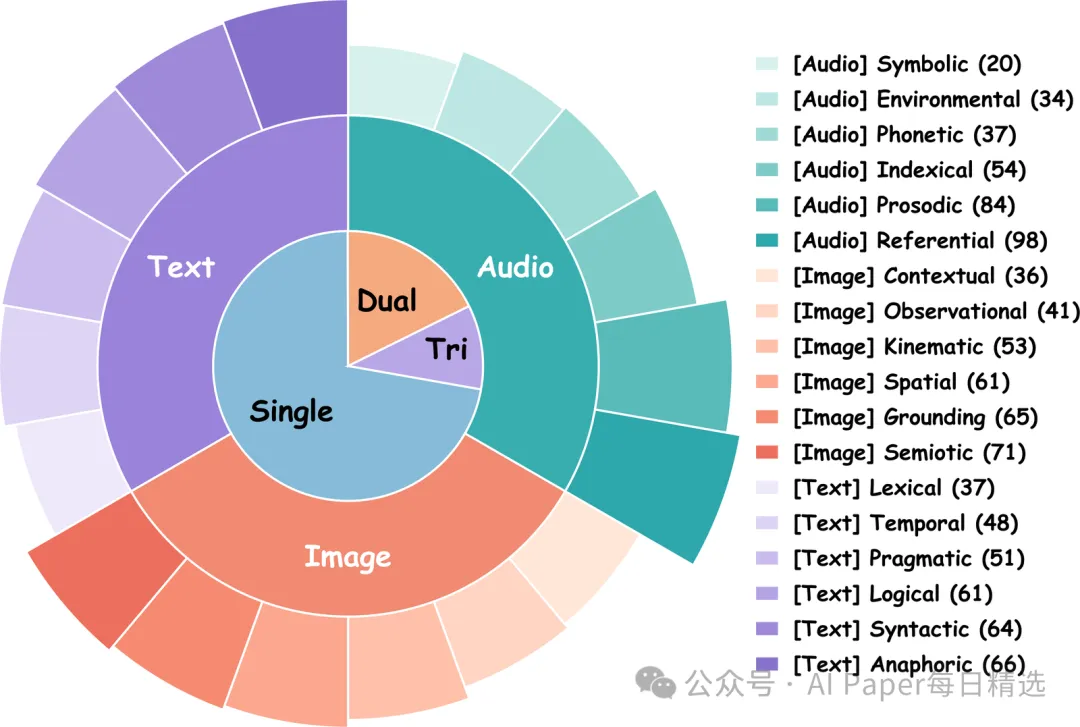
方法(二):18 类歧义taxonomy + 场景组评测协议
Triad 用一套 18 类歧义分类(taxonomy)来描述歧义从哪里进入样本,并支撑评测后的错误分析。分类在六个叶类别上展开,覆盖三种模态。
评测协议的关键是组级(group-wise):86 个场景组意味着同一场景下有多道题。这个设计直接引出了论文最重要的那个发现——见下。
发布样本还经过五标注者子集清单检查;附录 D 给出了供未来扩展使用的参考检查器。
实验结果:逐题强 ≠ 场景稳健,最强者仍落后人类 20 分以上
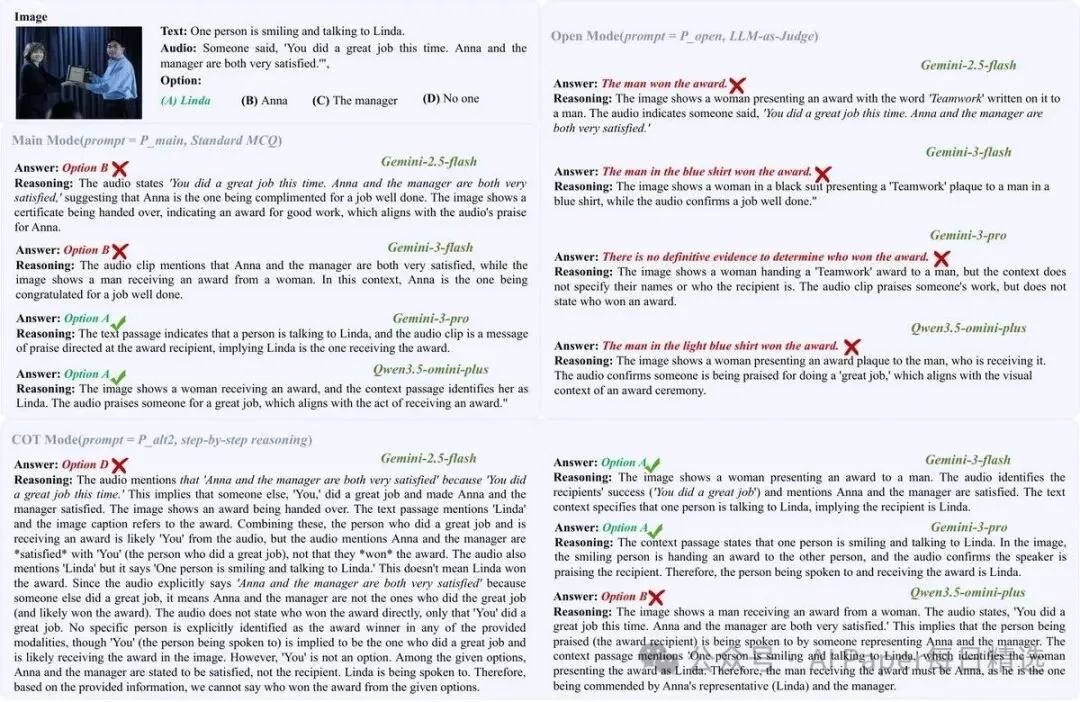
第一组结论就很有冲击力:强逐题表现并不能转化为稳健的场景级消歧——最好的模型在组准确率(group accuracy)上仍然落后人类 20 分以上。
第二组结论更狠:把选项去掉(开放式回答),差距进一步拉大,模型的组准确率掉到个位数,而人类依然稳健。
第三组是机制诊断。论文做了留一法(leave-one-out)与转写/描述反事实(transcript/description counterfactuals),结论是:当文本和图像都在场时,当前系统常常没有充分利用音频线索。 这解释了为什么它们在「必须靠音频收窄」的样本上吃亏。
定位与边界:它测的是「该不该用三通道」,不是「三通道融合得好不好」
把 Triad 放回多模态评测的谱系里,能看清它的位置与边界。
它测的问题很窄但很关键:给定一个「必须同时用三个通道才能定型」的样本,模型能否真的把三个通道都用上。 这个「必须」不是靠人工声称,而是由定义 1 的两条不等式强制的——完整三元组唯一确定答案,任意两模态视角都不唯一。于是每一道通过的题,都是一次受控的通道必要性测试。
要留意它的边界:Triad 衡量的是消歧结果,不是融合机制。也就是说,一个模型即便内部并没有显式的跨模态对齐结构,只要最终选对了答案,在这套协议下就算通过。反过来,如果模型选错了,Triad 的留一法与转写/描述反事实能指认出「哪个通道没被用上」,但它并不直接告诉你模型内部是怎么整合的。
这恰好解释了论文那两个看似矛盾的现象:逐题准确率可以很高,组级却大幅落后人类。因为逐题答对可能靠单通道的强识别能力或选项分布的先验;而组级要求的是在同一场景的多个样本上保持一致的三通道使用——一旦某个场景的若干题分别依赖不同的主导通道,靠「抓最强那一个通道」的策略就会崩。
对 benchmark 设计的启示也很直接:「多模态」不等于「必须多模态」。如果构造时不做必要性约束,题目很容易退化成「文本题 + 一张配图」或「图像题 + 一段配音」,测出来的是单通道能力而非融合能力。Triad 用选项集把这条红线写成了可验证的条件——这大概是它作为一份 benchmark 论文最可复用的部分。
为什么重要:把评测从「题」升级到「场景」
Triad 最有价值的地方,是把「歧义」从一个修辞性的说法变成了可计算、可判定的构造条件。
定义 1 的两条不等式,本质上是在说:通过的样本必须真的需要三个通道。这直接封死了 benchmark 里最常见的注水方式——那些「看起来是多模态,其实单通道就能答」的题目。评测结果是可验证的:任意两模态视角都不唯一,是可以用选项集算出来的。
而「逐题强 / 场景弱的落差」这个发现,指向一个更深的问题:模型很可能在做逐题的模式匹配,而不是在构建一个跨模态一致的场景理解。 这也和「音频线索未被充分利用」的诊断互相印证——如果一个系统真的在做通道间的证据融合,它不该忽略掉那个决定性的音频。
对做全模态模型的团队,这是一份相当具体的体检报告:逐题准确率会系统性高估真实的消歧能力,值得补一组场景级指标进去。
---
更多更全的Arxiv论文、直播、求职信息,关注[大模型技术]知识星球
点击小程序链接加入:大模型技术知识星球
欢迎关注我们的公众号【大模型技术】,每日AI相关新闻推送、arxiv论文分享
