1.摘要
当编程Agent从一次性答题走向数小时甚至全天运行,Token流量和API成本会快速放大。SoL-Pi把“优化Agent Harness”本身变成自动研究任务,在多种可执行环境中提出、验证并冻结可复用机制。
完整方案在EdgeBench上将Token流量降低44.7%–49.0%、API成本降低约三分之一,同时明确承认效率版本会牺牲少量任务得分。
论文标题:SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harne
作者:Haozhe Liu、Tian Ye、Sensen Gao 等
发布时间: 2026 年 9 月 20 日
论文地址:https://arxiv.org/abs/2609.20519
2. 引言:Agent运行越久,最贵的不一定是答案
传统代码补全只进行有限次数的前向计算;无人值守的编程Agent会不断读文件、执行命令、检查日志、修改代码,再把越来越长的历史重新送入模型。此时,缓存读取、重复观察和过细的动作调用会成为主要成本。
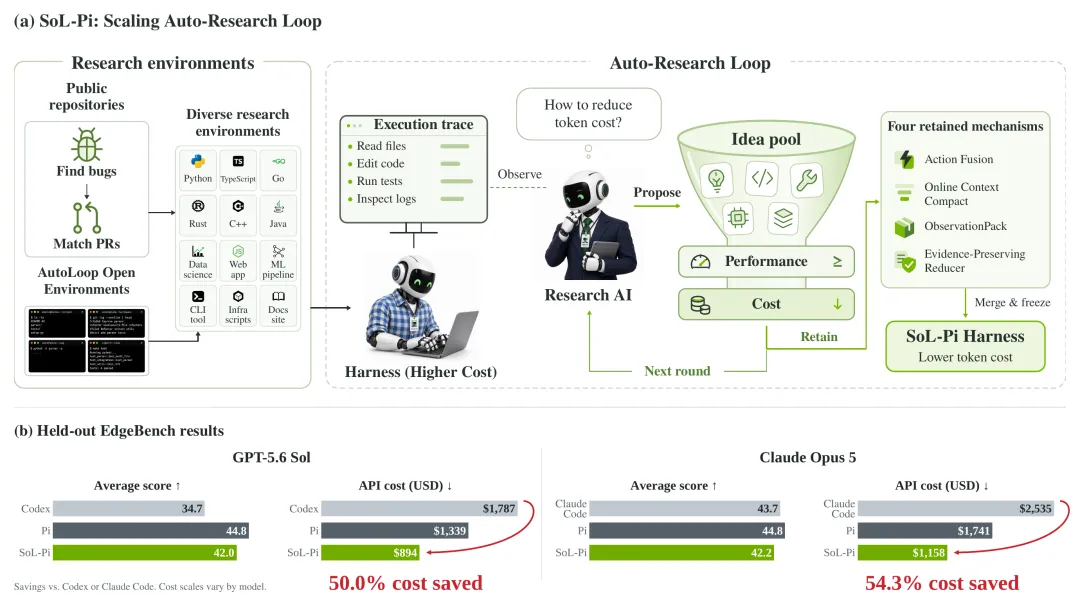
论文提出一个递归自改进思路:让研究Agent观察Harness轨迹,提出降低Token成本的机制,在开发环境中运行候选版本,只有同时满足性能容差和效率改进的方案才保留。最终得到的SoL-Pi并不是新底座模型,而是一组覆盖动作执行、上下文压缩、观察处理和委托阅读的Harness机制。
图1|系统从大量代码与可验证任务环境出发,通过自动研究漏斗筛选机制,冻结后再进入与搜索隔离的EdgeBench评测
3. 方法:搜索和最终评测必须隔离
候选机制来自六类方向:上下文、进度、工具、委托、提示与策略,以及改进流程自身。研究Agent先查看轨迹中的Token浪费或重复行为,再生成修改,运行开发任务并检查得分、成本和触发行为。对有潜力的分支继续细化,失败分支则停止。图2|轨迹驱动候选机制的提出与修订,最终评测结果不回流到搜索过程
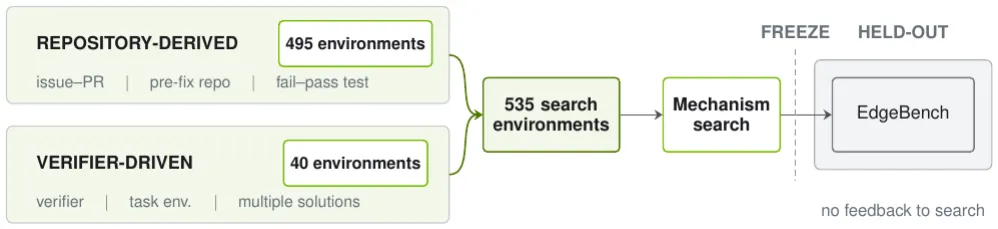
这里最关键的实验纪律是,EdgeBench不进入搜索循环。51个公开任务中,11个只用于冻结候选后的一次性接受判断,其余40个留给最终泛化评测。如果搜索过程中反复查看最终榜单,所谓“自动发现通用机制”很容易变成对测试集的自动过拟合。图3|搜索使用仓库修复与可执行验证任务,EdgeBench在方案冻结后才使用
2️⃣ 最终保留下来的四个机制
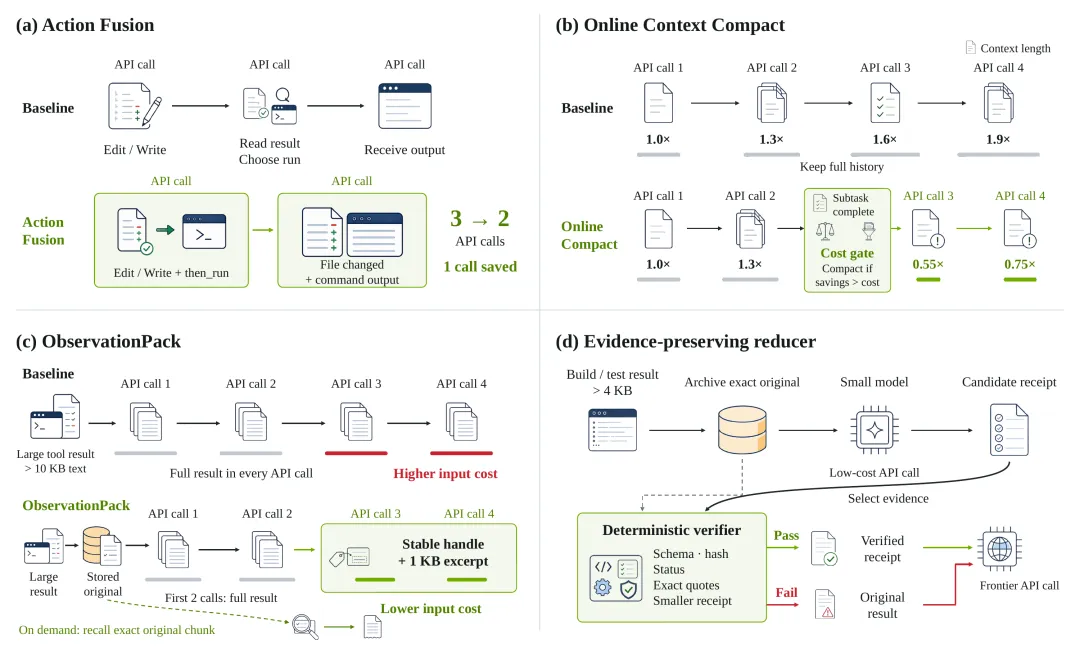
第一,Action Fusion允许文件修改工具附带一个后续命令,将两个相邻动作合并成一次交互。第二,Online Context Compact在计划步骤完成或接近窗口上限时,根据缓存改写成本决定是否压缩。第三,ObservationPack把大块观察写入本地,只向模型返回稳定句柄,需要时再精确读取。第四,Evidence-Preserving Reducer用较便宜的模型提取证据,并验证“收据”后再交给主Agent。
四个机制共同针对的不是模型推理深度,而是长轨迹中反复搬运、重复展示和动作过碎造成的系统性浪费。
4. 方法细读:递归搜索到底在优化什么
SoL-Pi把研究过程拆成“提出Harness修改—执行候选—根据结果继续搜索”的递归循环。候选不是直接修改被测任务答案,而是修改Agent如何分配子任务、共享上下文、合并行动或终止探索。为了避免研究循环记住最终测试,搜索阶段和保留评测严格分离;最终候选需要在未参与搜索的任务上重新运行,只有跨任务保持收益,才说明它改进的是Harness而不是某组样例。
Pi配置是基线递归循环,SoL进一步把目标写成两种明确偏好:Efficiency优先减少Token和成本,Performance优先提高任务分数。两者共享同一搜索机制,却选择不同的Pareto点。这种设计承认不存在5一个同时对所有用户最优的“自动研究Agent”:预算受限的批量任务与少量高价值难题,本来就应该采用不同候选。
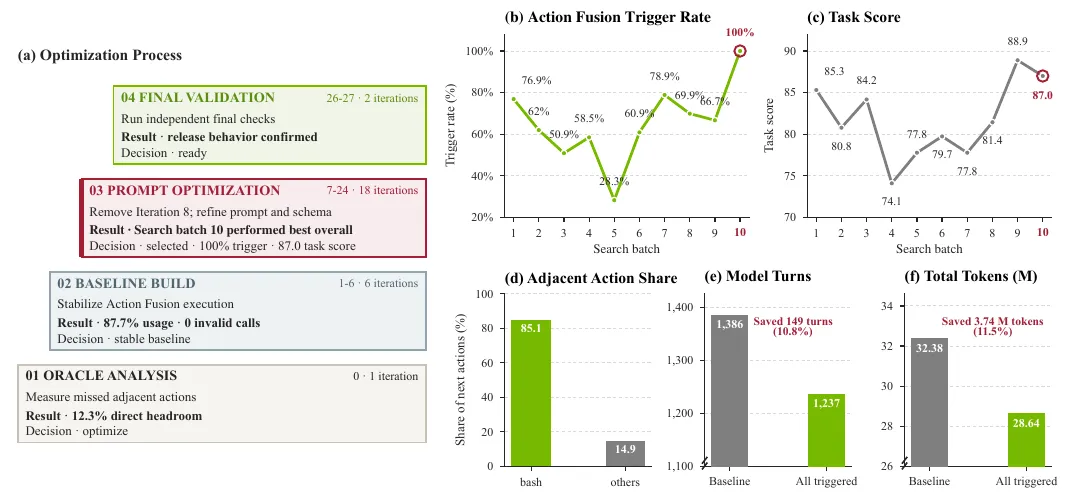
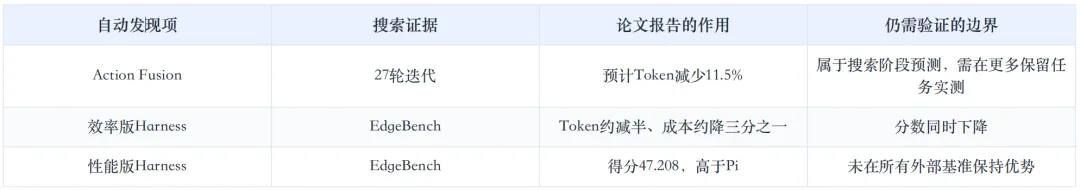
论文还让循环总结可复用行动模式。Action Fusion的发现来自27轮迭代:多个子Agent原本分别生成高度相似的动作,系统尝试在共享前缀处合并,再把结果反馈给后续Agent。作者估计该机制可降低11.5%的Token,但这属于搜索过程中的预测收益,必须与最终基准实测区分。
每轮搜索还需要保留失败记录,而不能只保存胜者。否则系统会反复提出已验证无效的并行规模、上下文共享或终止条件。候选比较也必须固定模型版本、任务集合与计价口径;当API价格或缓存折扣变化时,“成本最优”Harness可能随之变化。论文得到的是特定运行环境下的策略,而非脱离计费与执行器的永久规则。
Action Fusion针对的是交互轮次:当文件修改后几乎必然要立刻运行测试或检查,它允许修改工具附带一个后续命令,减少模型再次读取上下文、再发起一轮调用的成本。Online Context Compact针对的是前缀重复:系统不按固定轮数粗暴总结,而是在计划阶段完成或窗口压力增大时,结合缓存改写成本决定是否压缩。
ObservationPack处理超大观察。长日志、文件内容或测试输出先落到本地,主上下文只保留稳定句柄和精简索引;后续需要证据时可以精确读取相关片段。Evidence-Preserving Reducer则把“阅读大量材料”委托给便宜模型,但要求输出可核验的证据收据,主Agent可以回到原内容检查,而不是只接收一段无法追溯的摘要。
这四个机制看似都在省Token,作用位置却不同:动作融合减少轮次,在线压缩减少重复前缀,观察打包减少单次回传体积,证据归约减少昂贵模型阅读量。完整堆叠能够继续降Token,正是因为它们覆盖的是长轨迹中不同的成本来源,而非四次重复做同一件事。
2️⃣ 自动研究不是一次生成代码,而是一条保留谱系
Action Fusion的发现过程记录了27次迭代,依次经历机会分析、基线构建、提示与工具Schema优化、留出验证。最初的“只在提示里要求模型合并动作”触发并不稳定,于是研究Agent修改了工具接口,让融合动作成为明确可调用能力,并把无效调用、触发率与端到端得分一起纳入接受条件。
预分析估计,如果相邻动作都能触发融合,可减少约11.5%的Token。但候选不能只凭理论估计进入最终系统:它必须在开发任务中真实触发、不破坏执行语义,并通过被冻结后的留出任务。这个案例说明自动研究真正需要的是可执行环境、明确验证器和失败分支管理;若只让模型阅读轨迹后“提出建议”,得到的仍只是灵感,不是经过实验保留的机制。
3️⃣ 自动发现过程:Action Fusion如何被留下
Action Fusion的谱系包含27次迭代。轨迹分析先发现相邻动作频繁出现,并估计若全部触发可减少11.5%的Token;仅靠提示让Agent主动合并并不稳定,于是研究Agent修改工具Schema,直接暴露可融合动作,再用触发率与任务分数共同筛选。
图5|候选机制经历机会识别、接口稳定、提示优化和留出验证,触发率成为除最终得分之外的中间指标
这说明自动研究不仅可以搜索提示文本,也可以形成面向特定机制的新诊断指标。不过,论文对完整堆叠中“机制互补”的判断主要来自各自触发子集上的描述性比较,并没有完全隔离所有交互项。
4️⃣ 讨论:这是高效Harness,不是免费的递归自进化
SoL-Pi的搜索后端主要是GPT-5.6 Sol,转移到Opus 5后部分机制触发更少。EdgeBench公开任务只有51项,Terminal-Bench还排除了GPU任务。价格换算依赖2026年8月17日的API定价,未来实际美元节省会变化。
更重要的是,搜索本身也要花成本;论文展示的是如何把搜索结果冻结为可复用机制,而不是证明自动研究循环已经能够无限改进自己。效率版在多个评测中牺牲了部分成绩,部署时仍需要给定明确的性能容差。
5. 实验结果
1️⃣ EdgeBench的效率版本与性能版本是两个点
论文没有把所有结果压成一个“更强”。它报告两个工作点:SoL-Pi [Efficiency]使用全部四个机制,追求Token效率;SoL-Pi [Performance]按模型选择单个得分最高的机制。
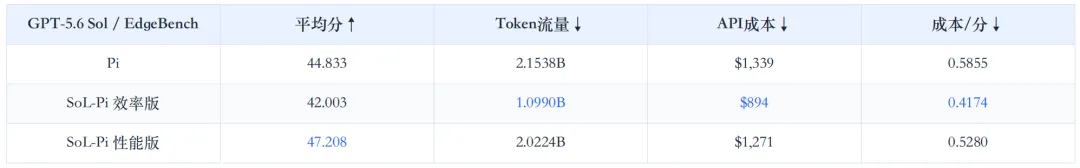
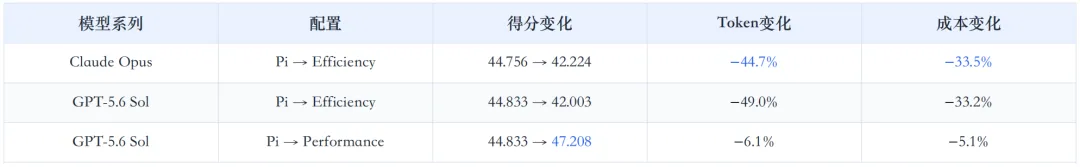
在GPT-5.6 Sol上,Pi的平均分为44.833,总Token流量2.1538B,API成本1339美元。效率版本得分42.003,保留Pi成绩的93.7%,但Token流量降至1.0990B,成本降至894美元。性能版本平均分47.208,比Pi提高5.3%,Token流量仍降低6.1%。
表1|根据论文EdgeBench主结果整理。效率版与性能版不是同一配置,不能合并成“既最高分又最低成本”
在未参与搜索的Opus 5上,效率版相对Pi将Token流量降低44.7%、成本降低33.5%,但平均分从44.756降到42.224。性能版采用Action Fusion,分数达到50.482。跨模型结果支持“机制可以迁移”的初步证据,但不支持“完整堆叠在所有模型上都同时提高分数”。
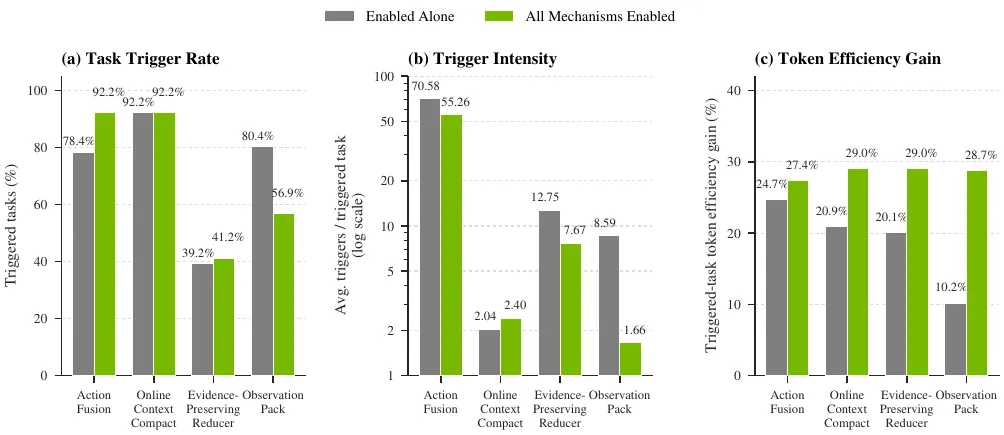
图4|单个机制与完整堆叠在不同后端上的触发和效率并不一致,说明Harness机制也存在模型依赖
2️⃣ EdgeBench之外更便宜,不一定解决更多
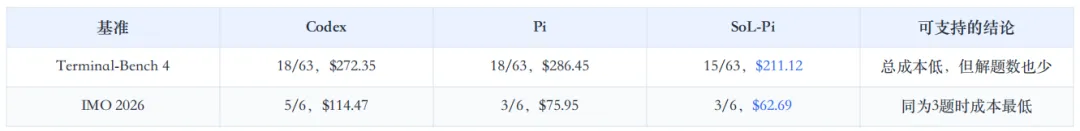
在Terminal-Bench 4的63个CPU任务上,Codex与Pi各解决18项,SoL-Pi解决15项。SoL-Pi总成本211.12美元,比Pi的286.45美元低26.3%;每个已解决任务成本14.07美元,也低于Pi的15.91美元。
IMO 2026形式化任务共6题,SoL-Pi通过3题,总成本62.69美元;Pi同样通过3题、成本75.95美元;Codex通过5题、成本114.47美元。这里的正确阅读方式是:SoL-Pi在通过数相同时更便宜,但不比Codex解决更多题。
表2|成本与完成数必须并列报告,不能只拿更低总成本宣称全面领先
6. 实验细读:效率前沿不等于绝对更强
EdgeBench上,GPT系列的Pi得分44.833,使用21.538亿Token、成本1339美元;Efficiency配置得分42.003,Token降至10.990亿、成本894美元;Performance配置得分47.208,Token20.224亿、成本1271美元。
Performance比Pi更高分且略省资源,而Efficiency接受约2.83分损失换取近一半Token。这三个点共同展示“自动研究”真正优化的是前沿,而不是单一冠军数字。
表3|依据论文跨模型效率前沿整理。Claude行与GPT行不是同一底座,适合看方向,不适合比较绝对分
表4|依据论文自动研究记录与最终评测整理,区分“搜索中发现”与“保留集结果”。
在Claude Opus设置中,效率版本相对Pi把Token减少44.7%、成本减少33.5%,得分从44.756降至42.224,进一步证明节省并非免费。跨基准结果更复杂:Terminal-Bench 4中Codex、Pi、SoL分别完成18、18、15项,成本272.35、286.45、211.12美元;IMO题中分别完成5、3、3项,成本114.47、75.95、62.69美元。SoL最低成本,却没有保持最高解题数。
因此论文支持的是“自动搜索可以找到更符合预算偏好的Harness”,而不是“递归Agent必然同时更便宜、更强”。搜索本身也消耗大量模型调用,只有当找到的策略被重复复用、后续任务数量足够大时,前期研究成本才可能摊薄。对于分布快速变化或一次性任务,人工配置可能仍更经济。
从统计解释看,完成题数差一两项时不能忽略样本量;同时,成本均值可能被少数超长失败轨迹拉高。实际复用前应同时查看逐任务成功、Token分布和提前终止比例。SoL-Pi提供了自动寻找候选的框架,却没有替代对候选行为的人工审计。
在GPT-5.6 Sol上,单独加入ObservationPack得到47.208分,是该后端的性能版;Action Fusion为46.664分,Online Context Compact把Token降到1.2881B但得分降至41.993。到了Opus 5,最优得分机制换成Action Fusion,达到50.482;ObservationPack则在成本效率上更突出。同一个Harness机制在不同后端上的触发频率与收益并不相同,因此性能版必须按后端选择,不能从一个模型直接复制答案。
机制在Opus上的触发率和触发强度普遍更低,这与搜索过程只使用GPT-5.6 Sol轨迹有关。好消息是,机制一旦触发,两个后端的Token效率都改善;限制则是当前证据尚不足以说明它们在更多模型上会主动、频繁且正确地使用。论文据此提出未来应进行多后端Harness训练,而不是把单后端自动研究结果当成通用接口标准。
2️⃣ 多Agent实验检验节省能否转化为更多搜索
论文还把SoL-Pi放入两小时内核优化任务。起始实现需要147734个模拟周期;单个Codex Agent最终做到1333周期、花费39.20美元,20个Pi工作者的群体做到1366周期、花费82.12美元,20个SoL-Pi工作者则做到1127周期、花费60.11美元。相对Pi群体,SoL-Pi群体成本低26.8%,最终候选也更快。群体并非20个Agent无组织并行:工作者被分为5组,每组4个,组内共享证据板,协调者跨组传播发现;只有不可变候选快照通过独立正确性验证,才会更新全局最佳。单Agent仍是最便宜的配置,因此实验不支持“群体总是更划算”。它支持的有限结论是:当任务本来就需要并行探索时,更省Token的Harness能让固定预算覆盖更多有效分支,并减少群体协作的成本浪费。
这组实验也把“便宜”拆成两层:单条轨迹减少重复上下文是一层,群体把节省下来的预算转成更多互补候选是另一层。若所有工作者重复同一思路,规模只会放大浪费;只有证据板、候选验证和跨组传播把发现去重后,Token节省才会表现为搜索覆盖提升。因此,多Agent收益不能只看工作者数量,还要看候选独立性与验证吞吐。
部署时还应保留机制级日志-Action Fusion是否实际触发、ObservationPack写入多少外部内容、压缩前后缓存前缀多大、归约证据能否被主Agent重新定位。没有这些记录,最终成本下降无法归因,也难以发现某个优化通过少读关键证据换取了表面节省。
此外,美元成本受模型单价、缓存折扣和输入输出计价比例影响,Token下降不一定等比例变成账单下降。复用论文结论时,应以本地价格重算每个Pareto点,而不是沿用一次实验中的美元数字。这也是成本结论可迁移的必要前提。
7. 结论
SoL-Pi把Agent优化的视角从“换更强模型”移到“减少长轨迹里的系统浪费”。它证明动作融合、分阶段压缩、外部观察存储和证据化摘要可以显著降低Token交通。
最值得借鉴的不是“一半Token”的单个数字,而是把性能版与效率版分开、把搜索集与最终评测隔离,并同时报告分数、流量和成本。只有这样,Agent Harness的自动进化才不会变成用测试集换来的漂亮故事。
一思维前沿灯塔系列聚焦大模型、多模态、具身智能、世界模型、3D 与 AI Agent 等多个AI主流方向,我们将持续更新各大顶会前沿论文。通过对顶会论文的深度解读,辅助每位学术研究者能针对性阅读到各类有益的学术论文,加强每个子领域的生态化,也希望大家每天能抽出几分钟时间阅读,感谢大家的支持与关注。
为方便大家学习交流建立了CCF/SCI投稿交流群,欢迎大家一起交流学习~
一思维为方便大家赶DDL不忘记时间研发了AcceptDDL小程序