很多品牌第一次想搞清楚"我们在 AI 那里到底什么情况",做法都差不多:
打开 DeepSeek 或豆包,问一句"某某类产品哪家好",看到答案里没有自己,心里一沉,截个图发到群里:完了,AI 不推荐我们。
过两天不甘心,又换个说法问了一次,这次居然提到了,于是松了口气:好像也还行。
问题是,这一忧一喜之间,没有任何一个结论是站得住脚的。手动截图测出来的"AI 可见度",往往和真实情况差得很远。这篇聊聊为什么,以及怎样测才靠谱。
一、一次截图,只是一个瞬间的切片
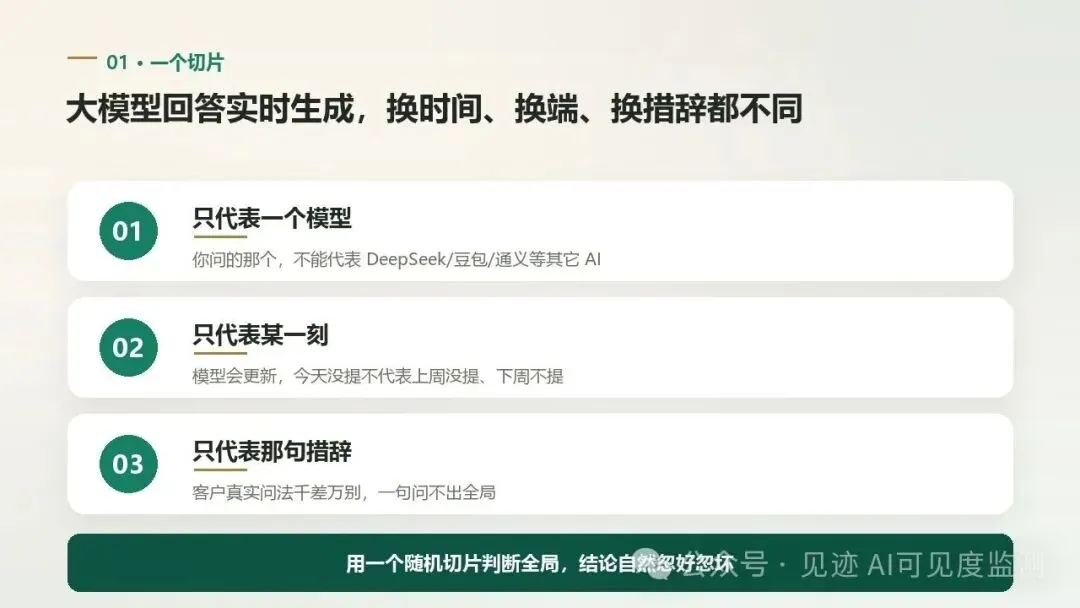
大模型的回答不是固定网页,它是实时生成的。同一个问题,换个时间、换个端、换个措辞,答案都可能不一样。
你随手截的那一张图,记录的只是"某一个模型、在某一刻、对你那一句具体措辞"给出的一个样本。它既不能代表其它模型,也不能代表下一次,更不能代表你的客户真实会怎么问。用一个随机切片去判断全局,结论自然忽好忽坏。
二、测不准,通常栽在四个变量上
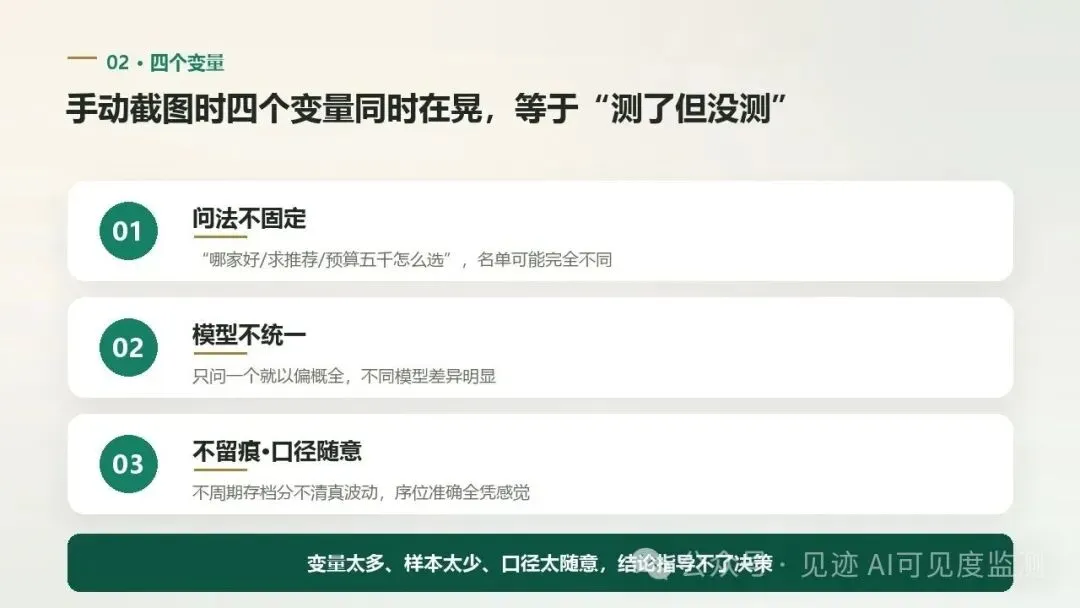
把"手动截图"拆开看,至少有四个变量在同时乱动:
1. 问法不固定。你每次问的措辞都不一样,而问法对结果影响极大——"哪家好""求推荐""预算五千怎么选"得到的名单可能完全不同。
2. 模型不统一。只问了一个模型,就以为代表了所有 AI。实际上不同模型的信息源和偏好差别明显,可能 A 模型常提你、B 模型从不提你。
3. 时间不留痕。AI 回答会随模型版本更新而变化。今天没提,不代表上周没提、下周不提;没有周期性的留痕,你根本分不清"真波动"还是"我问法变了"。
4. 口径不一致。什么叫"被提到"、排第几算"被推荐"、描述怎么算"准确",全凭当时的主观感觉,没有统一标准,自然没法横向比、纵向比。
四个变量一起晃,截图就成了"测了,但等于没测"。
三、靠谱的测量,靠"同口径"三个字
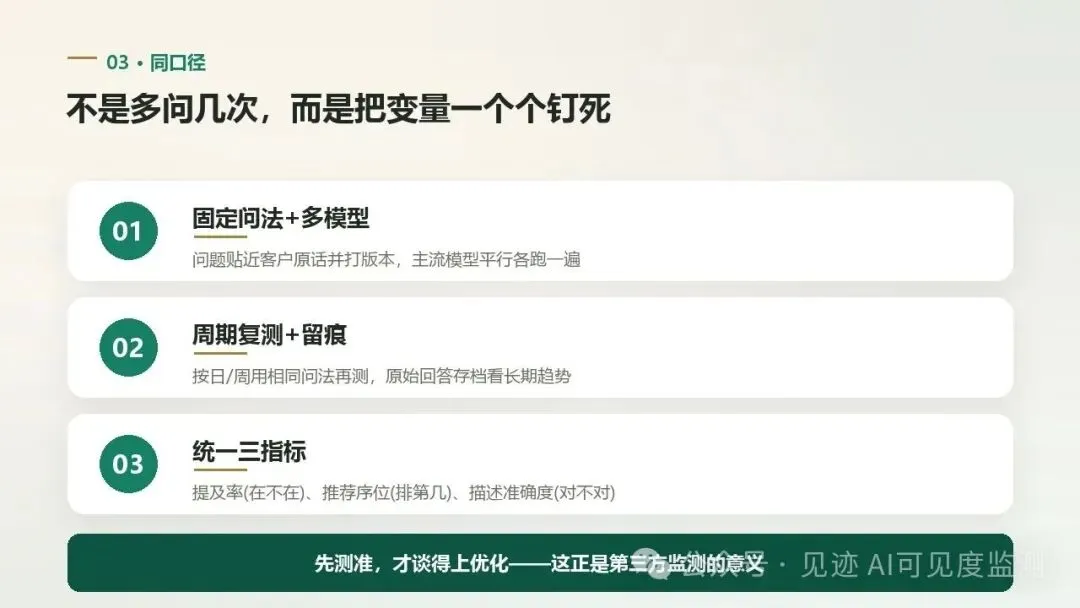
专业的做法不是多问几次,而是把变量一个个钉死:
- 固定问法集:用一组贴近客户真实提问的问题,打上版本号,不随意改;
- 多模型平行测:同一组问题,在 DeepSeek、豆包、通义、Kimi 等主流模型上各跑一遍;
- 周期复测 + 留痕:按日或按周用相同问法再测,把每次原始回答存档,看长期趋势而不是单次运气;
- 统一指标口径:用提及率(在不在)、推荐序位(排第几)、描述准确度(说得对不对)三个可计算指标来衡量。
这正是「见迹」在做的事——作为第三方品牌 AI 可见度监测平台,我们用同一套问法并行观察多个主流 AI,把每一次回答留作可核验的依据,回答"AI 正在推荐谁、你的品牌排第几"。我们只做监测与诊断,不做代运营,也不承诺一定排第一:测量的价值在于让你先看清真相,而不是给一个好看的数字。在见迹官网(star-geo.cn)可以先做一次免费的可见度诊断。
写在最后
自己截图最大的问题,不是不够努力,而是方法从根上就不可复现——变量太多、样本太少、口径太随意,得出的结论自然指导不了决策。
当"问 AI"逐渐取代"搜一下"成为用户做选择的新入口,品牌值得用更严谨的方式,去看清自己在这句话里的真实位置。先测准,才谈得上优化。