同一个商品界面,一处写着 140 美元,另一处却是 160 美元。一位参与 AI 购物研究的消费者,对这处不一致提出了疑问。
另一段记录里,价格对应了错误的包装规格。消费者以为自己在比较同一件商品,到了商家页面,才发现便宜的是另一种容量。
这两段都出自 ReFiBuy 委托 Clickstream Solutions 完成的购物行为研究,10 月 6 日发布。它们没有记录真实付款,却把一个容易被“品牌提及率”掩盖的问题拍了下来:AI 说出了品牌名字,距离消费者选中正确商品、找到合适卖家,还有几次比较。
品牌进入答案之后,产品与卖家仍要分别获得选择。 对同时经营官网和零售渠道的品牌,这两种选择可能把收益留在不同地方。
商品赢了,官网还没有赢
这项研究让 40 名美国参与者完成了 224 个桌面端购物任务,覆盖 ChatGPT 和 Google AI Mode。研究人员记录屏幕和口述过程,观察人们比较、放弃和最终选择了什么。
它的新闻标题是:ChatGPT 中,约 84% 的最终产品选择来自商品卡。
完整报告给出了更窄、也更有用的分母:手表、消费电子、箱包的 104 个 ChatGPT 任务,没有要求参与者一定从商品卡里选;其中 87 次最终选择关联到商品卡,比例为 83.7%。
这支持一个具体判断:至少在这些任务中,文字推荐以外的商品展示,承担了大量比较与选择。它没有证明 84% 的 ChatGPT 用户会在商品卡里付款,更没有证明文字答案失去了作用。文字仍可能先定义需求、解释取舍,再把人带到一组产品前。
接下来还有一次选择。同一款产品可能由品牌官网、百货零售商或其他卖家提供。研究里,在明确记录了两家及以上报价的 58 个任务中,44 次选择了排在第一的卖家报价,占 75.9%。
这里合并了两个平台,而且 39 个任务来自要求访问商家站的裤装与个护类别。它与前面的 104 个 ChatGPT 任务不是同一批样本,两个百分比不能相乘,拼成一条购买漏斗。
口径:各行是不同任务子集,记录的是选择,均非成交率。位置未经随机分配。
对品牌方,某款产品被选中,可能惠及多个销售渠道;对经营官网的团队,只有自己的报价继续被选中,才有机会接住下一步。这会让同一份“AI 可见度提升”报告,在品牌部与电商部那里得到不同评价。
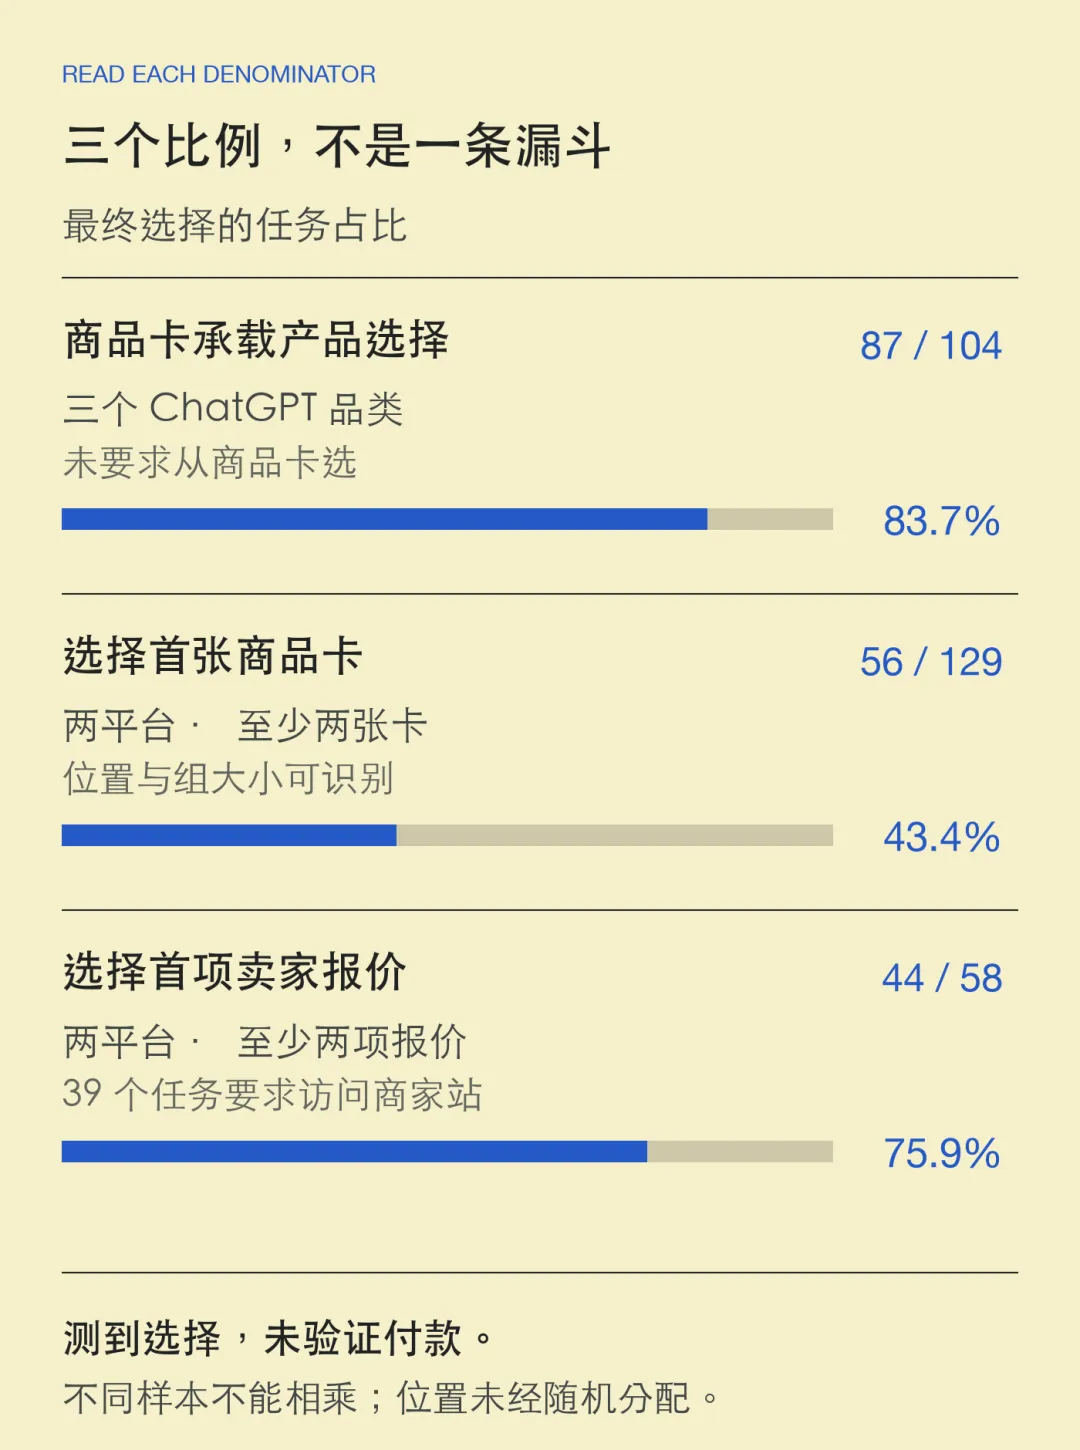
ReFiBuy / Clickstream Solutions,2026-10-06,第14、16、37页;均为选择,非付款,位置未随机化。
推荐产品与排列卖家,平台考虑的东西不同
截至 10 月 22 日,OpenAI 的购物说明把这两件事分开解释。
展示哪款产品,会参考用户问题、上下文、商品元数据与其他公开内容。点击产品后出现的商家,则依据库存、价格、质量,以及是否为制造商或主要卖家等因素排列。官方同时提醒,商品卡中的初始价格通常来自排在第一的商家,未必是最低价,价格和配送信息也可能延迟更新。
于是,消费者眼前看似只有一张卡,背后实际叠着两层信息:这是哪件商品,以及谁愿意以什么条件交付它。品牌名称、图片和型号帮助识别产品;库存、到手价格、配送与退货条件影响对卖家的判断。
前者做得更清楚,不会自动替后者补上缺货或配送短板。反过来,某个卖家给出了更合适的报价,也不意味着品牌必须在所有商品上同时降价。
这也是把 AI 商品卡直接叫作“新广告位”的问题。OpenAI 当前说明明确区分自然商品结果与广告,商品结果并非因商业合作而决定。研究中的首位选择集中,也没有告诉商家如何付费买到首位。
研究没有随机交换位置,排在前面的商品原本就可能更符合需求、价格更合适。因此,43.4% 和 75.9% 描述的是选择集中在哪里,不能单独拆出位置造成的提升。
但商业含义已经足够明确:品牌声量指标只覆盖了部分竞争;卖家能否在这件商品上提供可接受的交易条件,仍要单独判断。
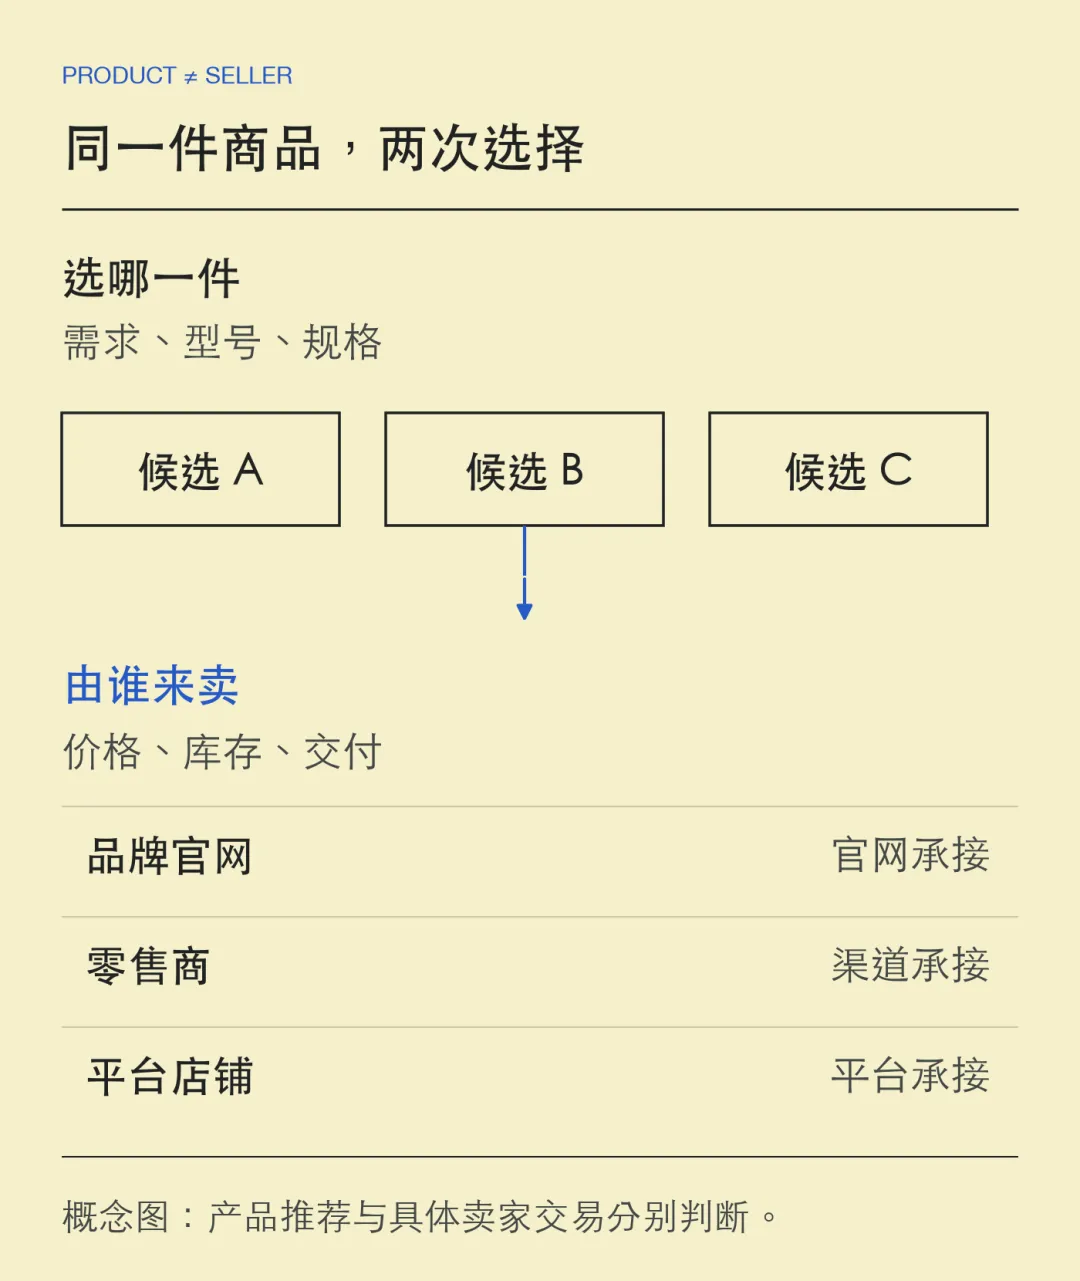
依据OpenAI购物帮助文档与ReFiBuy完整报告整理;概念结构,不表示交易顺序在每次会话中固定,也非真实界面截图。
一条库存记录,怎样影响一次推荐
OpenAI 当前的产品数据规范,分别处理具体商品、变体组和卖家报价,要求它们使用稳定的身份标识。商品每种规格还应有对应的价格、库存、图片与目的地链接。
这个数据模型解释了开头的价格冲突为何值得重视。
容量不同的两瓶商品,可以属于同一系列,却不能共用一份让人误以为完全相同的报价。用户要求的尺码已经无货,另一个尺码仍在售,也不能据此承诺前者可买。一个营销标题即使写得再有说服力,也无法修复这类商品身份错误。
官方规范还特意说明:运费字段留空代表未知,不能理解为免运费;商品是否具备搜索资格,也不等于一定会展示。提交了数据、数据被接收、消费者看到了什么,是三个需要分别核实的状态。
对有多家经销商的品牌,这涉及谁对哪部分信息负责。品牌可以统一型号、属性与变体关系,具体报价仍要由实际卖家维护。只更新官网的一段介绍,未必会同步修正零售商或第三方数据源里的库存与价格。
完整报告记录了卡片与落地页的多种不一致,但没有查明错误究竟来自商家、数据供给方还是平台处理。把所有问题都归给“AI 幻觉”,会让团队错过可修复的数据链路;把一次更新当成显示一定正确,同样缺少验证。
这部分工作有明确的经营对象:消费者提出的那组约束,能否落到一件身份清楚、当前有货、价格可兑现的商品上。它比继续增加品牌被提到的次数,更接近这次选择能否往下走。
把官网订单当目标,就要研究第二次选择
这项研究来自商业服务商委托,样本也偏向熟悉 AI 的美国用户。每个人做了多个任务,不能把 224 次任务当成 224 名独立消费者。移动端、真实付款、长期复购,以及修改商品数据能否增加销量,都没有被验证。
这些限制不影响它提出一个经营上的分工。
品牌可以关心产品是否进入候选、是否被正确理解,以及选择它的人多不多。经营官网则还要关心:同一商品出现了哪些卖家,官网的报价是否在其中,用户看到的交付承诺能否兑现。双方共享商品资料,却不共享完整的结果指标。
如果只给品牌提及率设目标,团队可能持续买来一份更漂亮的答案截图,却不知道被选中的订单会由谁履约。如果把官网订单当成唯一成功,又可能低估经销渠道获得的需求。多渠道品牌需要先决定,这次投入究竟希望改善整体销售,还是提高官网承接。
具体研究也应该沿着这个分工做。同一款商品、同一种规格、同一地区,记录产品是否进入候选,再看实际可选卖家及其报价。最终用真实订单核对结果。这里只是可检验的方法,公开研究尚未证明照此修改就能得到某个提升。
单看商家后台还会漏掉一段过程。报告中,在商品卡出现且点击记录可用的 218 个任务里,有 79 次悬停查看了商品卡,却没有点击任何商品卡。任务要求参与者悬停查看,研究将至少两秒的悬停计入记录,不能把这个比例视作自然浏览的自发频率。这不是说消费者完全没有点击其他位置,更不是说他们不会访问商家。它说明到站数据只留下了部分行为:产品可能已经参与过比较和排除,商家却收不到一次引荐访问。
因此,答案截图与流量后台可以互相补充,任何一份都无法独自复原完整选购。可见度值得记录,但最终要解释的仍然是产品如何进入选择、官网又承接了其中多少交易。
AI 购物让产品推荐和零售报价挨得更近,也让两者的利益差异更容易被忽略。消费者选中了品牌,品牌可能受益;官网要拿到这笔交易,还得在那款产品的卖家比较里给出一个继续选择它的理由。
来源
ReFiBuy / Clickstream Solutions:《In AI Shopping, the Product Card Is Your Storefront》,2026 年 10 月 6 日;全文重点核对第 8—16、20、35—37 页的方法、原始计数与限制。
OpenAI Help Center:Shopping with ChatGPT Search;OpenAI Developers:Products / Product Feed specification,2026 年 10 月 22 日核对。产品与商家选择机制会继续更新,本文按当日官方说明表述。
你更想知道品牌有没有被推荐,还是官网有没有接住交易?
说一下你现在负责品牌还是官网就行。
关注「智跃出海」· 每篇先说结论
