文|卯时AI 来源|www.agentm6.com
导读
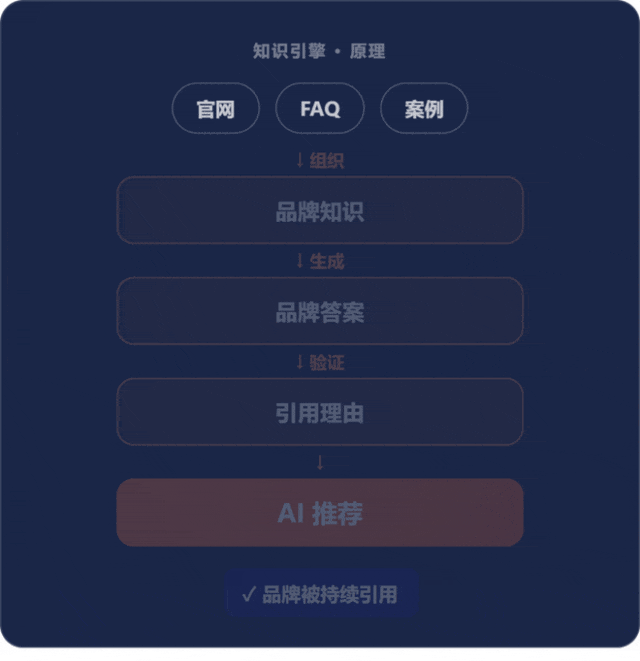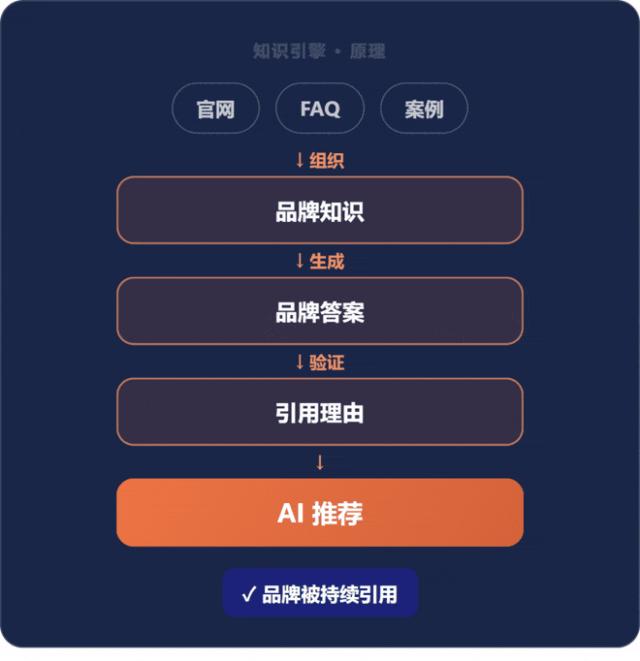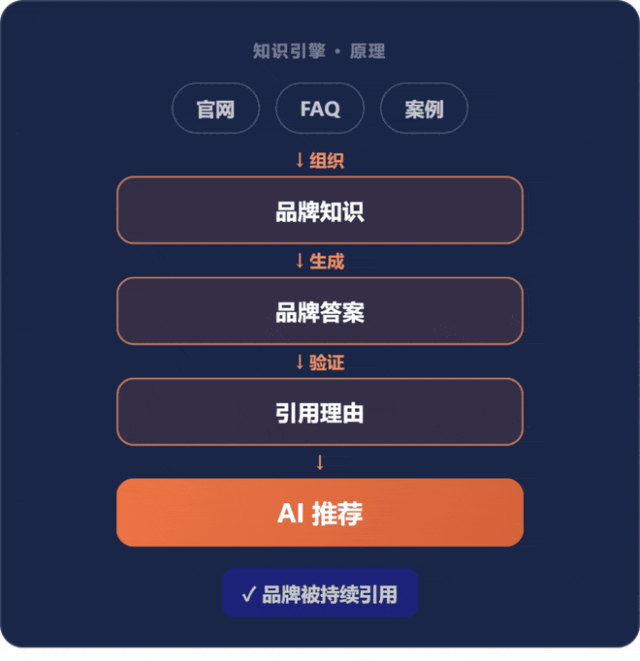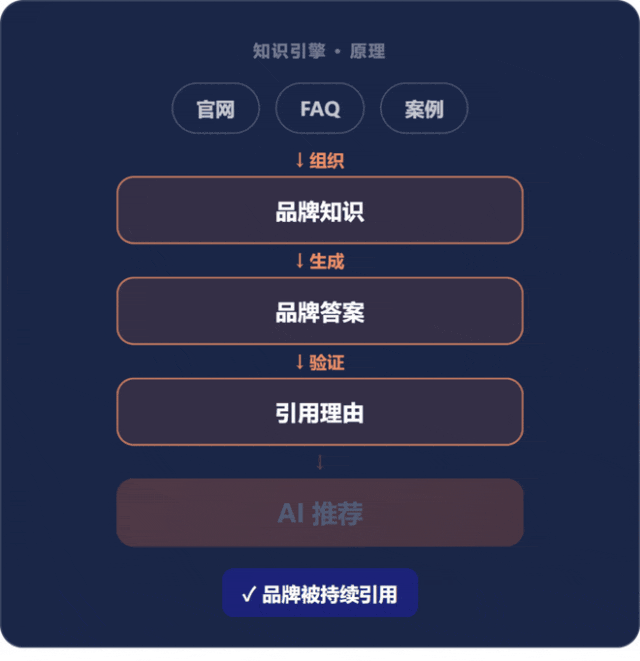
品牌知识引擎负责把非结构化品牌资料组织成 AI 可理解的实体资产并持续生成可引用答案,越晚建设,品牌在 AI 答案中的可见性与可信度损失越大。
01非结构化数据重构的买家可见性
AI 答案正成为买家获取品牌信息的第一接触面,品牌知识引擎决定品牌在其中的可见性与可信度。今天多数团队仍以 CMS 里存了多少品牌资料来衡量准备度,但真正暴露差距的,是 AI 能不能从这些资料里生成一个可追溯的答案——存得越多,越显出组织能力的缺口。这个缺口不在资料量,而在资料与答案之间缺少一层持续运转的组织机制。
Forrester 调查显示,70% 的营销人员表示 AI 可见性是其 CMO 或 CEO 的首要任务。问题已经摆上桌面,可多数企业仍把它当成市场部的传播议题,而不是一项需要专门基础设施支撑的能力。
研究显示,当 AI 搜索引擎引用来源时,约 78% 的引用指向企业网站,包括品牌自有页面和同行业第三方公司页面。买家在考虑阶段看到的品牌答案,多半来自 AI 对公开信息的重组,而非品牌主动递出的资料。品牌自有页面既然承担了近八成的引用落点,它就不只是宣传窗口,而是答案的原料仓库;原料是否可被机器读懂、可被追溯,直接决定品牌在答案里出现还是消失。
由此看,品牌知识引擎的职责不是把资料搬进另一个系统,而是让这些资料随时能变成一段有出处、可核对的答案。
对 CEO 与高管来说,这一层判断的落点很实际:AI 答案里的品牌形象,取决于背后有没有一套持续组织知识、生成答案、维护资产的引擎在运转。缺少这套引擎,品牌在买家第一次提问时可能就已经缺席。
这一层判断的代价,往往不在建引擎的成本,而在对引擎能力边界的误判。
- 近八成引用落在企业网站,自有页面是答案原料主要来源
AI 今天如何理解你的品牌?
不看 AI 眼中的自己,优化就是盲改。一次诊断看清:
✓ 主流 AI 如何描述你的品牌
✓ 品牌知识点的收录率与缺口在哪里
✓ 与竞品在 AI 答案中的差距有多大
✓ 下一步该优先补什么,不再盲改
点击上方按钮,添加顾问微信免费诊断
02实体图谱化才是品牌知识引擎的底牌
把品牌知识引擎当成普通 CMS 或网盘,漏掉的是它把非结构化文档转化为三维实体图谱的能力。文档存得再整齐,也只是文件夹的秩序;AI 需要的是实体之间的明确关系,知道这段文字说的是谁、和谁相关、凭什么可信。
一项实验发现,未指定目标对象的改写很少提升目标曝光,而明确指定目标候选人或政党的改写更常带来曝光提升。因为改写若不指向具体对象,机器就无从判断这段内容该关联到谁,所以哪怕资料归档得井井有条,也不会自动转化成 AI 答案里的曝光。反过来,明确指向品牌与产品实体的内容,被机器识别并关联的概率通常更高。
研究分析了生成式引擎实际引用的来源,发现许多引用来自成本较低的自有渠道和开放平台来源,且部分网页能在多天内持续保持可见。自有渠道能被持续引用,前提是页面上的内容已经被机器读成结构——实体、属性、关系都标得清楚。这说明机会窗口真实存在,但它只对结构化的内容开放;把文档堆进网盘,等于把原料锁在机器读不懂的柜子里。
品牌知识引擎与 CMS 的分野不在存储,而在转化:把散落的文档拆成实体、把实体连成关系、把关系维护成可追溯的图谱。企业若只升级存储,多半会在下一次答案生成时发现,自己的资料一条都没被用上。技术负责人评估这类系统时,该问的第一个问题往往是它能不能输出可核对的实体关系,而不是它能装多少文件。
这一区别决定了投入的性质:买存储是买容量,建引擎是建结构。容量会贬值,结构会随维护而增值。团队若把两者混为一谈,预算花出去,AI 答案里的品牌存在感却可能原地不动。
存得整齐不等于AI能读懂
| |
|---|
| 文档中的品牌、产品、场景被自动识别为实体并建立关联 |
| |
| |
品牌知识引擎的建立时点,决定 AI 答案里品牌可见性的起点。03品牌知识引擎:从存知识到生成答案
只做存储与检索的系统无法针对买家意图生成结构化答案,AI 在考虑阶段拿不到可引用内容,品牌就会被跳过。品牌知识引擎的价值,在于把品牌知识组织成机器能理解并持续维护的资产,从而稳定生成品牌答案。两者的差别不在知识多少,而在知识被加工到什么程度:仓库保存的是原文,引擎产出的是可以直接放进回答里的结论。
AI 答案偏爱排名式清单,这类结构最容易被整段取用。存储型系统能检索到十篇产品介绍,却拼不出一张按场景排序的对比清单;它能告诉企业文档在哪,却答不出这家供应商在某个具体采购条件下排第几。买家在考虑阶段提出的问题往往带着限定条件——预算区间、交付周期、适配的既有系统——这些条件必须落到同一张表里才能比较,而散落在多份文档里的描述无法自动对齐。
系统若只负责把文档找出来,把这些条件拼成一张可比较的表就落到了人身上,规模一大便维持不住。
前文那组关于引用来源的数字已经说明,机器更倾向取用结构清晰、实体明确的页面。它证明的是取用偏好而非知识储量:同样主题下,实体清楚、层级分明的页面更容易被整段引用,写得详尽但结构松散的页面则容易被略过。企业若只把知识库当仓库,AI 在回答具体采购问题时便找不到可直接引用的段落。
后果会沿着采购流程往后传:考虑阶段没有被引用,比较阶段就进不了候选名单,到了决策阶段再想靠销售话术补回来,成本通常要高得多。
生成答案的能力包含三件事:把文档拆成实体、把实体按买家意图重新编排、把编排结果维护成可追溯的版本。三件事缺一件,答案就会退回成一段泛泛的介绍。企业常以为买了检索工具就有了知识管理,实际上买到的只是查找速度。
那么,企业该从哪里开始,才能让 AI 在答案里稳定提到自己?答案多半不在扩大存储,而在先选一条产品线,把它的实体、场景与对比关系整理成机器可读的结构,再看答案里是否开始出现可核对的引用。这一步做不通,后面的规模投入就很难站得住。企业可以把这条产品线当作一次小范围检验:整理前后各问 AI 同一批采购问题,看引用是否从无到有、从泛泛介绍变成带条件的对比。
检验结果稳定之后,再把同样的结构复制到相邻品类,团队也能据此判断哪些知识值得长期维护、哪些只是历史存档。
品牌知识引擎不是网盘,是答案生成器
| |
|---|
| |
| 针对具体考虑阶段的问题生成结构化答案,可被AI直接引用 |
| 围绕高杠杆引用格式(如排名式清单页)组织可复用资产 |
04品牌知识引擎该跑起来了
品牌知识引擎应承担实时监控全网 AI 引用状态、向各分发通道持续灌输证据的职责,高管应把它当作长期运维的资产基础设施。这个定位决定了立项方式:它更像一条需要持续供料的生产线,而不是一件买回来就能用的设备。生产线一旦停料,产出就断;引擎一旦停止监控与补证,引用存量也会慢慢蒸发。因此立项时企业要问的不是买哪套工具,而是谁负责供料、供什么料、多久供一次。
Hatter 的 BSCG 案例显示,SEO 和 AEO 内容驱动了 BSCG 网站流量的 78%,并锁定了 19 个持续被 AI 引用的页面。那 19 个页面不是一次投放的结果,而是持续运维留下的存量;企业若按项目制做完就撤,这类存量往往会在几个月内流失。
这也解释了为什么监控必须实时:引用状态是流动的,今天被引用的页面,明天可能因为模型更新或竞品补证而掉出答案,只有持续盯着,才能在掉出的早期补上证据。
效果该怎么评估,是立项时绕不开的问题。企业要判断引擎是否真的带来引用,靠观察流量涨跌并不够,需要设计对照:同一批内容,一部分做结构化处理,一部分保持原样,再看两组在答案中的出现差异。验收标准多半应当按这种因果逻辑来设,而不是按上线了多少篇文档来计。对照之外,还要看引用的稳定性:同一问题在不同时间反复提问,答案里是否仍指向同一批页面。
稳定性比单次出现更能说明资产是否真的沉淀下来。
文章提出搜索引擎评估内容的两阶段模型:先做相关性过滤,再按权威性排序。内容必须先被判定与提问相关,才有资格进入权威比较,这意味着引擎的职责是持续向可抓取的通道灌输证据,而不是一次性交付一批资料。相关性这一关过不去,权威积累再厚也用不上。引擎的日常动作因此应当分成两段:一段盯相关性,确保实体、场景、问答对得上用户真实提问;一段盯权威,把可核验的证据补进页面。
主题权威常被误解成一种独立的排名因子。研究显示,文章把主题权威重新定义为相关性的结构化延伸,而不是一种全新的排名因子。引擎的产出必须按实体与主题成体系地覆盖,这决定了它是长期运维而非一次性采购。堆关键词的做法在这里失效,覆盖的广度与一致性才是可积累的部分。
成体系覆盖意味着企业要先画清自己的实体地图:哪些产品、哪些场景、哪些问题属于自己该回答的范围,再按图逐块补齐,而不是零散地追热点。
生成式 AI 重塑了信息检索的方式,也改变了内容在答案式搜索中获得突出地位所依据的标准。品牌资产因此需要围绕机器可理解性来组织,引擎则要持续监控引用状态、持续补充证据。关键词式 SEO 的局限正在显现,语义相关性、用户意图、结构化数据与信任信号的分量在上升;文档排得整齐,并不等于机器读得懂。
机器读得懂,要求实体命名统一、属性字段完整、证据可追溯,这些都不是一次整理能完成的,需要有人按周期复核。
把这些线索合起来看,品牌知识引擎是一种新东西:它既不是 CMS 的升级版,也不是一次内容外包。它要求企业把品牌知识当成需要长期供料的资产,把监控引用、补充证据、维护结构变成常态工作。越晚建立这套运转机制,品牌在 AI 答案中的可见性与可信度就越难补回,因为引用存量需要时间累积。
高管在立项时若仍按一次性采购的预算与考核方式来管它,团队多半会在交付后失去持续投入的依据,引擎也就退化成一批静态文档。
最小代价的起步方式并不复杂:由技术负责人牵头,选一条产品线,把它的实体与场景整理成结构化页面,同时记录这些页面在主流 AI 答案中被引用的频次与出处;连续观察数周,若引用开始稳定出现且可核对,再考虑扩大范围。这套动作不需要全公司动员,但需要有人对结果负责。
负责人还应把观察记录固定成周报,让引用频次、出处与补证动作一一对应,这样引擎的运维才有据可查,扩围时也有可复用的底稿。
既然 AI 答案已成为品牌被理解的主要入口,把品牌知识组织成可持续维护的资产,就该尽早落子。常见问题
什么是品牌知识引擎?
品牌知识引擎是组织品牌知识、生成品牌答案并持续维护AI可理解品牌资产的机制。它并非存储工具,而是把非结构化文档转化为实体关系图谱,让资料能变成可追溯的答案。
它和普通工具有啥区别?
品牌知识引擎与普通工具的区别在于转化而非存储:普通工具保存原文,引擎产出可直接引用的结论。引擎能把文档拆成实体、连成关系并维护成可追溯图谱,而普通工具只提供查找速度。
品牌知识具体包含哪些?
品牌知识具体包含实体、属性、关系以及按买家意图编排的问答对和对比清单。企业应从产品线入手,梳理实体、场景与对比关系,形成机器可读的结构化知识。
它不就是个高级网盘吗?
品牌知识引擎不是高级网盘,网盘只存文件,引擎负责把文档转化为实体关系并生成可追溯答案。把引擎当网盘会漏掉其三维实体图谱能力,资料存得再整齐也不会自动变成AI答案里的曝光。
怎么让AI推荐我的品牌?
让AI推荐品牌的关键是让内容被机器读成结构:明确实体、属性与关系,并持续向可抓取通道灌输证据。先选一条产品线整理成机器可读结构,再观察AI答案中是否出现可核对引用。
让企业知识真正被 AI 用起来
卯时AI | 让企业知识真正被AI用起来。我们致力于把企业知识组织成 AI 可推理、可引用、可调用的 AI知识资产,为 GEO、企业智能体、营销与销售等 AI 应用提供统一的知识底座。