模型榜单那么多,到底该看哪一个?从能力、体验、中文表现到资料检索,7个平台各有分工。
每次新模型发布,我们都会看到“刷新纪录”“登顶榜单”的消息。但真正用起来,大家关心的往往更具体:写作顺不顺手?代码能不能跑?中文理解如何?完成一次任务要花多少钱?
评估平台做的,就是把这些问题拆开来看。这篇文章整理了7个值得收藏的入口,帮你按用途找到合适的参考。它们有的自行组织评测,有的研究长期趋势,有的负责整理资料,分工并不相同。
01|Artificial Analysis:把能力和成本放在一起看
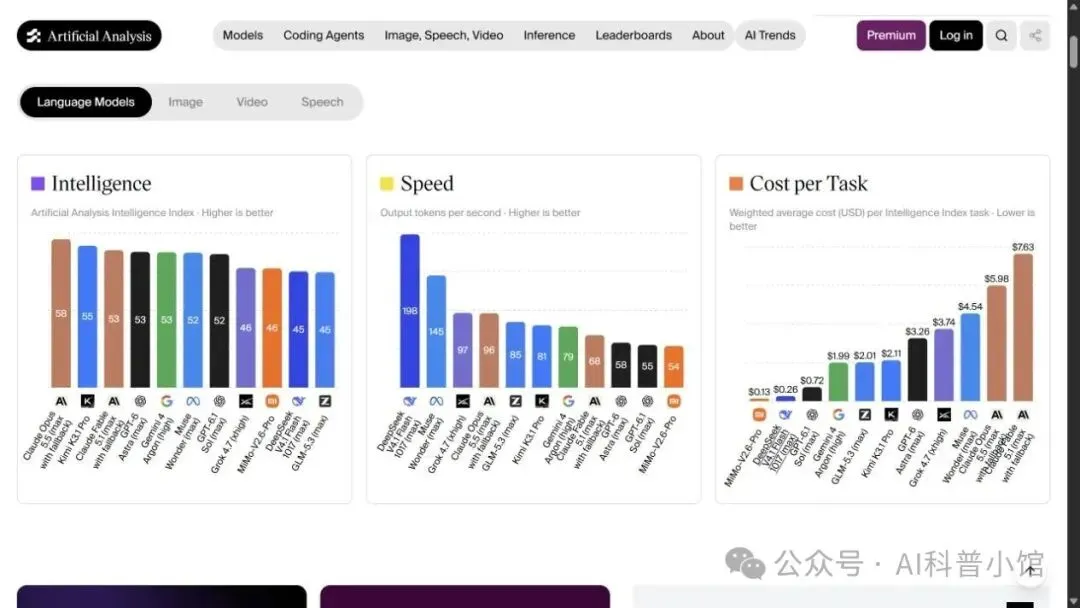
想知道一个模型“强不强、快不快、贵不贵”,可以先看 Artificial Analysis。它自行组织评测,同时比较推理速度、价格和任务成本。
图1|能力、速度与任务成本并列展示。来源:artificialanalysis.ai;截图:2026年10月24日。
它把选型的关键问题放在一起回答:能力更强的型号,值不值得多花钱?速度更快的模型,跟不跟得上你的任务?日常比较型号、算性价比,先来这一家。
官网:https://artificialanalysis.ai/
02|Arena:看看真实用户更喜欢谁
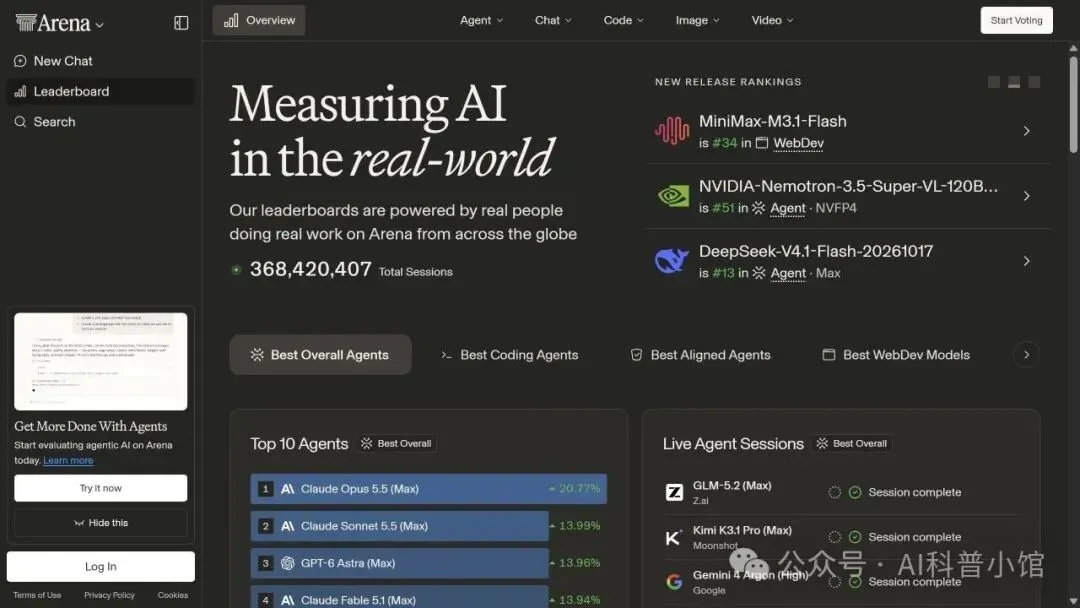
有的模型分数很高,回答却未必合你的口味。Arena 从用户偏好和实际任务反馈出发,提供聊天、编程、图像、视频等不同方向的榜单。
图2|榜单总览展示不同任务类别与真实使用反馈。来源:arena.ai/leaderboard;截图:2026年10月24日。
它的规则很简单:匿名对比,先看回答,再选更喜欢的那一个。因此它反映的是表达、交互和整体体验。看榜时留意样本量和排名区间就好,不必纠结相邻的一两名。
官网:https://arena.ai/leaderboard
03|Epoch AI:把模型放进长期进步的坐标里
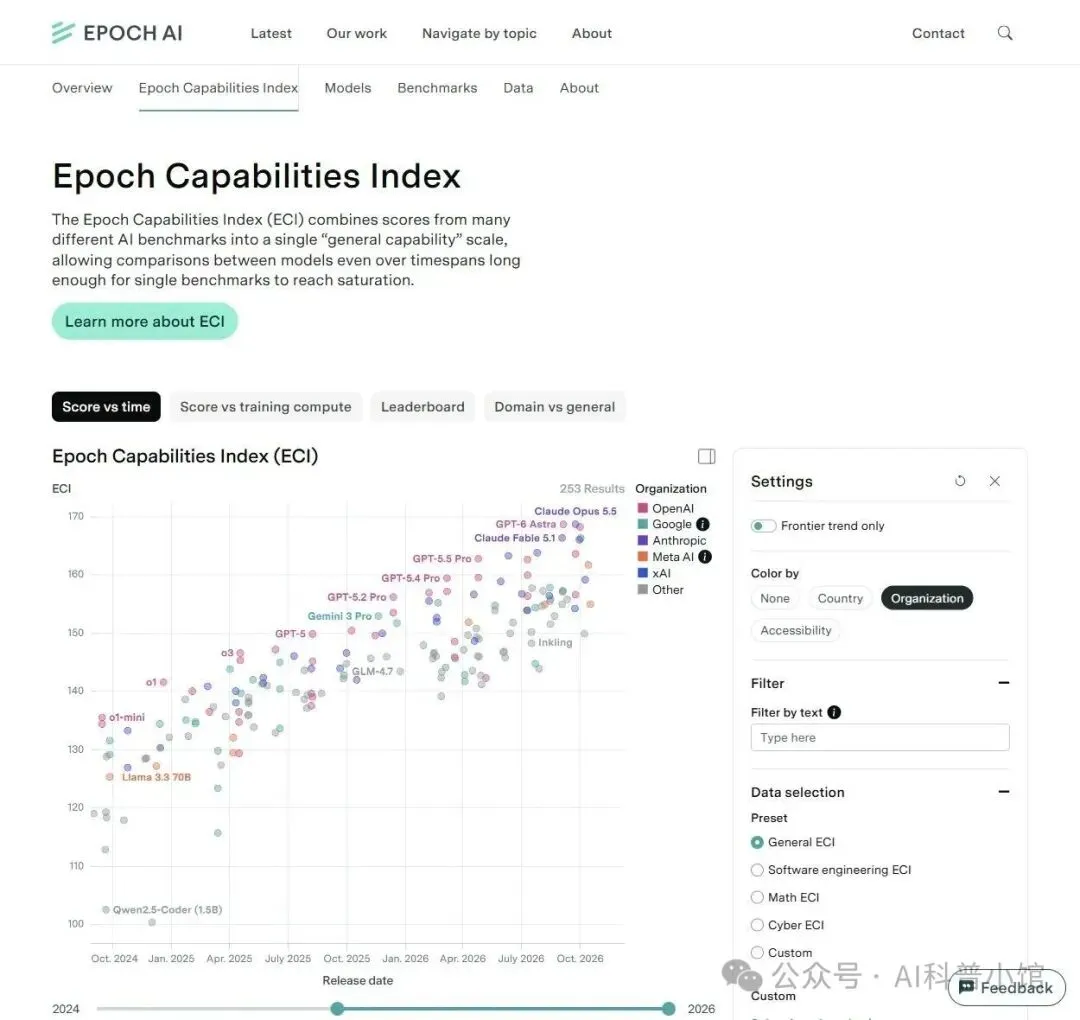
如果你关心的不只是“今天谁排第一”,还有“AI 能力究竟进步了多少”,Epoch AI 值得关注。它提供模型评测数据库和综合能力指数 ECI。
图3|ECI将不同模型放进同一条能力变化时间线。来源:epoch.ai/eci;截图:2026年10月24日。
它汇集自身评测与外部来源,能观察数学、编程等能力这些年的变化。对研究者、技术作者和长期跟踪 AI 的人来说,这是一个能追溯证据的观察窗口。
官网:https://epoch.ai/eci
04|LiveBench:关注模型能否把复杂任务做完
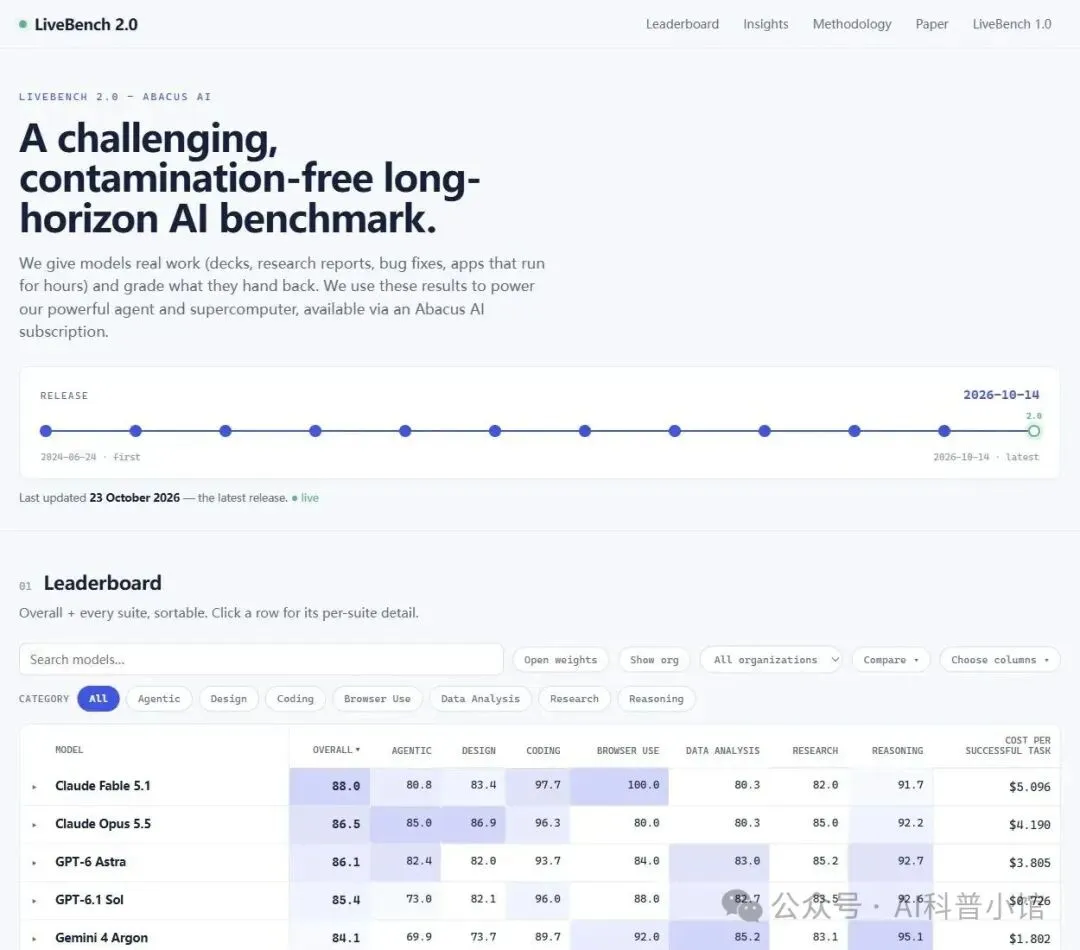
从回答一道题,到完成一项工作,中间还隔着规划、操作和反复检查。LiveBench 2.0 把关注点扩展到复杂任务和较长的工作流程。
图4|综合成绩之外,还可查看任务类别和完成任务的成本。来源:livebench.ai;截图:2026年10月24日。
推理、编程、浏览器操作、数据分析、研究、设计都在它的覆盖范围内,分项成绩和任务成本一并列出。如果你想让 AI 承担多步工作,这比单看一道题的正确率更贴近需求。
官网:https://livebench.ai/
05|SuperCLUE:给中文应用补上一把尺子
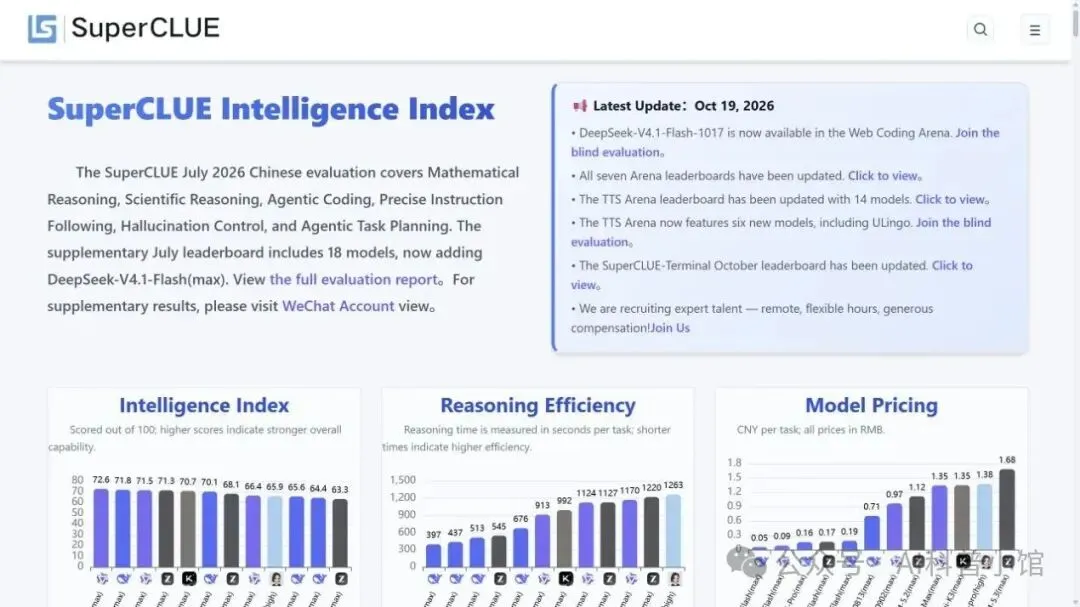
英文任务里的好成绩,回答不了中文场景的使用问题。SuperCLUE 是面向中文大模型的综合评测基准,关注中文推理、指令遵循、幻觉控制和智能体能力。
图5|综合智能指数页面提供中文评测说明与指标对比。来源:superclueai.com;截图:2026年10月24日。
国际榜单之外,它是中文场景的补充参照。选中文助手、比较国产模型时,值得加入交叉参考。
官网:https://www.superclueai.com/static/fewclue.html
06|DataLearner:先把模型资料查清楚
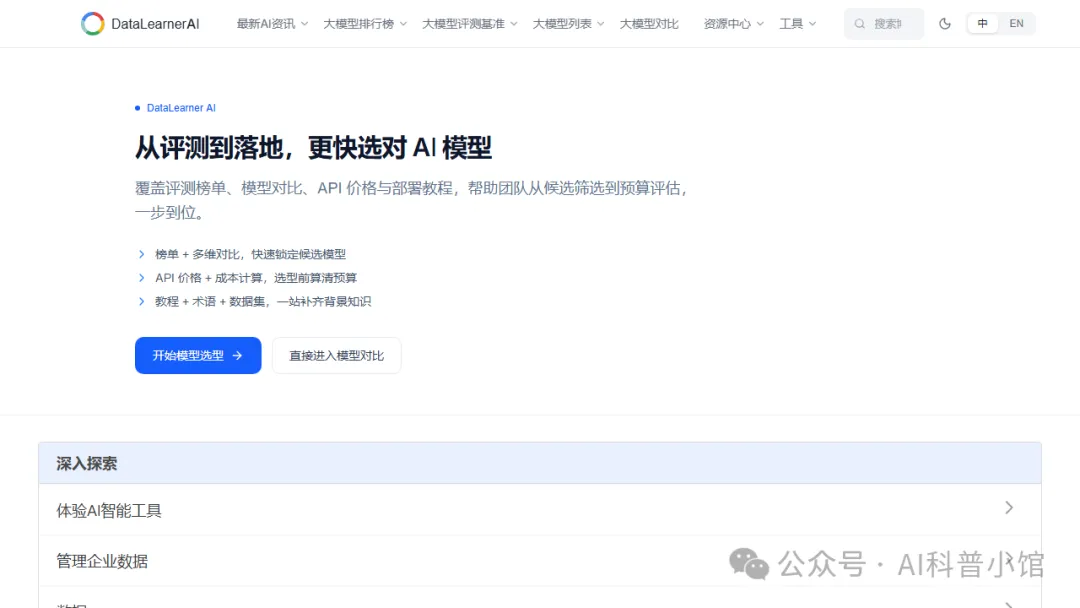
面对不断出现的新型号,参数、上下文长度、价格和测试成绩常常分散在不同页面。DataLearner 把模型资料、评测数据和比较工具汇集到一个中文入口。
图6|首页汇集榜单、模型对比、价格与教程入口。来源:datalearner.com;截图:2026年10月24日。
查参数、找技术报告、建候选清单,一个入口就能完成;首页还提供模型对比、API 价格、成本计算器和部署教程,从筛选候选到核算预算一站覆盖。读到某项成绩时,不妨继续追溯来源,分清它是厂商公布的数据,还是第三方组织的测试。
官网:https://www.datalearner.com/
07|聚模合:用一个入口浏览多家榜单
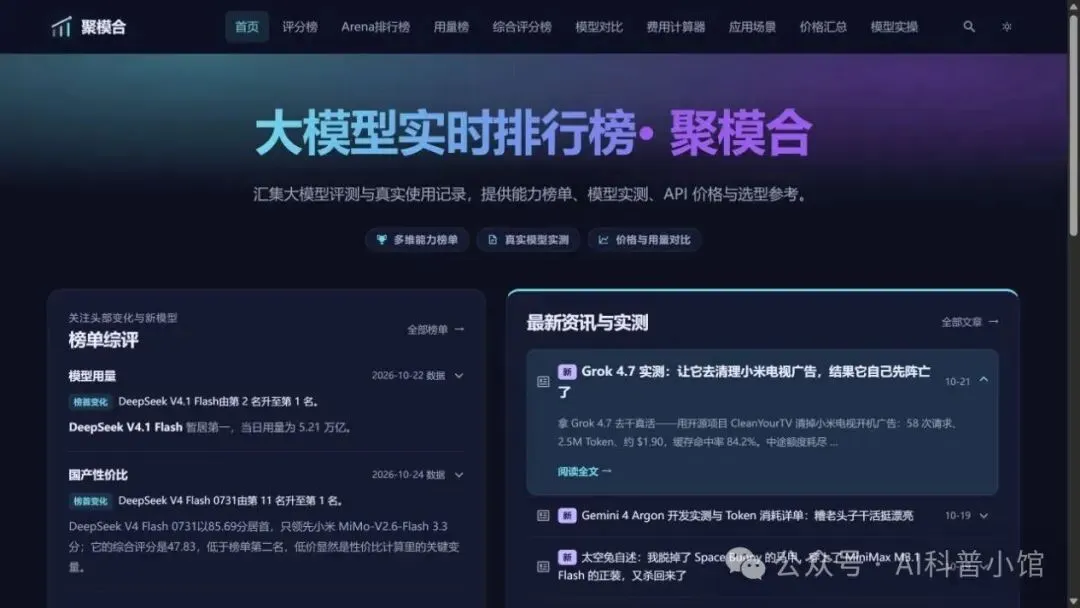
如果你不想反复切换网站,聚模合提供了更集中的浏览方式:汇总多来源榜单、模型信息和价格,并给出自己的综合排名。
图7|首页汇集榜单综评、模型实测和选型入口。来源:jumohub.com;截图:2026年10月24日。
把它当作浏览起点:不同榜单的共同趋势一眼看清,再挑值得深入了解的模型。它的定位是信息聚合——同一份成绩被多个网站转载,仍然只是一份评测证据。
官网:https://www.jumohub.com/
选模型时,可以先用 Artificial Analysis 比较能力与成本,再到 Arena 看用户体验;中文应用补 SuperCLUE,复杂任务参考 LiveBench,长期趋势看 Epoch AI;需要查资料、汇总榜单时,再打开 DataLearner 和聚模合。
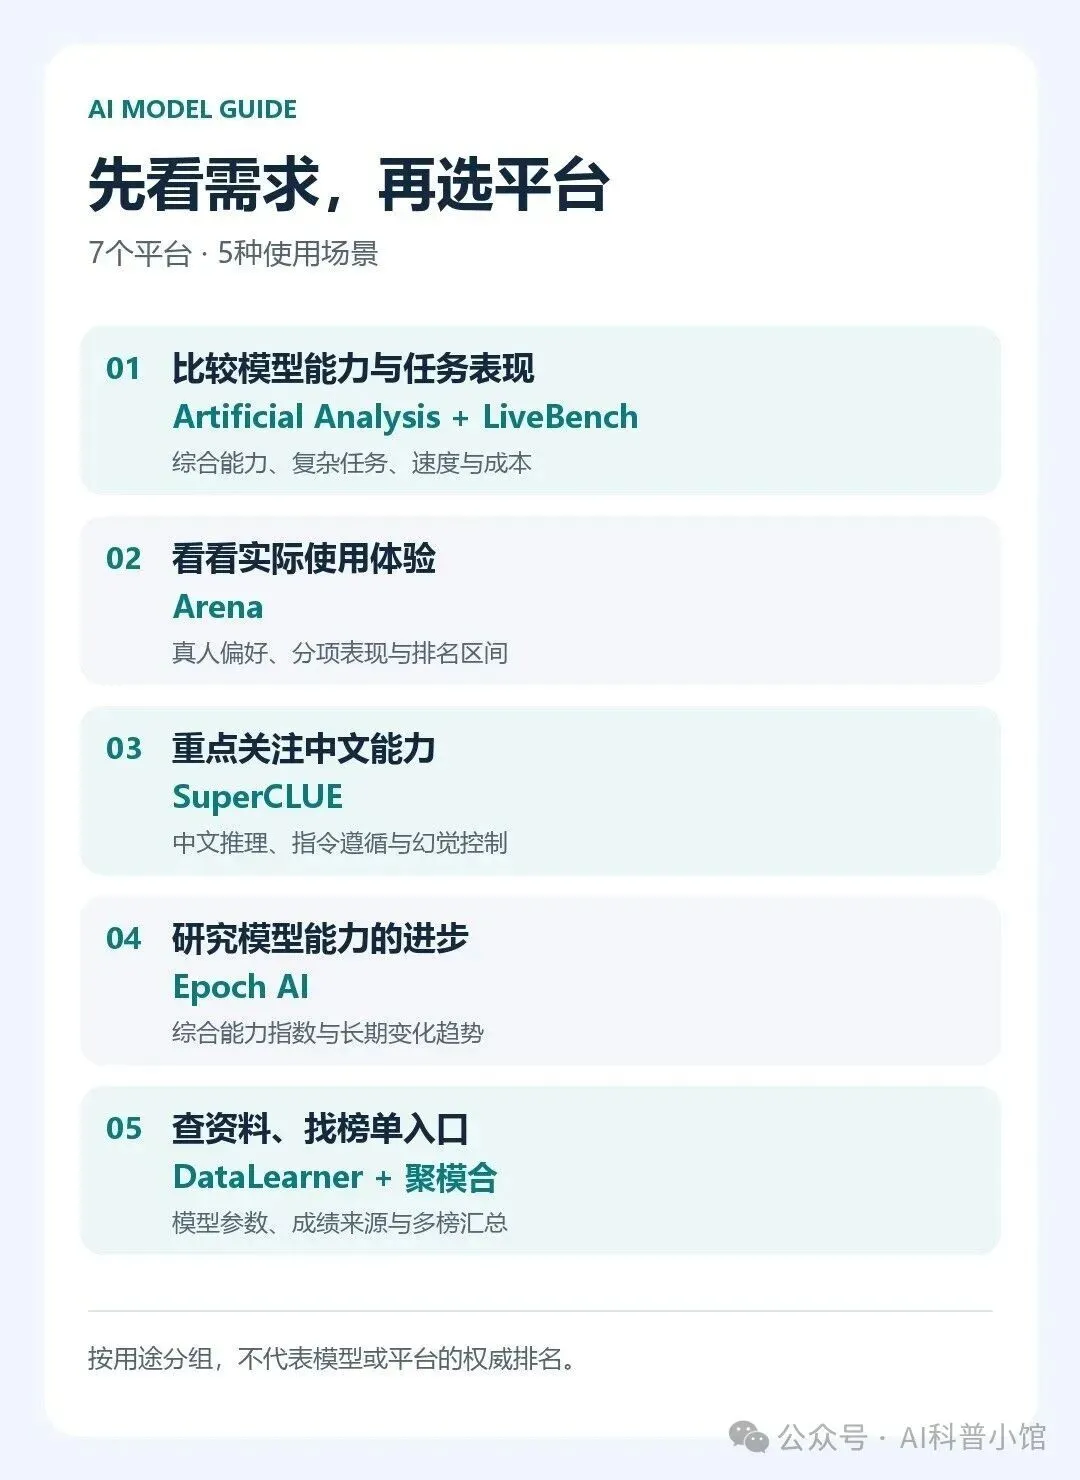
最后,拿自己的真实任务试一次:同一份材料、同一个要求,看哪个模型更准确、更省心。榜单帮助缩小范围,你的任务决定最终选择。
一张表总结:7个平台分别适合做什么?
| | | | |
|---|
| | 独立的AI模型评测与分析平台,覆盖语言、图像、视频和语音等领域 | | 自行组织测试,公开评测方法;适合综合选型、性能比较和性价比分析 |
| | 以用户偏好和真实任务反馈为基础的AI评测平台,前身为 Chatbot Arena/LMArena | | 提供匿名对比、分项榜单和排名区间;适合判断实际使用体验与用户偏好 |
| | 研究AI发展趋势与模型能力的机构,提供评测数据库和综合能力指数 ECI | | 注重方法说明与数据追溯;适合技术研究、趋势分析和跨基准比较 |
| | | 评估推理、编程、浏览器操作、数据分析、研究及设计任务 | 重视实际任务交付,展示分项成绩和任务成本;适合评估模型完成多步工作的能力 |
| | | 评估中文数学与科学推理、指令遵循、幻觉控制及智能体能力 | 中文任务针对性强,具有自建评测体系;适合中文应用选型及国产模型比较 |
| | | | 信息覆盖广,便于追溯技术报告和成绩来源;适合资料检索、候选模型筛选和横向比较 |
| | | | 浏览方便,披露综合评分方法;适合快速了解多个榜单的共同趋势,辅助模型选型 |