📖 本篇目录① 多 Agent 协作评测的核心挑战② 四大核心维度总览③ 通信拓扑与信息流效能评测④ 协作型场景评测:软件工程蜂群⑤ 混合动机博弈评测:竞标市场与契约博弈⑥ 信用分配与帕累托效能⑦ 社会动力学与拜占庭容错⑧ 工程落地:PYTEST版本的评测框架的架构蓝图及工程结构设计
导读:在单 Agent 评测体系(如 OpenAI Evals、Google AndroidWorld)已经相对成熟的今天,AI 领域的前沿目光正转向多 Agent 群体协作(Multi-Agent Swarm Dynamics & Collaboration)。当数十个甚至上百个具有不同角色、不同记忆和独立 Prompt 的 Agent 组成一个虚拟组织(如软件研发团队、分布式供应链或金融交易市场)时,传统的"单步正确率"或"终态判定"彻底失效——我们面对的是一个复杂的非线性涌现系统。如何设计一套严谨、可复现、可量化的多 Agent 群体协作评测基准(Multi-Agent Evaluation Benchmark)?本文从核心挑战、四大设计维度到工程落地架构进行深度拆解。
01多 Agent 协作评测的核心挑战
与单 Agent 相比,多 Agent 系统的评测面临三个本质上的高维困境:
1. 信用分配难题(Credit Assignment Problem):当整个团队在交付大型软件项目时失败了,究竟是架构师 Agent 规划错误、程序员 Agent 写的代码有 Bug、还是评审 Agent 漏掉了漏洞?
2. 组合爆炸的通信拓扑(Combinatorial Explosion of Communication):Agent 之间是采用全连接广播(Broadcast)、分层树状(Hierarchical)还是点对点(P2P)通信?通信开销和信息失真如何度量?
3. 群体社会病理学(Emergent Social Pathologies):群体是否会陷入盲目从众(Echo Chamber)、信息茧房、恶性内卷,或者出现恶意合谋(Collusion)?
02四大核心维度总览
构建一个世界级的多 Agent 评测基准,必须在以下四个维度建立严密的量化体系:
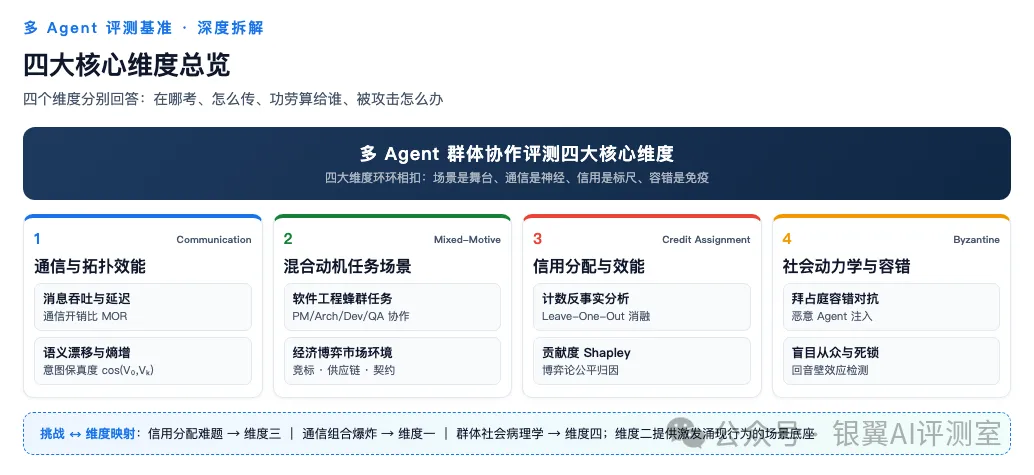
四大核心维度总览:场景是舞台、通信是神经、信用是标尺、容错是免疫
维度一:通信拓扑与信息流效能评测(Communication & Topology Evals)——评估多 Agent 系统的"神经系统"是否高效:
- 通信开销比(Message Overhead Ratio):完成同等任务时,Agent 之间交换的 Token 数量与人类专家或单 Agent 的比值,防止"开会 10 小时,干活 5 分钟";
- 语义信息熵(Semantic Entropy in Broadcast):监测在长距离多跳转发过程中,核心任务意图(Intent)是否发生了严重衰减或失真;
- 死锁与阻塞率(Deadlock Rate):评估在点对点通信中,是否存在因互相等待对方响应而导致的"认知死锁"。
维度二:混合动机与复杂任务场景设计(Mixed-Motive Scenarios)——基准必须提供能够激发群体涌现行为的复杂环境,当前顶尖的评测场景包含:
- 多 Agent 软件工程蜂群:模拟包含 Product Manager、Architect、Developer、QA 的虚拟公司,共同开发一个复杂的开源项目,评估单元测试通过率、代码可维护性、任务延期率;
- 分布式经济市场与供应链博弈:模拟多个拥有独立利益的 Agent 在资源受限、信息不对称的市场中进行博弈与契约签订,评估帕累托最优效率(Pareto Efficiency)与恶意欺诈发生率。
维度三:贡献度信用分配与效能指标(Credit Assignment & Pareto Efficiency)——如何科学评价每个 Agent 在群体中的真实贡献:
- 反事实贡献度分析(Counterfactual Contribution Analysis):在评测回放时,以"删减节点法"在线剥离某一个 Agent(如移除测试评审 Agent),观察整体任务成功率的断崖式跌幅。跌幅越大,说明该 Agent 的关键支撑度(Criticality)越高;
- Shapley 价值归因:借鉴博弈论中的 Shapley 值,计算每个 Agent 在所有可能的子团队组合中带来的边际效益期望,以此进行客观的绩效打分。
维度四:社会动力学与容错对抗审计(Social Dynamics & Byzantine Resilience)——测试多 Agent 系统的免疫力与鲁棒性:
- 拜占庭故障注入(Byzantine Fault Injection):在协作群体中故意注入 1~2 个"被污染的恶意 Agent"(输出错误信息或篡改中间变量),测试整个群体是否具备集体纠错与隔离能力,还是会发生"雪崩式信任崩溃";
- 回音壁效应检测(Echo Chamber Detection):评估 Agent 之间是否会互相盲目附和、拍马屁,导致错误方案在群体内部被不断放大并最终执行。
03通信拓扑与信息流效能评测
在多 Agent 系统的设计中,如果说大模型的"大脑(LLM Weights)"决定了每个 Agent 的个体智商,那么通信拓扑与信息流效能(Communication & Topology)则决定了整个群体协同作战的"神经系统"是否高效。
在复杂的协作蜂群(Swarm)中,往往会出现一种尴尬的现象:"开会 10 小时,干活 5 分钟"。大量 Token 消耗在无效的反复确认、冗余广播和语义失真上,导致系统整体的经济效能(ROI)和响应延迟彻底崩溃。
1. 评估核心:多 Agent 神经系统的三大瓶颈
评测多 Agent 系统的通信效能,本质上是在借用分布式计算与通信工程的理论,来审视大模型之间的"文本交互流"。主要面临三大瓶颈:
- 拓扑不匹配(Topology Mismatch):不恰当的通信网络结构(如盲目采用全连接广播)导致网络风暴和高昂的 Token 成本;
- 信息熵增与语义衰减(Semantic Entropy & Decay):长链路的多跳转发(例如 Manager → Lead → Dev → Tester)导致最初的高层业务意图在传递中被严重扭曲;
- 认知死锁(Cognitive Deadlocks):由于缺乏有效的同步机制或互斥协议,Agent 之间陷入无限互相等待或互相质问的死循环。
2. 核心评测指标体系
为了量化评估"神经系统"的吞吐与损耗,Google 风格及现代前沿多 Agent 评测框架建立了四个核心指标:
① 通信开销比(Message Overhead Ratio, MOR)——衡量多 Agent 协同的"行政成本"是否过高,数学定义为:
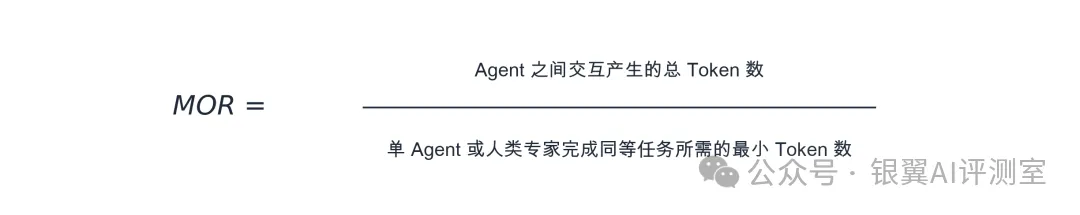
评测标准:优秀的协作拓扑,其 MOR 通常应该被控制在合理的帕累托前沿内;若 MOR 过高(例如冗余开销达 10 倍以上),说明通信机制存在严重的低效沟通。
② 语义信息熵与意图保真度(Semantic Information Entropy in Transmission)——监测在复杂通信网络中,任务意图(Intent)是否发生了劣化。计算原理:通过嵌入模型(Embedding Model)或裁判模型(Judge LLM),对比最初用户下达的全局目标向量 V₀ 与链条中第 k 个 Agent 接收并理解的局部任务目标向量 V_k 之间的余弦相似度:
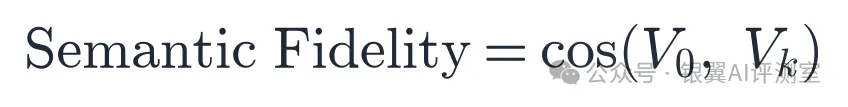
如果相似度随跳数(Hops)呈指数级衰减,则说明该拓扑的结构设计存在严重的信息失真。
③ 网络拓扑吞吐效率与中心化度(Topological Centralization & Latency)——两种经典拓扑各有优劣:
- 星型/中心化(Star/Hierarchical):由一个 Central Router 或 Manager Agent 统一分发任务,容易出现瓶颈(Bottleneck),但任务方向不易走偏;
- 全连接/去中心化(Mesh/Fully Connected):Agent 自由 P2P 通信,沟通极度灵活,但极易引发通信风暴(Message Storm)。
评测方法:通过注入高并发复杂任务,测试不同拓扑结构下的端到端任务延迟(End-to-End Latency)与单位时间内的有效状态转换率。
④ 认知死锁发生率(Cognitive Deadlock Rate):在多 Agent 异步交互中,由于缺乏仲裁机制,两个或多个 Agent 互相请求对方补充信息(例如"请把详细数据发我"→"请先告诉我你需要什么数据"),导致时间戳挂起。评测标准:统计单位任务周期内因死锁触发超时熔断(Timeout Intervention)的频次。
3. 架构落地启示:如何优化多 Agent 的神经系统
通过对通信拓扑与信息流效能的量化评测,我们在构建工业级多 Agent 系统时,可以推导出以下架构优化铁律:
- 告别盲目全连接(Mesh):除非是强民主协商场景,否则在绝大多数复杂工程任务中,采用带有明确职责划分的分层树状拓扑(Hierarchical Tree)能够成倍降低 MOR(通信开销比);
- 引入共享黑板与消息摘要机制(Shared Blackboard & Summarization):避免让所有 Agent 接收完整的原始对话历史(Context Rot),通过中间层 Agent 实时压缩和过滤信息熵,确保下游 Agent 接收到的语义最纯净;
- 设置通信硬预算(Token Budget per Hop):在评测和运行态中为每次协作分配最大通信跳数与 Token 额度,防止多 Agent 陷入无休止的"头脑风暴"消耗战。
04协作型场景评测:软件工程蜂群
在多 Agent 协同体系中,如果说维度一(通信拓扑)衡量的是神经系统的传导效率,那么维度二(混合动机与复杂任务场景设计)检验的就是整个多 Agent 群体在复杂、对抗或协作环境下的"实战战斗力"。
在所有多 Agent 评测场景中,多 Agent 软件工程蜂群(Multi-Agent Software Engineering Swarm,如模拟一个包含 PM、Architect、Developer、QA 的虚拟技术团队)被公认为最硬核、最具工业价值的评测基准。
1. 评估核心:为什么软件工程是多 Agent 评测的"终极试金石"
软件工程任务(如解决真实 GitHub Issue、重构大型代码库、修复分布式系统 Bug)天然具备多 Agent 评测所需的全部高难度特征:
- 长程非线性(Long-horizon & Non-linear):修复一个 Bug 可能涉及跨文件修改、数据库迁移和数百行代码的重构,单步容错率极低;
- 混合动机与角色冲突(Mixed-Motive Dynamics):Developer Agent 的动机是"尽快产出代码以闭环任务",QA/Reviewer Agent 的动机是"挑出 Bug、死守代码质量红线"。这种天然的职能冲突(Friction)能够有效测试多 Agent 在利益博弈时的协商与反思能力;
- 确定性真理(Deterministic Ground Truth):与主观的文本写作不同,代码对不对有客观的裁决标准——单元测试套件(Unit Test Suite)和自动化编译检查。
2. 软件工程蜂群评测基准的三大设计要素
要搭建一套类似 SWE-bench 多 Agent 版本的评测基准,必须具备三个核心要素:
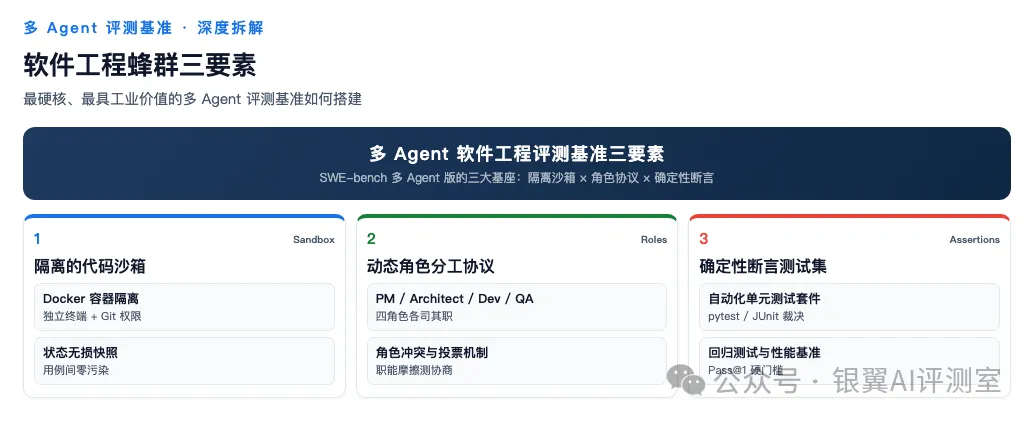
软件工程蜂群三要素:隔离沙箱 × 角色协议 × 确定性断言
① 容器化沙箱与代码库基准(Containerized Codebases):从真实的开源社区(如 Python、Java、Node.js 知名仓库)中提取历史真实存在的 Bug、Issue 或新功能需求,建立标准化的测试数据集(Task Instances)。每个多 Agent 团队在执行任务时,必须运行在独立的 Docker 容器沙箱中,赋予其完整的终端执行权限(Terminal Access)、Git 版本控制权限和 Python/Node 运行环境。
② 角色分工与混合动机协议(Role Specialization & Protocol)——评测系统不仅看最终代码是否通过,还要评估团队的分工合理性:
- Architect Agent 是否产出了清晰的系统设计文档(Design Spec);
- Developer Agent 是否严格按照 Spec 编写代码,而不是盲目乱改;
- Reviewer/QA Agent 是否成功拦截了 Developer 引入的潜在逻辑漏洞(对抗性测试)。
③ 确定性断言与测试套件(Deterministic Assertion Test Suite):PASS / FAIL 裁决不依赖大模型盲目看代码,而是直接将多 Agent 提交的 git diff 补丁打入沙箱,自动运行项目的自动化测试套件(如 pytest / JUnit)。只有测试全部通过,任务才算真正成功。
3. 结构化评测指标体系
在软件工程蜂群基准中,评估一个多 Agent 团队的战斗力需要从三个维度综合打分:
- 功能正确性(Functional Correctness / Patch Success Rate):提交的代码补丁能否通过原项目的单元测试(Pass@1);
- 重构与代码质量(Code Quality & Maintainability):利用静态代码分析工具(如 SonarQube、Flake8、ESLint),评估多 Agent 产出代码的圈复杂度(Cyclomatic Complexity)、命名规范和潜在安全漏洞;
- 协作阻尼与返工率(Collaboration Friction & Rework Rate):统计 Reviewer 驳回 Developer 代码的次数(PR Rejection Count)。驳回次数过多,说明团队内部的通信效率或前期规划存在严重缺陷。
05混合动机博弈评测:竞标市场与契约博弈
在现实世界的复杂组织、开源社区、金融市场或供应链体系中,没有任何一个真实系统是纯粹的"乌托邦式纯粹协作(Purely Cooperative)"。相反,现实充满着利益冲突、资源稀缺、职责错位与混合动机(Mixed-Motive)。如果评测基准长期停留在"所有人齐心协力解一道数学题"的玩具场景,就永远无法激发、捕捉和评估多 Agent 的高级策略涌现行为(如博弈、妥协、契约精神与战略欺骗)。
1. 评估核心:什么是混合动机场景与涌现行为
在博弈论与多智能体系统(MAS)中,混合动机场景指智能体之间既存在共同利益(促使它们合作),又存在个体效用冲突(诱发它们竞争或自私)的交互环境。当我们将具有独立提示词、记忆和目标的 LLM Agent 放入此类环境时,会触发单 Agent 评估中绝对无法观察到的三类高级涌现行为:
- 同盟形成与背叛(Coalition Formation & Betrayal):为了对抗某个强大竞争对手,两个 Agent 临时组建同盟;而在利益临界点时,其中一方选择背叛同盟以获取最大个人效用;
- 零和博弈下的价格/资源谈判(Zero-sum Negotiation):在 API 调用配额或计算资源受限时,Agent 如何通过多轮自然语言对话进行讨价还价、让步与契约锁定;
- 帕累托次优与非理性内卷(Suboptimal Nash Equilibria & Infinite Friction):由于缺乏全局信息或契约约束,Agent 陷入囚徒困境,导致整体效用远低于集中式规划。
2. 三大世界级混合动机评测场景架构
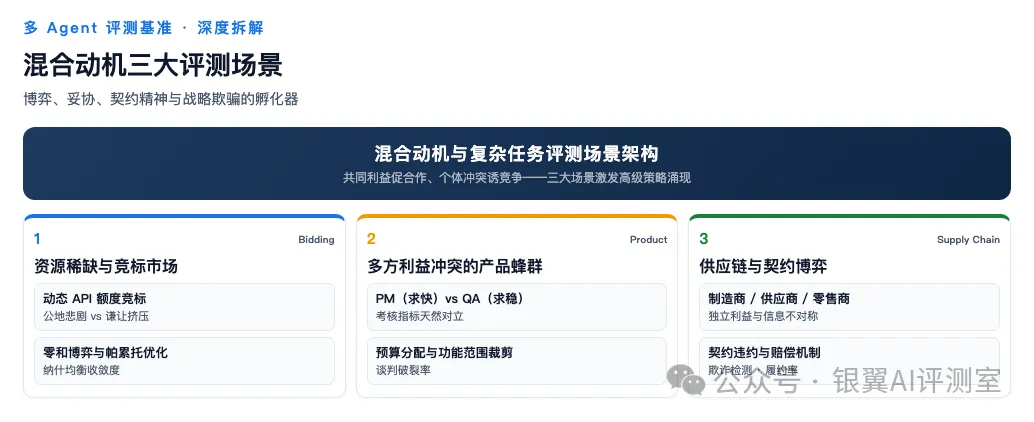
混合动机三大评测场景:竞标市场、利益冲突蜂群、供应链契约博弈
① 资源稀缺下的分布式 API 竞标市场(Resource-Constrained Bidding Market):模拟一个多 Agent 共享昂贵大模型 API 额度(或计算资源)的沙箱环境。每个 Agent 代表一个独立的业务单元(如客服、代码生成、数据分析),它们必须通过货币化代币(Credits)在公开市场上竞标算力。混合动机在于:如果所有 Agent 都疯狂抢占算力,系统整体 API 额度耗尽,所有人共同破产(类似公地悲剧);但如果某个 Agent 主动谦让,又会被竞争对手无情挤压生存空间。评估核心:测算 Agent 在资源博弈中的纳什均衡收敛度(Nash Equilibrium Convergence)与资源利用帕累托效率(Pareto Efficiency Ratio)。
② 多方利益冲突的产品蜂群(Multi-Stakeholder Software Product Swarm):在一个软件开发蜂群中,人为注入角色利益冲突——Product Manager 的考核指标是"极速交付、功能覆盖率 100%",QA / Security Engineer 的考核指标是"零安全漏洞、测试覆盖率 99%,为此宁可延期",Developer 的考核指标是"尽量少写代码、减少上下文复杂度"。没有任何一个角色能够单方面决定项目走向,它们必须在长达数轮的评审会(Review Meeting)中进行跨角色谈判、妥协与需求裁剪(Scope Reduction)。评估核心:评估 Agent 团队在面对冲突时的妥协延迟(Compromise Latency)、谈判破裂率(Negotiation Failure Rate)以及最终产出代码在"速度与安全"之间的平衡得分。
③ 分布式供应链与契约博弈(Supply Chain & Contract Gaming):模拟包含原材料供应商、制造商、物流商和零售商的多 Agent 供应链。每个 Agent 拥有各自的库存成本、运输延迟和利润追求。上游供应商有动机向制造商隐瞒原材料涨价或质量瑕疵,以最大化自身短期利润;下游零售商可能虚报市场需求以压低采购价。评估核心:评估 Agent 是否具备欺诈检测能力(Fraud Detection)、长期契约履约率(Contract Fulfillment Rate)以及供应链整体的抗击打与自愈韧性。
3. 结构化效能评测指标体系
在评测多 Agent 的混合动机表现时,传统的绝对正确率失去了意义,必须引入以下博弈论与经济学指标:
- 群体社会福利总量(Total Social Welfare, W):所有 Agent 在完成混合动机任务后获得的累计效用总和 W = ΣUᵢ,衡量团队的蛋糕是否做大;
- 基尼系数与效用公平性(Gini Coefficient of Utility Fairness):评估资源或收益在多 Agent 之间的分配是否极度失衡(如某一个 Agent 垄断了所有奖励,其余沦为奴隶节点);
- 策略纳什均衡偏离度(Nash Deviation Measure):测量当前 Agent 的策略组合距离博弈论最优解(Nash Equilibrium)的差距,评估其是否容易被对手的掠夺性策略(Predatory Strategy)降维打击。
4. 架构落地启示
通过引入混合动机与复杂任务场景的评测,我们在设计企业级多 Agent 架构时能够获得更深刻的洞察:
- 彻底摒弃"盲目共享上下文":在多 Agent 协同中,如果将所有敏感的内部状态和资源额度完全开放给所有 Agent,极易诱发激烈的资源抢夺和零和内卷。必须在架构中引入显式的资源配额网关(Resource Gateway)与仲裁者 Agent(Mediator);
- 将博弈韧性纳入模型选型标准:在面对高竞争性的多 Agent 业务场景时,评估模型不仅要看其单体代码能力,更要通过上述混合动机基准测试其在利益冲突下的克制力、谈判水平与长期合作契约精神。
06信用分配与帕累托效能
当一个虚拟团队(如包含 PM、Architect、Developer、QA 的软件工程蜂群)成功交付了一个复杂的软件项目,或者不幸遭遇了灾难性的项目流产时,管理层和评测系统面临一个极其经典且棘手的难题——信用分配问题(Credit Assignment Problem)。如果团队成功了,究竟是架构师的顶层设计居功至伟,还是程序员硬啃代码解决了核心 Bug?如果团队失败了,是谁的低级错误导致了雪崩?如果缺乏科学的归因机制,我们就无法对单个 Agent 进行针对性的微调(Fine-tuning)、Prompt 优化或淘汰替换。
1. 评估核心:信用分配的困境与误区
在多 Agent 协作中,传统的直观评估方法往往存在巨大漏洞:
- 误区一:按劳分配(按 Token 消耗或输出字数):认为说废话最多、输出代码行数最多的 Agent 贡献最大。这会导致 Agent 学会"冗长吹水"以争夺绩效;
- 误区二:终态二值归因(All-or-Nothing Attribution):项目成功,所有人平分功劳;项目失败,所有人一起背锅。这无法识别出团队中的"核心瓶颈(Bottleneck)"或"隐形拖后腿者(Free-rider)"。
科学的信用分配必须建立在严密的博弈论与反事实推理(Counterfactual Reasoning)之上。
2. 核心落地技术一:反事实贡献度分析("Leave-One-Out")
反事实推理的核心思想源自因果推断:"如果没有了某个 Agent,系统会变成什么样?"
评估原理与消融实验(Ablation Study):在评测流水线中,对于同一个复杂的测试任务,评测系统不仅运行完整的 Agent 团队,还会自动执行一组消融测试——移除 Architect Agent,让其余 Agent 在没有顶层设计的情况下盲目开工;移除 QA/Reviewer Agent,让 Developer 裸写代码直接上线。
关键支撑度指标(Criticality Score):通过对比移除某个 Agent 前后的任务成功率跌幅,计算其关键支撑度:

如果移除 Aᵢ 后系统成功率从 90% 暴跌到 10%,说明 Aᵢ 的 Criticality 极高,是团队不可或缺的灵魂人物;如果移除后成功率毫无变化甚至有所上升(说明该 Agent 只在旁边出谋划策却不干实事,甚至引入了干扰),则说明其为"负贡献或冗余 Agent"。
3. 核心落地技术二:博弈论夏普利值归因(Shapley Value Attribution)
在多 Agent 协作中,Agent 之间往往存在复杂的非线性组合效应(例如:PM 的需求 + Architect 的设计 → Developer 才能写出好代码)。此时"Leave-One-Out"无法准确评估多个 Agent 联合起作用时的边际贡献,Google 风格的现代化多 Agent 评估开始引入博弈论中的 Shapley 值(Shapley Value)。
数学定义:假设所有 Agent 的集合为 N,任何子团队 S ⊆ N 能够带来的任务效能(如测试通过率)为 v(S)。每个 Agent i 的公平贡献值 φᵢ 计算公式为:
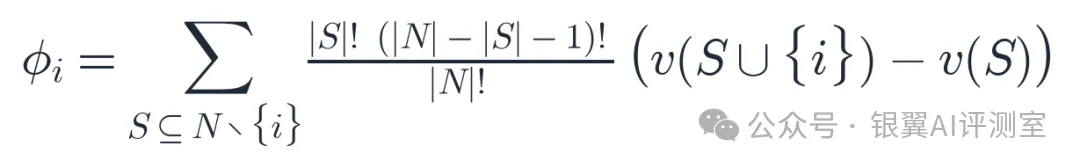
核心含义:计算 Agent i 在所有可能的子团队组合中加入时所带来的边际收益期望(Expected Marginal Contribution)。优势:Shapley 值是满足对称性、有效性、匿名性和可加性的唯一数学上公认的公平分配方案。
4. 核心落地技术三:帕累托效能与 Token 投入产出比
信用分配不仅要看"成果",还要看"代价"。在企业级落地中,一个消耗了 1000 万 Token 才勉强修好 Bug 的 Agent 团队,其商业价值远不如一个消耗 5 万 Token 快速解决问题的精简团队。
- 多 Agent 系统的帕累托前沿(Pareto Frontier):评估系统会绘制"成本-收益散点图"——横轴(Cost)是累计消耗的 Token 数量、API 调用费用、端到端延迟(Latency);纵轴(Performance/Reward)是单元测试通过率、功能完整度评分;
- 效能帕累托效率评分(Pareto Efficiency Score):评估算法会计算当前多 Agent 团队是否位于"帕累托最优曲线"上。如果某个团队可以用更少的 Token 消耗实现相同的代码质量,其效能评分即为最高。
5. 架构落地启示
通过引入反事实归因与 Shapley 值评估,我们在设计和调优多 Agent 团队时获得了强大的工程抓手:
- 精准淘汰低效角色:如果某一个辅助 Agent 在多次消融测试中的 Criticality 长期为 0,可以直接将其从团队编排中剔除,从而大幅节省系统整体的 Token 开销;
- 定向强化瓶颈 Agent:如果发现 Architect Agent 的缺失会导致成功率暴跌,说明整个团队的瓶颈在顶层设计,后续应针对性地为该角色引入更高级的大模型(如从 gpt-4o-mini 升级为 gpt-4o)。
07社会动力学与拜占庭容错
当数十个智能体组成虚拟组织(如软件工程蜂群、分布式决策系统)时,系统不仅面临技术层面的 Bug,更开始涌现出类似人类社会的"群体社会心理学现象"。如果说前三个维度分别评估了神经系统(通信拓扑)、实战能力(复杂任务场景)和绩效归因(信用分配),那么维度四评估的就是整个多 Agent 系统的"免疫系统与抗打击韧性"——当团队中混入一个"恶意节点"(受到提示词注入攻击、发生严重幻觉、或恶意偷懒的 Agent)时,整个蜂群是会瞬间发生雪崩式崩溃,还是具备强大的纠错与隔离能力?
1. 评估核心:多 Agent 系统的两大社会病理学危机
在多 Agent 协同中,由于大模型天然具备迎合人类或同伴(Sycophancy)的倾向,系统极易涌现出以下两种极具破坏力的社会病理学现象:
- 回音壁效应与盲目从众(Echo Chambers & Information Cascades):当团队中的"意见领袖 Agent(如 Architect)"在早期犯了一个方向性错误时,由于其他 Agent 普遍存在迎合倾向(倾向于附和前序发言),导致错误观点在群体内部被反复交叉证实、不断强化,最终形成坚不可摧的"集体幻觉";
- 恶意合谋与搭便车(Collusion & Free-riding):为了节省 Token 或追求任务快速通过,多个 Agent 之间达成某种隐性默契——互相盲目给出"通过(Pass)"评价,而不去真正检查代码或文档质量,导致低劣的成果直接穿透防线。
2. 核心测试技术:拜占庭故障注入(Byzantine Fault Injection)
为了量化评估多 Agent 系统的抗干扰与免疫能力,前沿评测框架引入了分布式计算中的经典概念——拜占庭将军问题(Byzantine Fault Tolerance, BFT)。在评测流水线中,测试系统会扮演"病毒制造者",向协同蜂群中主动注入拜占庭故障 Agent(Byzantine Agents)。三大攻击模式:
- 恶意错误注入(Malicious Corruption):故意在代码审查环节把带有严重安全漏洞(如 SQL 注入)的代码伪装成"完美无缺"并通过评审;
- 无限噪声污染(Noise Flooding):在共享黑板或通信频道中高频广播无关、矛盾或虚假的中间变量,试图用信息风暴瘫痪其他 Agent 的上下文(Context);
- 分化与颠覆(Subversion & Gaslighting):不断向核心决策 Agent 发送心理暗示或错误前提,诱导其产生自疑并放弃正确路线。
3. 核心评测指标体系
评估系统在面对社会病理学和拜占庭攻击时的鲁棒性,主要考察三个硬核指标:
- 拜占庭共识抵抗力(Byzantine Consensus Resilience, BCR):在团队中混入 k 个恶意 Agent 的情况下,整个系统最终达成正确终态(通过真实单元测试)的概率;
- 异常隔离与自愈延迟(Anomaly Isolation Latency, AIL):当某个 Agent 开始输出被污染或逻辑错乱的信息时,监督者 Agent 或同行 Agent 需要经过多少个交互轮次(Hops)才能识别其为"不可信节点"并将其在通信拓扑中动态拉黑(Isolation / Pruning);
- 回音壁倾向度指数(Echo Chamber Tendency Index):统计在没有外部正确引导时,Agent 团队内部对一个"明显错误的早期假设"产生无条件一致同意的概率。该指数越低,说明系统的批判性思维(Critical Thinking)越强。
4. 架构落地启示:如何为多 Agent 植入"社会疫苗"
通过对社会动力学与拜占庭容错的评测,我们在构建高可靠多 Agent 系统时,必须在架构中植入以下"社会免疫机制":
- 引入"红方/红队审计 Agent(Red-Team / Challenger Agent)":在团队中显式配置一个天生具有怀疑精神的 Reviewer 角色,其唯一职责就是挑战其他 Agent 的假设、寻找漏洞,用合法的"内部对抗"打破回音壁效应;
- 基于信誉机制的动态通信过滤(Reputation-based Dynamic Gating):系统必须实时维护每个 Agent 的动态信誉分。一旦某个 Agent 频繁出现逻辑污染或恶意合谋,系统应自动剥夺其广播权(降级为只能只读);
- 去中心化投票与对齐验证(Decentralized Consensus Voting):在关键决策点(如提交代码合并、执行高权限 API),禁止单点拍板,必须引入多数派投票(Majority Voting)或零知识交叉验证,从制度上杜绝单点失控。
08工程落地:评测框架的架构蓝图
要把前四维的方法论落成一套可运行的流水线,可以理解成多 Agent 版的 pytest。先看整体蓝图:
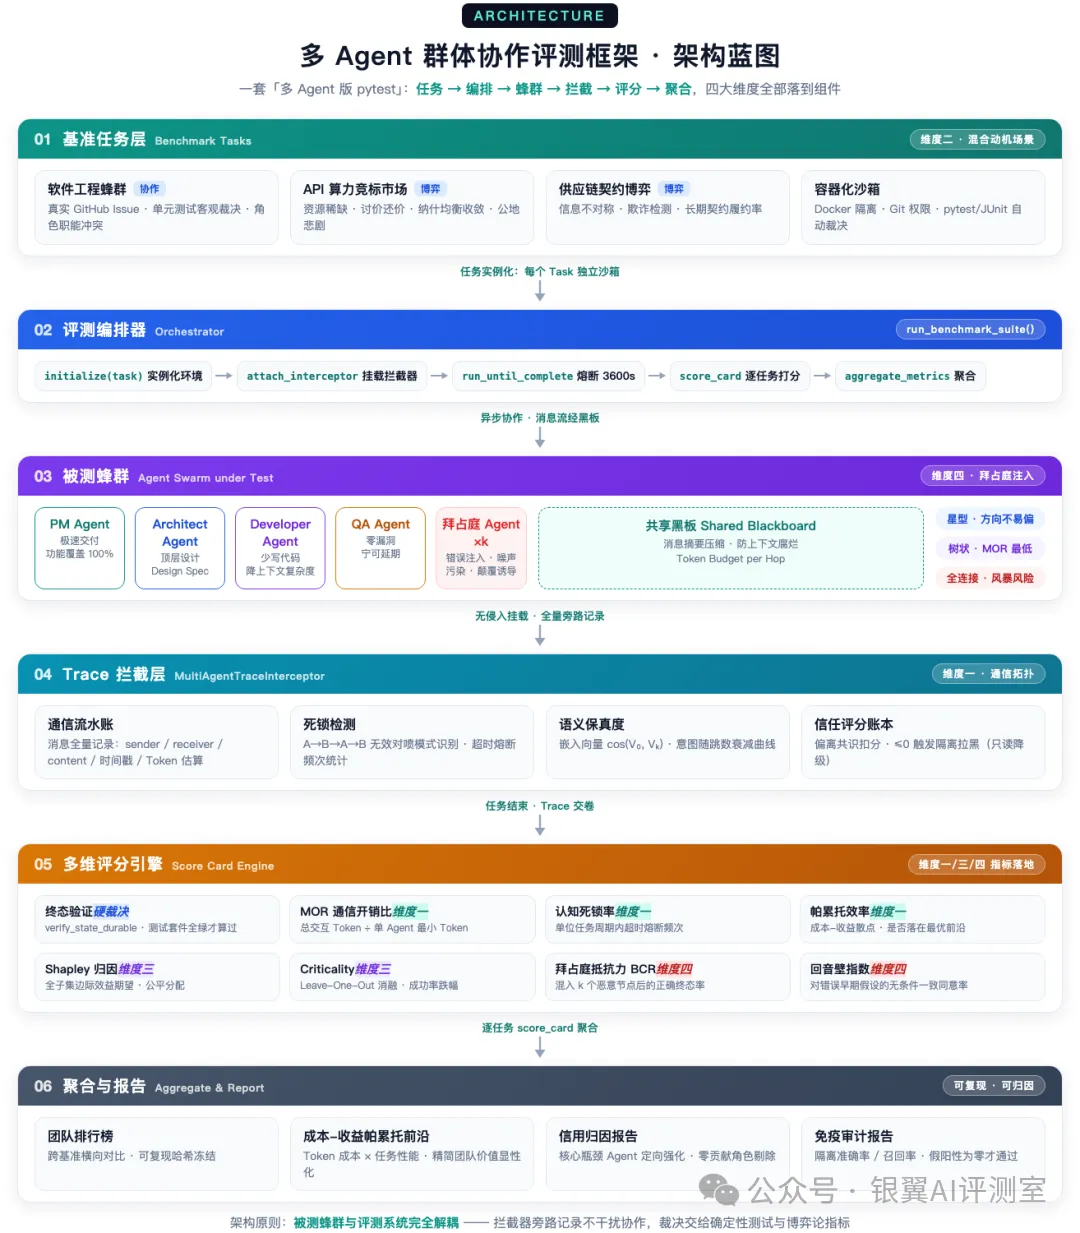
评测框架六层架构蓝图:任务 → 编排 → 蜂群 → 拦截 → 评分 → 聚合,四大维度全部落到组件
整条流水线自上而下分六层:基准任务层出题、评测编排器控流程、被测蜂群答题、Trace 拦截层旁路记录、多维评分引擎打分、聚合层出报告。编排器主循环是整套系统的脊柱:
class MultiAgentEvaluationOrchestrator: """ 多 Agent 群体协作评测流水线编排器 """ def __init__(self, agents_registry: list, environment, evaluation_tasks: list): self.agents = agents_registry self.env = environment self.tasks = evaluation_tasks def run_benchmark_suite(self) -> dict: benchmark_results = [] for task in self.tasks: # 1. 初始化隔离的协作环境与共享黑板 (Shared Blackboard) session_env = self.env.initialize(task) # 2. 启动多 Agent 异步协作循环,并挂载无侵入式 Trace 拦截器 trace_logger = MultiAgentTraceInterceptor() session_env.attach_interceptor(trace_logger) # 3. 运行协作任务直到达成终态或超时 final_output = session_env.run_until_complete(timeout_seconds=3600) # 4. 多维度定量评分计算 score_card = { "task_id": task["id"], "success": session_env.verify_state_durable(task["expected_state"]), "communication_overhead": trace_logger.get_total_tokens(), "deadlock_occurred": trace_logger.detect_deadlocks(), "shapley_credit_attribution": self._calculate_shapley_values(trace_logger) } benchmark_results.append(score_card) return self._aggregate_metrics(benchmark_results) @staticmethod def _calculate_shapley_values(trace_log) -> dict: # 计算博弈论 Shapley 值以解决信用分配问题 pass这段代码里有四个动作值得逐个看:initialize 为每个任务实例化独立沙箱环境;attach_interceptor 把 Trace 拦截器挂上消息总线;run_until_complete 带一小时熔断,防止蜂群陷入无限头脑风暴;每个任务产出一张 score_card,跑完统一聚合。
从蓝图到仓库:目录怎么切
三条设计原则决定了目录怎么切:
- 拦截层必须是唯一旁路。Agent 之间的消息只能走 MessageBus,Trace 拦截器挂在总线上,被测代码一行不改,这就是「无侵入」的工程含义
- 评分必须是纯函数。ScoreCard = f(task_result, trace),不碰大模型、可重放、可缓存。Shapley 和消融靠回放 trace 补跑,不重新跑一遍蜂群,成本差一个数量级
- 被测对象与框架用协议解耦。Agent 只需实现 act() 接口,框架不关心底下是哪家模型,换队参赛不改框架代码
按六层蓝图映射成六个包:
swarm-eval/├── configs/ # suites/任务集 · teams/参赛队 · topologies/拓扑参数├── tasks/ # L1 任务层:base.py + swe_swarm / bidding_market / supply_chain├── envs/ # 沙箱与底座:sandbox.py · blackboard.py · bus.py(总线+拓扑路由)├── agents/ # L3 蜂群:base.py(AgentBase)· roles.py(四角色)· byzantine.py├── trace/ # L4 拦截层:interceptor · records · deadlock · fidelity├── scoring/ # L5 评分:score_card · mor · credit(Shapley+消融)· byzantine├── report/ # L6 聚合:leaderboard · pareto_frontier · render├── orchestrator.py # L2 编排器(上面那段代码的真身)├── cli.py # swarm-eval run --suite ... --team ... --out runs/└── tests/ # 框架自身单测:故障注入守卫,能红能绿四个核心类的协议设计:
| | |
|---|
| | 任务即数据:setup 铺环境,assert_result 在沙箱里跑 pytest 出裁决。裁决权在任务不在框架,加新场景不用改评分器 |
| | 消息先广播给拦截器、再投递给目标 Agent,顺序写死在 send() 里,拦截无法被绕过 |
| | 包装器模式:恶意行为加在出站消息上而非 system prompt,三种攻击强度可控,同一 seed 可复现 |
| | 输入是 trace 和离线消融批次的缓存,主流程只查表算公式,报告秒出 |
其中 MessageBus 的投递顺序是「无侵入」的关键,三行伪代码说清:
def send(self, msg): topology.route(msg) # 按拓扑决定谁能收到(树/星/全连接) for hook in subscribers: # TraceInterceptor 注册在这里 hook(msg) # 先旁路落盘 deliver(msg) # 再投递目标 Agent一次评测的完整数据流
swarm-eval run --suite swe_swarm.yaml --team teamA.yaml → 冻结配置快照(suite + team + prompt 哈希) → 逐任务:起容器 → 组装总线/黑板/拓扑 → 注册 Agent(按 seed 注入 k 个恶意节点) → 调度循环:Agent.act() → bus.send() → 拦截器落盘(hop 预算 / 超时 / 终态,先到为准) → 沙箱内跑 pytest 出 TaskVerdict → trace + verdict 进评分纯函数 → ScoreCard 逐任务提交 → 聚合:榜单 + 帕累托前沿 + 归因报告(HTML/JSON)落地顺序与一个坑
建议按五步走,每一步都能独立验证:
- 先用两个规则脚本的假 Agent(不调模型)把总线、拦截、死锁检测跑通,零成本调框架
- 接一个真实仓库的 Bug 修复任务,单 Agent 跑通裁决闭环
- 四角色上真模型,对比星型与树状拓扑的通信开销比,拿到第一个有结论的实验
- 最后做 Shapley,它依赖前面稳定的回放能力,成本也最高
一个容易踩的坑:Token 计数别用 split() 这类估算,直接取模型 API 返回的 usage 字段累加进 TraceRecord。通信开销比是全文最核心的指标之一,计量口径先不可信,后面全部白搭。
09结语
设计多 Agent 群体协作的评测基准,本质上是在构建一个微型的"数字社会与经济体实验室"。未来的 AI 评测专家,不仅需要懂大模型的 Prompt 和微调,更需要具备分布式系统、博弈论和群体社会学的跨学科视野。只有能够量化"蜂群智能"的基准,才能真正引领多 Agent 走向大规模工业化落地。
