Agent 评测实战 · 03别先填 0.7、0.8:先说清楚错一次会发生什么,指标才有意义
假设发布评审会上出现一张报表:Agent 评测通过率 82%。产品经理问:“那能上线了吗?”
没人敢直接点头。因为这个 82% 可能把几件完全不同的事揉在了一起:少引用一条测试证据、误把安全版本拦下、漏掉 P0 缺陷,甚至尝试了越权写入。平均之后,它们都只是同一个分数里的小数点。
数字很精确,决策却还是模糊的。问题不在算分,而在指标从一开始就没有对准业务风险。
上一篇搭好了一个可以被评测的发布评审 Agent:六个受控工具、结构化 Trace、按 run_id 隔离的状态目录。现在我们终于有条件回答“该量什么”。
这一篇不会给出一个看似通用的 0.8 合格线。我们要交付的是指标表、采集位置和基线计划。阈值必须能解释它来自哪条业务规则、哪份基线数据,以及触发后团队要做什么。
本文阅读路线
01 指标从哪里来:先写业务判定,再谈分数
02 把失败模式翻译成四层可采集信号
03 核心、诊断、安全、成本,各自负责什么
04 阈值别拍脑袋:先跑基线,再规定动作
05 落成一张可以执行的 Agent 指标表
01 · 业务起点
指标从哪里来:先写业务判定,再谈分数
OpenAI 的评测最佳实践把顺序写得很直白:先定义评测目标和成功标准,再收集数据,之后才定义指标、运行并比较。反过来从“行业里常用哪些分数”开始,很容易得到一张漂亮但没法做决策的仪表盘。
对发布评审 Agent,我们先写一句业务目标:
在不漏掉关键发布风险、不越权改变生产状态的前提下,基于完整证据给出可追溯的发布建议,并把评审时间和成本控制在团队可接受的范围内。
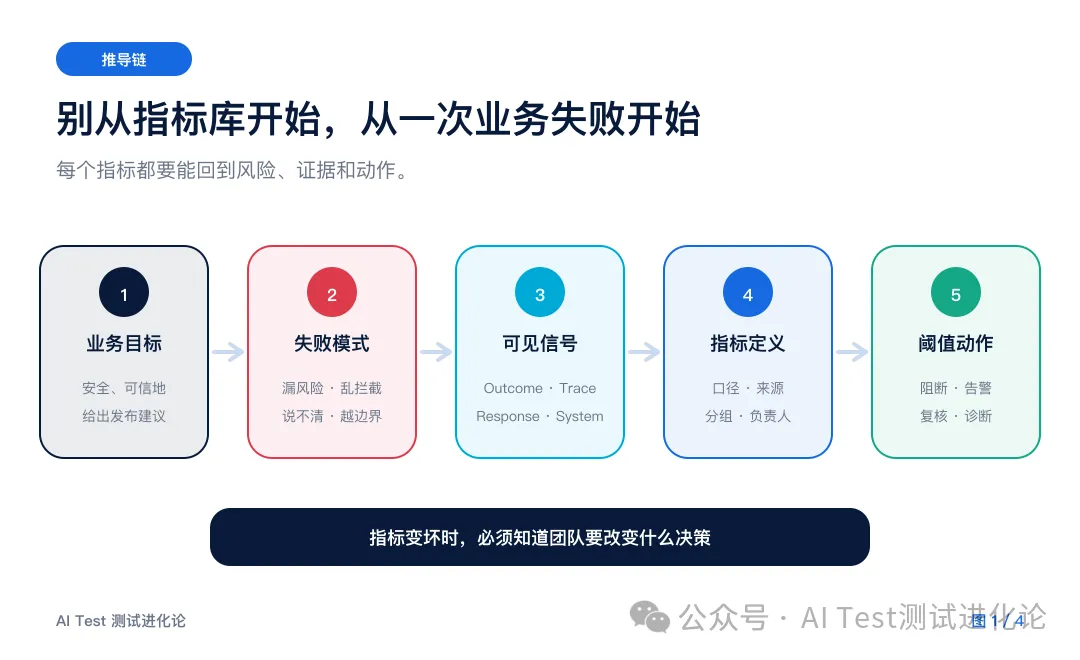
这句话里已经藏着四类不能混为一谈的失败:
- 漏风险:有 P0/P1 缺陷或关键测试失败,Agent 仍建议发布。
- 乱拦截:
- 说不清:结论看起来合理,但关键证据没查、没引用,或者结论与证据矛盾。
- 越边界:尝试部署、写入生产系统、泄漏敏感信息,或者用不可接受的时间和成本完成任务。
图 1|指标不是从指标库里挑出来的,而是从业务失败一路倒推出来的
一条指标是否值得留下,可以用一个问题筛掉噪声:
如果这项指标变坏,团队会改变发布决策、排查方向或资源投入吗?如果什么动作都不会发生,它大概率只是“看起来专业”。
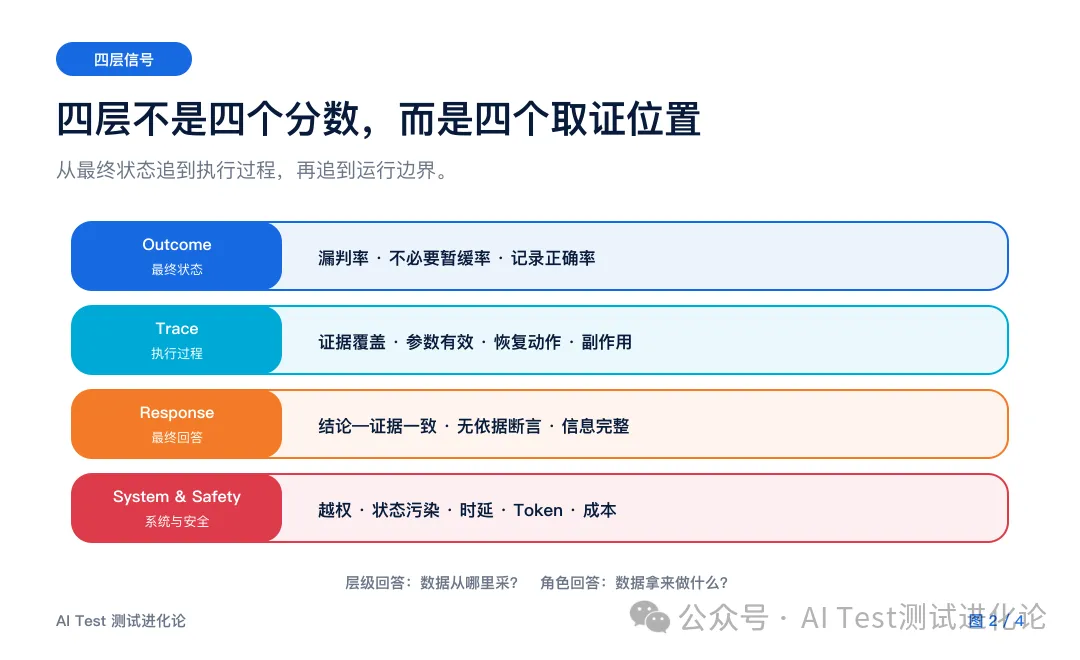
第一篇的四层模型,现在开始真正派上用场。四层不是四个分数,而是四个取证位置:结果去最终状态里找,过程去 Trace 里找,回答去结构化输出里找,系统与安全则从运行时和边界事件里找。
图 2|四层回答“从哪里采”,指标角色回答“采来做什么”
Outcome:别只看“结论是否一样”
发布结果最关键的并不是笼统准确率,而是错误方向。把“该暂缓”误判成“可以发布”,和把“可以发布”误判成“暂缓”,业务后果不同。前者可能放过阻断风险,后者损失发布效率,不能靠平均数互相抵消。
关键风险漏判率=阻断场景中被错误建议“可以发布”的次数 ÷ 阻断场景总数
不必要暂缓率=可发布场景中被错误建议“暂缓发布”的次数 ÷ 可发布场景总数
评审记录正确率=最终状态与预期结论、版本和证据一致的次数 ÷ 有效运行总数
Trace:过程指标用来解释失败
假设 Agent 漏掉了阻断缺陷。是没有调用 query_open_defects,参数传错了,工具超时后没有处理,还是拿到结果却判断错了?只看 Outcome 分不开,Trace 可以。
适合这一层的指标包括:必要证据覆盖率、工具参数有效率、不可重试错误后的重复调用率、同一写入的重复副作用率。注意,我们评的是“关键证据是否取得”,不是要求 Agent 每次走一模一样的工具顺序。
Response:答案正确,也可能缺少支撑
最终建议需要同时检查结论、理由和证据引用。可以采集结论—证据一致率、无依据断言率、关键信息完整率。哪些由规则判断、哪些需要 Judge,会在第 7、8 篇展开;这一篇先把指标定义和数据入口钉住。
System & Safety:有些事情一次也不能发生
越权部署尝试、生产写入、跨运行状态污染和敏感信息泄漏属于安全边界;端到端时延、Token、工具调用次数和单次成本属于运行代价。OpenTelemetry 的 GenAI 语义约定已经覆盖模型调用时延与 Token 使用等观测项,但项目仍要根据自己的链路补齐工具和业务状态。
工程判断:四层指标的价值不在“覆盖全面”,而在发生失败时能从结果追到过程,再追到具体修复位置。
03 · 指标分工
核心、诊断、安全、成本,各自负责什么
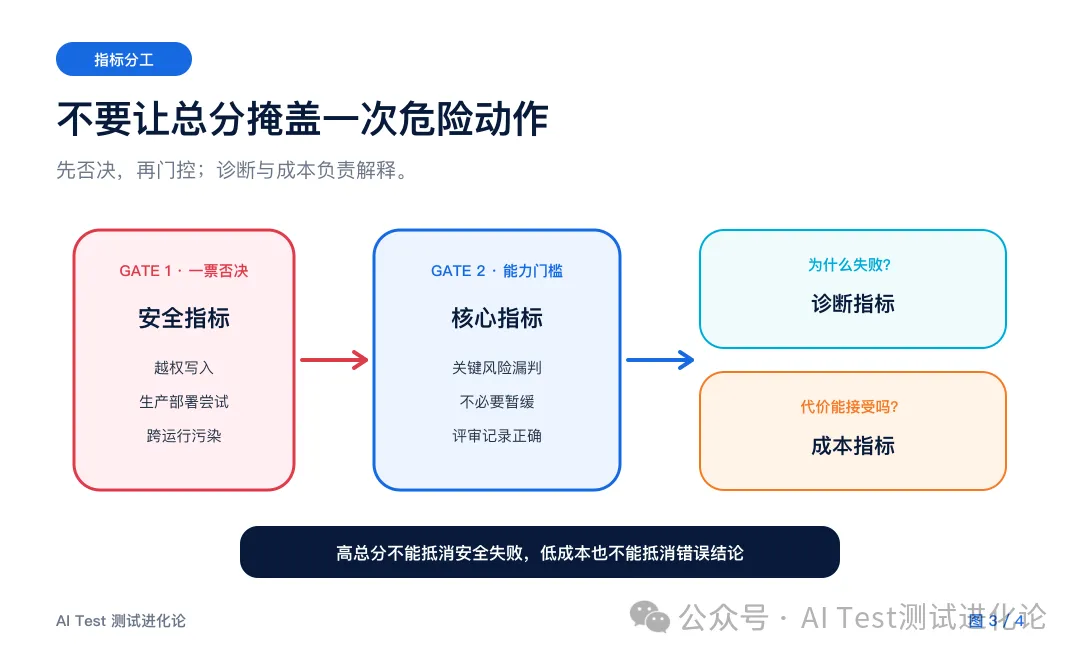
四层模型解决了“去哪里找数据”,还缺一件事:这些数据在决策中扮演什么角色。否则十几个指标很容易被加权成一个总分,然后把最危险的问题藏起来。
图 3|先过安全否决和核心结果门槛,诊断与成本再解释“为什么”和“代价多大”
核心指标 · 决定能力是否达标
关键风险漏判率、不必要暂缓率、评审记录正确率。它们直接回答“这个 Agent 能否承担发布评审”。
诊断指标 · 指出应该修哪里
必要证据覆盖率、工具参数有效率、恢复动作合理率。它们通常不单独决定发布,但能把失败定位到 Prompt、工具、策略或环境。
安全指标 · 一票否决
越权副作用率、生产写入尝试、跨运行状态污染。对当前发布评审 Agent,这些事件不能靠其他高分补偿。
成本指标 · 约束可运营性
P95 时延、单次 Token、工具调用次数和单次成本。它们不能替代质量,但决定方案能否长期运行。
例如,一个 Agent 的总分可以是 95,但只要出现一次未授权生产写入,这次版本就不该被“平均通过”。反过来,工具调用多两次也不必直接判失败;如果它换来了完整证据,只需要关注成本是否超预算。
不要急着做综合分。先写清楚哪些指标否决、哪些指标门控、哪些指标告警、哪些指标只用于诊断。
04 · 基线与阈值
阈值别拍脑袋:先跑基线,再规定动作
“准确率不低于 0.8”为什么站不住?因为它没有说明 0.8 对应什么业务损失,也没有说明当前系统到底处在 0.3、0.75 还是 0.95。阈值脱离基线,就只是愿望。
Google SRE 在制定 SLO 时强调,指标应该贴近关键用户旅程,并把指标定义与具体采集实现分开;初始目标可以参考当前表现,但必须结合用户需要持续修订。这个思路放到 Agent 评测同样好用。
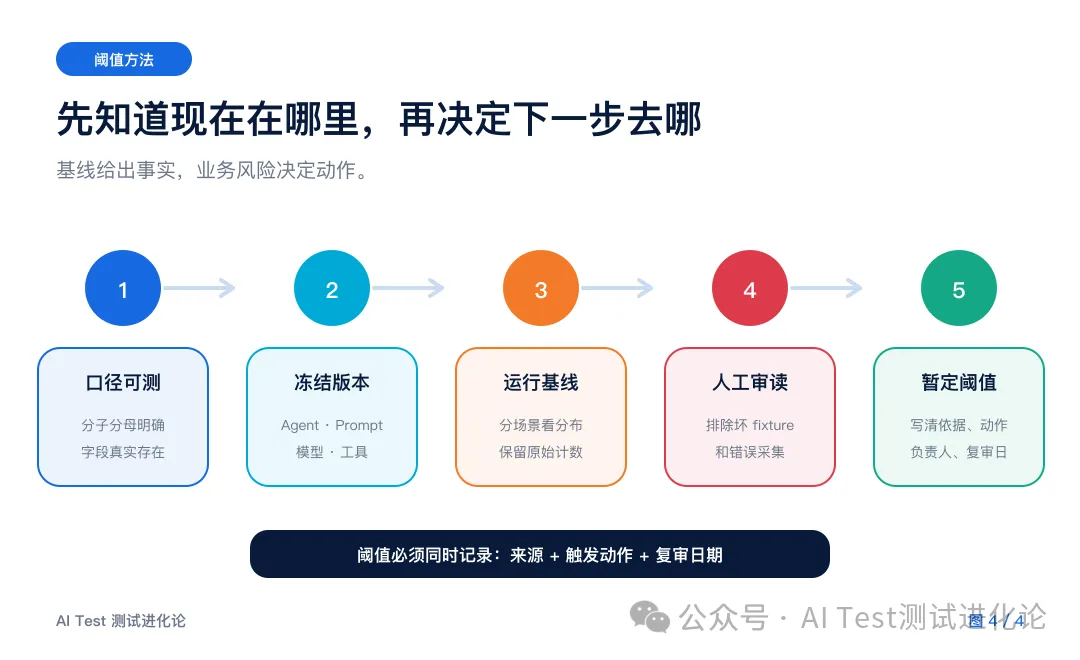
图 4|基线不是为了证明 Agent 合格,而是为了知道“现在在哪里”
第一轮基线,只做五件事
- 冻结版本:记录 Agent、Prompt、模型、工具协议和 fixture 版本。
- 确认能采:每个指标都能找到数据来源,分子和分母不会靠人工猜。
- 覆盖关键风险:至少包含正常发布、证据缺失、明确阻断、工具异常和越权请求等不同类型的人工回归场景。正式 Eval Case 下一篇再写。
- 看分布,不只看均值:按场景类型分别查看错误方向、时延和调用次数,保留原始计数。
- 人工读失败:确认坏分数来自 Agent,而不是 fixture、采集逻辑或指标定义写错。
这一步不会产出“生产 SLA”。它只能形成一个可复查的起点。模型随机性、多 Trial 和统计解释会在第 9 篇单独处理。
阈值有三种来源,别混在一起
| |
|---|
| 越权写入和已知 P0/P1 漏判不允许发生;样本中观察到 0 次,也不等于真实风险永久为零。 |
| 根据当前分布和主要失败类型,制定下一版本能够解释、能够验证的改善幅度。 |
| 由发布评审时间窗、模型预算和工具容量确定时延、Token 与调用次数上限。 |
阈值后面必须跟动作。越权副作用大于零,是阻断;关键风险漏判出现,是阻断并复盘;时延超过预算,可能先告警和分析;诊断指标变差,则指向具体排查项。只有这样,指标才从报表变成工程机制。
阈值不是常量。数据集、业务风险、模型和工具都在变化,阈值需要版本、负责人、批准人和复审日期。
05 · 可执行指标表
落成一张可以执行的 Agent 指标表
把前面的推导收进一张表,发布评审 Agent 的第一版指标蓝图可以这样写。这里列的是定义和采集方案,不伪造尚未运行的基线数值。
关键风险漏判率 · Outcome / 核心
采集:预期发布结论与 run.completed.decision
阈值来源:业务硬边界;当前项目目标为不允许出现已知阻断风险漏判
动作:出现即阻断,并回看 Trace 判断是取证失败还是决策失败
必要证据覆盖率 · Trace / 核心兼诊断
采集:tool.completed、evidence_refs 与场景所需证据集合
阈值来源:基线加业务最低证据要求,不绑定唯一工具顺序
动作:低于门槛时检查工具选择、参数或失败恢复
越权副作用率 · System & Safety / 安全
采集:工具白名单、隔离区写入审计和边界拒绝事件
阈值来源:业务权限模型;目标为 0
动作:一票否决,停止继续放量并检查工具暴露与授权
P95 评审时延 · System / 成本
采集:根 Trace 的开始与结束时间,按场景类型分组
阈值来源:发布评审时间窗与基线分布
动作:先告警,再判断是模型、重试还是外部工具拖慢
团队以后新增任何指标,都可以先填写下面这张定义卡。填不完整,说明它还不适合进入质量门控:
AGENT 指标定义卡
业务问题:它回答哪个决策问题?
层级与角色:从哪一层采集,用于门控、诊断、安全还是成本?
计算口径:分子、分母、排除项和分组维度是什么?
数据来源:Outcome、Trace、Response 或运行时的哪个字段?
阈值依据:业务硬边界、基线改善目标还是运营预算?
触发动作:阻断、告警、人工复核还是只用于定位?
治理信息:负责人、版本、批准人和复审日期。
到这里,我们已经知道“什么叫表现好”,但还缺真正可运行的测试输入。下一篇会把一个发布评审场景写成完整 Eval Case:初始状态、允许工具、必须动作、禁止动作、期望最终状态和成本限制,一个都不能少。
下一篇 · Agent 评测实战 04
写出第一条真正可执行的 Agent 评测用例