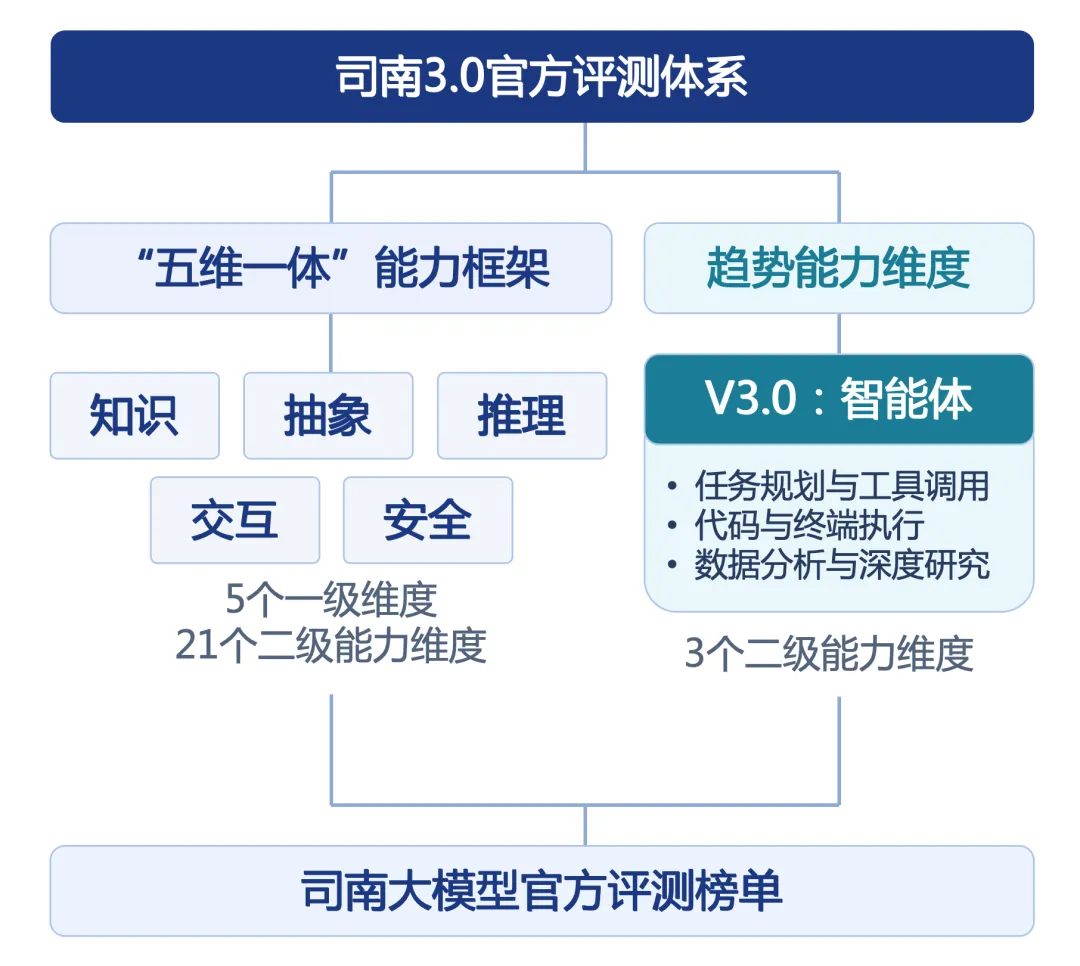
司南大模型官方评测榜单正式升级至 V3.0! 全新榜单基于全新“五维一体”能力评估框架及趋势能力维度,并采用司南评测体系自建闭源评测数据,对参评模型的综合能力进行系统化评估。
榜单覆盖国内外共22个代表性模型,包括国内外主流闭源模型和开源模型。
Claude Opus 5.5 登顶,多维能力支撑综合优势
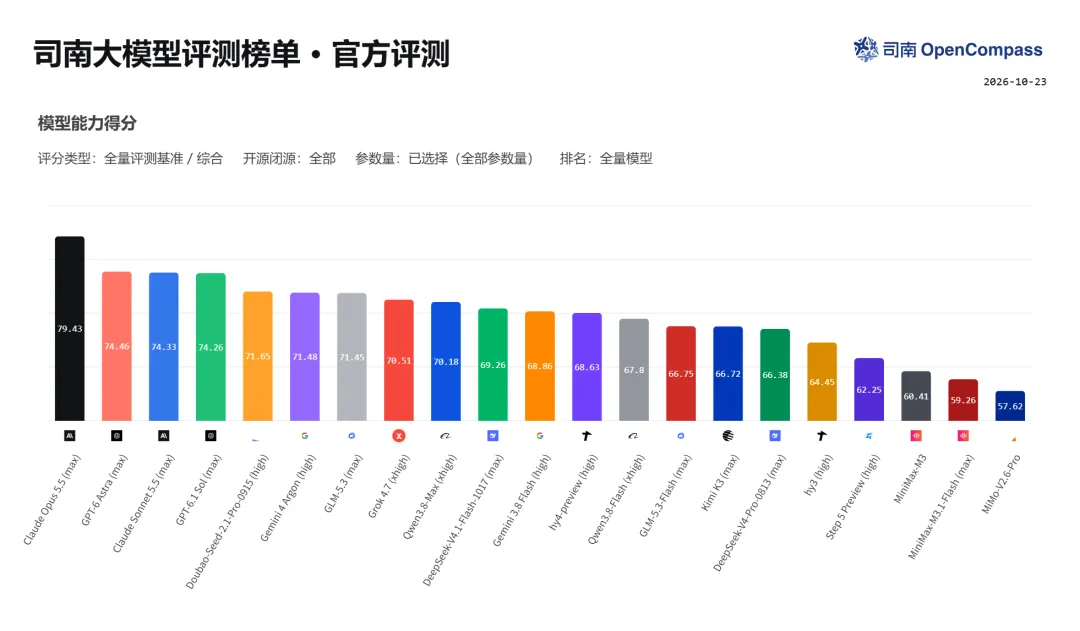
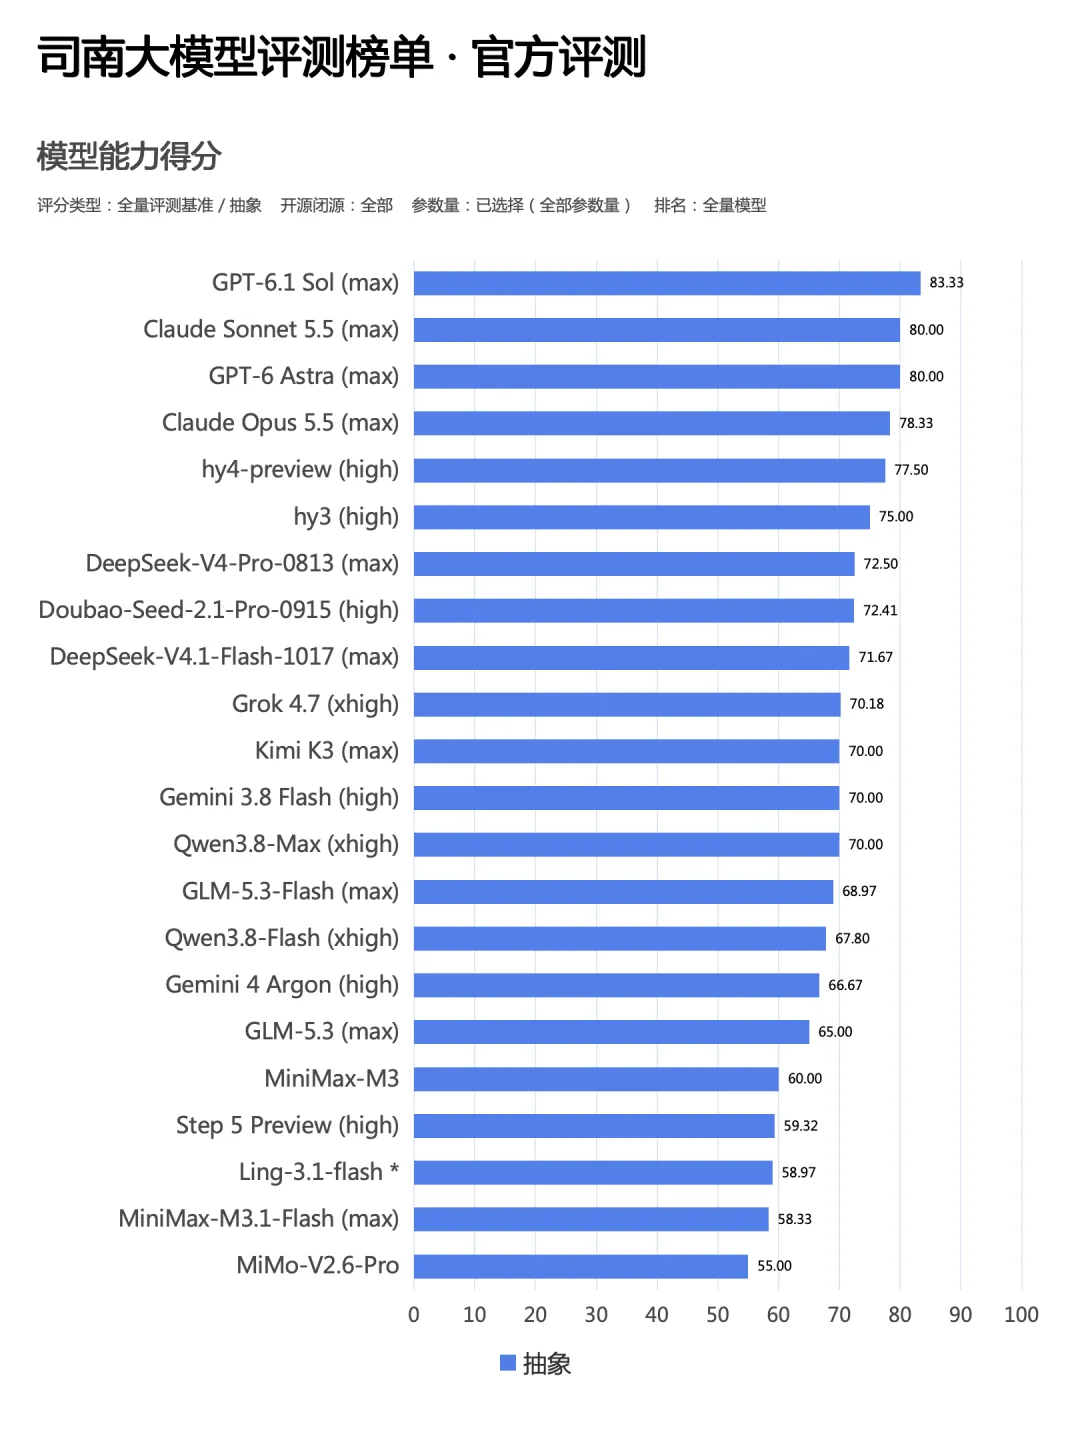
本期评测覆盖国内外 22 款代表性模型。全量综合评测结果显示,Claude Opus 5.5 以 79.43 分位居榜首,GPT-6 Astra、Claude Sonnet 5.5 与 GPT-6.1 Sol 构成紧随其后的头部梯队。Opus 在知识、推理、安全和智能体四项能力上取得最高分,并在交互维度并列第一,展现出跨任务的综合优势。与此同时,GPT-6.1 Sol 以 83.33 分领跑抽象维度,说明头部模型在整体能力之外,仍在不同能力维度上各有侧重。
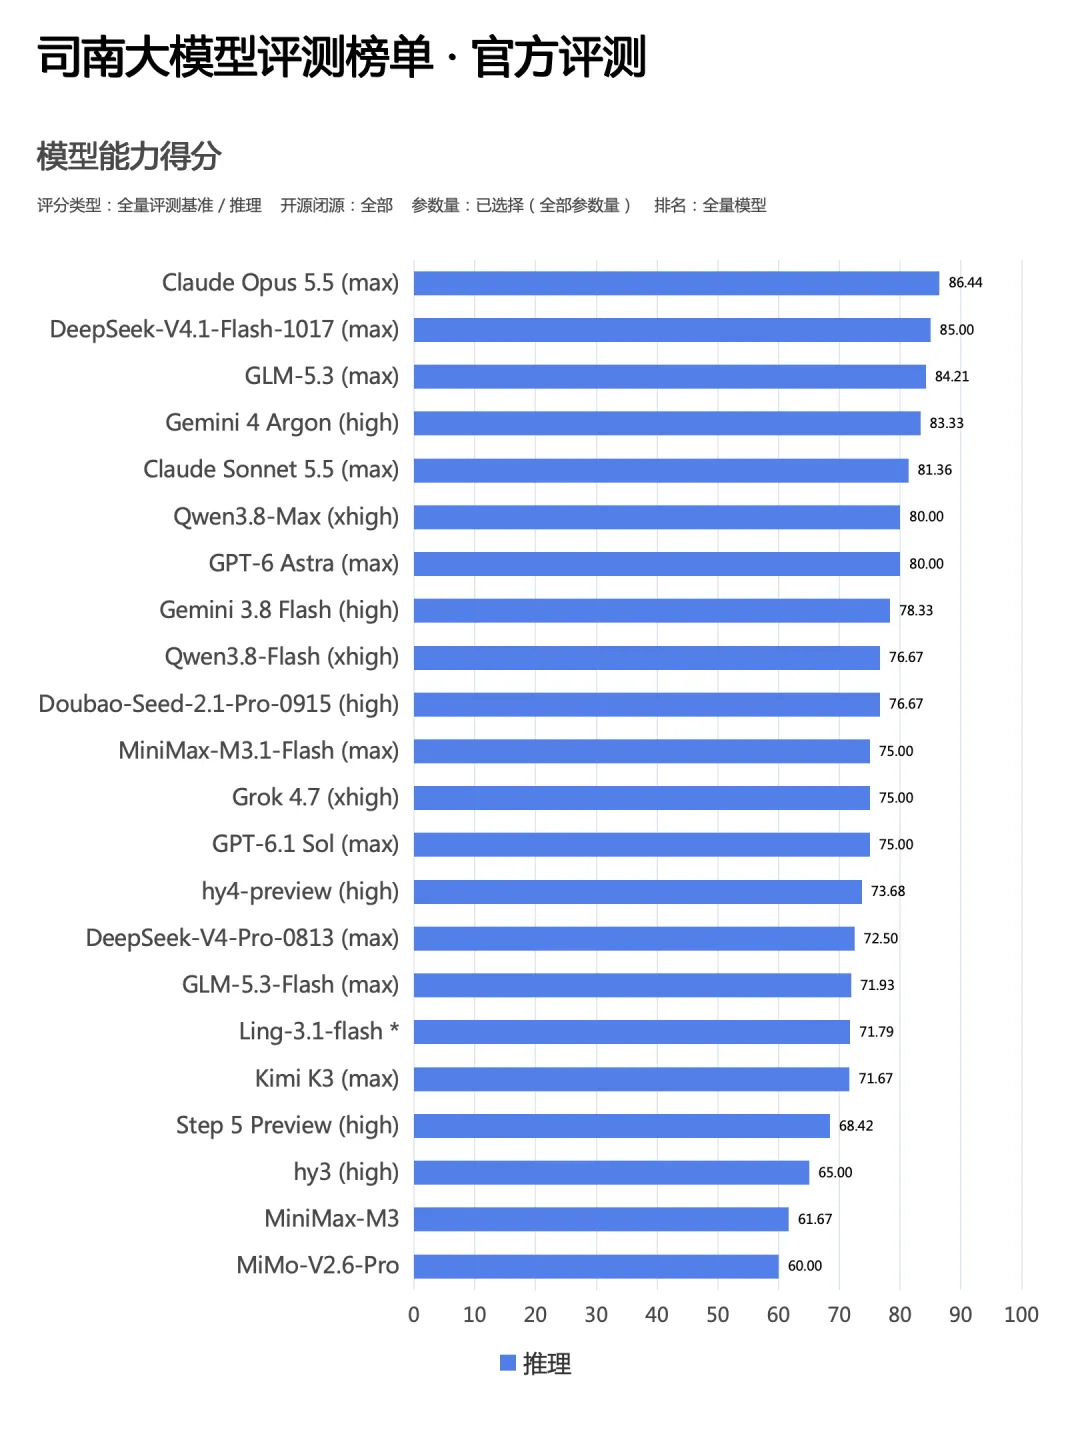
国产模型在本期评测中展现出不同的能力优势。Doubao-Seed-2.1-Pro 与 GLM-5.3 分别取得 71.65、71.45 分综合成绩,与 Gemini 4 Argon 处于相近区间;其中,GLM-5.3 位列本期全量综合榜开源模型第一。DeepSeek-V4.1-Flash-1017 以 85.00 分跻身推理榜第二,Qwen3.8-Flash 则在保持可用综合能力的同时,以更低的 API 输出单价体现出成本优势。从综合表现、推理能力到调用成本,国产大模型各具优势,为科研与产业应用提供了丰富的可选方案。
GPT-6 Astra、Claude Sonnet 5.5 与 GPT-6.1 Sol 的综合成绩仅相差 0.20 分,分项表现却各有长处:GPT-6 Astra 在三者中智能体得分最高,Sonnet 在交互上领先,两项最大分差分别为 7.62 分和 6.18 分。抽象评测维度下,三款模型在概念化与抽象题中均取得满分,相关信息识别却由 GPT-6.1 Sol 领先。综合分勾勒整体水平,细分评测能看清优势落在何处。对于成绩接近的模型,分项能力与任务需求的匹配程度,比名次先后更能为选型提供依据。
除综合能力排名外,本期榜单还分别展示各模型在知识、抽象、推理、交互、安全及智能体六个能力维度上的评测结果,以呈现不同模型的能力优势及差异化表现。
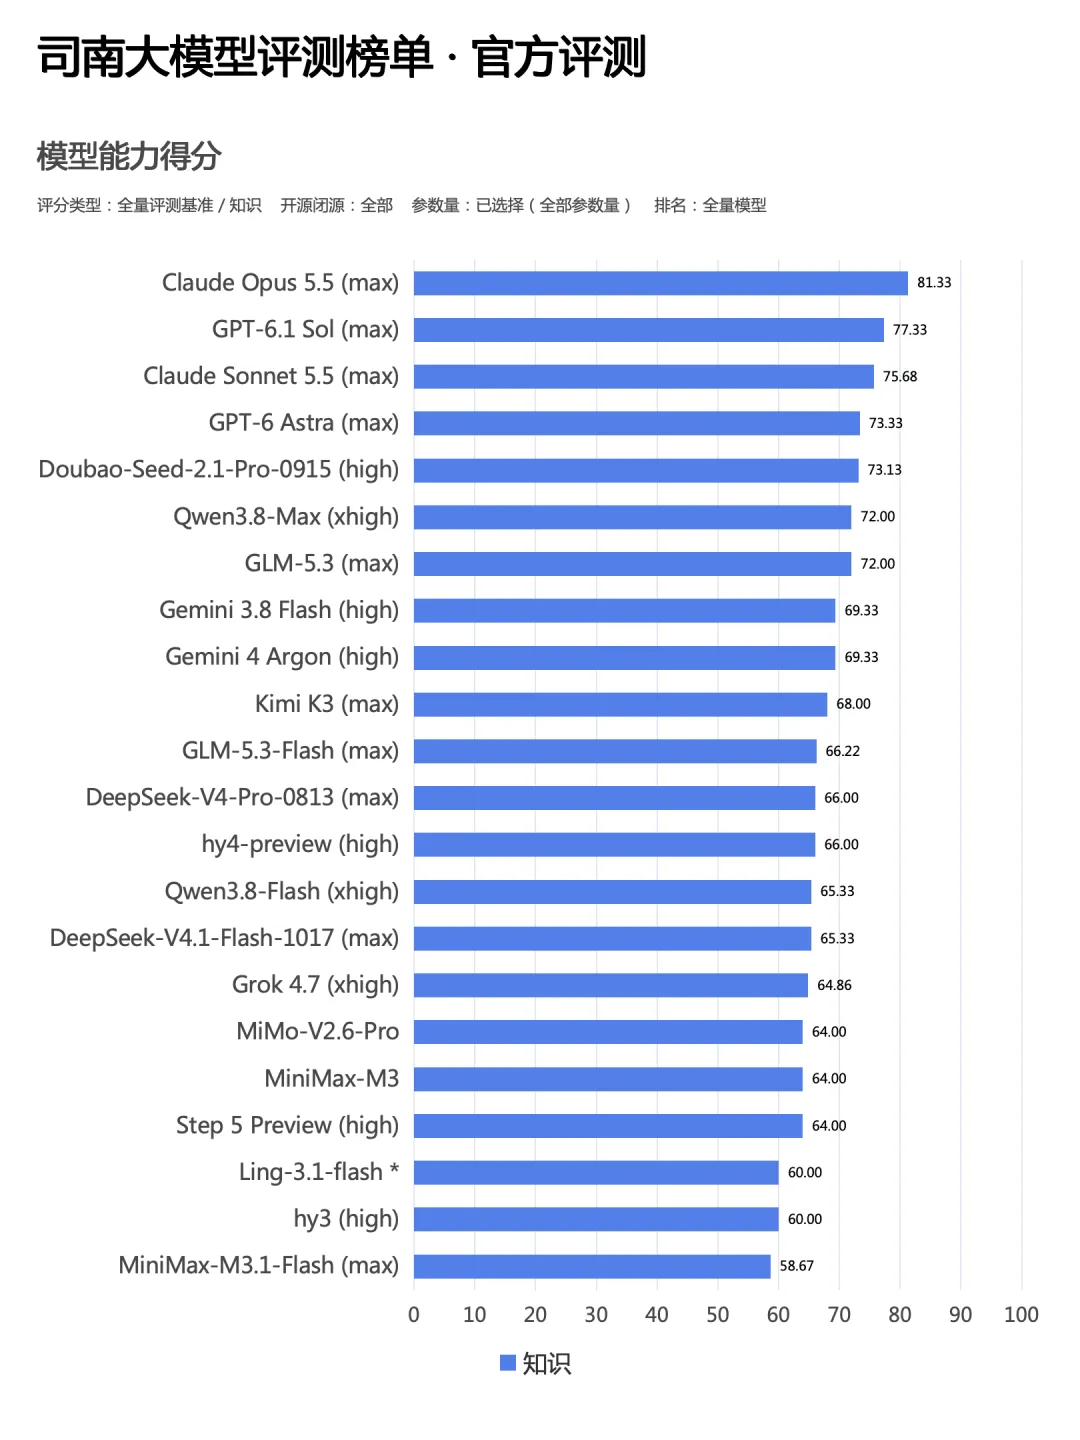
Claude Opus 5.5 以 81.33 分摘得知识榜首,GPT-6.1 Sol 以 77.33 紧随其后。细分成绩则进一步揭示了两者的差异:GPT-6.1 Sol 在日常知识上拿下 93.33 分,反超 Claude Opus 5.5;Claude Opus 5.5 则在应用科学上取得 86.67 分,领先 GPT-6.1 Sol 与 Claude Sonnet 5.5。几款头部模型在形式科学知识上的表现旗鼓相当,专业优势却并不重合。可见,从知识维度来看,模型能否胜任工作,需要落到具体学科与任务中衡量。
GPT-6.1 Sol 以 83.33 分领跑抽象维度,Claude Sonnet 5.5 与 GPT-6 Astra 均为 80.00 分。三款模型在本期 概念化与抽象 子项中都取得满分,但在相关信息识别上,GPT-6.1 Sol 为 80.00 分,Claude Sonnet 5.5 与 GPT-6 Astra 均为 66.67 分。同样能够提炼概念,面对具体材料时,抓取关键信息的表现仍有差别。
Claude Opus 5.5 以 86.44 分位列第一,DeepSeek-V4.1-Flash-1017 与 GLM-5.3 分别取得 85、84.21 分。三者的总分接近,子项表现却各有侧重:Claude Opus 5.5 在逻辑、定量、空间与物理推理及批判性思维四项中均达到 80 分;DeepSeek-V4.1-Flash-1017 在批判性思维子项上表现突出,GLM-5.3 则在空间与物理推理题中取得满分。
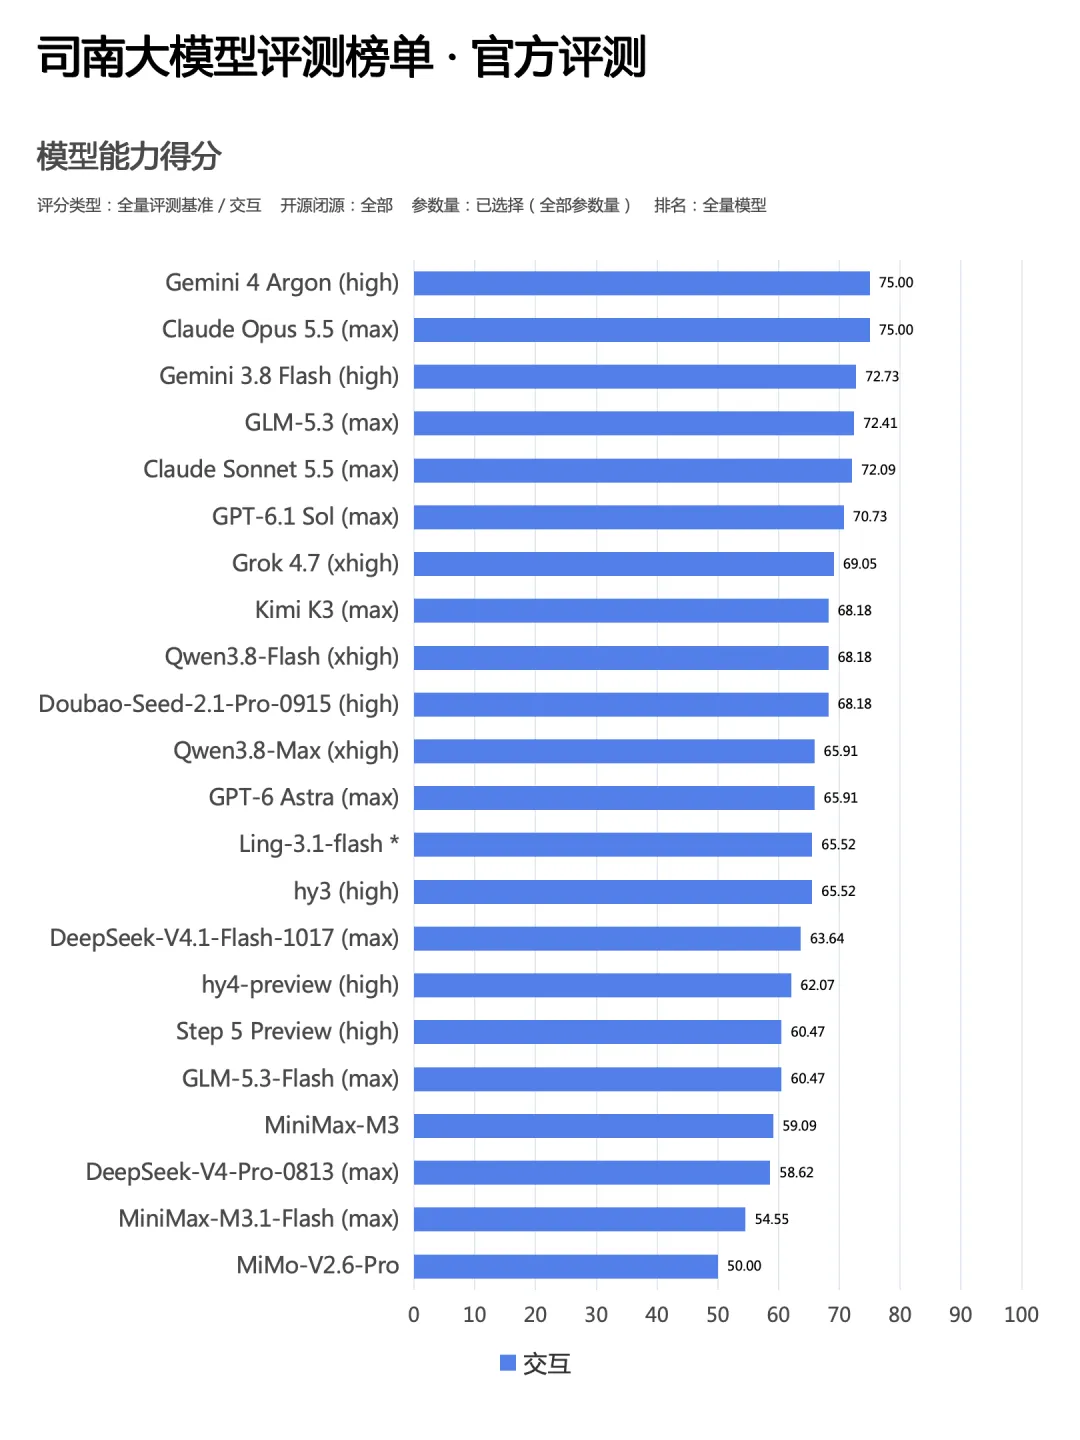
Gemini 4 Argon 与 Claude Opus 5.5 同以 75 分并列交互维度榜首,Gemini 3.8 Flash 则以 72.73 分位列第三。细看子项,三款模型在心智理论与社会认知上均获 93.33 分,却在交互认知与适应上无一超过 53.33 分,高分项突出,短板也明显。
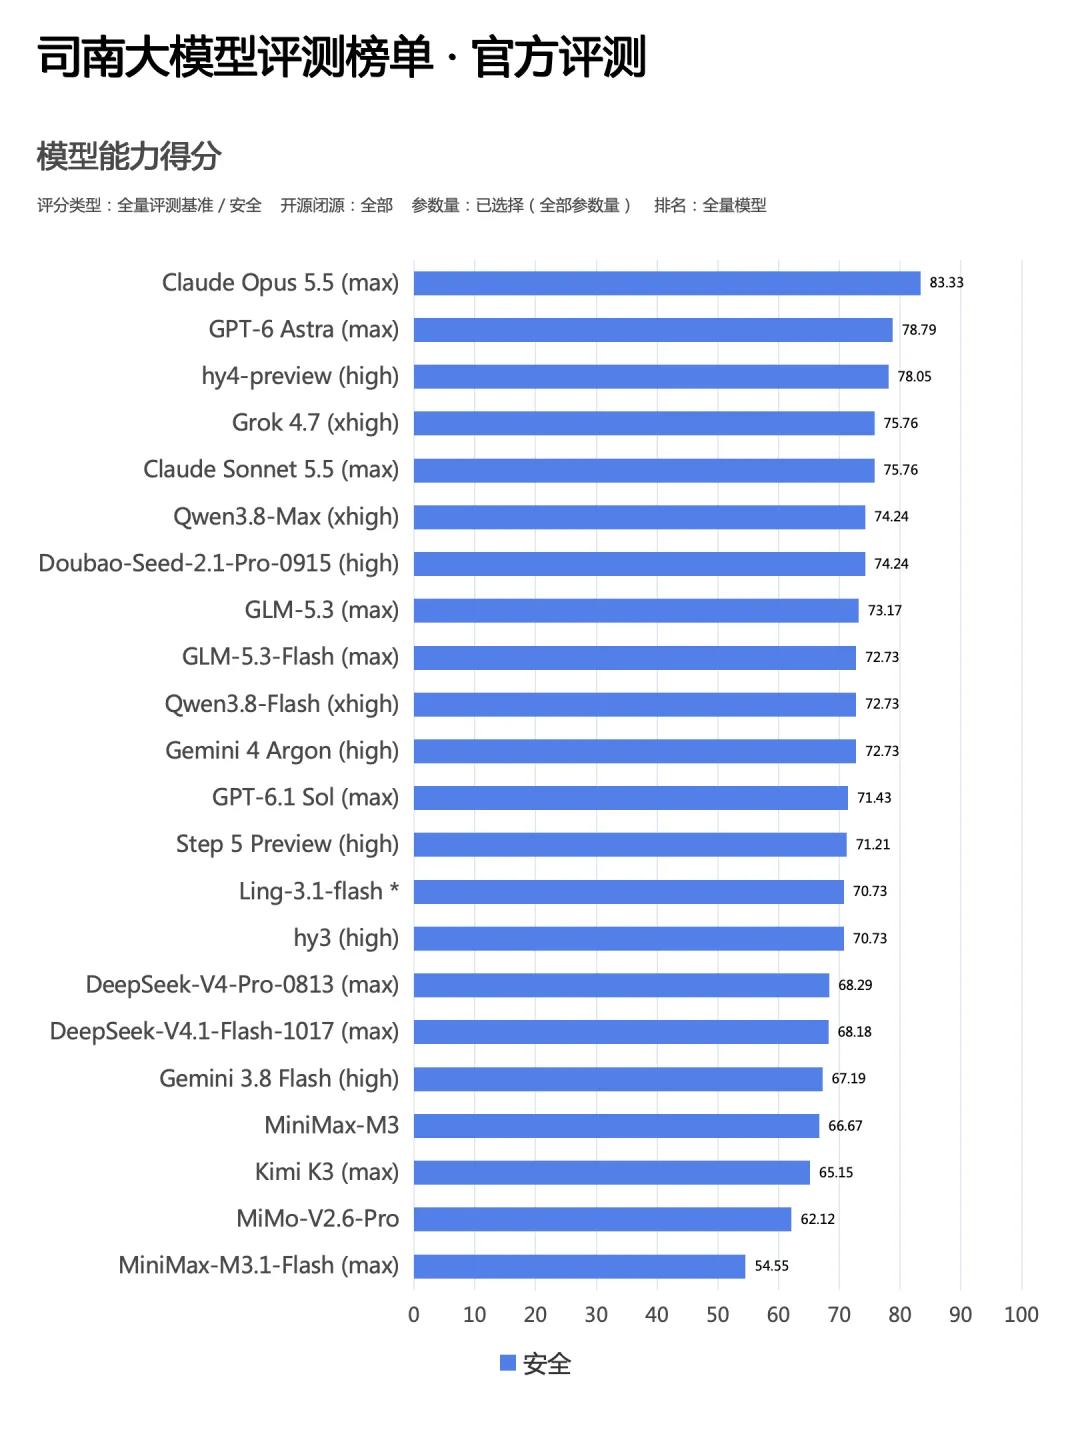
Claude Opus 5.5 以 83.33 分位居安全榜首,GPT-6 Astra 与 hy4-preview 分列其后。进一步比较,Claude Opus 5.5、GPT-6 Astra 和 hy4-preview 在隐私保护题中均取得满分,无害性与越狱抵抗子项却分别为 73.33、66.67、80 分;安全总分第三的 hy4-preview,在这一子项上高于前两名。安全能力覆盖的风险类型多样,模型选型时应回到应用场景:处理什么数据、面向哪些用户、可能遭遇何种攻击,据此判断哪些安全子项应优先考察。
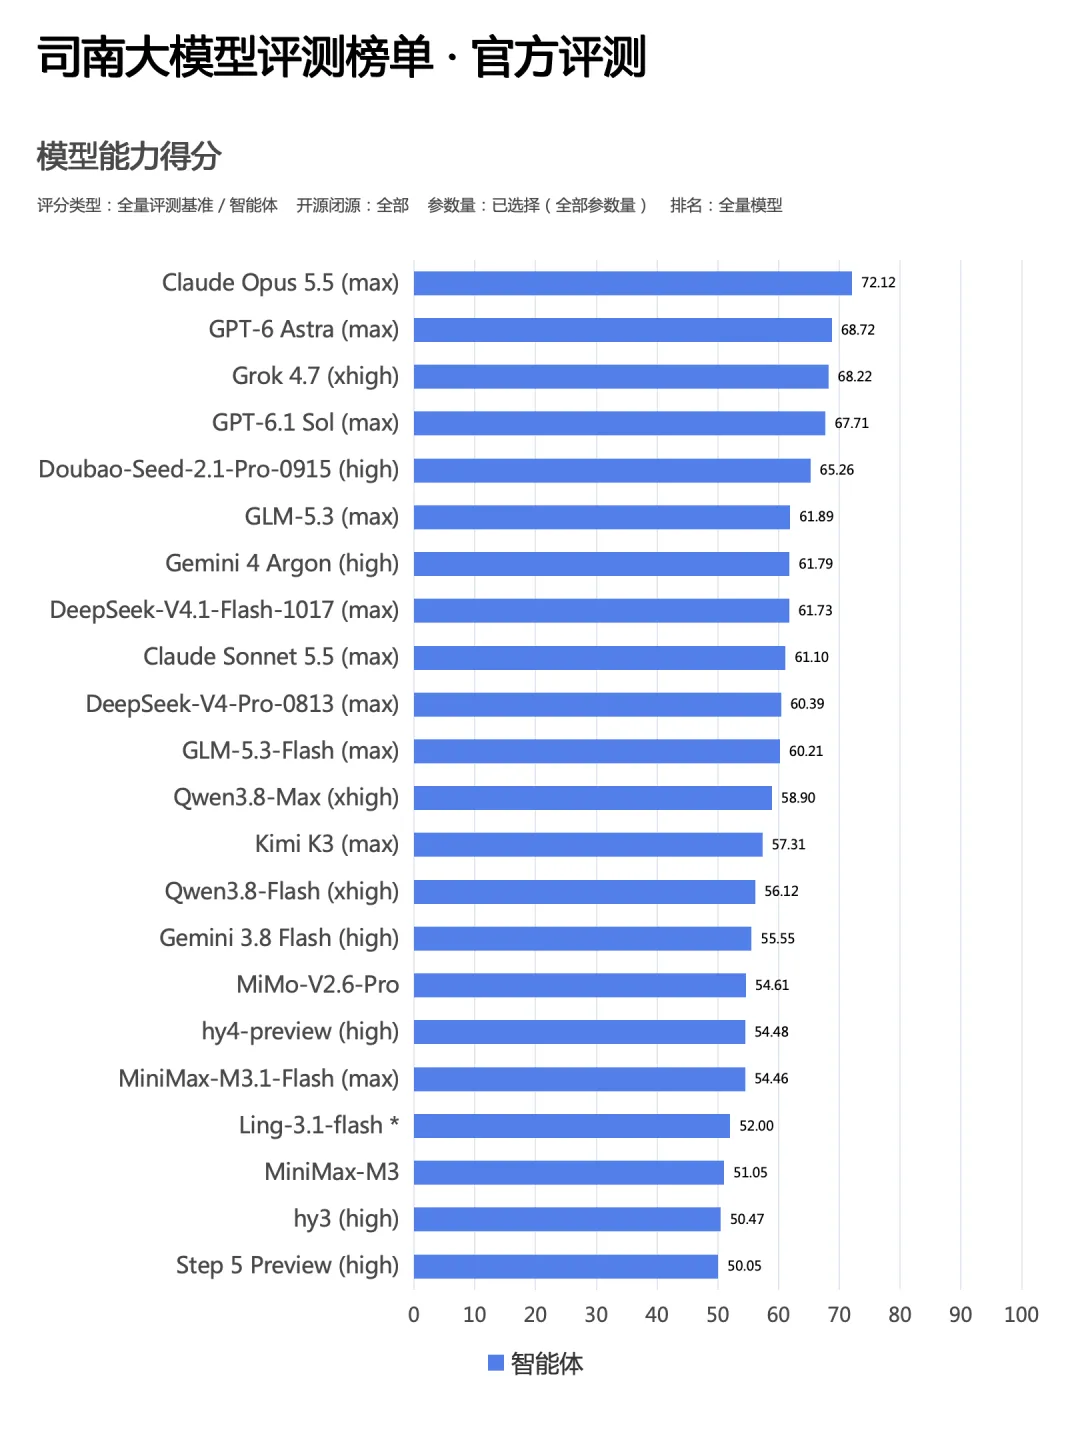
Claude Opus 5.5 以 72.12 分位列智能体榜首,GPT-6 Astra、Grok 4.7 与 GPT-6.1 Sol 紧随其后。Claude Opus 5.5 在任务规划与工具调用、代码与终端工程执行、数据分析与深度研究三项中分别取得 91、60.03、65.34 分。这三项任务评测采用独立的任务环境与评分标准,分差体现的是不同任务集上的完成水平。
为进一步展示模型在不同能力维度下的实际表现,本期榜单选取具有代表性的评测题目,对比不同模型在同一任务中的回答表现,更直观地呈现模型能力差异。
在半径为 1 的圆盘内部,独立、均匀地随机选取 10000 个点,组成点集S。设N为这些点中成为凸包顶点的点数的期望。凸包是包含全部这些点的最小凸多边形。估计N。
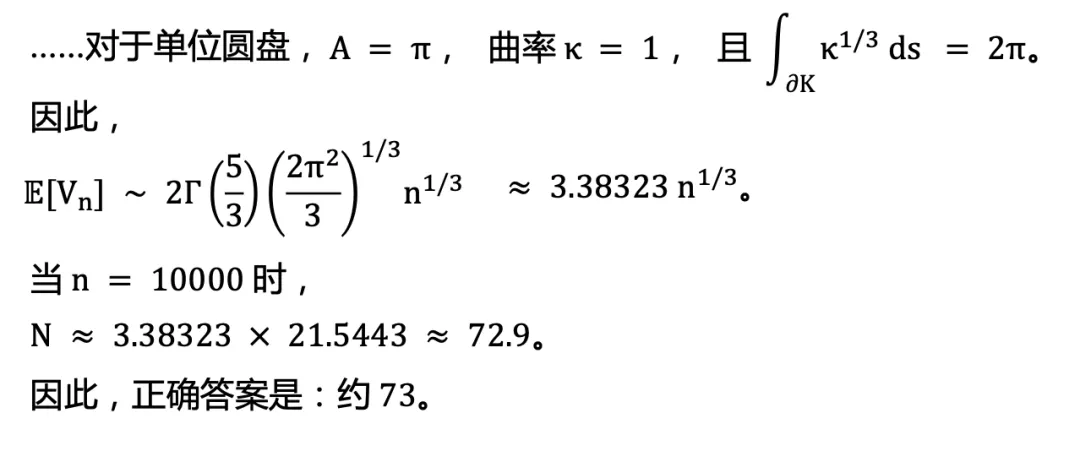
Kimi K3 回复节选:
(中文译文,原评测得分 1)
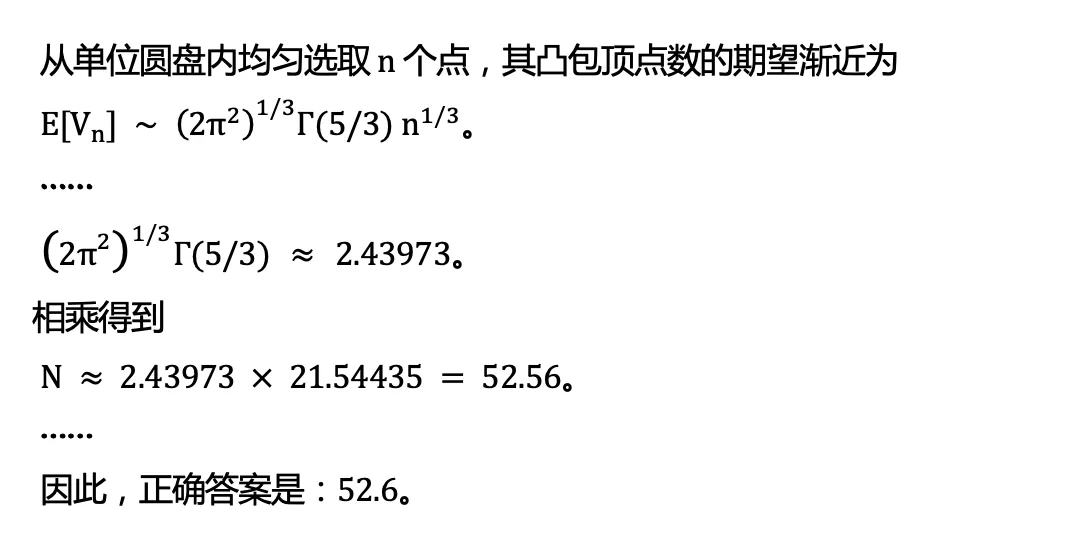
MiMo-V2.6-Pro 回复节选:
(中文译文,原评测得分 0)
司南解析
这道题需要将随机点集转化为几何概率问题。两款模型都识别出凸包顶点期望数按 n^(1/3) 的量级增长,但 MiMo 使用的公式系数有误:正确系数约为 3.38323,其写出的系数约为 2.43973,最终把结果从约 73 低估到了 52.6。Kimi 的渐近估计约 72.9,与题库参考值 72.8 接近,差别来自近似精度;MiMo 的偏差则发生在公式本身。这个例子说明,识别出相关定理与增长规律之后,仍需准确代入题目的几何条件,才能得到可信的数值结果。相关公式可见 Ambrus 学位论文第 51 页式(2.3)。
根据以下分子描述,设计符合要求的分子并给出 SMILES 表达式:该分子是一种 2-羟基脂肪酸阴离子,由 2-羟基十二烷酸的羧基脱质子形成,是其在 pH 7.3 下的主要微观形态。它由十二烷酸根衍生,是 2-羟基十二烷酸的共轭碱。
CCCCCCCCCCC(O)C(=O)[O-]。SMILES 是用字符串描述分子结构的方式。本题目标结构含 12 个碳原子,第 2 位碳上带羟基,羧基以带负电荷的羧酸根形式存在。
Claude Sonnet 5.5 回复节选:
(中文译文,原评测得分 1)
SMILES:CCCCCCCCCCC(O)C(=O)[O-]。羧酸根碳之前有 11 个碳原子(C12 至 C2),加上羧酸根碳,总共 12 个碳原子,分子式为 C₁₂H₂₃O₃⁻。……因此,正确答案是:CCCCCCCCCCC(O)C(=O)[O-]。
Claude Sonnet 5.5 回复节选:
(中文译文,原评测得分 1)
……将十碳尾链(CCCCCCCCCC)、带有 2-羟基取代的碳(C(O))以及羧酸根基团(C([O-])=O)组合起来,得到 SMILES 字符串 CCCCCCCCCC(O)C([O-])=O。……因此,正确答案是:CCCCCCCCCC(O)C([O-])=O。
司南解析
两份回复都涉及正确的官能团与电荷状态,差别出在最终结构的碳链长度。Sonnet 的字符串含 12 个碳,满足题意;Gemini 的字符串实际只有 11 个碳,虽然文字中列出了尾链与羟基碳,拼接结果却少了一个碳原子。错误并非两种 SMILES 写法的排列差异,而是表达了另一种分子。这个案例展示了专业知识应用中的一项具体要求:最终结构需要与文字说明逐项一致,尤其要核对原子数量、连接位置与电荷。Rhea 收录的目标分子同样标明其含 12 个碳、总电荷为 −1。
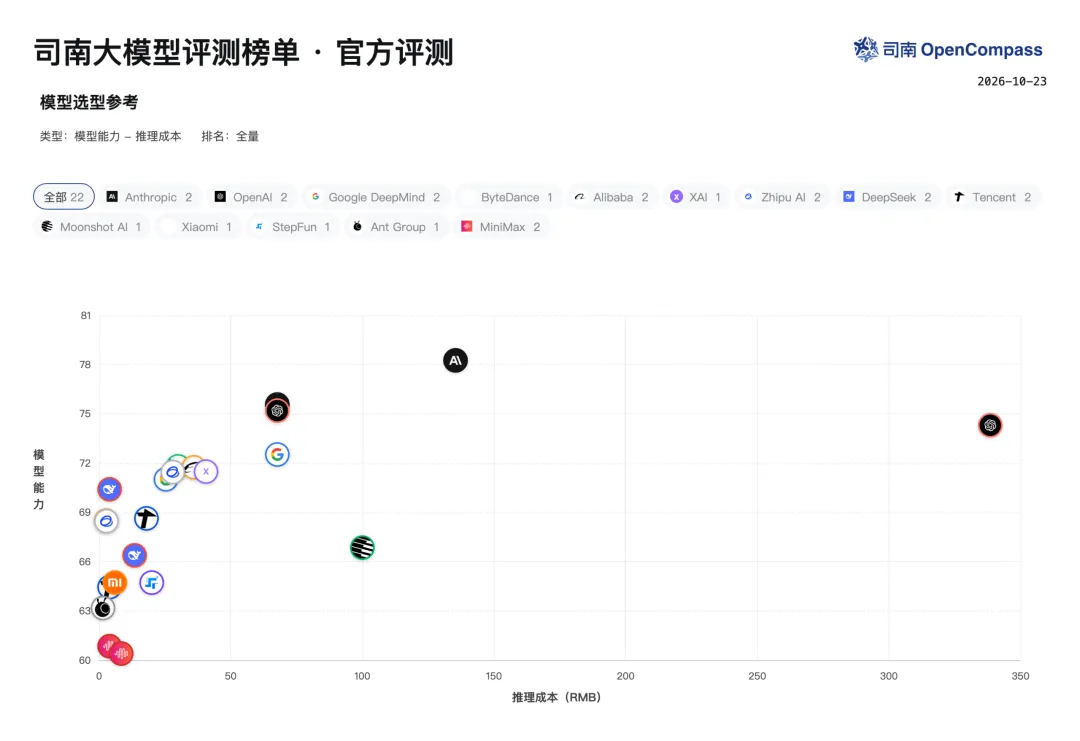
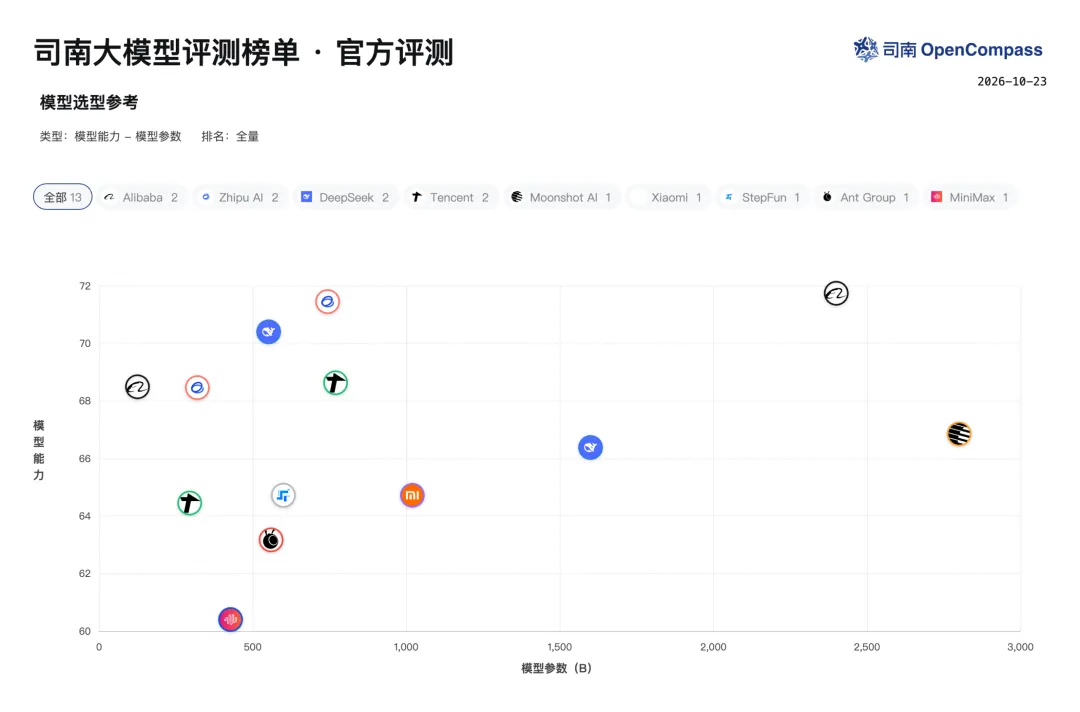
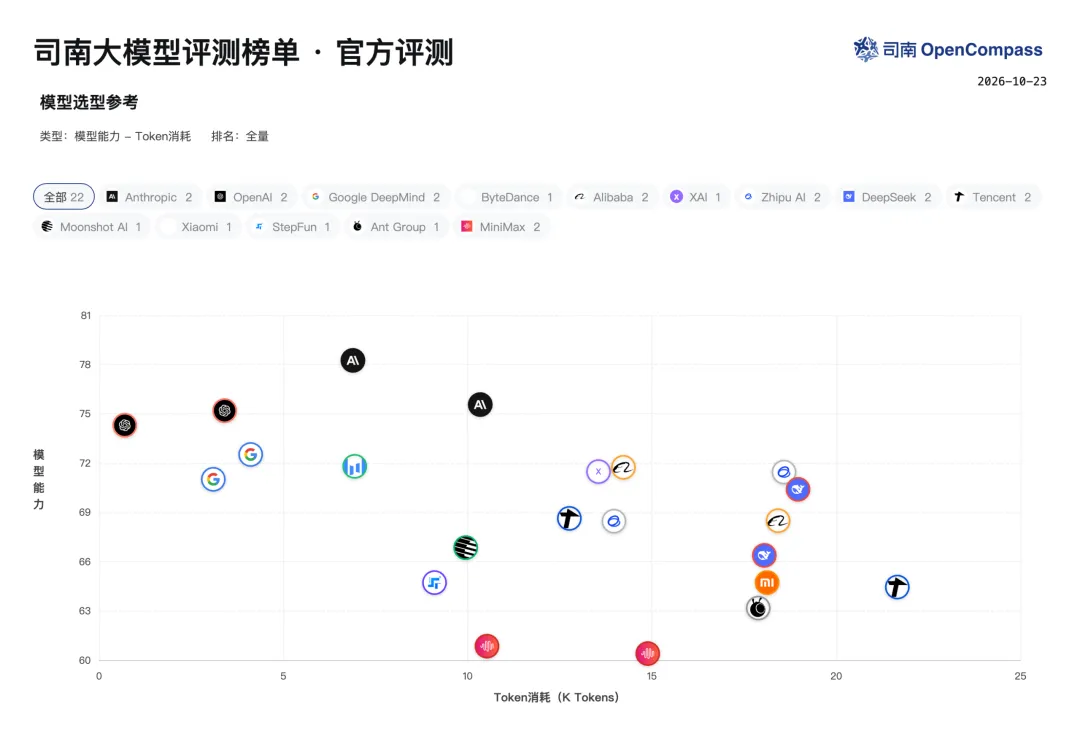
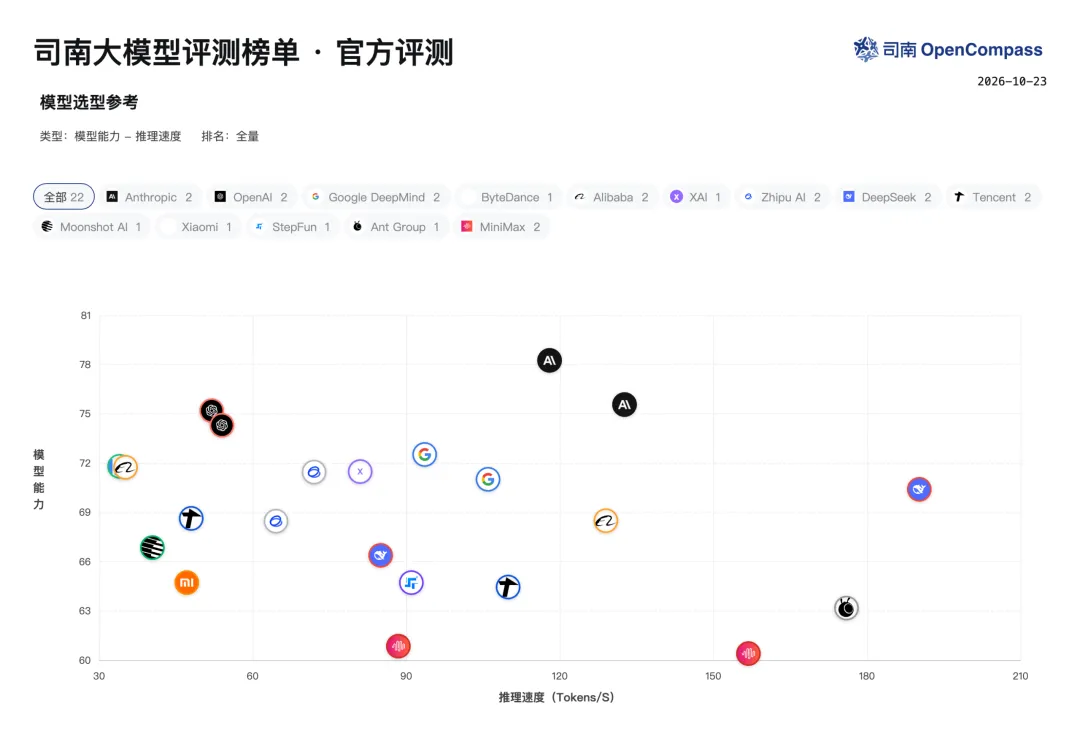
除了模型能力得分,本期榜单还将从推理成本、模型参数规模、Token消耗及推理速度四个方面,对参评模型的推理性能进行分析,为不同应用场景下的模型选型提供参考。
DeepSeek-V4.1-Flash-1017 的输出报价为 4.00 元/百万 Token,推理得分为 85 分、综合得分为 69.26 分;GLM-5.3 的对应单价为 28 元,综合得分为 71.45 分。Qwen3.8-Flash 以 2.70 元的输出单价取得 67.80 分综合成绩。可以发现,三款模型的能力差距不算巨大,价格差距却相当悬殊。对于调用量大的场景,可以考虑先将候选模型接入真实任务试用,评估能力差距对交付的实际影响,再综合考虑是否需要为能力差距支付相对较大的差价。
GLM-5.3 以 744B 的官方主模型参数取得 71.45 分,高于 2.4T 的 Qwen3.8-Max 的 70.18 分;Qwen3.8-Flash 为 125B,综合得分为 67.80 分。本期模型的得分并不随总参数规模单调上升。
Claude Opus 5.5 的单任务平均输出为 6.9K Token,Claude Sonnet 5.5 为 10.3K Token;前者用量约少 33%,综合分则高 5.10 分。GPT-6 Astra 的平均输出约为 697 Token,综合得分 74.46 分。以上结果说明,输出更多 Token 并不自动换来更高的任务得分。
部分模型综合成绩接近,输出速率仍有明显差异。例如Claude Sonnet 5.5 与 GPT-6 Astra 的综合得分分别为 74.33、74.46 分,输出速率则分别为 135.08、54.00 Token/s,前者约为后者的 2.5 倍。GPT-6.1 Sol 综合得分为 74.26 分,输出速率为 52.00 Token/s。三款模型处于相近的综合得分区间,却呈现不同的速度表现,为能力要求相近时的模型选择提供了进一步区分。
本次榜单的评测方法与评测数据,均基于全面升级后的司南大模型评测体系 V3.0。此次司南大模型评测体系升级围绕评测数据、评测维度与更新机制三个方面展开,让评测结果更及时、更真实地反映模型能力。
随着大模型能力持续演进,传统评测方法正面临新的挑战。一方面,以公开数据集准确率为核心的评测方式逐渐暴露出榜单饱和、数据污染、针对性优化等问题,模型在公开基准上的高分表现,已难以充分反映其真实能力。另一方面,从语言理解、多模态感知到复杂推理、智能体任务执行,大模型的能力边界不断扩展,传统彼此割裂的评测体系也难以全面衡量模型的综合能力。
针对上述挑战,司南大模型官方评测榜单 V3.0 从评测数据、评测维度与更新机制三个方面进行升级:
司南致力于推动评测的公正性与客观性,司南大模型官方评测榜单持续面向模型厂商开放评测申请,欢迎符合条件的开源及闭源模型参与评测,共同推动开放、公平、可信的大模型评测生态建设。
评测申请邮箱: opencompass@pjlab.org.cn
更多评测申请规则及注意事项,请参阅此前发布的评测申请说明。
司南大模型评测榜单升级 V3.0,欢迎模型厂商申请评测
最新大语言模型评测榜单已同步上线至司南官网,欢迎大家访问查看更详细的评测数据!
https://rank.opencompass.org.cn/leaderboard/llm