很多算力项目在立项阶段,很容易陷入一个误区:算力越强越好,显卡越多越好。但实际落地后才发现,花大价钱采购的 GPU 集群,资源利用率不到 30%,预算白白浪费。核心问题往往不在于硬件性能不够,而是没有选对计算精度。FP64、FP16、BF16,不同精度直接决定算力、显存占用、项目成本,选对了事半功倍,选错就是资源空转。
很多算力项目,栽在 “盲目追求高算力”
不少项目方案撰写、硬件招标时,习惯盯着 GPU 峰值算力,一味增加卡的数量。大家默认算力参数越高,项目效果就越好。可等到集群上线跑业务,才发现大量算力闲置,机房电费、制冷成本居高不下。
造成这种浪费的核心原因,就是忽略浮点精度。同样一块 GPU,FP64、BF16、FP16 模式下,实际输出算力天差地别。脱离业务所需精度去评估算力,纸面参数再华丽,也只是无效算力。
一文看懂:FP64 / FP16 / BF16,三者核心差异
FP,全称浮点精度,代表计算机存储、运算数字的精细程度。位数越高,数值表达越精准,但占用显存越多、硬件开销越大。
FP64 也就是双精度浮点,64 位。它的优势是计算误差极小,数值稳定性最强。但缺点非常突出:同样一块 GPU,FP64 算力远低于低精度运算,而且显存占用翻倍。每一组计算都要消耗更多显存空间。
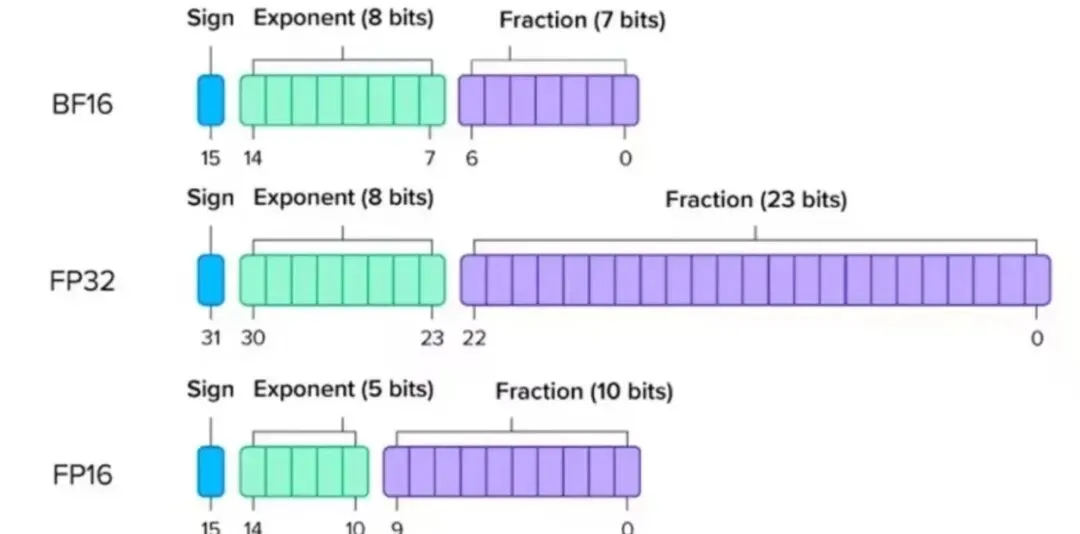
FP16 半精度浮点,16 位。精度下降,显存开销减半,算力大幅提升。FP16 的数值范围有限,数值过大或过小的时候,容易出现溢出,计算出错。
BF16,脑浮点数,同样 16 位。它和 FP16 位数相同,显存占用一致,算力接近。区别在于,BF16 牺牲了小数精度,扩大了可表示的数值范围,不容易溢出,这也是为什么现在大模型训练普遍优先 BF16。
场景对应精度:不同业务该选哪一种?
很多人会问,精度是不是越高越好?并不是,不同场景适配完全不同。
FP64,适合对数值误差零容忍的场景。气象模拟、有限元仿真、CAE 工程计算、量子力学、流体力学、高精度地质建模,这类科学计算项目必须用 FP64。微小的计算误差会层层累积,最终仿真结果完全失真。这类项目,不能强行降精度,就算算力成本高,FP64 是硬性需求。但要注意:AI 大模型训练、推理,绝大多数场景完全不需要 FP64。如果做 LLM 却上 FP64,属于典型的过度配置,成本直接翻几倍。
BF16 是当前大模型领域的主流选择。大模型预训练、微调、大部分大模型推理,首选 BF16。相比 FP16,它数值范围更大,训练过程中不容易出现梯度溢出,模型收敛更稳定;对比 FP64,显存占用大幅降低,同等 GPU 集群能塞更大的模型,算力吞吐量显著提升。现在主流的国产算力卡、NVIDIA 新一代 GPU 原生支持 BF16 加速,是兼顾性能与稳定性的最优解。
FP16 更适合推理场景,或者对数值范围要求不高的模型。图像识别、传统 CV 模型推理,FP16 表现不错。但训练大模型时慎用 FP16,梯度很容易溢出,需要额外开启损失缩放,增加调试复杂度。
误区:峰值算力≠实际可用算力
回到最开始的核心观点:算力项目,不要盲目堆高算力。
不少投标和项目方案,一上来就堆砌大量高端 GPU,追求纸面算力峰值。但峰值算力只是理论最大值,能不能发挥出来,精度选择是第一道关卡。举个例子:一个大模型微调项目,方案按 FP64 算力去配置硬件,采购大量高端显卡。实际跑起来才发现,业务本身只需要 BF16。大量 FP64 算力闲置,显存资源浪费,硬件采购、机房供电、制冷成本全部超额投入。
除了硬件采购成本,还要考虑隐性开销。高算力集群,功耗更高,电费、机房制冷、机架占用都会持续增加运营成本。如果精度选错,GPU 长期低利用率,项目 TCO(总拥有成本)会失控。
算力落地 3 条实操建议,降低项目 TCO
第一,先确认业务类型,再定精度,最后选硬件。先区分是科学仿真,还是大模型训练、模型推理,优先确定浮点精度,再反推需要的算力指标,而不是先买卡再适配业务。 第二,分阶段测试验证。正式采购集群前,先用单卡做小规模测试,验证模型在 BF16/FP16 下是否出现精度损失,确认业务是否能接受低精度带来的微小误差,不要直接大规模上线。 第三,混合精度灵活使用。现在主流框架支持混合精度计算,计算过程用 BF16/FP16 加速,关键参数保存用高精度,兼顾速度与稳定性,是性价比很高的方案。
结语:算力建设,匹配需求才是核心
算力建设不是一场 “比拼硬件参数” 的竞赛。峰值算力只是纸面数字,匹配业务需求、选对浮点精度,把硬件利用率提上来,才是算力项目成功的关键。盲目追求高算力,最后只会造成巨大的资源浪费。合理选择 FP64、BF16、FP16,用最少的预算,拿到满足业务需求的计算能力。
获取完整HPC方案、软硬件兼容清单及项目细节,欢迎联系我们咨询