导读:大厂 Agent 评测体系六大模块:指标体系、评测集治理、分层归因、评估器方法论、AgentOps、安全红队。这篇逐模块深研京东:自建基准怎么拆到参数级、评测怎么直接翻译成 GMV、红队 200+ 攻击手法怎么沉淀。
📖 本篇目录① 一、评测版图总览:供应链孵化器式评测② 二、指标体系:京东从生意倒推的业务结果金字塔③ 三、评估器与自动比对:业务数据有天然标准答案④ 四、深挖:OxyEcomBench自建基准即行业标准,京东最锋利的一招⑤ 五、分层归因:多智能体分工即归因边界⑥ 六、评测集治理:京东的治理特色⑦ 七、AgentOps:评测织进三条业务线⑧ 八、安全红队:红蓝对抗产品化的双线布局⑨ 九、总评与可借鉴清单
大厂的 Agent 评测不同于学术界的静态跑分,它要解决的是「从模型选型、组件调试、端到端业务验收,到线上运营监控」的全生命周期质量保障。业内常把它归纳为六大模块:评测目标与多维指标体系、评测集治理与数据工程、分层归因与链路评测、评估器与评测方法论、自动化评测平台与 AgentOps、安全护栏与红队测试。
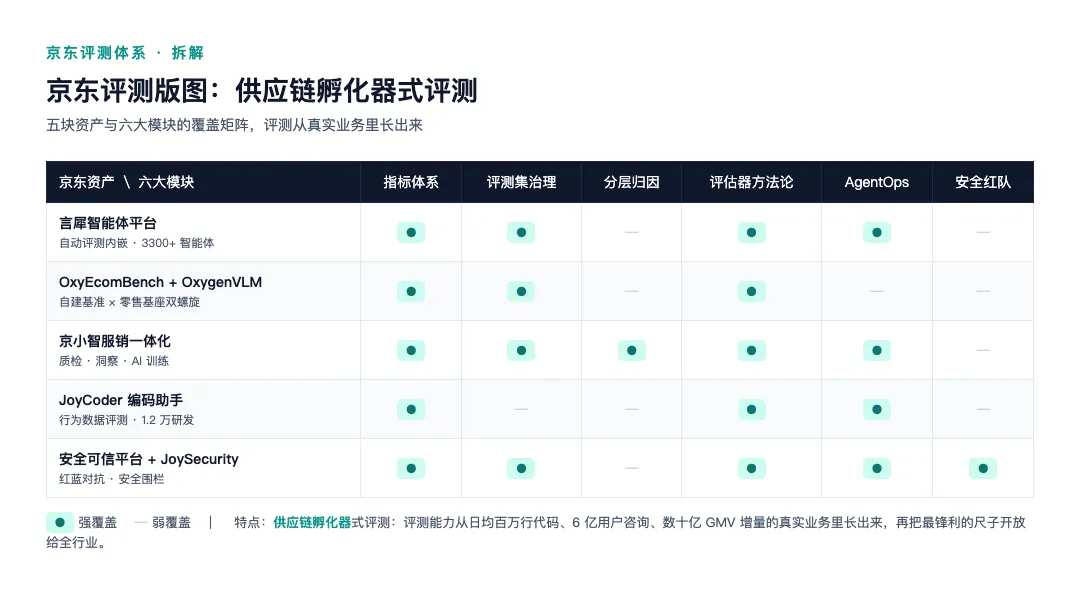
京东的评测体系没有一张总览白皮书,但把言犀智能体平台、OxyEcomBench、京小智、JoyCoder、大模型安全可信平台五块资产拼起来,六大模块一块不缺。更值得说的是,京东手里有一张别家都没有的牌:自建电商行业基准,再把它开放成全行业的度量衡。这篇按六大模块逐项拆解,拆到参数级,中间单开一节讲这张牌。
京东评测版图:五块资产 × 六大模块覆盖矩阵
一、评测版图总览:供应链孵化器式评测
京东的评测版图由五块资产拼成,与六大模块的映射关系如下:
| | |
|---|
| Agent 开发平台内嵌自动评测,3300+ 活跃智能体在跑 | |
| | |
| 智能客服全链路 + 智能质检 + AI 训练 + 咨询洞察 | |
| | |
| 红蓝对抗攻击手法库 + 安全围栏 + 智能渗透测试 | |
一句话总评:京东的评测是「供应链孵化器」式的。日均超百万行代码提交、6 亿用户的智能咨询积累、数亿 GMV 增量的业务验证,评测能力从这些真实业务里长出来,先服务自己,再把最锋利的一把尺子开放给全行业。与百度「平台内嵌式」对照,京东把评测重心放在两端:一端是业务结果指标(评测结论直接翻译成 GMV 和转化率),另一端是行业标准话语权。中间的模型能力层,京东大量借力信通院认证与通用基准,自建榜单反而不是重心。这个取舍本身就有信息量。
二、指标体系:从生意倒推的业务结果金字塔
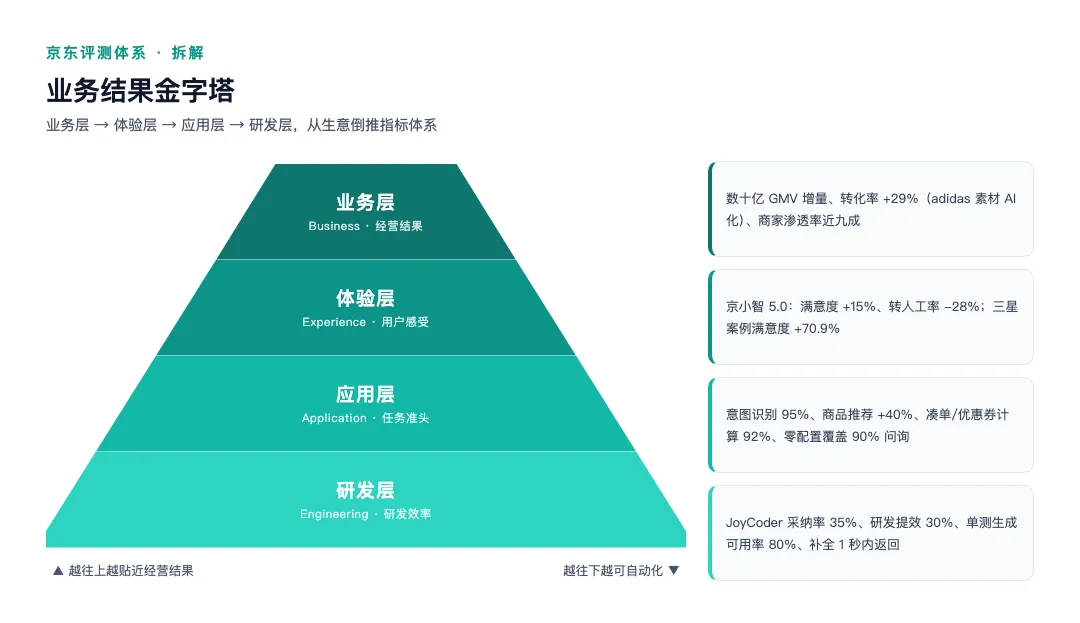
业务结果金字塔:从生意倒推的四层指标
京东的指标金字塔是从生意出发倒推的:业务层看钱,体验层看人,应用层看准头,研发层看效率。
| | |
|---|
| | JoyAI 大模型落地超 2000 个零售细分场景,累计为商家创造数十亿 GMV 增量;京小智站内商家渗透率近九成;adidas 自营店用京点点后素材效率提升 30 倍、店铺转化提升 29% |
| | 京小智 5.0 五万店铺内测:用户满意度提升 15% 以上、转人工率降低 28% 以上;三星自营店案例满意度提升 70.9% |
| | NLP 识别准确率 95%;商品推荐准确率提升 40% 以上;凑单、优惠券计算准确率 92%;零配置覆盖 90% 常见问询 |
| | JoyCoder 约 1.2 万研发使用(占整体 70%),生成代码采纳率超 35%,研发提效 30%,单元测试生成可用率 80% |
三个值得注意的亮点:
- 评测指标与经营指标同表呈现:京东敢把评测结论直接写成「数十亿 GMV 增量」「售前咨询转化率提升 37%」,评测和经营说的是同一套话,跨部门沟通零折算。
- 行为数据当评测信号:JoyCoder 的管理后台持续统计用户活跃度、采纳率、调用次数,用真实接受行为给模型打分。1.2 万名研发每天的无感投票,比任何离线榜单都新鲜。
- 稳定性也是指标:数据服务评测里,同一批样本会多次调用,评估输出稳定性;单行代码补全要求 1 秒内返回。准确之外,抖动本身是被测对象。
需要说明的边界:轨迹级指标(Pass@k、Progress Rate、Grounding Accuracy)在京东的体系里不唱主角,模型能力层主要靠信通院认证(言犀大模型是软件平台功能性评估首批通过者,覆盖数据安全、性能、效率三模块)和通用基准兜底。指标体系的重心压在业务层,这与京东「供应链是大模型超级孵化器」的定位一致。
三、评估器与自动比对:能算的不问模型
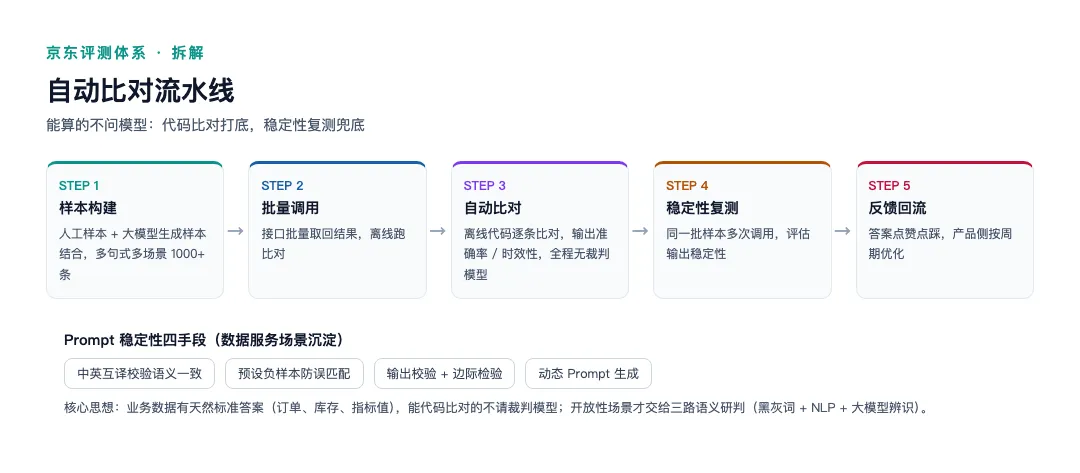
自动比对流水线:能算的不问模型
京东的评估器方法论里,最有参考价值的是京东零售数据资产团队跑了几年的评测流水线,它的核心思想是:业务数据有天然标准答案,能用代码比对的绝不请裁判模型。
- 样本设置:人工样本和大模型生成样本结合,快速、多频次覆盖不同句式、不同场景的 1000+ 条问答,保障多样性与丰富度。
- 准确率测评:批量调用接口拿回结果,离线代码批量自动比对,高效输出准确率、时效性等指标;同一批样本多次调用评估稳定性。
- 反馈闭环:用户在答案上点赞或点踩,产品侧按反馈周期性优化。
Prompt 工程侧的稳定性细节同样值钱:环境预设、指令描述、输出规范三段式构建之外,还有四个稳定性手段:中英互译校验语义一致性、预设负样本防误匹配、增设输出校验和边际检验、动态 Prompt 生成。每一条都是冲着「大模型输出抖动」这个痛点去的。
安全评测侧的评估器是另一条路:AI 智能检测流对大模型输出做三路综合研判,黑灰词匹配、NLP 语义识别、生成式大模型辨识,配合恶意识别算法四种以上,输出识别准确率不低于 95%。风险分析判断本身由模型完成,但三路信号互证,单路误判有兜底。
京东的取舍很清楚:零售业务里订单、库存、指标值天然就是 ground truth,规则比对便宜、可复现、无裁判偏差;真正开放性的场景(客服对话质量、素材审美)才交给语义模型判。评估器的性价比阶梯,京东爬得很稳。
四、深挖:自建基准即行业标准,京东最锋利的一招
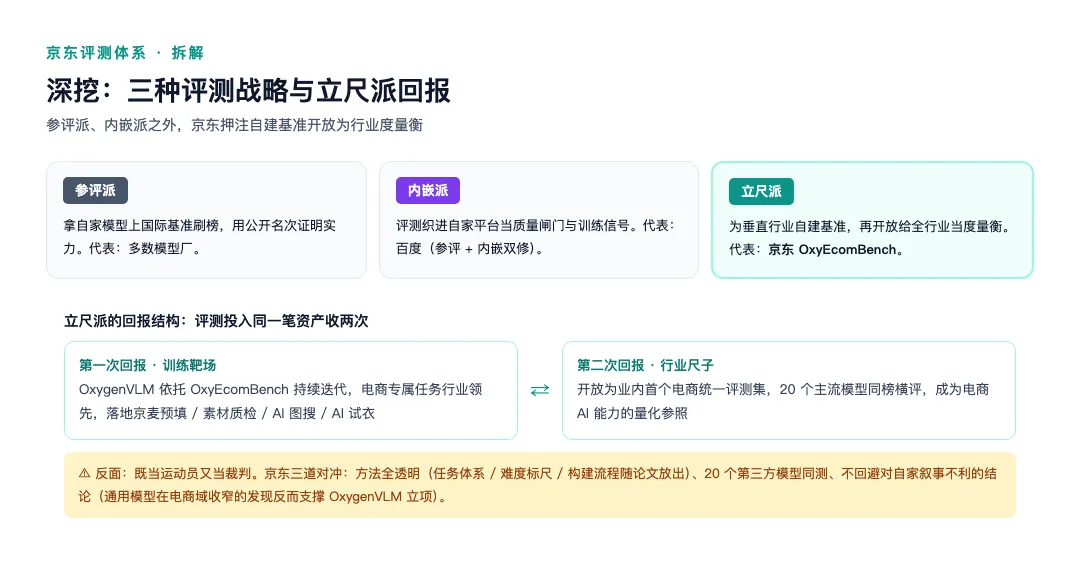
三种评测战略与立尺派的回报结构
把国内大厂的评测战略放在一起看,有三种打法:参评派,拿自家模型刷国际榜证明实力;内嵌派,把评测织进自家平台当质量闸门;立尺派,为垂直行业自建基准,再开放给全行业当度量衡。百度是参评与内嵌双修,京东把战略重心押在立尺上,押注就是 OxyEcomBench:业内首个覆盖电商全链路、多角色的统一多模态评测集。
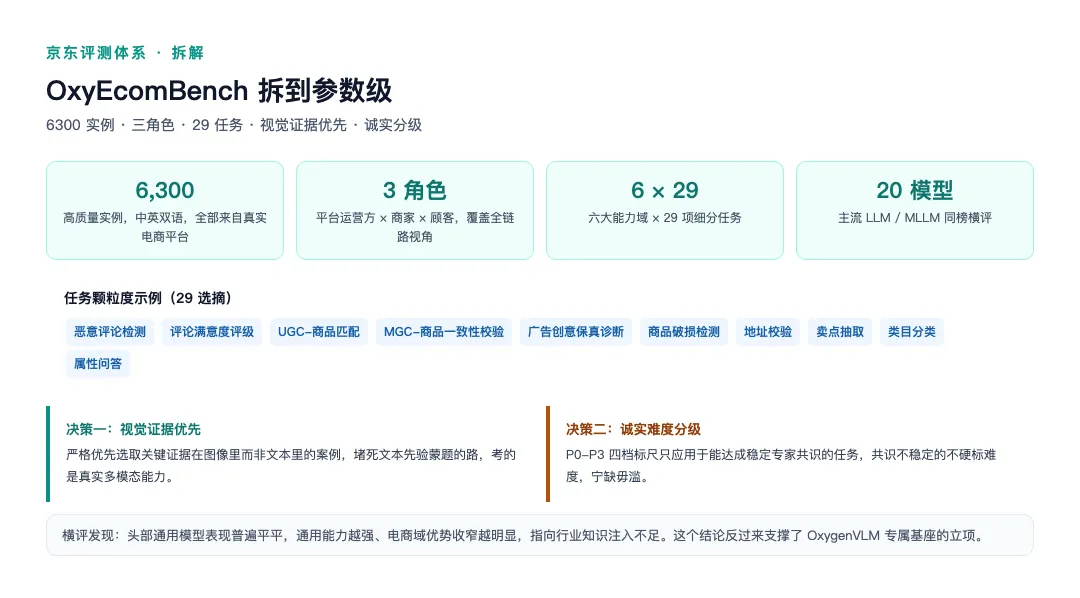
OxyEcomBench 拆到参数级
先看硬规格:约 6300 个高质量实例,中英双语,数据全部来自真实电商平台并经领域专家验证;三类角色(平台运营方、商家、顾客)× 六大能力域 × 29 项细分任务;输入配置覆盖纯文本、单图、多图、单轮、多轮全形态。
29 个任务值得列几感受下颗粒度:恶意与无效评论检测、评论满意度评级、UGC 与商品匹配、MGC 与商品一致性校验、广告创意保真度诊断、商品破损检测、地址校验、卖点抽取、商品类目分类。从售前种草到售后纠纷、从内容生产到合规风控,电商经营的真实颗粒全在里面。
三个设计决策,一条比一条狠
第一个决策:三角色覆盖。此前同类基准几乎都是单一视角,京东把平台运营、商家、顾客三方的需求差异直接编码进任务体系。同一个商品理解任务,平台看合规、商家看卖点、顾客看性价比,评测「全链路」而非某个单点。这让 OxyEcomBench 成为唯一能回答「这个模型适不适合整个电商生态」的尺子。
第二个决策:视觉证据优先。评测集严格优先选取关键证据在图像里而非文本里的多模态案例。这是防作弊设计的精髓:通用模型靠文本先验就能蒙对的题,测不出多模态真实能力;电商场景天然图像密集(商品图、评论晒图、素材图),把证据压进图像,考的才是真本事。
第三个决策:诚实的难度分级。P0 到 P3 四档难度标尺只应用在能够达成稳定专家共识的任务上,共识不稳定的任务不硬标难度。宁缺毋滥,这比强行给所有任务打分的设计克制得多。
双螺旋:尺子和被测对象互相成就
OxyEcomBench 拆到参数级
OxyEcomBench 不只是对外度量衡,它首先是京东自研零售多模态基座 OxygenVLM 的训练靶场:基座依托该体系持续迭代,电商专属任务表现行业领先,再落地到京麦一键预填、AIGC 素材质检、AI 图搜、AI 试衣四个核心场景验证。尺子造题、模型提分、业务收钱,评测投入在同一笔资产上收回两次,这是立尺派最划算的地方。
20 个主流大模型和多模态模型的横评还给出一个反直觉发现:头部通用模型的表现普遍平平,通用能力越强,在电商域的优势收窄越明显。结论指向电商域知识注入不足。这个发现反过来支撑了 OxygenVLM 立项的合理性:不是通用模型不够强,是行业需要专属基座。自家基准、自家结论、自家模型,三件事咬合成一个正循环。
硬币反面:既当运动员又当裁判
立尺派天然面临公信力质疑:尺子是你造的,第一名也是你家的,这榜单怎么信?京东的对冲有三道,都值得细看:方法全透明,任务体系、难度标尺、数据构建流程随论文完整放出,任何人可按方法论复核;第三方同测,20 个外部模型与 OxygenVLM 同榜横评,且横评结论(通用模型在电商域收窄)对自家叙事并不有利,这种不回避不利结论的姿态是公信力的来源;数据可核验,全部实例来自真实电商平台、经领域专家验证,且配了防作弊的视觉证据设计。三道对冲下来,「运动员兼裁判」的质疑被压到了可接受范围。
给自建评测体系的团队,这条深挖的可操作结论是:垂直行业玩家与其苦等通用榜单覆盖自己的场景,不如把自家业务颗粒攒成基准。路径有三步:先按真实业务分布采样建集、把最痛的场景做成任务、让自家模型当第一个考生;验证方法论后开放给同业,评测投入就从成本项变成了标准话语权。
五、分层归因:多智能体分工即归因边界
NL2SQL 四步兜底链:归因即分层兜底
Agent 端到端失败时必须回答:是意图理解错、检索召回差、还是生成幻觉?京东的归因打法是让系统结构本身承担归因功能。
第一条线是京小智的多智能体协同架构:售前接待、规格推荐、催单催付、售后跟进四类「AI 数字员工」各管一段,一次服务会话的失败可以按角色边界直接定位到责任智能体。配合服销一体化里的三件归因工具:智能质检全量扫描会话定位答非所问,咨询洞察对问题聚类找共性问题,AI 训练让商家按诊断结果自主调优。归因不靠事后复盘报告,而是织进日常运营动线。
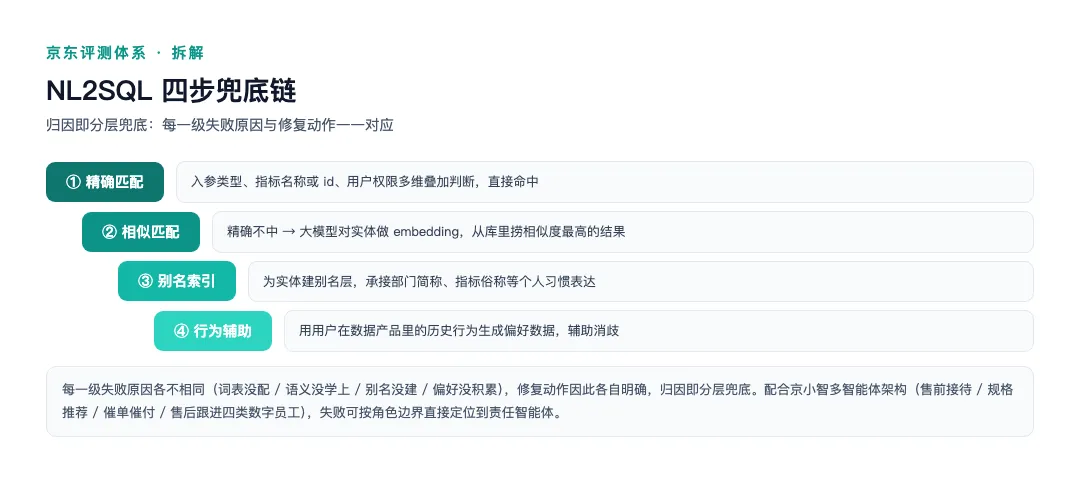
第二条线是京东零售数据资产场景的 NL2SQL 四步兜底链,把「实体没对上」这类失败的归因和修复做成了一个递降的匹配流水线:
- 精确匹配:入参类型、指标名称或 id、用户权限多维叠加判断,直接命中;
- 相似匹配:精确不中,大模型对实体做 embedding,从库里捞相似度最高的结果;
- 别名索引:为实体建别名层,承接部门简称、指标俗称等个人习惯表达;
- 行为辅助:用用户在数据产品里的历史行为生成偏好数据,辅助消歧。
四级里每一级失败原因不同(词表没配、语义没学上、别名没建、偏好没积累),修复动作也就各自明确。这种「归因即分层兜底」的设计,比单纯出一份归因报告更接近工程实效。
第三条线是性能归因:大促咨询量激增 5 到 10 倍、峰值服务量同比激增 14 倍的场景下,并发承接能力本身就是被评测的维度。京小智以多智能体架构扛住流量冲击,压力测试把「稳定性归因」从定性描述变成了量化验收。
六、评测集治理:真实数据、专家验证、诚实分级
千帆把评测集当资产管,京东的治理特色在「真实性与难度工程」两翼。
- 真实性一翼:OxyEcomBench 全部数据来自真实电商平台交易与交互场景,领域专家逐条验证;恶意问题数据集超过 3 万条,全部人工审核,覆盖《生成式人工智能服务安全基本要求》5 类 31 种风险类型。评测集的可信度先于模型被验证。
- 难度工程一翼:P0-P3 四档难度标尺 + 专家共识机制,让 6300 个实例不只是「题多」,而是「题有梯度、分有含义」。横评结论(头部模型表现平平)之所以有说服力,前提就是难度分级做得诚实。
- 自定义通路:安全可信平台支持用户上传自定义测试集,自带输出判断、人工审核打标与分类管理能力;企业可以把自家业务语料变成安全回归集,评测集治理能力直接开放给客户。
- 知识保鲜:言犀智能体平台的 Advance RAG 提供结构化与非结构化数据的接入配置;京小智与商家共创核心品类知识库,大促前知识库先行,评测输入侧的运营做成了常态机制。
对照来看,百度的评测集治理强在「版本化与 SDK 化」,京东强在「真实性与难度分级」。两条路径都指向同一个目标:让评测结论可复现、可信赖。
七、AgentOps:评测织进三条业务线
三条业务线的评测飞轮
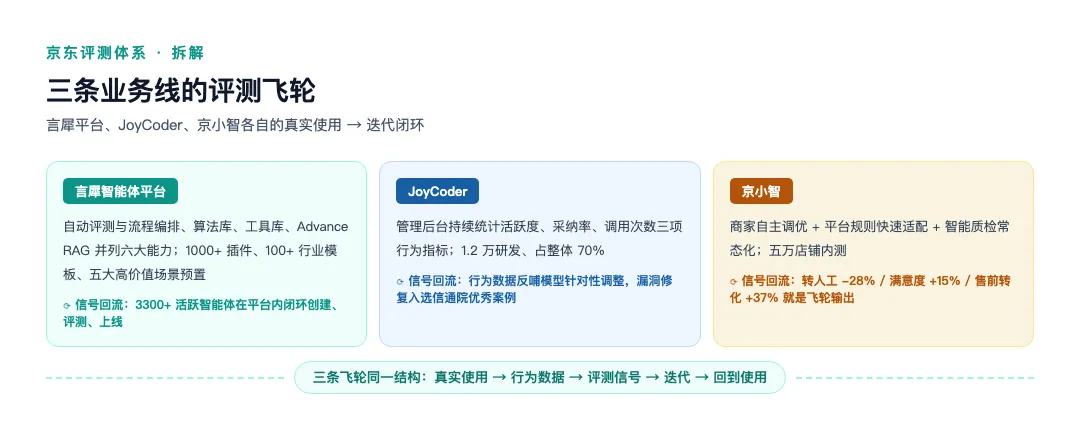
千帆把评估织进开发全流程,京东则把评测分散织进三条业务线,每条线都有自己的数据飞轮。
第一条线,言犀智能体平台:自动评测与流程编排、算法库、工具库、Advance RAG、数据分析并列,是平台六大能力组合之一。平台沉淀 1000+ 智能插件、100+ 行业解决方案模板,预置协同办公、专业助手、客户服务、营销推广、数据应用五大高价值场景模板。智能体从创建、评测到上线在同一平台闭环,京东内部 3300+ 活跃智能体、集团超 3 万个智能工具在跑。
第二条线,JoyCoder:管理后台的用户管理加数据统计,持续产出活跃度、采纳率、调用次数三项行为指标,反哺模型针对性调整优化。研发工具的运营数据就是评测数据,模型迭代周期跟着真实使用走。这套机制的效果有外部背书:基于 JoyCoder 的漏洞修复助手入选信通院 2024 安全守卫者计划优秀案例。
第三条线,京小智:商家自主调优 + 平台规则更新快速适配 + 智能质检常态化扫描,五万店铺内测的量化结果(转人工 -28%、满意度 +15%、售前转化 +37%)本身就是这条飞轮的输出。
三条线的飞轮转法不同,但结构一致:真实使用产生行为数据,行为数据当评测信号,评测信号驱动模型与配置迭代,迭代再回到真实使用。京东没有把 AgentOps 做成一个独立平台,而是做成了三条业务线的肌肉记忆。
八、安全红队:红蓝对抗产品化的双线布局
安全红队双线布局:检测线与防护线
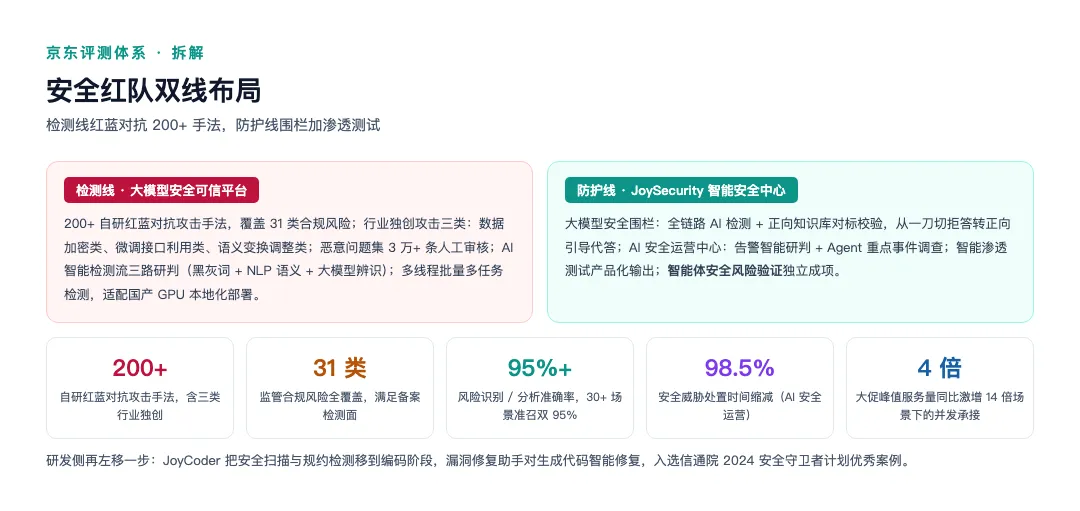
京东的安全评测是两条产品线的双线布局,一条管检测,一条管防护。
第一线是大模型安全可信平台,红队攻击能力的沉淀池:超过 200 种自研红蓝对抗攻击手法,覆盖监管合规要求的全部 31 类风险类型,且拥有行业独创的攻击能力,数据加密类、微调接口利用类、语义变换调整类攻击,相关研究已进入学术会议。配套的 3 万条恶意问题集(人工审核)与 5 类 31 种风险覆盖,使它同时满足备案检测的合规面。检测执行走 AI 智能检测流:黑灰词、NLP 语义、大模型辨识三路综合研判,恶意识别算法四种以上,识别准确率 95% 以上;支持多线程、批量、多任务同时检测,适配国产 GPU 与本地化部署。
第二线是 JoySecurity 智能安全中心,防护与运营的落地面:大模型安全围栏做输入输出全链路 AI 检测,配合正向知识库(全面契合法律法规与业务规范)做精准对标校验,从「一刀切拒答」转为「正向引导代答」;AI 安全运营中心基于安全运营大模型实现告警智能研判与 Agent 重点事件调查,安全威胁处置时间缩减 98.5%;智能渗透测试把红队攻击手法产品化输出。安全检测覆盖能源、制造、工业等 30 多个大模型应用场景,准召率均在 95% 以上,可识别暴恐、提示词注入、商业秘密、违禁内容等 30 多种风险。
值得注意的是 Agent 专属能力已经独立成项:JoySecurity 明确提供智能体安全风险验证,这与百度把 Agent 安全检测列为独立产品能力是同一步棋,大厂都看到了「智能体自身的工具调用链」是新攻击面。
再加一条研发侧的安全评测左移:JoyCoder 把安全扫描和规约检测移到编码阶段,漏洞修复助手对生成代码智能修复。安全评测从「上线前拦截」前移到「写代码时预防」,三条战线合围。
九、总评与可借鉴清单
| | |
|---|
| | 业务结果金字塔直通 GMV 与转化率,行为数据当评测信号;轨迹级指标缺位 |
| | 6300 实例真实数据专家验证、3 万条恶意问题集人工审核、诚实难度分级 |
| | 多智能体角色边界即归因边界、NL2SQL 四步兜底链;缺轨迹级回放 |
| | 自动比对流水线 + 稳定性复测 + 三路安全研判,性价比阶梯清晰;LLM 裁判方法论着墨少 |
| | OxyEcomBench 三角色 × 29 任务 × P0-P3 × 视觉证据优先,双螺旋 + 开放立尺,国内独一份 |
| | |
| | 200+ 攻击手法(含独创三类)、31 类全覆盖、Agent 安全独立成项、处置时间 -98.5% |
对想自建评测体系的团队,七条可借鉴实践:
- 评估器性价比阶梯:业务有标准答案的场景用代码比对,省下的裁判预算留给真正开放性的场景,不要全量请大模型当裁判。
- 行为数据当评测信号:采纳率、活跃度、调用次数是免费且持续的评测,工具类 Agent 尤其该用真实接受行为打分。
- 自建基准的三个设计决策:多角色覆盖全链路、证据与文本模态隔离防泄漏、难度分级宁缺毋滥。
- 双螺旋回报:基准既当行业尺子又当自家训练靶场,评测投入同一笔资产收两次。
- 立尺先修公信力:方法全透明、第三方同测、不回避对自家叙事不利的结论,运动员兼裁判也能被信任。
- 归因按角色切:多智能体的分工边界就是归因边界,把归因织进运营动线而非事后报告。
- 评测结果翻译成经营语言:转化率、GMV 增量、渗透率,让业务方听得懂评测,评测才进得了决策。