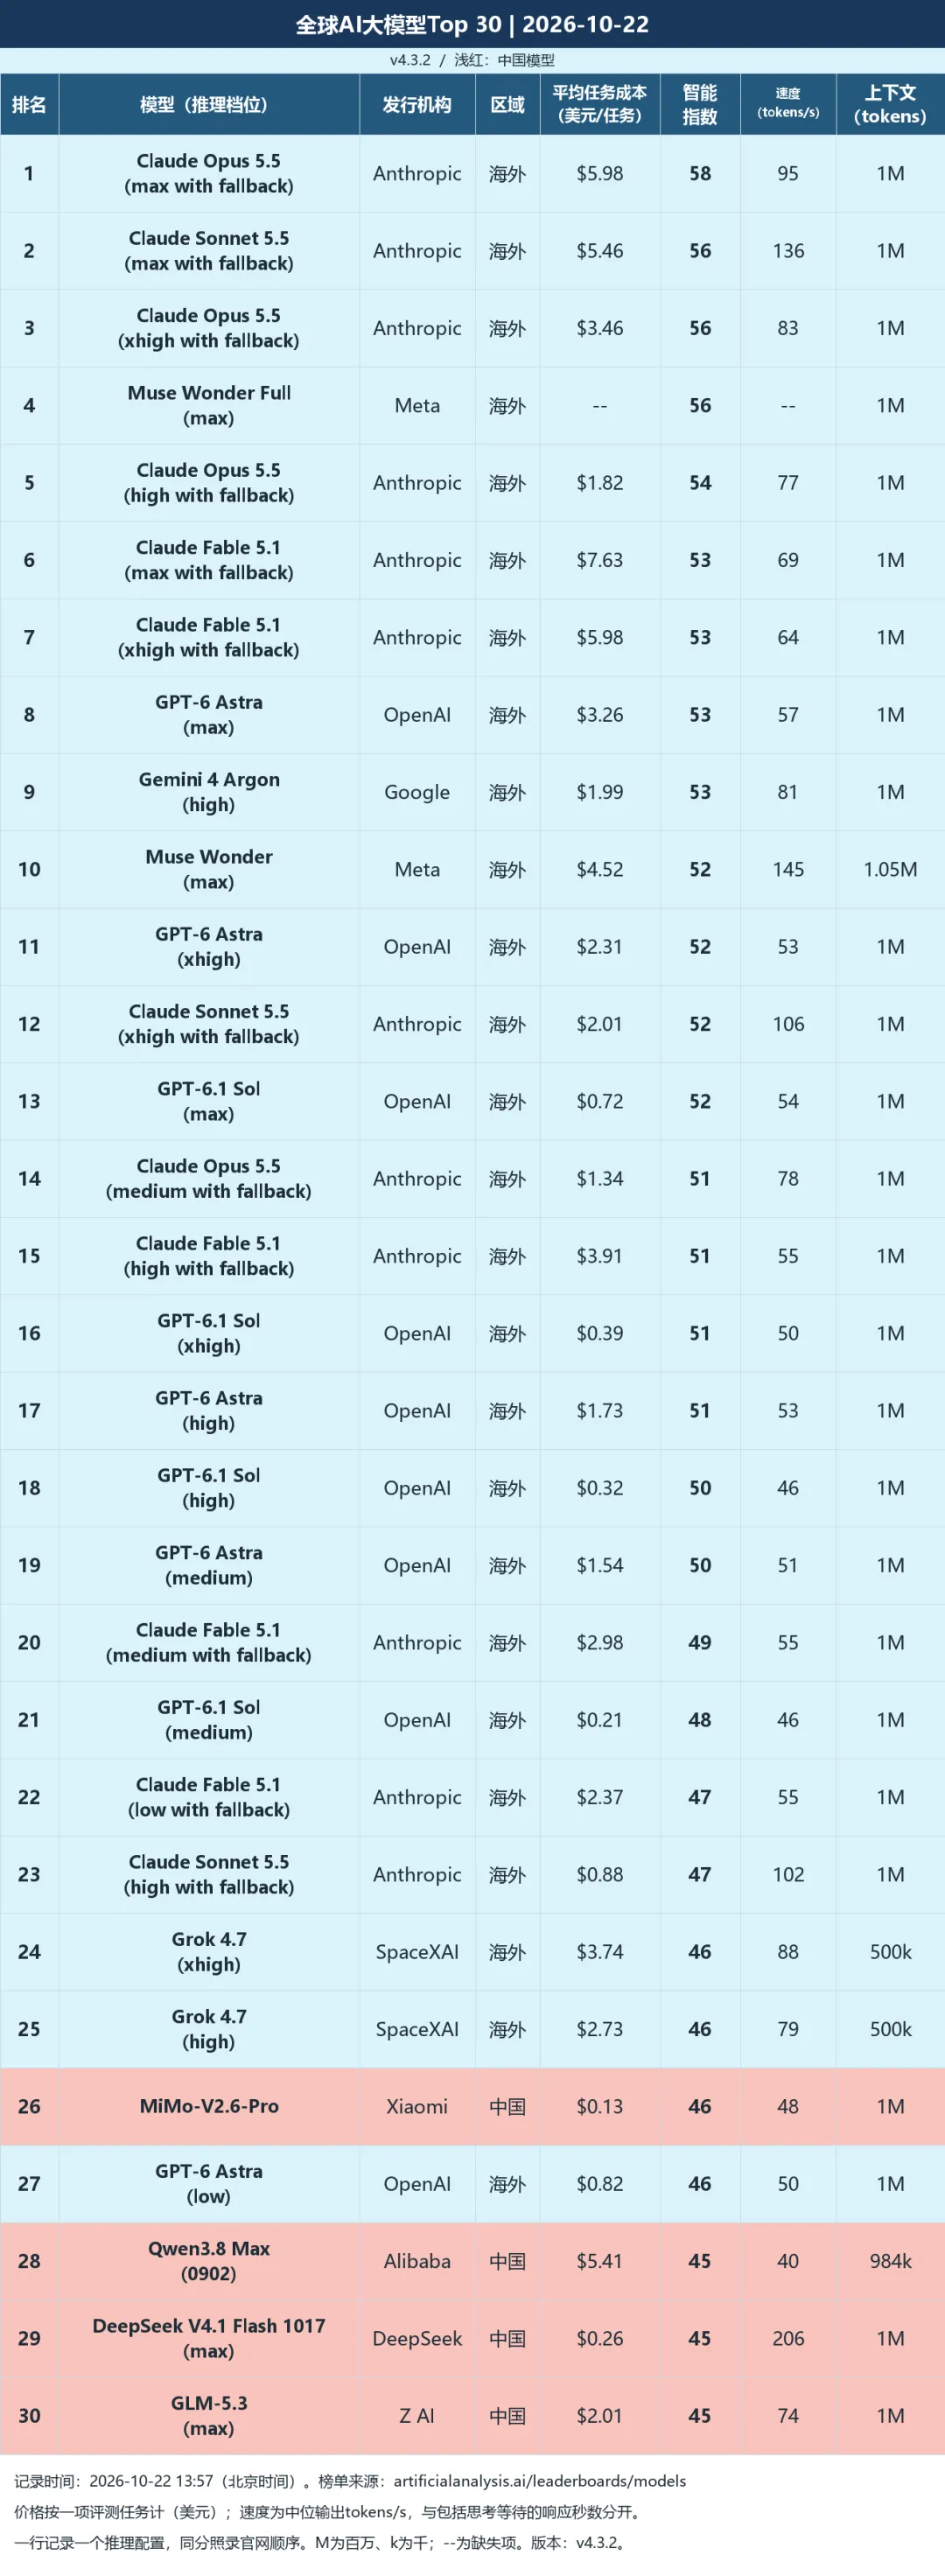
先看长图下半部分:浅红色从两行变成了四行,多出DeepSeek V4.1 Flash 1017和GLM-5.3。榜首没有换,仍是58分的Claude Opus 5.5。今天继续把前30名放在一张图里,图后说明名单怎么变了,以及这几组价格、速度和等待时间该怎样读。
第1名还是Claude Opus 5.5(max with fallback),58分、每项任务5.98美元。其后三行依次为Sonnet 5.5 max、Opus 5.5 xhigh和Muse Wonder Full max,都是56分。与10月18日快照相比,这四行的顺序、分数和已披露任务成本均未变,Wonder Full的成本、速度和响应时间也仍是“--”。
换行的是榜单后半段。DeepSeek V4.1 Flash 1017 max排第29,GLM-5.3 max排第30;10月18日图内的Muse Spark 1.3 max和xhigh,在本次Current列表中未列出。共同留在前30的28个条目,分数和任务成本都没变。这里能确认的是当前名单不同,不能据此给未列出的模型补一个“降分”结论。
榜首的等待时间倒有变化:Opus max总响应从733.40秒变为653.02秒,输出速度却从97变为95 tokens/s。速度略低,等待反而较短。两列描述的不是同一件事;两次官网快照也不是同一批请求的配对实验,不能把这个差额当成稳定提速幅度。
GPT-6.1 Sol max仍为52分、0.72美元,排第13。本次是54 tokens/s、首块延迟281.25秒、总响应290.45秒;10月18日对应为66 tokens/s、324.19秒和331.76秒。和Opus一样,只看输出速度会把这次变化读反。至于自己的长文输入要等多久,仍须另做测试。
第9名Gemini 4 Argon high仍是53分、1.99美元,但原来留空的运行指标已经有数值:81 tokens/s、首块延迟48.55秒、总响应54.69秒。能补充的是这次测量结果,不是“从无穷慢变快”,也不是发现它今天才具备这些能力。前一期没有数值,便无法计算前后提速。
同为52分的Muse Wonder max仍排第10,任务成本4.52美元,本次总响应46.59秒;Sol max为290.45秒。成本约为6.28倍,等待却短不少。用来批量抽取文献字段,还是反复追问一篇论文,取舍可能不同。这里的任务成本不是“每篇论文收费”,也不是每百万token的API报价。
浅红色现在有四行:第26名MiMo-V2.6-Pro,46分、0.13美元;第28名Qwen3.8 Max(0902),45分、5.41美元;第29名DeepSeek V4.1 Flash 1017 max,45分、0.26美元;第30名GLM-5.3 max,45分、2.01美元。MiMo、Qwen和GLM的展示分数、任务成本都与10月18日存档相同,不能把名次前移写成能力涨分。
从第28行读到第30行,会连续遇到三个45分。Qwen的任务成本是5.41美元,DeepSeek是0.26美元,GLM是2.01美元;总响应分别为65.05秒、13.19秒和36.46秒。DeepSeek这一档还给出了206 tokens/s和1.04秒的首块延迟。相同的总分下面,付出和等待相差很大;至于哪一个更擅长区分中文相近情绪,这几列尚未回答。
这里还要核对一个日期。DeepSeek带1017后缀的新评测条目,10月18日已出现在官方更新日志中,当时记录的就是45分。它没有进入那天10:18的留存快照,今天出现在第29行。GLM则一直有旧记录:10月18日排第31,今天排第30,同样是45分。若把这两行统称为“今天发布的国产新模型”,日期和对象都会混在一起。
Haiku 5.5 max从存档的第34移到第33,保留43分和0.21美元。总响应从338.50秒变成312.57秒,少了25.93秒;只是,等完这一轮仍要五分多钟。把312.57秒再拆开看,首块输出前占了310.44秒。模型开始往外输出以后并不慢,问题是开始之前要等多久,这也是长图里速度列容易漏掉的部分。
第34行值得顺手记进候选表:MiniMax-M3.1-Flash,43分、0.22美元,评测结果记录于10月19日。本次总响应28.23秒,首块延迟1.38秒,输出速度93 tokens/s。它比Haiku max的235 tokens/s低,但等待明显较短。两者刚好提供了一个同分对照:总分、输出速度、端到端等待,三种排序并不相同。
如果把图片的截取线往下挪两行,还能看到Step 5 Preview和Kimi K3 max,分别排31、32,都是44分,任务成本为1.03美元、2.00美元。这两个名字并没有从官网消失,只是本图截到30。本文额外记下它们和MiniMax,是为中文任务保留候选,不是另做一份情感识别排行榜。
整理这期时,最需要回查的其实是GLM。只看两张图,它从图外回到图内,很容易被写成“升分回归”;打开10月18日的原始记录,第31行就是45分、2.01美元。今天这两个数原封不动。Muse Spark又是另一种情况:本次Current列表没有那两行,当前快照没有给出它们降分的证据,本文只记录未列出。
给情感识别实验选模型,我更在意45分附近的几行会把什么判错。可以用同一批含反讽、多轮上下文和情绪转折的样本,逐条保留原文、预测标签、证据句与耗时。先检查标签有没有越界、证据是否真的出现在原文,再进入独立测试集,统计macro-F1和逐类召回率。小样本排查用来找故障,正式测试用来比较结果,两步各有用途。
还有一个数字含义要保留:这里采用Artificial Analysis Intelligence Index v4.3.2,主要评估英语文本,图像、语音和多语言另行报告。图中的45分不是45%的情感分类准确率。读完榜单,若能缩小一轮待测名单,再知道应该检查哪类错例,就已经比记住谁高一名、谁低一名更有用了。
数据来源: Artificial Analysis LLM Leaderboard(https://artificialanalysis.ai/leaderboards/models)
评测方法: Artificial Analysis Intelligence Index v4.3.2(https://artificialanalysis.ai/methodology/intelligence-benchmarking)
官方更新日志: Artificial Analysis Changelog(https://artificialanalysis.ai/changelog)
数据截点: 2026年10月22日