当大模型能够准确回答某一分子的功能时,是否意味着它同样能够正确回答该分子参与的信号通路及相关细胞反应?
在生命科学领域,分子、信号通路与细胞反应之间存在紧密的知识关联。传统正确率只统计模型答对了多少题,却不记录这些题目之间的知识联系。即使两个模型的正确率相同,也可能呈现不同的表现:一个能够连续答对同一组关联题目,另一个则在相关问题上表现不稳定。要看清这种差别,就需要先把题目之间的联系表示出来。
为此,上海人工智能实验室联合上海第九人民医院推出了面向生命科学大语言模型的图结构评测基准LG-Bench。研究团队从 Cell、Nature、Science 及其相关子刊公开发表的生命科学论文中提取知识,生成并筛选出医学、生物学和化学领域的 10,200 道四选一题目 。LG-Bench 再把每一道题作为一个节点,按语义联系把题目连接成图,全图共有 2,990,277 条加权边。模型作答后,这张图便能显示它答对了哪些相互关联的问题,以及错误集中在哪些知识区域。
从一份平铺的答题清单,到一张有联系的知识地图,LG-Bench 想回答的是:模型答对的知识,能否连成体系?
https://arxiv.org/abs/2610.26787
https://github.com/open-compass/opencompass/blob/main/opencompass/datasets/lgbench150.py
https://hub.opencompass.org.cn/dataset-detail/LG_Bench
研究团队从Cell、Nature、Science 及其相关子刊 近期发表的生命科学论文中提取知识,经过题目生成与筛选,最终题库包含 生物学 3,630 道、化学 3,360 道、医学 3,210 道 。
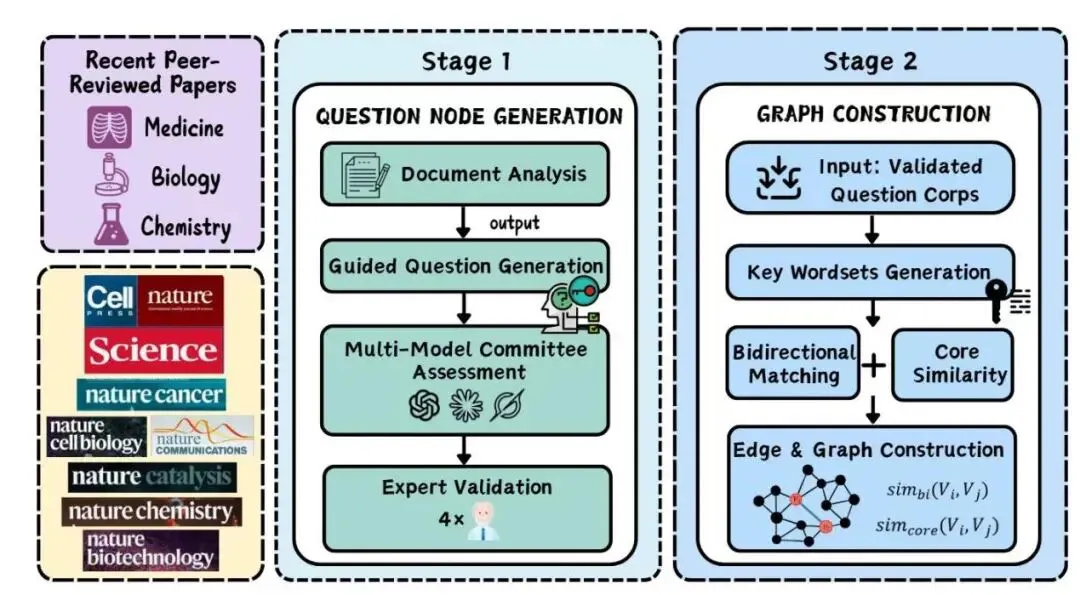
题目生成从文献分析开始:多模态模型先阅读来源论文,提取核心概念、属性及相互关系,并确定要考查的认知层级。随后,负责出题的语言模型依据这些信息生成候选四选一问题。候选题由 GPT-4o、Claude 3.7 Sonnet 和 Grok-3 组成的委员会评估科学准确性、认知复杂度和概念整合程度;四位生命科学博士专家再对被标记及随机抽取的题目,对照来源论文进行核验。
初始生成 13,250 道 ,委员会筛选后保留 10,597 道 ;专家核验其中 4,153 道 ,剔除 397 道 ,最终形成 10,200 道 。
图 1|文献分析、引导式出题、委员会评估与专家核验形成题库;通过筛选的题目随后用于构建评测图。
有了题库,下一步是判断哪些题目讨论了相近的知识。LG-Bench 让模型从每道题中抽取关键词,再把关键词转成向量。对于任意两道题,系统计算两组关键词两两之间的余弦相似度,并结合两种判断:
双向匹配看覆盖范围:从第一道题的每个关键词出发,在第二道题中寻找最相近的词,求平均;反过来再做一次,最后取两方向的均值。
核心相似度看最强联系:把两道题的关键词两两配对,计算每一对的余弦相似度,再将所有相似度从高到低排序,取前k个数求平均。其中 k=\min(3,|K_i|,|K_j|),|K_i| 和 |K_j| 分别是两道题的关键词数。比如两道题分别有 2 个和 5 个关键词,就从 2 * 5 个相似度中取最高的 2 个。
两种分数加权合成题目相似度;相似度大于阈值,两道题之间就连一条边,相似度同时成为这条边的权重。建图时,核心相似度权重设为 0.6,连边阈值设为 0.4。据此得到一张加权无向图:联系越强,边权越高;医学、生物学和化学问题之间也可以出现跨领域连接。
前三行仅统计各领域内的连边,完整评测图还包含跨领域的题目联系。
把模型的作答结果标在图上之后,LG-Bench 用三个指标读这份答卷。
Acc、GCS 以百分比呈现;KBS 先将局部连贯度乘以 100,再计算方差,因此表中的 KBS 是方差数值。
| | |
| | |
| 当一道题答对、紧密相连的其他题却答错时,正确答案仍会计入 Acc,但它对 GCS 的贡献会减小;相关题目也答对时,这一片区域会贡献更高的连贯得分。KBS 则观察这样的强项与薄弱区域,在整张图上分布得有多不均匀。 | |
| | |
当一道题答对、紧密相连的其他题却答错时,正确答案仍会计入 Acc,但它对 GCS 的贡献会减小;相关题目也答对时,这一片区域会贡献更高的连贯得分。KBS 则观察这样的强项与薄弱区域,在整张图上分布得有多不均匀。
研究团队评测了不同规模的通用模型、生命科学领域模型和闭源模型,采用相同的提示与评测流程,各项实验重复 3 次并取均值。下表摘录部分模型在完整评测图上的结果:
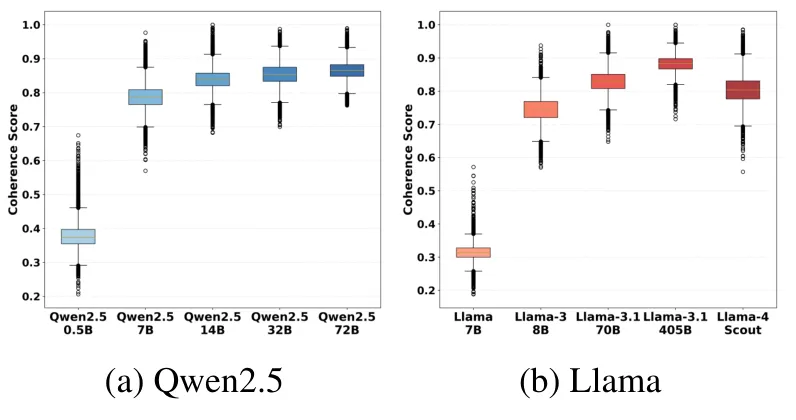
在 Qwen2.5 系列中,从 7B 到 72B,正确率提高 7.62 个百分点,GCS 提高 12.52 个百分点,KBS 则从 15.19 降到 10.26。更多题目答对的同时,相关题目的作答更连贯,各知识区域的表现差异也缩小。下方箱线图展示了不同规模模型在各节点上的局部连贯度分布。
在参与评测的模型中,GPT-5 的全图 Acc 和 GCS 最高,KBS 最低,分别达到 91.00%、83.10% 和 4.40。这三列数字把答题能力、相关知识的连贯性与区域之间的均衡程度放在了同一张成绩单上。
图 2|箱线图比较 Qwen2.5 和 Llama 系列不同规模模型在各题节点上的局部连贯度分布。
领域适配带来另一种变化。将 Llama-3-8B 与医学领域模型 Llama3-Med42-8B 放在三个领域的子图上比较,可以看到:
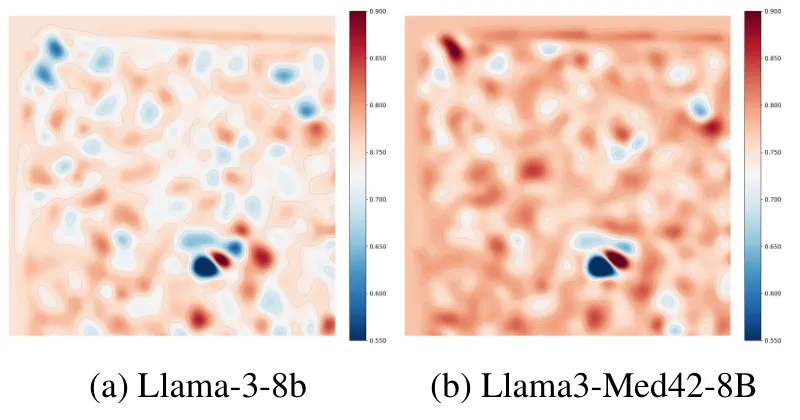
与基础模型相比,Llama3-Med42-8B 在医学、生物学和化学三个子图上的正确率与 GCS 均有所提高。其中,医学子图的变化最明显:正确率从 72.77% 提高至 78.10%,GCS 从 54.11% 提高至 61.60%,KBS 从 35.65 降至 25.61。下方热图进一步展示了医学适配前后,不同知识区域的局部连贯度如何变化。
图 3|左侧为 Llama-3-8B,右侧为 Llama3-Med42-8B;颜色显示不同题目节点的局部连贯度,红色较高,蓝色较低。
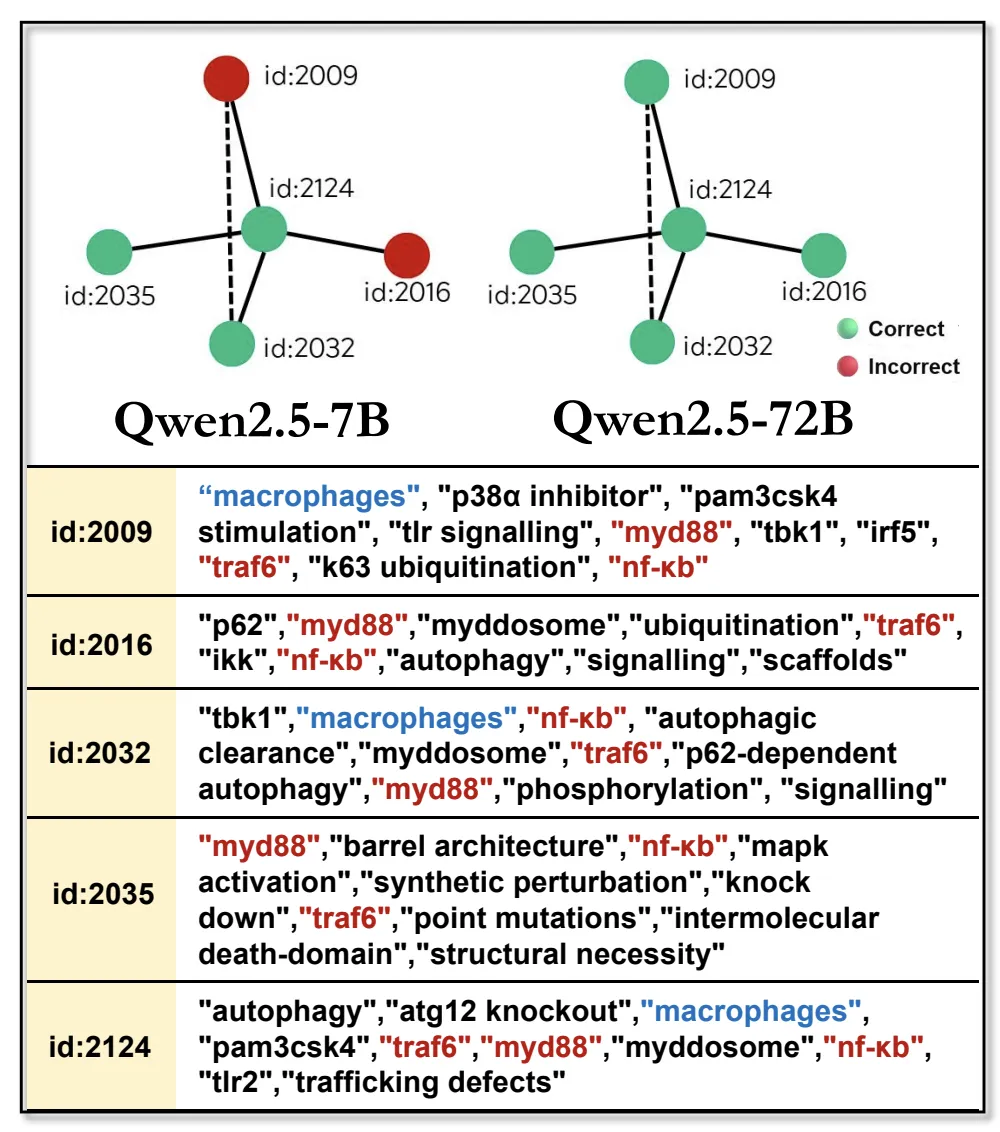
总体分数可以比较模型,局部图则能指出错误落在哪一组概念上。五道共享 MyD88、TRAF6、NF-κB 等概念的题目构成一组案例:Qwen2.5-7B 答错其中两道,Qwen2.5-72B 五题全部答对。这组题都涉及相近的分子与信号机制,较小模型在相关问题上的作答出现了断点。
图 4|绿色为答对,红色为答错;题目关键词展示这五道题之间的概念联系。
研究团队进一步去掉这五道题的选项,让模型开放式回答。对于其中一道题,Qwen2.5-7B 只给出笼统的“与自噬相关”解释,遗漏了依赖泛素的自噬转运这一关键机制;它还忽略了 MyD88 依赖的 myddosome复合物的作用,并错误地将其与早期 NF-κB 依赖的转录联系起来。错误由图上的红色节点,进一步落实到对具体机制的解释中。
这组案例揭示的薄弱点是:即使几道题共享关键词,模型仍可能在相邻问题中遗漏关键机制,无法稳定地运用相关知识。
上述实验呈现了两类仅看总体正确率难以读出的差异。一类是关联机制的理解是否连贯:五题案例中,小模型在共享概念的问题上仍会遗漏关键机制。另一类是知识分布是否均衡:医学模型在医学子图上进步明显,化学子图的局部表现差异却增大。这些差异为定位模型的知识薄弱区域提供了线索。
研究团队还检验了图指标的稳健性及其与人工评价的一致性。调整连边相似度阈值与两种相似度的组合权重后,GCS 的数值相对稳定;KBS 的绝对数值随图的稀疏程度变化,所比较模型的相对排序保持稳定。在 450 道题的子集上,人工评估模型开放式回答的推理深度和准确性;GCS、KBS 与人工评价的 Spearman 秩相关系数分别为 0.94 和 0.90 。
LG-Bench 为后续的模型分析提供了更具体的入口:找到错误集中的关联题目,追查模型遗漏的概念和机制;比较领域训练前后的局部表现,观察能力改善落在何处。这样的结构化诊断可以为模型能力分析和优化提供依据。
下一步值得追问的,不只是模型还能多答对多少题,还有它能否把相关机制稳定地串起来,让知识进步覆盖更多区域。