scGPT、Geneformer 这类基础模型,此前几乎没有在「不做任何额外训练」的场景下被严格评估过——也就是零样本(zero-shot):直接拿模型内部的表征去做下游分析,不再针对具体任务训练。理解模型在零样本设定下的表现,对那些无法微调的应用至关重要,比如标签本身就未知的探索性研究。作者对 Geneformer 和 scGPT 的零样本性能做了评估,结果显示:在某些情况下,这些模型可能面临可靠性方面的挑战,甚至会被更简单的方法超过。这一发现凸显了在单细胞研究中开发和部署基础模型时,零样本评估的重要性。
零样本评估揭示单细胞基础模型的局限
Zero‑shot evaluation reveals limitations of single‑cell foundation models
时间:2025 杂志:Genome biology 影响因子:9.2 分区:Q1
基础模型是在海量数据上预训练的机器学习模型,目标是让模型捕捉数据中的普适规律。这份「基础知识」有两种用法:用少量额外训练迅速适配到具体任务,或者零样本使用——把模型对输入数据的内部表征(即 embedding,嵌入/表征)直接拿来做下游分析,完全不再做任务特定训练。
单细胞生物学领域对基础模型兴趣很大,人们期待它们能自动完成细胞类型鉴定、基因表达预测这类任务,CELLxGENE 等数据平台也在为这种数据需求而兴起,一批基础模型相继被提出。问题在于,目前这些模型主要靠微调来展示性能,对零样本设定的探索非常有限。而在蛋白质序列、生物医学图像等其他生物学领域,评估标准恰恰强调:零样本评估才是判断预训练有没有真正学到可迁移的生物学理解的关键。蛋白质语言模型的近期研究更是揭示,迁移学习可以通过若干平凡机制「看起来」提升下游任务表现,实际上并没有依赖预训练中的复杂学习。
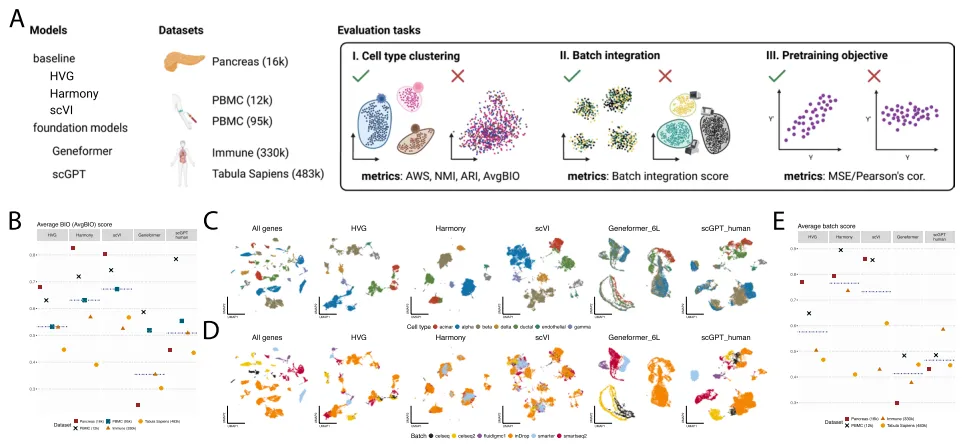
零样本评估在单细胞生物学中的意义尤其突出:这里很多任务是探索性的,缺乏预定义标签,微调的可行性因此受限。作者对两个流行的单细胞基础模型 Geneformer 和 scGPT 做了零样本评估(图 1A),直接检验其原作者关于「生成稳健细胞表征」「对未见过数据集有强泛化能力」的宣称。
图 1 | 对模型生成的细胞嵌入空间的评估。A 评估设置概览。我们在五个不同的数据集上,将 Geneformer 和 scGPT 与 scVI、Harmony 以及高变基因(HVG)的选择进行比较。B HVG 以及来自 Harmony、scVI、scGPT 和 Geneformer 的嵌入的平均 BIO 分数。C、D 使用模型生成的细胞嵌入空间对 Pancreas (16k) 数据集 UMAP 投影的可视化。细胞按细胞类型(C)和批次(D)进行颜色编码。E HVG 以及来自 Harmony、scVI、scGPT 和 Geneformer 的嵌入的平均批次分数。B 和 E 中的虚线表示跨数据集计算得到的中位数。
2.1 模型与基线
我们评估了两个面向单细胞转录组学提出的基础模型:Geneformer 和 scGPT。选择这两个模型,是因为它们提供预训练权重,并且是在大规模数据集(约 3000 万个单细胞转录组)上以无监督目标训练得到的。在评估时,其他若干可能的候选模型没有公开可用的权重。下面我们概述 Geneformer 和 scGPT,包括它们提取细胞表征(即单细胞的隐表示)的做法——我们的分析沿用这些做法。
两个模型都接受单细胞基因表达向量作为输入,但对数据的表示方式不同。Geneformer 模型的输入是一个排序列表,其中一个基因的位置代表它相对于该细胞内其余基因的表达水平。该模型采用受 BERT 启发的架构,含 6 个 Transformer 层,每层有 4 个注意力头。
Geneformer 用掩码语言建模(MLM)任务的一个变体进行训练,模型被训练去恢复随机选中的、被掩码或被破坏的基因。由于基因是按其表达排序的,这实际上就是在预测某个基因相对于其他基因的表达。模型输出基因表征,随后被解码为基因预测。细胞表征通过对该细胞提取到的所有基因表征取平均得到。Geneformer 在 2740 万个人类单细胞转录组上预训练(排除恶性细胞和永生化细胞)。
scGPT 对每个基因表达向量做预处理:将数值独立分箱到 50 个等距的箱中,最低箱对应最低表达,最高箱对应最高表达。接着,分箱后的数值和基因 token(即每个基因的唯一索引)分别被嵌入,并在嵌入空间中相加——共同表示该基因及其分箱后的表达。与 Geneformer 一样,scGPT 也使用 MLM 任务。
不过 scGPT 直接学习一个细胞表征,并把它整合进预测掩码基因的预训练损失中:scGPT 先从未被掩码的基因预测被掩码基因的表达分箱和一个细胞表征;然后在第二步中,用第一步预测出的细胞表征进一步迭代精修被掩码基因的表达。这意味着 scGPT 在其预训练任务中输出两套分箱基因预测,第一套仅来自未掩码的基因,第二套则以细胞表征为条件。为了理解预训练目标的泛化情况,我们对两套都做了分析。
最后,与 Geneformer 相比,scGPT 的参数量是其 3 倍,使用 12 个 Transformer 层、8 个注意力头。scGPT 有多个变体,各自在多个不同数据集上预训练。在我们的分析中,我们聚焦于三个变体:在 81.4 万个肾脏细胞上预训练的(scGPT kidney)、在 1030 万个血液和骨髓细胞上预训练的(scGPT blood)、以及在 3300 万个非癌人类细胞上预训练的(scGPT human)。
在评估细胞表征时,作为基线,我们把 Geneformer 和 scGPT 与选取高变基因(HVG)的做法做比较。所有实验中我们统一取 2000 个 HVG。此外,我们还把所有方法与 scVI(一个可扩展的生成模型)和 Harmony(一种调整共享嵌入空间的方法)做比较,这两者是我们在每个数据集上单独训练的。
虽然这意味着我们对 scGPT 和 Geneformer 是零样本部署、而对 scVI 和 Harmony 是在目标数据上训练,但我们认为这一设置反映了实际情形——现实中训练轻量模型往往比微调更大的模型更容易获得资源。重要的是,Harmony 和 scVI 的设计本身就把批次标签纳入了训练过程,基线的这一特性使其能够直接处理批次效应。相比之下,Geneformer 和 scGPT 在预训练时并没有显式使用批次标签,它们的思路是在预训练阶段通过接触极其多样的细胞,间接学会缓解批次效应。在评估预训练目标时,我们用均值估计或平均排序作为参照。
2.2 数据集
为评估细胞表征的质量以及在批次整合任务上的表现,我们使用了五个不同的人体组织数据集(附加文件 1:表 S7)。这些数据集包括来自胰腺的样本、两套外周血单个核细胞(PBMC)、一个跨组织免疫细胞图谱,以及一个多器官人类细胞图谱。每个数据集都提出了与单细胞分析相关的独特挑战,例如界限清晰与界限不那么清晰的细胞类型簇之间的区分、同一组织内不同技术批次的整合(附加文件 2:图 S2),以及跨多个组织的数据统一(附加文件 2:图 S1)。用于模型预训练的数据集与本文所用数据集的概览,在下文 Data availability 部分讨论。
在所选数据集中,胰腺数据集与用于预训练 Geneformer 的数据存在部分重叠(GEO ID 为 GSE84133 的版本被纳入了预训练)。我们同时使用完整的胰腺数据集及其不重叠的子集进行了评估。两者结果一致,因此在本次评估中我们为简便起见采用完整的胰腺数据集(附加文件 1:表 S1 和表 S5)。Tabula Sapiens 和 Immune 数据集被包含在用于 scGPT 预训练的 CellxGene 合集(2023 年 5 月普查版)中。
2.3 评估指标
我们评估细胞表征空间正确区分已知细胞类型的能力,以及整合不同批次的能力。评估时,我们基本遵循 Luecken 等人描述的方法,其中包括挑选最契合所评估任务的具体分数(见下文描述)。我们还通过评估重建准确性,来考察模型在预训练任务上的表现。
2.3.1 生物学保留分数
评估细胞表征的一个关键方面,是细胞类型在表征空间中彼此区分的程度。为此,我们采用基于平均轮廓宽度(ASW)和平均 Bio(AvgBIO)分数的指标。简要地说,ASW 的计算方式是:取簇间距离与簇内距离之差,再除以二者中较大的那个值。ASW 被归一化到 0 到 1 之间,其中 0 表示簇内高度内聚,0.5 表示簇彼此重叠,1 表示簇被很好地分开。ASW 越高,说明分离簇的表现越好。
AvgBIO 是三个单项指标的算术平均:ASW、归一化互信息(NMI)和调整兰德指数(ARI)。NMI 和 ARI 是基于直接从表征空间生成的 Louvain 聚类计算的,方法同 Luecken 等人。简要地说,聚类在 20 个分辨率上计算,选取 NMI 指标最高的那个分辨率;然后用选定的分辨率生成聚类,再报告 NMI 和 ARI 指标。AvgBIO 被归一化到单位尺度,数值越高表示聚类与真实标签的吻合越好。
2.3.2 批次混合分数
为评估批次混合的程度,我们使用了平均轮廓分数的一个变体,我们称之为批次整合分数(相对于批次计算、并在各细胞类型上取平均的平均轮廓宽度分数),以及 PCR 分数。简要地说,轮廓分数是针对每个细胞类型、相对于批次标签计算的,只取其绝对值,其中 0 等同于完全混合,任何偏离 0 的情况都表明存在批次效应。为与惯用约定保持一致,随后用 1 减去该分数,得到 0 到 1 之间的最终分数:最终分数为 0 表示批次完全分离、批次效应很强,为 1 则表示批次完美混合与整合。
主成分回归(PCR)分数比较的是批次变量所解释的方差比例在原始数据集与模型表征之间的差异。我们还定义了 AverageBIO 分数的对应物——Average Batch Score,它是 PCR 分数与批次整合分数的算术平均。
2.3.3 重建基因表达
在预训练中,两个模型都会选取一定百分比的基因进行掩码;因此这项评估需要决定输入中有多少基因被掩码。为消除采样中的随机性,并再现信息量最大的设定,我们把所有基因都不加掩码地作为输入。我们在与细胞表征任务相同的数据集上评估模型。为评估 scGPT 在其预训练目标上的表现,我们使用均方误差(MSE),这也是原作者用作模型损失的指标。
为评估 Geneformer 在其预训练目标上的表现,我们测量真实排序与预测排序之间的皮尔逊相关。为此,我们把有序输出转换为缩放到 0 至 1 的排序,其中表达最高的基因被赋予排名 1。Geneformer 最多可输出 2048 个基因的序列;当输入以批的形式传入时,模型输出的序列长度等于最长输入的长度。在我们的评估中,我们把输出序列限制到输入序列的长度。
3.1 结果与讨论
scGPT 和 Geneformer 都会产生细胞表征,目的是把可能带噪声的基因表达测量投影到一个生物学上更相关的隐空间,然后这些细胞表征会被微调用于细胞类型分类。然而,这种微调策略在更具探索性的情境中会失效——那里数据集中的细胞组成可能并不已知;在这些设定下,基础模型必须零样本地产生稳健的细胞表征。
我们评估了 scGPT 和 Geneformer 在多个数据集上区分已知细胞类型的零样本表现(图 1B)。以平均 BIO(AvgBIO)分数衡量,两个模型在细胞类型聚类上的表现都不如选取高变基因(HVG),也不如 Harmony、scVI 这类更成熟的方法(图 1B,附加文件 1:表 S1)。若只考虑平均轮廓宽度(ASW)指标,这些成熟基线仍然优于 scGPT 和 Geneformer(附加文件 2:图 S3,附加文件 1:表 S1)。
scGPT 在 PBMC(12k)数据集上的表现优于 scVI、Harmony 和 HVG;但在其他数据集上,就 AvgBIO 分数而言它比 scVI 和 Harmony 都差(图 1B,附加文件 1:表 S1)。就 ASW 分数而言,scGPT 在 Tabula Sapiens、Pancreas 和 PBMC(12k)数据集上与 scVI 相当,并在 Tabula Sapiens 数据集上优于 Harmony(附加文件 2:图 S3,附加文件 1:表 S1)。HVG 在所有指标上都优于 Geneformer 和 scGPT(附加文件 2:图 S4,附加文件 1:表 S1 和表 S2)。
鉴于各数据集上表现不一,我们试图弄清,这种差异能否用评估数据集与预训练数据集之间的潜在重叠来解释。我们发现胰腺数据集与用于 Geneformer 的预训练集存在部分重叠。此外,Tabula Sapiens 和 Immune 数据集被包含在 scGPT 的预训练数据集中(附加文件 1:表 S3)。然而,scGPT 和 Geneformer 在预训练时已经见过的数据集上并没有稳定地超过基线,而 scGPT 唯一同时超过两个基线的、且在预训练中未见过的数据集是 PBMC 12k 研究。
接下来,为评估预训练数据集对细胞类型聚类零样本表现的影响,我们测试了四种不同的 scGPT 变体:随机初始化的 scGPT,以及在 81.4 万个肾脏细胞(scGPT kidney)、1030 万个血液和骨髓细胞(scGPT blood)、3300 万个非癌人类细胞(scGPT human)上预训练的 scGPT(附加文件 2:图 S5)。我们注意到,较小的模型是在组织特异性数据上训练的,这就混淆了性能差异究竟来自模型规模还是数据集构成。
不过至少可以确定,scGPT human 包含了用于预训练 scGPT blood 和 scGPT kidney 的数据。我们的分析表明,预训练在 PBMC(12k)数据集上带来了明确的细胞类型聚类改善,并且三个 scGPT 模型跨数据集计算的中位分数都高于随机基线(附加文件 2:图 S5,附加文件 1:表 S1)。我们还观察到,在 scGPT kidney 未能超过随机模型的一些数据集上(包括 Immune 和 Tabula Sapiens 数据集),scGPT human 和 blood 仍能超过随机模型,这提示性能可能随预训练数据集增大而提升。出人意料的是,scGPT human 略逊于 scGPT blood,即使是在涉及血液和骨髓细胞以外组织类型的数据集上也是如此(附加文件 2:图 S5,附加文件 1:表 S4)。
总体而言,零样本配置下的 scGPT 和 Geneformer,相比来自 HVG 或由 scVI、Harmony 生成的细胞表征,表现并不稳定。对 scGPT 各变体的评估凸显出:虽然预训练带来了一定收益,但超过某个界限之后,更大、更多样的数据集可能不再带来额外收益。此外,模型在预训练时见过的数据集上表现也不好,说明预训练目标与细胞类型聚类之间的关系并不清晰。
我们接着评估了这些被提出的单细胞基础模型在批次整合上的零样本能力(图 1C–E)。批次整合是单细胞分析中的常见任务,目标是在不去除有意义的生物学差异的前提下,消除来自多个数据来源的批次效应。我们首先在胰腺基准数据集上可视化了 scGPT、Geneformer 及其他基线的表征,该数据集包含来自五个不同来源的数据(图 1C–D)。
Geneformer 和 scGPT-human 虽然能整合以相同实验技术开展的不同实验,但它们总体上无法校正不同技术之间的批次效应。定性来看,Geneformer 的细胞表征空间未能保留细胞类型的信息,任何聚类主要由批次效应驱动。而 scGPT 的细胞表征空间虽然在细胞类型之间提供了一定的分离,但降维中的主要结构仍由批次效应主导(图 1C–D)。Harmony 和 scVI 则在很大程度上成功整合了胰腺数据集。
用批次整合指标做定量评估发现,Geneformer 在大多数数据集上都不如 scGPT、Harmony、scVI 和 HVG(图 1E)。在批次仅限于技术差异的数据集上(Pancreas 和 PBMC),scVI 和 Harmony 都优于 scGPT;但在同时存在技术性和生物学性(即供体之间的差异)批次效应的更复杂数据集上,它们分别被 scGPT 超过(分别对应 Tabula Sapiens 和 Immune 数据集;图 1E,附加文件 2:图 S6)。
我们注意到,Immune 和 Tabula Sapiens 数据集都被用于 scGPT 的预训练,这凸显了我们评估的一个局限——我们无法判断这些改善是否源于模型在预训练中已经见过这些数据集。尽管批次混合的评估分数各有波动——Harmony 在批次整合上排名最后,但在主成分回归(PCR)分数上排名第二,考虑到 Harmony 通过调整 PC 表征来校正批次效应,这是符合预期的——Geneformer 在所有指标上都稳定排在末位(附加文件 1:表 S2)。
Tabula Sapiens 数据集给 Harmony 带来了显著挑战,尤其是在 PCR 分数方面;而 Immune 数据集则给 scVI 带来了类似的困难(附加文件 2:图 S6B)。Geneformer 在所有数据集上的表征中,由批次效应解释的方差比例都高于原始数据,表明批次混合不充分(附加文件 2:图 S6B)。因此,Geneformer 在批次混合分数上始终排在最后(附加文件 1:表 S2),凸显了它相比其他模型在有效处理批次效应上的局限。
出人意料的是,所有数据集上最好的批次整合分数都是由选取 HVG 取得的(附加文件 1:表 S2)。这一观察与我们的定性观察(图 1C–D)略有出入,原因在于我们的排名指标是在完整维度而非降维空间中计算的(附加文件 2:图 S6A,附加文件 1:表 S5)。不过,无论在完整维度还是降维空间中,这些被提出的基础模型都不如 Harmony 和 scVI(附加文件 1:表 S4 和表 S6)。
对于 Geneformer 和 scGPT 在零样本下不如所测基线,我们提出两个假设。第一,可能是 scGPT 和 Geneformer 所用的掩码语言模型预训练框架并不能产生有用的细胞表征。第二,可能是 scGPT 和 Geneformer 根本没有学会预训练任务。为区分这两种可能,我们评估了这些模型在基因表达重建这一预训练任务上的表现(对 scGPT 是每个基因的分箱值,对 Geneformer 是基因排序)(图 2,附加文件 2:图 S7)。
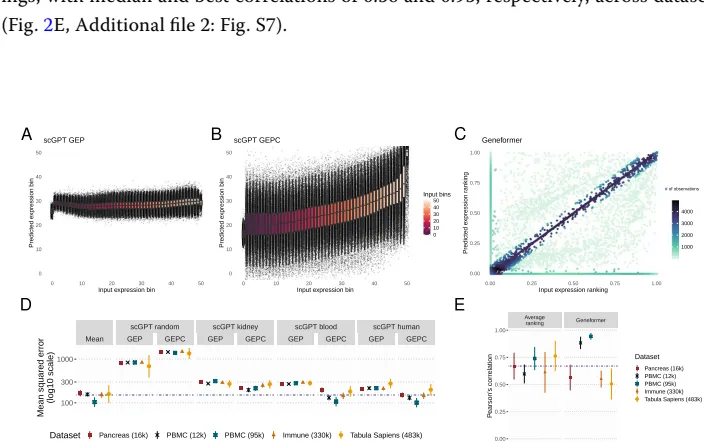
图 2 | scGPT 与 Geneformer 在基因表达重建方面的性能比较。A–C Immune (330k) 数据集中表达的重建:A 掩码语言建模(MLM)目标下的 scGPT 基因表达预测(GEP)。B scGPT 由细胞嵌入进行的基因表达预测(GEPC)。C Geneformer MLM 输出的预测表达排名(y 轴)与真实输入表达排名(x 轴)的对比。D scGPT 各目标的均方误差(MSE)比较。均值和标准差范围分别以点和实线表示,基于均值的重建的 MSE 中位数以虚线表示。E Geneformer 以及平均基因排名的输入表达排名与预测表达排名的皮尔逊相关性。均值和标准差范围分别以点和实线表示,平均排名的相关性中位数以虚线表示。
我们发现两个模型在重建基因表达上都面临挑战(图 2)。在不以其细胞表征为条件时,scGPT 在所有分箱值上都预测输入箱的均值(图 2A)。当以细胞表征为条件时,预测有所改善,尤其是在较高的输入值上(图 2B)。在其掩码语言建模(MLM)目标下,Geneformer 预测给定位置上最可能的基因。尽管在许多基因上吻合良好,但也存在 Geneformer 预测出输入中并不存在的基因的情况(图 2C,附加文件 2:图 S7)。
不使用表征的 scGPT 甚至不如「预测均值」这一朴素基线,而加入细胞表征后也只有边际改善(图 2D)。Geneformer 的基因排序与真实排序仅表现出中等相关,跨数据集的中位相关和最佳相关分别为 0.56 和 0.95(图 2E,附加文件 2:图 S7)。
这项工作对 Geneformer 和 scGPT 两个单细胞基础模型做了零样本评估。两个模型以其当前形态都没有稳定超过更简单的基线,并且在应对批次效应上面临困难——尽管它们在原论文中微调后报告了很好的性能,这说明零样本评估能揭示只用微调评估时看不到的弱点。这些发现对 MLM 用于学习单细胞表征的普遍适用性提出了疑问。
研究采取的是聚焦式的做法:只针对特定模型、选取有限数量的数据集,并不能穷尽单细胞分析的全部应用(例如所用数据集只包含转录组数据)。另一个局限是部分评估数据集被用于预训练,使得作者无法判断性能趋势是普遍规律,还是源于模型此前见过特定数据集。
版权与出处
本文是对下列论文的中文编译,由「数字细胞实验室」整理,对原文作了翻译、节选与改写。
- 原文标题:Zero-shot evaluation reveals limitations of single-cell foundation models.
- 原文作者:Kedzierska KZ、Crawford L、Amini AP 等
- 发表于:Genome biology · 2025
- 原文链接:https://pubmed.ncbi.nlm.nih.gov/40251685/
- 版权:© 2025 Kedzierska KZ、Crawford L、Amini AP 等
- 原文许可协议:CC BY 4.0(https://creativecommons.org/licenses/by/4.0/)
- 文中图表引自原文,依该协议原样转载,未改动图表内容
原文依 CC BY 4.0 授权公开,本文在该协议下编译转载并标明改动。
编译内容不代表原作者观点,未经原作者审阅或认可;原文按「现状」提供,原作者不对其作任何明示或默示的担保。 本文仅供学术交流与科普参考,不构成任何诊疗建议。