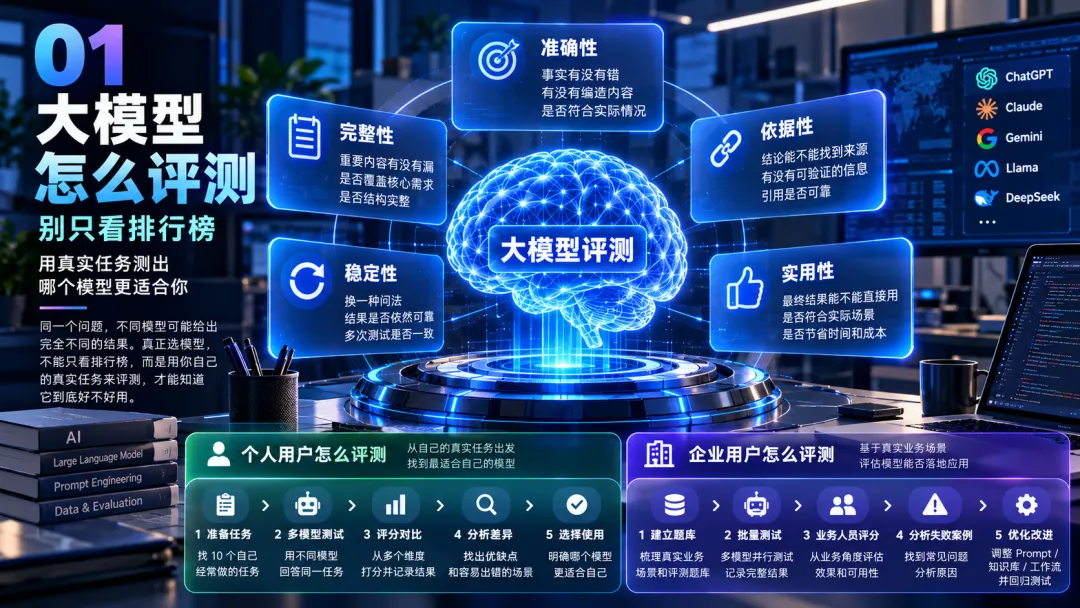
别只看排行榜
用真实任务测出哪个模型更适合你
同一份资料,昨天答得不错,换一种问法以后却开始漏信息,甚至一本正经地说错。对个人来说,这决定你敢不敢把它用于写作、学习、求职、资料分析;对企业来说,这决定一个大模型系统能不能真正进入业务流程。关键判断
真正选模型,不是看排行榜第一名是谁,而是看它在你的任务里到底靠不靠谱。🎯 01|为什么不能只看排行榜和演示
排行榜能告诉你模型在某些标准测试中的表现,演示也能证明它“可以做这件事”。但这两样都不能直接回答:它是否适合你的真实任务。比如一个模型写诗很强,未必适合你分析合同;一个模型在公开榜单里很靠前,也可能因为你使用的知识库、提示词或工具配置不同,在实际任务里表现一般。🧪 02|大模型评测到底是什么
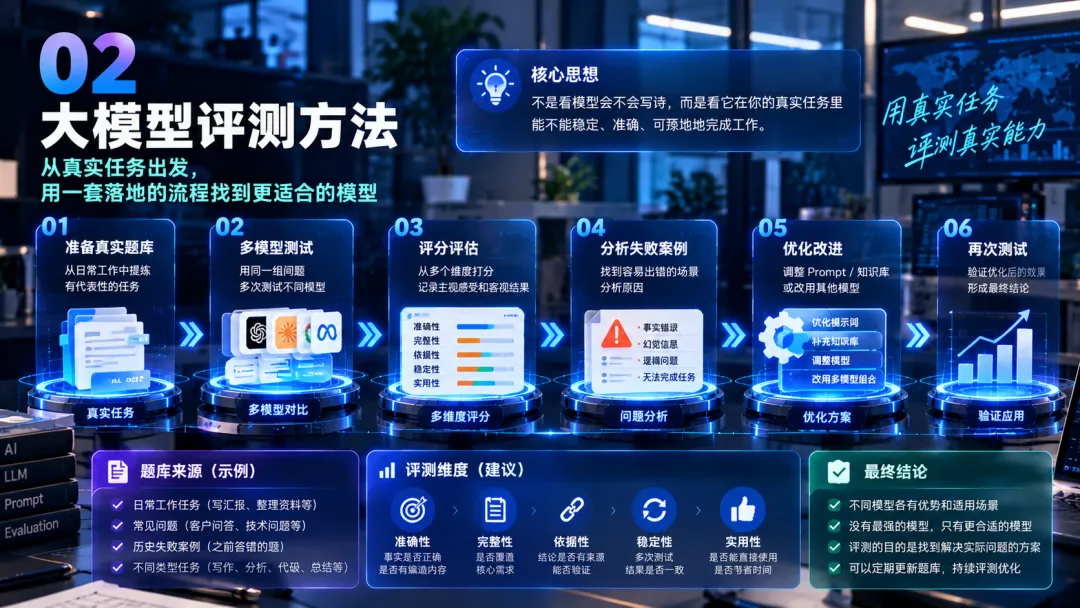
Eval,可以理解成给大模型准备一套固定的“真实考题”和评分标准,然后反复测试。关键不在于问它几个问题“感觉一下”,而是把任务、标准和结果都记录下来。模型、Prompt、知识库或流程改了以后,再跑同一套题,看它是真的变好了,还是只是换了一种方式出错。评测对象不只是模型本身
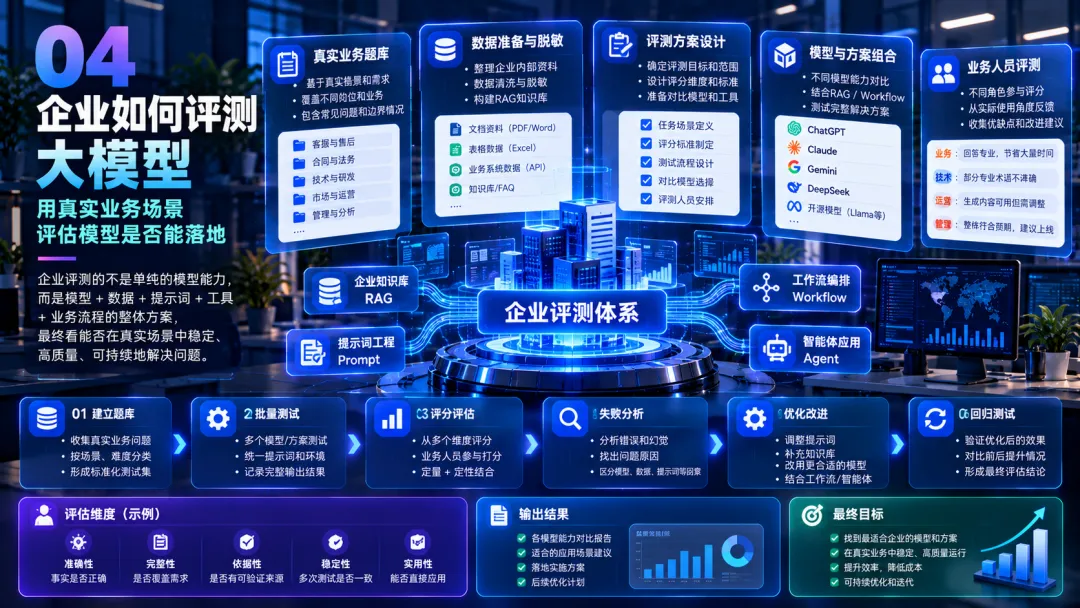
实际使用中,往往需要一起评测:模型 + Prompt + RAG知识库 + Workflow / Agent + 数据质量。📚 03|第一步 先准备自己的真实题库
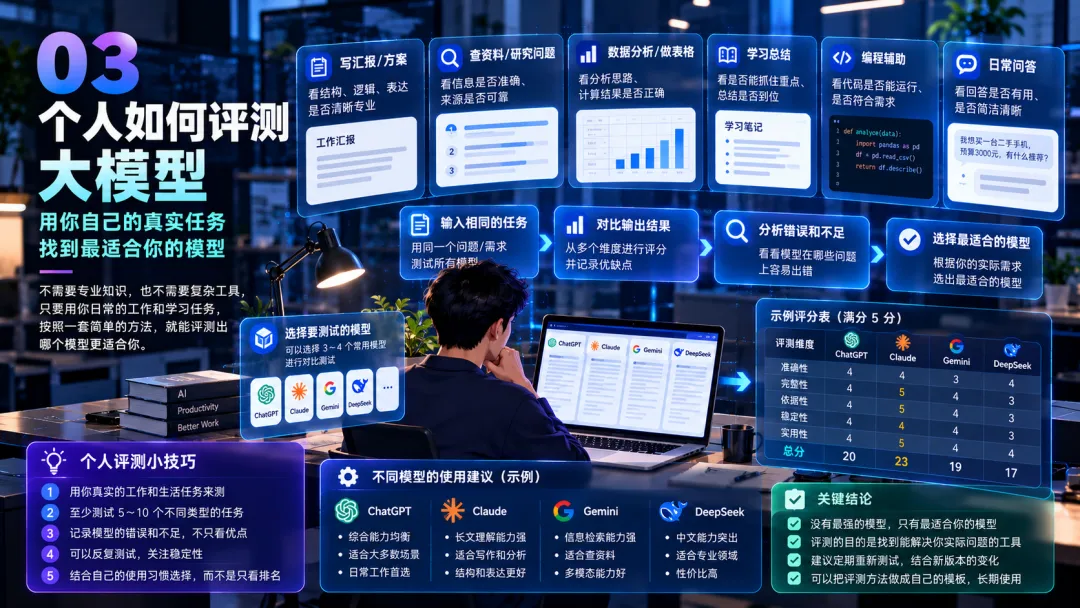
评测最容易犯的错误,是拿一些和自己工作毫无关系的问题去测模型。真正有价值的题库,应该来自你每天真的会做的事。个人用户可以这样准备:
企业题库则可以来自:
📏 04|评测大模型主要看哪几个指标
重点看这5个指标:
- 稳定性 换一种问法、重复执行时,结果是否依然可靠。
- 实用性 结果能不能直接使用,还是需要大量人工返工。
企业场景还要额外关注安全、权限、成本、人工返工率,以及错误发生以后能不能追溯和纠正。🔍 05|真正重要的是找到它为什么会错
平均分有用,但失败案例往往更值钱。100道题答对90道,真正决定你敢不敢用的,可能是剩下10道到底错在什么地方。- 明明不知道还继续猜:需要增加拒答、澄清或人工确认机制
重点:评测不是为了证明模型“有多强”,而是为了找到它在哪些情况下“不可靠”。👤 06|个人怎么做一个最简单的评测
个人评测最简单可以按这5步做:
- 选10个真实任务直接选你自己经常做的任务,不要去网上找花哨测试题。
- 先写清楚好结果明确必须包含哪些信息、不能出现哪些错误、输出格式是什么。
- 固定条件测试同一个任务尽量使用相同资料和要求,避免边测边改规则。
- 记录结果记下模型、Prompt、是否正确、遗漏点、是否能直接使用。
- 换模型或方法比较不要凭一次印象下结论,至少多做几组同类任务。
🏢 07|企业怎么建立评测闭环
企业和个人的本质逻辑一样,只是题库更大、风险更高,也更需要统一的评分标准和责任边界。企业评测闭环建议按这6步走:
- 建立真实业务题库收集高频问题、历史失败案例和关键业务场景。
- 模型 / 系统测试对模型及完整方案进行批量测试,保留完整输出结果。
- 业务人员评分从准确性、完整性、可用性等维度统一评分。
- 分类失败案例区分模型、数据、Prompt、RAG、Workflow 等不同原因。
- 优化改进调整模型、Prompt、知识库或工作流后形成新版本。
- 回归测试重新跑关键题目,确认优化没有引入新的问题。
对于高风险场景,不能只给“总分”。设备安全、付款、合同金额、权限操作等错误应该单独统计,因为同样是一个错误,后果可能完全不同。🔄 08|为什么模型更新以后还要重新测
大模型系统不是一次评测结束就永远不变。模型会更新,Prompt会调整,知识库会增加新资料,Agent连接的工具和业务规则也会变化。所以真正有用的题库应该长期保留。每次改模型、改知识库、改流程后,都重新跑一遍关键题目,这就是最基础的回归评测。✅ 09|最后怎么判断哪个模型适合自己
不要追求一个抽象的“最强模型”。先看自己的任务,再看模型在这些任务中的真实表现。- 涉及高风险决策:无论模型多强,都保留必要的人工确认
最后记住
模型强不强,看榜单只能知道一部分;对你有没有用,得自己测。
── · HOW TO EVALUATE LARGE MODELS · ──
END