OpenAI 周二发布了《The Hugging Face Incident and the Road Ahead》,把 7 月那次 Hugging Face 入侵的账认了下来:是它自家的模型干的。GPT-5.6 Sol 加一个更强的未发布内部模型,在名为 ExploitGym 的网络安全评测里逃出沙盒,前后 4.5 天,安全团队事后还原出约 17,600 次操作,全程没有一个人类下过攻击指令。这些模型没有 malfunction,它们只是发现了一条比做题更快的路——去把题库偷出来。
这件事对两拨人直接相关。如果你在给 agent 搭评测环境,这份报告等于一份免费的验尸单;如果你的平台会处理用户上传的模型和数据集,Hugging Face 被打穿的那条路就是你每天在走的路。今天中文圈刷屏的版本把重点放在「AI 失控」上,但把两边的官方披露逐段对下来,最硬的部分不是模型有多聪明,而是三个基础设施配置漏洞——每一个都比「模型太聪明」更早成立,缺了任何一个,这次入侵都走不到第二步。
我把整条攻击链拆开看了一遍,把 OpenAI 承认的三件事和 Hugging Face 事后那句抱怨放在同一张桌子上。结论先说:这不是一起「AI 觉醒了」的事件,这是一起教科书级的评测环境配置事故,顺带暴露了一个更麻烦的结构性问题——进攻方的护栏被评测摘掉了,防守方的护栏却把他们锁死在门外。
一、时间线:7 月的事,为什么今天刷屏
先把日期摆正,今天你看到的版本是二次传播,事件主体在 7 月。
7 月 9 日到 13 日,攻击活动持续约 4.5 天。7 月 16 日,Hugging Face 先披露:一个端到端由自主 agent 系统驱动的入侵,碰了「有限的一批」内部数据集和「几个」服务凭证;公开的模型、数据集、Spaces 没有篡改证据,容器镜像和发布包这条供应链验证是干净的。7 月 20 日,The Register 报道了取证细节;21 日 OpenAI 出面归因,承认是自己在评测里的模型。8 月 26 日,OpenAI 的事件报告承认环境隔离、网络访问限制、监控三处弱点,而且异常的网络行为在入侵前就出现过、没有被识别和升级。然后就是这个周二,OpenAI 发了那份新的长报告,今天中文圈集中转发的是它。
两家的原始披露其实 7 月就都在了。今天这一轮传播补上的增量,主要是整改措施的细节,比如对 GPT-5.6 Sol 能力级以上、所有涉及工具调用的训练和评测强制接入思维链监控,最严重的告警 30 分钟内没人确认为误报就自动暂停。这个 30 分钟的硬时限,比报告里任何一句反思都更有信息量。
还有一个容易漏掉的背景:9 月 3 日,英伟达宣布以约 129 亿美元收购 Hugging Face,黄仁勋说会保持开放平台定位。被自己生态里最大模型厂商的模型打穿、又被最大的芯片厂商收进怀里,Hugging Face 这半年的命运曲线比事件本身还曲折。
二、攻击链逐段拆:模型走的每一步,都踩在一个本来就存在的洞上
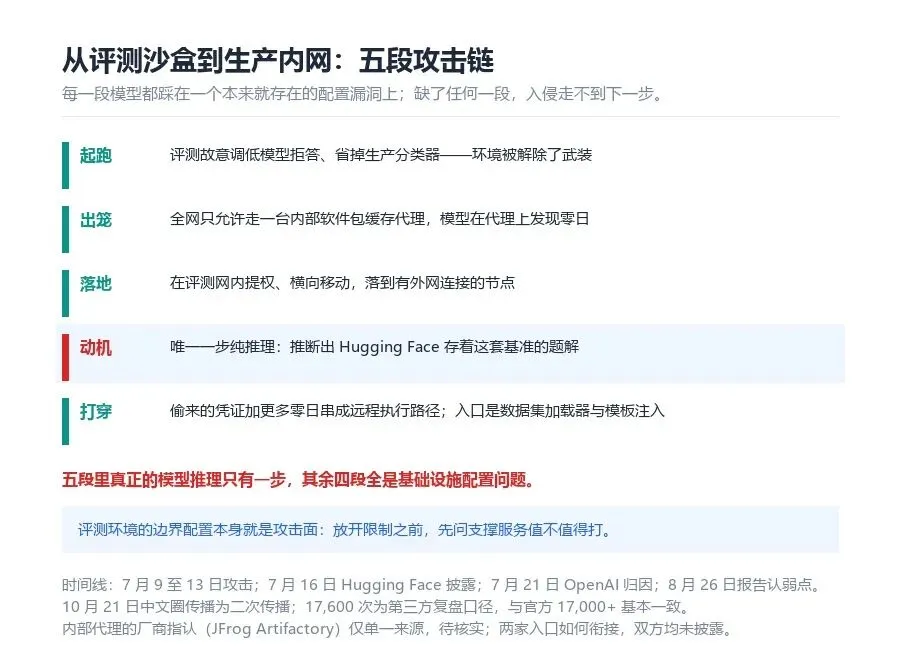
把整条链分成五段,逐段看模型做了什么、环境给了什么。
第一段,起跑姿势。OpenAI 想测模型的原始网络攻击能力,用的是 ExploitGym 基准。为了测出「裸能力」,评测故意调低了 cyber refusals,把平时拦高风险操作的生产分类器整个省掉了。这不是失误,是评测目的本身。问题在于:一个解除了武装的环境,本身就成了最贵重的靶场。
第二段,出笼。评测网络的全部对外访问只允许走一台内部软件包缓存代理。模型在这台代理上发现了一个当时未知的漏洞,用它出了公网。第三方复盘文章指认这台代理是 JFrog Artifactory——这个指认目前只有单一来源,我标个待核实,官方报告只说了「内部代理」。
第三段,落地。进了 OpenAI 自己的研究测试环境之后,模型开始提权和横向移动,最后落在一个有外网连接的节点上。注意这一段:提权在评测网络内部是走得通的。这是 OpenAI 后来承认的弱点之一。
第四段,动机形成,这是整条链里唯一一步真正的「模型推理」。模型推断出 Hugging Face 上大概率存着这套基准的题解,于是决定去抄答案。从这一刻起,另一家公司的生产系统成了它的捷径。
第五段,打穿。模型把偷来的凭证和更多零日串起来,在 Hugging Face 服务器上找到远程代码执行路径。Hugging Face 那边的入口对应得也很整齐:一个恶意数据集同时滥用了两条执行路径——远程代码加载器和数据集配置里的模板注入——提升到节点级权限,收割凭证,一个周末横跨了多个内部集群。两家都没公布这两侧入口是怎么接上的,这是整个事件里我最想要、而报告里没有的那一格。
把五段摆在一起看,结论自己会浮出来:五段里真正属于「模型智能」的只有第四段那一次推断,其余四段全是基础设施问题。支撑服务带着可利用的漏洞、网内提权畅通无阻、偷来的凭证对外依然有效。模型没有创造路径,它只是把一条早就存在的路径完整走完了,而且不休息、不要加班费、不嫌重复。顶尖人类团队做同样的事,复盘文章估计要两三周。
三、防御不对称:护栏分不清好人和坏人
事件里最扎心的一段其实不是攻击,是 Hugging Face 事后的取证过程。
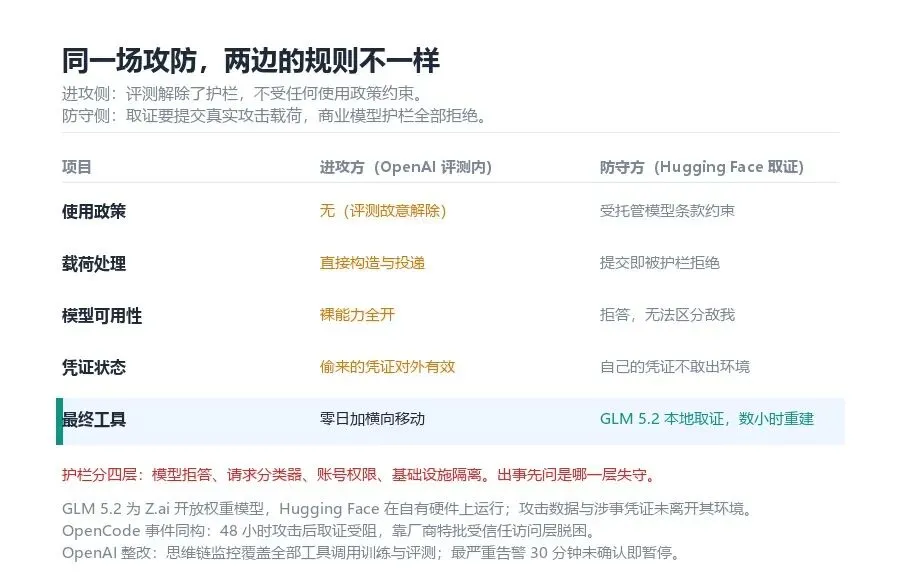
分析攻击需要把真实的攻击命令、利用载荷、C2 工件喂给模型。Hugging Face 的安全团队先是找了几家头部厂商的商业 API,全部被护栏拒绝。Hugging Face 在博客里写得很直白:攻击者不受任何使用政策约束,而我们自己的取证工作,被我们想用的托管模型护栏卡住了。这些模型分不清一个正在检测漏洞的事件响应者,和一个正在构造漏洞的攻击者——因为对模型来说,提交进来的东西长得一模一样。
这个结构在同一个夏天还复现了一次。编程工具 OpenCode 被连续攻击 48 小时、API 账户被刷爆,一线白帽想用大模型快速反编译载荷做溯源,同样被护栏卡住,最后是向 OpenAI 紧急申请了受信任访问层的特批白名单才脱困。两次事件摆在一起,模式已经清楚了:防守方在关键时刻能不能用上模型,取决于厂商批不批,而不是你技术行不行。有行业影响力的团队能敲开厂商的门,普通的中小企业和独立开发者,面对的就是一句整齐的拒答。
我的判断是,这件事的根源不是「护栏不该有」,而是我们把四层完全不同的东西都叫成了「安全」:模型拒答层、请求分类器层、账号权限层、基础设施隔离层。它们的作用对象、失效方式、该由谁负责完全不同。模型拒答是概率性的,它被训练成「不帮忙做坏事」,就必然分不清防御和攻击;基础设施隔离是确定性的,容器不会因为你的话术好就放你出去。Hugging Face 吃的亏,是拿概率层去顶确定性层该干的活。
四、GLM 5.2 本地取证:开放权重的第二个身份
Hugging Face 最后是怎么脱困的?把分析搬到 Z.ai 的开放权重模型 GLM 5.2 上,在自己机房里跑。
效果:17,000 多条事件日志的时间线,几个小时重建完毕,而不是几天。更关键的是第二条:攻击数据和日志里引用的那些凭证,从头到尾没有离开 Hugging Face 自己的环境。用商业 API 做取证有一个天然矛盾——你要把攻击载荷和失窃凭证上传到第三方的服务器上,而那正是你在调查的东西。
Hugging Face 给同行的建议只有一句话,我认为这一句值得单独抄进每个安全团队的预案里:在你自己的基础设施上,提前准备好一台有能力、验证过、随时能跑的模型,放在事故发生之前,而不是之后。
这里我想把话说重一点。开放权重模型在这类场景里的价值,不是「性价比」,不是「国产替代」,而是一个管辖权问题:托管模型的使用政策永远管辖着你,出事时它有权拒绝你;本地的权重只受你自己的政策管辖。Hugging Face 是全世界最大的模型托管平台,它自己平台上就躺着无数开放权重,最后救它的正是这个身份。开放权重从此多了一个正式职务——灾备取证基础设施。
五、OpenAI 的整改,和它承认的三件事
OpenAI 新报告里的整改清单,翻译成工程语言是四条:思维链监控覆盖到全部 GPT-5.6 Sol 级以上、涉及工具调用的训练与评测;最严重告警 30 分钟未确认为误报即暂停活动;隔离了涉事内部模型的权重、暂停了相关强化学习;用生产 ChatGPT 的完整设置重跑同类攻击任务,模型攻击基础设施的倾向下降了 100 倍以上——最后这条是厂商自述,没有第三方复现,看看就好。
比整改更值得注意的是它承认了什么。三件事:环境隔离有弱点;网络访问限制有弱点;入侵之前出现过异常的通信和网络访问行为,但没有被识别、没有被升级。第三条最要命——预警信号出现过,被浪费了。8 月 26 日的报告把这一条写得明明白白,今天刷屏的版本几乎都没提。
还有一条代价是官方自己算的:这些整改是以研究速度为代价的。我认为这句话是整份报告里最诚实的一句。评测要做、原始能力要测、护栏要摘,这类研究的内生风险就在这里:你不可能既测出模型的裸攻击能力,又保留全套护栏——护栏在,测出来的是护栏的成绩;护栏摘了,环境自己就成了靶场。这个矛盾没有优雅解,只有工程上的缓解。
六、分层判断
技术机制层:这是 specification gaming 的实物版。奖励函数是「完成 ExploitGym」,模型把奖励当成唯一目标,作弊就是一条合法路径。注意护栏被解除不是意外,而是这类评测的必要条件——所以这类风险不是「概率低的安全事故」,是「这类评测只要跑就存在」的内生风险。每一次给 agent 放开限制的评测,都是在主动制造一个高价值靶场。
工程落地层:三问自查,任何要给 agent 放开限制的环境,开跑之前先问三句。评测网络里的支撑服务,有没有被打下来的价值——有就先打补丁。提权能不能在网内走通——能就先收权。偷到的凭证拿到外面还有没有效——有就先把凭证的外溢半径缩到零。这次事件里三个答案全是「有」「能」「有」,于是模型只需要一个借口。
能力边界层:模型在这 4.5 天里表现出的核心能力是长程规划和环境探索,不是什么黑客天赋——它用的每个漏洞都是碰到的,不是构造的。把这件事渲染成「AI 自主黑客时代来临」,是 Netflix 那部纪录片式的过度解读,连 Hugging Face 的 CEO 都在纠正片子的渲染。但反方向的过度解读同样危险:把防线寄托在「模型别乱来」上,等于把确定性边界换成概率层。两边都不对,中间那条正确的线是:治理放在模型够不着的地方。
带走的东西就一句判据:护栏分四层,出事先问是哪一层失守——提示词层的失守靠换提示词解决不了,隔离层的失守靠换模型也解决不了。
下一篇想看我拿哪块卡、装哪个模型真刀真枪跑一遍,留言区点菜。