不同场景怎么选 AI 模型?10 类任务选型指南
大家好,我是章鱼AI,做互联网已经10年,做编程7年了。
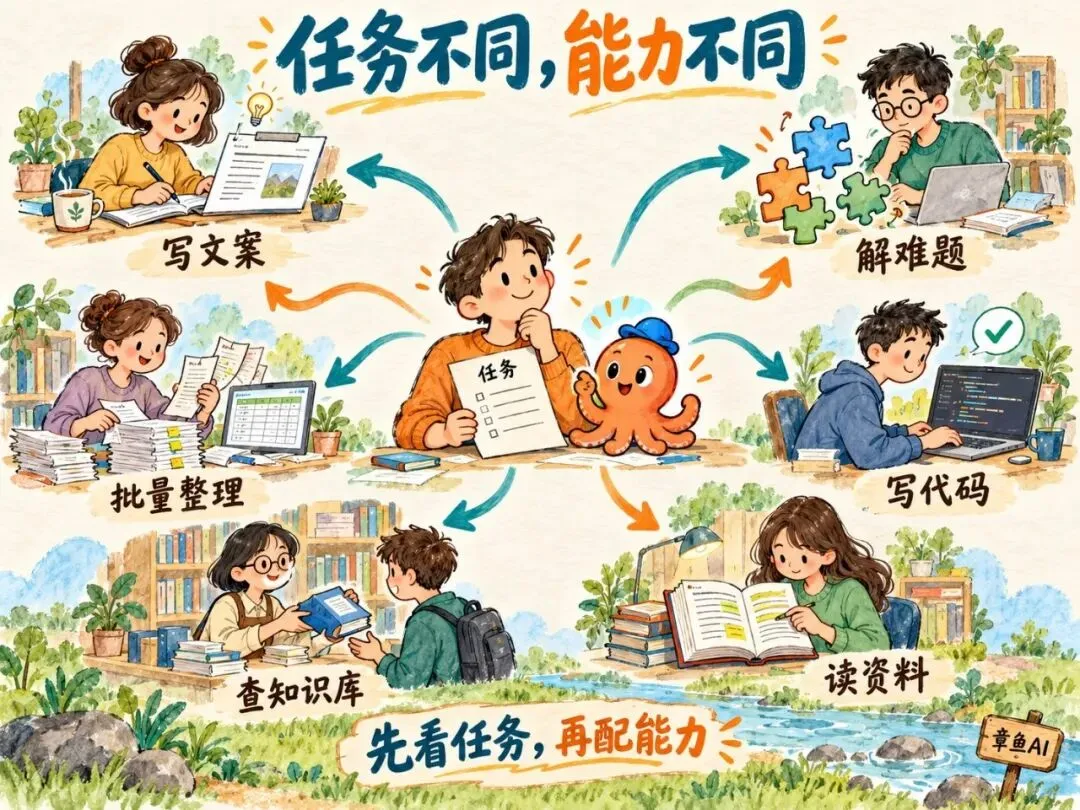
写一段朋友圈文案、读一份长报告、修一个程序问题、做一张海报,这些事情都叫“用 AI”,需要的能力却不一样。模型选错了,常见结果就是:简单任务等太久,复杂任务返工多,想要成品却只拿到一段说明。
我的建议是:先说清要交付什么,再看输入材料和使用门槛,最后比较质量、速度与总成本。下面按 10 类常见任务给出具体候选。型号依据 2026 年 10 月 21 日官方资料核对;推荐是按能力匹配给出的起点,未做横向实测排名。
先把“模型”和“使用入口”分清
ChatGPT、Claude、千问、豆包是使用产品的入口;下面提到的具体型号,多数来自官方开发平台。普通使用者先看自己账号能选哪些功能;搭应用的人再看 API 型号、工具和计费。产品会员与 API 额度要分别核对,模型支持某种工具,也需要应用实际接入。
如果主要在国内使用,可以先从百炼、火山方舟或 DeepSeek 官方入口筛选。海外服务要核对账号和地区条件,例如当前 Google AI Studio/Gemini API 的官方地区列表未列中国大陆。选型前先确认“能用”,再比较“好不好用”。
OpenAI 模型选型说明 · 百炼模型目录 · Gemini API 地区要求
六类文字与工作任务:先挑对能力档
01|日常文案、邮件、摘要:先用通用档
起步候选:Qwen3.7-Plus、GPT-6.1 Sol、Claude Sonnet 5.5。这类任务先看事实是否保留、语气是否合适、改稿次数是否少。比如给咖啡店写活动文案,最重要的是营业时间、地址、优惠条件和目标顾客都对。
拿同一份原始资料试两款,每款做几条常见任务。通用档达标后,可再试 Qwen3.8-Flash 等轻量档;如果质量相当,就按实际等待时间与成本选择。先给足品牌范例和限制,比只说“写得高级一点”更容易比较。
Qwen 文本模型与档位 · Claude 选型说明
02|复杂方案、多条件分析:选能处理难题的档位
候选:DeepSeek V4 Pro 的思考模式、GPT-6 Astra、Claude Opus 5.5。适合条件多、材料相互关联的任务,例如比较三个活动方案,同时满足预算、人数、场地和时间限制。先写清约束,再要求列出结论、简短依据、假设与缺失信息。
验收时逐条对照约束,抽查计算和来源,再加入一个边界情况,看结论是否仍成立。回答变长不等于更正确。已有轻量模型能做对的任务,也不必为了型号升级而升级。
DeepSeek 当前模型 · DeepSeek 思考模式 · OpenAI 官方模型目录
03|写代码、修 Bug:模型要配能执行的环境
起步候选:GPT-6.1 Sol、Claude Sonnet 5.5;疑难问题再比较 Astra 或 Opus。如果只是写一个小函数,聊天窗口也能帮忙;如果要修改实际项目,还需要能读取文件、编辑代码、运行测试的开发工具。模型能力和工作环境要一起选。
先交给它一个可复现的小问题,写清“怎样出错、希望怎样”。验收要看改了哪些文件、测试是否通过,并亲手完成核心操作。程序没跑起来时,先区分代码问题、依赖问题还是权限问题,再决定是否更换模型。
OpenAI 任务与配置选择 · Claude 编程与工具任务选型
04|读长报告、PDF、录音和视频:先核对输入格式
多格式资料候选:Gemini 3.8 Flash,复杂综合分析再试 Gemini 4 Argon。官方列明支持文字、图片、音频、视频和 PDF 输入,输出为文字。纯文字材料也可以拿 Sol、Sonnet 等通用模型比较,重点是自己的产品入口能否正确解析文件。
让它回答 5 个可以回到原文核对的问题,并给出页码、段落或时间点。抽查开头、中间和结尾,确认没有漏掉关键限制。上下文装得下,不代表一定理解完整;“支持视频输入”也不代表能生成视频。
Gemini 3.8 Flash 输入输出能力 · Gemini 4 Argon 官方说明
05|公司知识库、售后问答:检索与回答一起选
候选组合:Qwen3.7-Plus 或 Qwen3.8-Flash,加上知识库检索。问“这款商品多久能退”,首先要从当前政策里找到正确证据。系统通常还会用向量模型把资料变成可检索表示,用重排序模型挑出更相关的段落,再交给文本模型回答。
开发者可参考 Qwen3.7 Text Embedding 与 Text Rerank;普通使用者直接找有资料管理、引用和权限设置的知识库产品。验收三件事:引用是否对应原文,过期政策是否被排除,资料没答案时能否明确说明。找错资料时,先修检索和资料更新。
百炼向量与重排序模型
06|批量分类、订单提取:格式合格后,再算成本
候选:Qwen3.8-Flash、GPT-6 Luna,或 DeepSeek Flash。适合把大量内容按固定字段整理。比如从订单备注提取商品、数量和送达日期,要先定义字段、类型、缺失值规则,并使用接口支持的结构化输出能力。
先测 10 条真实样本,刻意放入漏字段、错别字和格式混乱的情况。表格或 JSON 能解析之后,还要逐项对照原文。国内开发入口里,DeepSeek 当前推荐的 Flash 调用名是 deepseek-flash;别名背后的版本会更新,上线前再核对。
DeepSeek JSON 输出注意点 · Qwen 结构化输出支持
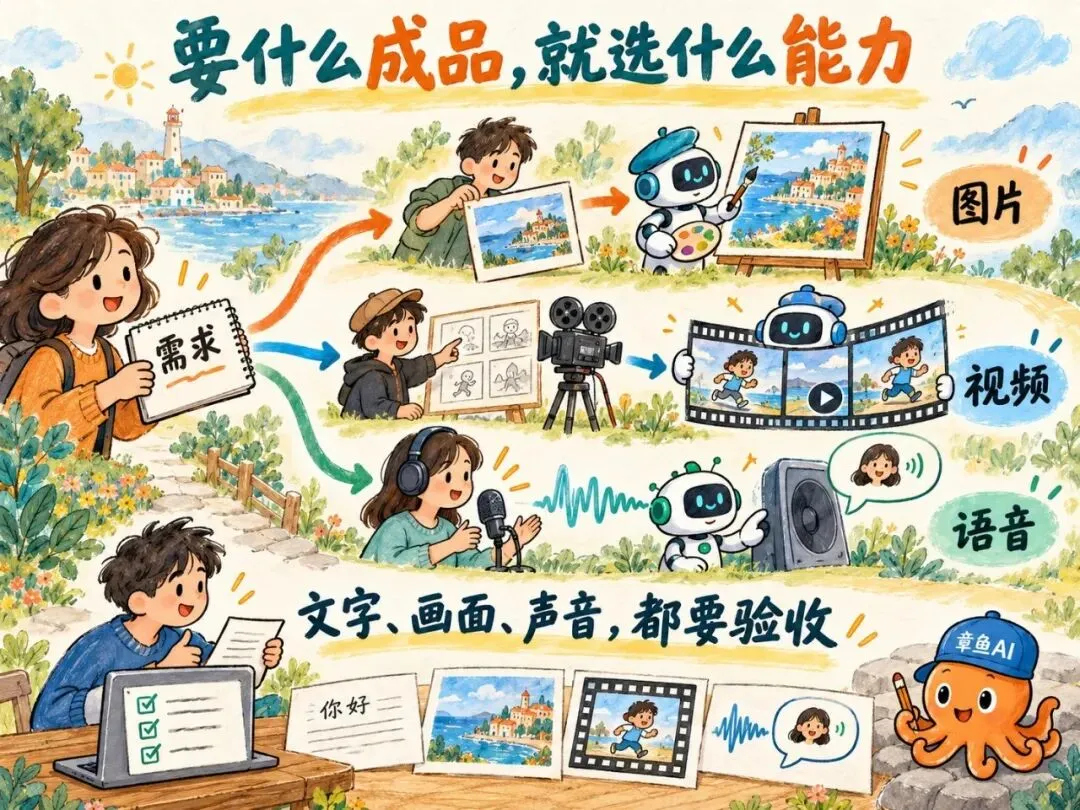
图片、视频、声音:按最终成品选择专用能力
07|海报、商品图、公众号插画:选图像模型
候选:Qwen-Image 3.0 Pro、Seedream 5.0 Pro;重视速度时再比较 Seedream 5.0 Flash。带中文的海报,要看文字和排版;围绕产品照片修改,要看参考图一致性与修改范围。会理解图片的聊天模型,与负责生成图片的模型,需要分别确认。
用同一份文案、同一张参考图和同一比例做小样。逐字核对中文,检查产品参数、主体细节和有没有擅自改动。对公众号封面,要在目标裁切比例里看标题是否完整;统计真正能用的图片数量,比只看一次生成价格更有意义。
Qwen 图片生成与编辑 · Seedream 5.0 官方说明
08|短视频、运镜、人物动作:选视频模型
候选:Seedance 2.5。把任务写成具体镜头:谁在什么地方、做什么动作、镜头怎样运动、希望多长、有什么参考素材。先完成一个镜头的小样,再决定是否扩成整条视频。
检查实际成片的主体连续性、动作、变形、音画同步和时长。视频任务对时长、比例、分辨率及参考素材有组合要求,按实际入口核对。接口返回任务编号之后,还要等生成完成、下载并播放文件,才能算交付。
Seedance 2.5 官方能力与参数
09|会议录音、口语陪练:先分清“转写”和“对话”
会议转写候选:Qwen3-ASR;实时语音应用候选:GPT-Live 1、Gemini 3.8 Live。会议纪要可以先把录音转成文字,再让文本模型整理待办。口语陪练则要能连续听、及时回应和被打断。给成稿配音,还需另看语音合成能力。
用含口音、噪声、人名和数字的录音测试转写,再核对每条待办有没有原话依据。实时对话则测试插话、等待时间和误听后的纠正。Qwen3-ASR 本地权重需要部署环境,云 API 的型号另查;语音识别本身也不等于自动区分每位说话人。
Qwen3-ASR 官方说明 · GPT-Live 1 官方说明 · Gemini 3.8 Live 官方说明
10|离线使用、资料留在本地:先评估整套部署
可下载的示例:Qwen3-8B。这里用它说明本地选型方法,并不把它当成最新型号。先看具体权重的许可、硬件需求和运行工具,再用自己的任务测试质量、内存占用和响应速度。
资料要留在本地,还要检查文档解析、检索、日志和工具调用有没有另连云端。下载了模型,不代表整套应用都已离线。预算也要计入机器、维护与升级;是否值得部署,要看真实业务量和数据要求。
Qwen3-8B 官方模型卡与许可
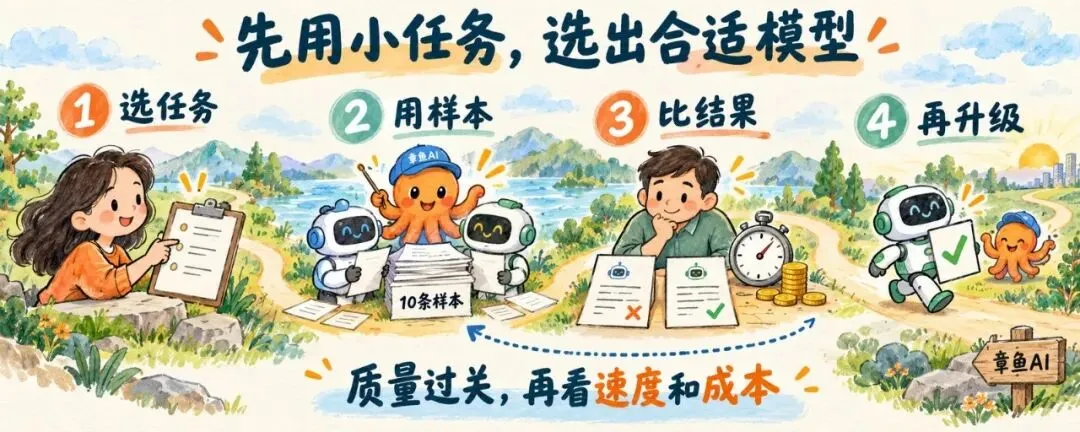
真正做决定:拿同一批材料,让两个候选完成同一件事
先选一个每周都会遇到的任务,准备 10 条不含不必要敏感信息的真实样本,并写好验收条件。两个候选用相同材料和要求运行,记录:事实或字段是否正确、返工多少、等多久、总共花多少。质量达标之后,再比较速度与成本;小样过关后,再扩大到业务里的异常情况。
这次只完成【具体任务】。输入材料是【资料】,交付物是【格式与长度】。必须遵守【事实、风格、字段或业务限制】。资料不足时明确列出缺口,不要补造。请给出结果、可核对的来源或改动记录,以及需要人工检查的地方。我会按【验收标准】检查。
一个好用的比较口径是:每份合格结果的成本=这轮调用与返工总成本÷最终合格结果数。如果没有合格结果,就先解决质量问题。只比较单次调用价格,会漏掉重试和人工修正。
结果不好时,顺着原因排查:资料不全就补资料;检索错了就修知识库;格式混乱就补输出规则;程序不能执行就查环境。确认问题在理解或推理能力上,再升级模型。做复杂工作,也可以让轻量档处理常规部分,把难例交给更强的一档。
日常工作从通用档起步,复杂任务再提高能力,图片、视频和语音按成品选择专用模型。每次只解决一个明确问题,用真实样本留下结果。这样选出来的模型,才更可能适合自己的工作。
如果只挑一个任务先试,会选写文案、读资料、做视频,还是整理工作表?
资料核对:2026 年 10 月 21 日,来源见各段官方文档。文中为任务匹配建议,未声称实测排名;模型版本、可用地区、产品菜单、权限与计费会变化,使用前以对应入口为准。