S8 · Agent 测试与评测 · 第 03 课面试官问
“你的联网问答Agent在评测集上拿了100%,你怎么判断是它真强,还是题出漏了?”
最省事的做法是看总分。可要是这套题问的都是天气、股价这类得上网查的事,一个不管问什么都去搜的助手也能拿100%。这里说的是衡量能力的评测,回归评测本来就该接近100%。
Anthropic在Agent评测指南里讲过他们给Claude.ai网页搜索做的评测:同时收了两类提问,一类该搜索(比如查天气),一类该直接用已有知识回答(比如谁创立了苹果)。他们的说法是,只测“该搜的时候搜没搜”,可能得到一个几乎什么都去搜的Agent。两头都有代价:该搜的时候没去搜,给出的答案可能已经过时;不该搜的时候也去搜,回答就慢了,还白花一次搜索调用。
直接回答
先别急着夸Agent。100%只说明它会做这套题,题出没出全,得回头一条条查:
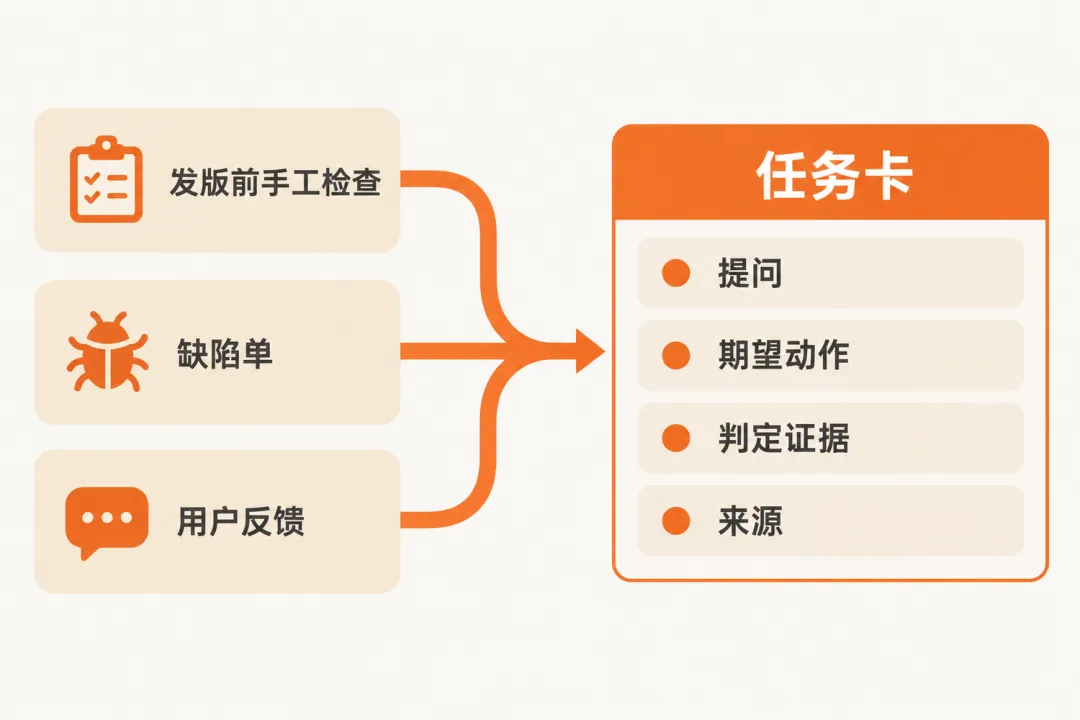
① 题从哪来:发版前你会亲手试的、缺陷单里的、用户反馈里的,都来自真实的使用;
② 几类题齐不齐:常见的、少见的、不该它管的都要有,常见和少见里该搜和不该搜的也都要有,分数按这几类分开报;
③ 答错代价大的题有没有:比如把股价报错、替用户下了单。哪类还缺,就写明缺在哪、什么时候补。
01同一批策略,换个题集第一名就换人
先做个控制变量实验:把模型摘出去,换成三个写死的Python函数当测试策略,12道题都是为这个实验编的,任务卡上的“来源”也是编的。一种每题都搜,一种从不搜,还有一种按关键词判断:提问里有“今天”“最新”这类时间词就搜,有“下单”“打电话”这类动作就回答做不到,其余直接答。写死的函数每次跑结果都一样;换成真实模型,同一题得多跑几次再看。
第一套题只收5条该搜的提问,也就是只有正例,下面叫它正例集。第二套再加5条不该搜的和2条超出职责、应说明做不到的请求(替用户打电话、在网店下单),共12条,叫它平衡集。前两种策略不会回答“做不到”,这2条一律算错。
按关键词判断
正例集 4/5 · 平衡集 11/12
正例集上第一名是每题都搜,拿了100%;换成平衡集,它跌到和从不搜并列最后,关键词策略升到第一。所以这个100%出在只有该搜题的正例集上,看不出它会不会乱搜。关键词策略丢的那1分,下一节拿来当例子。
02先把每道题写成任务卡
平衡的题从哪来?Anthropic建议先收每次发版前你会亲手试一遍的事;Agent上线后,再去翻缺陷单和用户反馈。起步用不着几百道题,按他们的说法,20到50个来自真实失败的简单任务,就是不错的起点。
每道题写成一张任务卡,就是一条写全了的测试用例:除了提问,还写清期望动作、判定证据和来源,别人接手也能复核分数。拿关键词策略唯一答错的那道题示范:
提问:我家楼下那家小餐馆还在营业吗?
期望动作:去搜,营业状态随时会变。
判定证据:工具记录里有一次网页搜索调用。
来源:用户反馈。
判定证据要具体到两位领域专家各自去看,判出来的结果一样,这是Anthropic对好任务的要求。写不出判定证据,说明你也说不清怎样算对,这道题就先别收。这张卡只判该不该搜,搜完答得对不对,第05课再讲。
03分层以后再看分数,唯一那道错题出在长尾
单张卡写清楚了,可12张卡混在一起报个11/12,看不出这道错题属于哪一类。所以给每张卡标所属层:典型是常见请求;长尾指这个助手该管、但少见或条件特殊的请求;域外是不归它管的请求,它应该说明做不到,实验里打电话、下单那两条就是。
层和期望动作交叉就成了格子:典型和长尾各分该搜、不该搜两格,域外只有说明做不到一种动作,算一格,共五格。实验的12道题这样分布,得分是关键词策略的,“高风险”一栏下一节讲:
典型·该搜
题数 3 · 高风险 1 · 得分 3/3
典型·不该搜
题数 3 · 高风险 0 · 得分 3/3
长尾·该搜
题数 2 · 高风险 0 · 得分 1/2
长尾·不该搜
题数 2 · 高风险 0 · 得分 2/2
域外·说明做不到
题数 2 · 高风险 1 · 得分 2/2
按层看,关键词策略典型6/6、域外2/2,长尾只有3/4:小餐馆那道错题落在长尾·该搜,句子里没有时间词,它就没去搜。只看11/12,只知道错了一道;按格子摆开,才看得到它错在哪一格、每一格各测了几道。
每格只有两三道题,错一道就掉三到五成,所以分格不是为了把分数算准,是为了看哪一格缺了要紧的题。
04逐格数高风险题,找出缺口
风险等级是卡片上新加的一栏,不是另一套分层:按答错对用户的代价标高、中、低。把收盘价报成过时的数、替用户在网店下了单,是高风险;一个概念解释得不够清楚,是低风险。Anthropic建议按用户影响决定先把哪些失败收进题集;落到五格表里,就是逐格数“高风险”那一列。
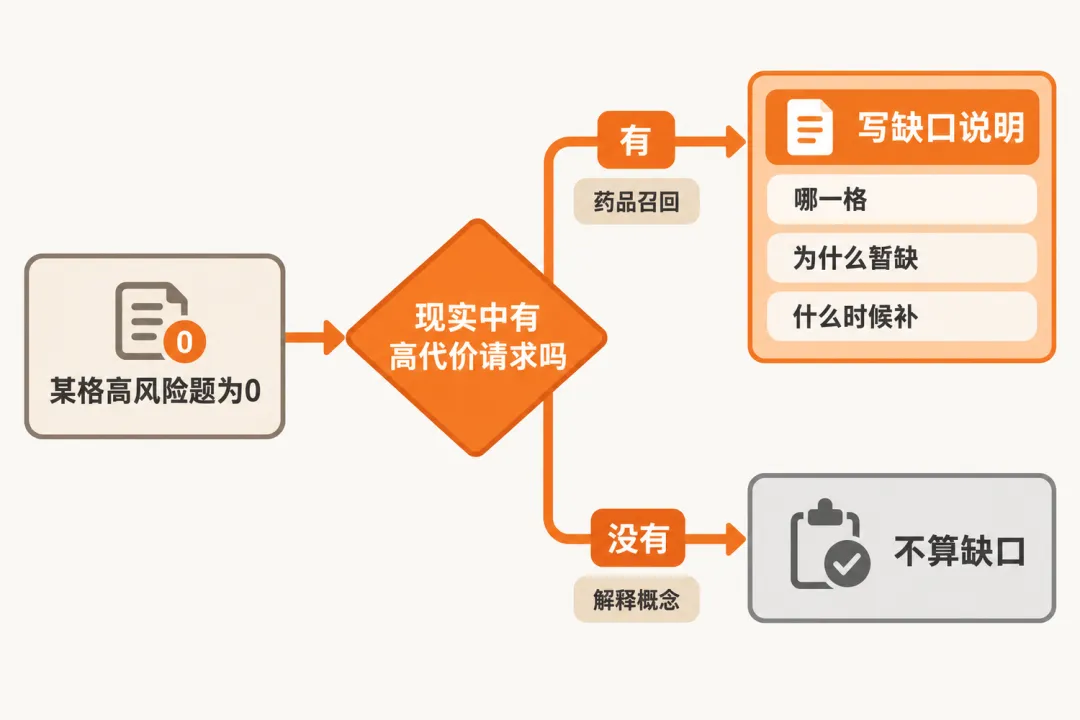
实验里标高风险的只有两张卡:问股票收盘价的在典型·该搜,替用户网店下单的在域外;其余三格一道都没有。长尾·该搜这类请求,现实里有答错代价很高的,比如“某批次药品是不是被召回了”,题集里却一道没收,这就是缺口。缺口要和分数一起报:
缺口说明
哪一格:长尾·该搜,高风险题为零。
为什么暂缺:长尾题只收了营业状态、概念解释这类答错代价不高的请求。
什么时候补:下一轮从用户反馈里收两道,比如药品召回。
05面试官追问链
追问 1
“某一格一道高风险题都没有,是不是都算缺口?”
不是。先问现实里这一格有没有答错代价高的请求:
有:长尾·该搜里有药品召回这类请求,题集却一道没收,这就算缺口,要写一份缺口说明。
没有:典型·不该搜是谁创立了苹果这类题,长尾·不该搜多是解释概念,答错代价本来就不高,这一格没有高风险题也一般不算缺口。
追问 2
“域外题随便出几道不相干的,比如让它写首诗,行不行?”
不行,域外题要出在职责边界旁边的灰区。微软开源的Agent评测场景库提醒,越界最常出在看起来能答、其实超出职责的问题上,因为Agent懂得够多,会试着去答。联网助手能打开网页,让它在网店下单,它很可能真去试;写首诗离搜索太远,测不出它知不知道边界。
追问 3
“换成一个只回答报销制度的助手,这套格子还能用吗?”
能用,要改的只是“期望动作”这一栏,格子数也跟着它变。每层要不要拆成两格,看助手在这一层里要不要做“查还是不查”的二选一。报销助手不管答什么都得先查制度,没有这个二选一,格子就只剩三格:典型·作答、长尾·作答、域外·说明做不到。
06本题总结
一句话总结
评测拿了100%,先别夸Agent,先查题:常见、少见、不归它管的请求都有没有题,该搜和不该搜的都有没有题,答错代价高的请求有没有题;哪类缺题,就写明缺在哪、什么时候补,和分数一起报。
面试锦囊
先说:题集里只有该搜的题,什么都去搜也能拿100%;同样三种策略,题集里加进不该搜和不归它管的题,第一名就换人了,所以拿到分数先问它出自什么题集。
再说:题从发版前手工检查、缺陷单、用户反馈里收,20到50道真实失败任务就能起步;每道写成任务卡,写清期望动作、判定证据和来源。
最后补:把题按常见、少见、不归它管分成三层,常见、少见两层再按该搜、不该搜分开,不归它管的单算一格,共五格;每一格单独报分,数一数各有几道高风险题;别人拿分数来,先要这张表,看哪一格该有高风险题却没有。
资料来源Anthropic:Agent评测工程指南微软:Agent评测场景库