Skill如何用于Agent的训练与评测?
- 更新时间 2026-10-20 08:23:17
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
摘要
Skill中沉淀的工作方法和配套资源,已经能够复用于构建Agent训练与评测所需的任务、运行环境和验收标准,小红书AllSpark、NVIDIA等团队的近期工作进一步验证了这条路径。通过让Agent实际执行这些任务,既可获得操作示范和训练反馈,也能依据交付要求、必要步骤及前后依赖,检验Agent能否完整完成工作。
关键发现
Skill已能作为Agent训练与评测任务的构建依据,将工作方法、配套资源和质量要求共同用于任务设计、环境准备与结果验收; Skill中的工作要求可以转为具体检查标准,使评测能够识别最终产物之外的必要步骤遗漏; 将多个Skill对应的工作连接起来,可以检验Agent能否持续使用有效的中间结果,暴露单项操作测试难以发现的交付问题。
01
Skill正在成为训练与评测任务的来源
Skill中沉淀的工作方法,已可复用于Agent训练与评测:依据操作步骤设计任务,准备执行所需的文件和工具,再把交付要求转为检查标准。近期小红书AllSpark和NVIDIA的工作,分别通过批量任务构建、训练实验和开源工具,补充了这条路线的实现与效果证据。
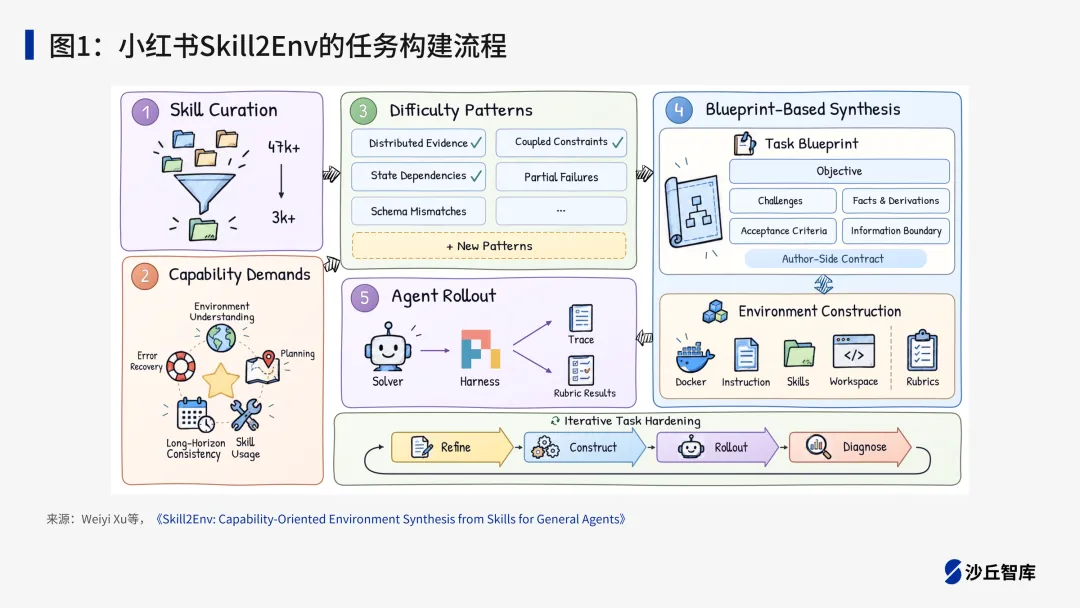
小红书AllSpark团队Weiyi Xu等人于2026年9月27日公开Skill2Env论文,构建了2,963项可执行任务,并利用其中的高评分执行记录训练模型。该方案还会依据Agent的实际表现调整任务难度,同步更新材料和评分规则。[1]
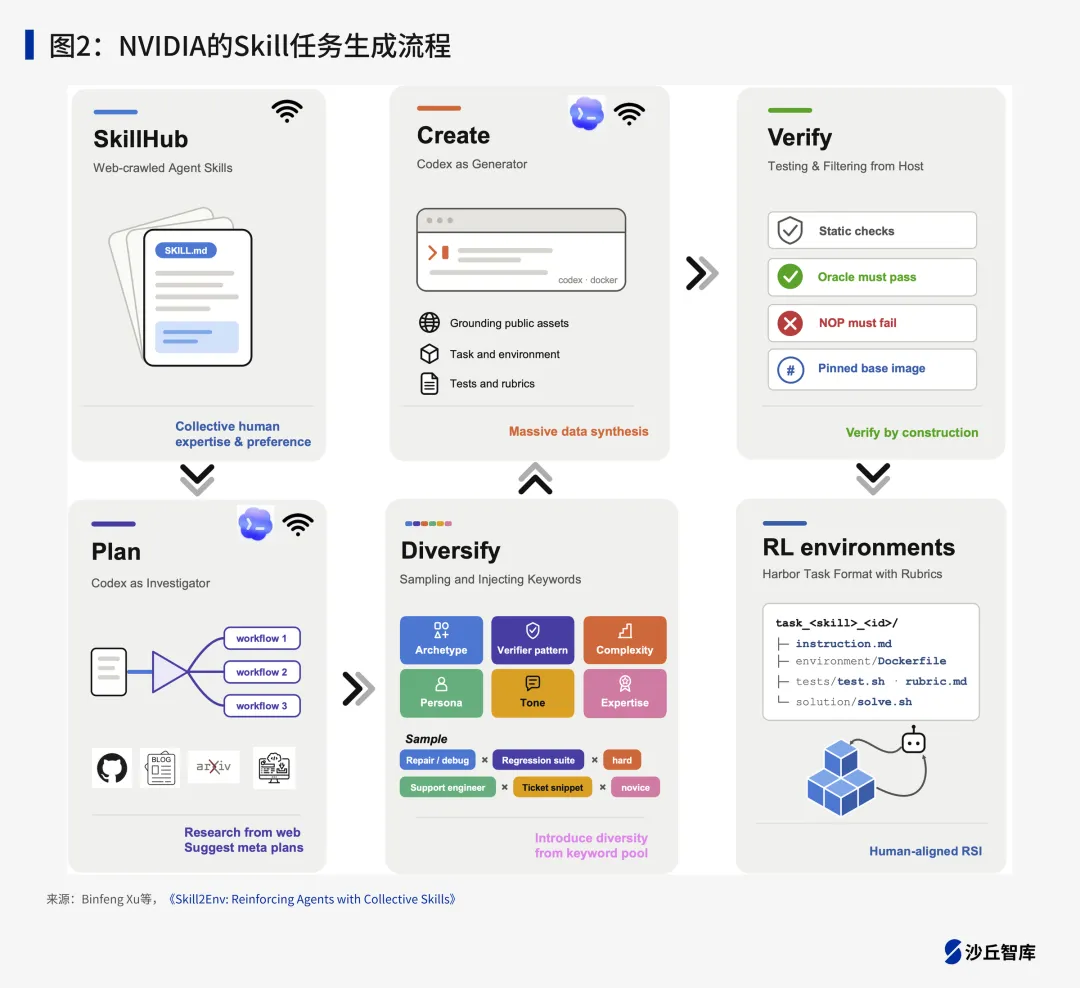
NVIDIA的Binfeng Xu等人于9月23日提交了另一项同名工作Skill2Env的报告,并公开任务生成工具和数据。该工具调用Codex读取Skill、规划任务、准备文件和运行环境,再编写检查程序与参考解法,使同一份Skill能够用于构建多项可验证的任务。[2]
这条路线已有技术积累。2026年5月,北京航空航天大学Zihao Cheng等人的Terminal-World已依据Skill构建任务、运行环境和执行示范,并用于模型训练。[3] 近期不同团队的工作继续验证了训练用途,并补充了可复用工具、任务难度调整及更细致的验收方法。
02
训练与测试任务如何生成
为工作方法配齐具体材料
小红书AllSpark团队发布的Skill2Env,使用Kimi-K3读取Skill、设计任务并准备运行环境。以Docling文档处理Skill为例,该方案生成了一项供应商对账任务:为Agent准备合同、发票和付款记录,要求核对某一季度的账目,交付明细、汇总和核查说明。材料中包含下一年度才生效的调价通知,Agent需要判断当前账期应采用哪项费率。
读取和转换文档的方法来自Skill,具体账期、价格和票据来自为任务准备的材料。评分会核对金额是否正确、明细与汇总是否一致。即使Agent成功提取了全部金额,采用尚未生效的费率仍会被判错。
通过试运行检查任务质量
小红书AllSpark的Skill2Env会让Agent试做任务,核查材料是否齐全、评分是否符合任务要求。遗漏必需文件或评分错误造成的失败,会先用于修正任务。对于Agent已经能够轻易完成的任务,该工具会增加难度,例如将判断依据分散到多份文件中,并同步调整材料和评分。
03
执行记录与评分如何用于训练
基于Skill设计任务,为Agent训练补充了实际操作的材料。模型需要读取文件、调用工具,根据返回结果继续处理,最终完成交付。训练可以利用成功执行的示范,也可以让模型实际尝试,再依据任务得分调整后续行为。
采用示范训练时,保留的是一段完整操作过程,包括模型如何选择工具、处理返回信息和形成结果。小红书AllSpark团队让DeepSeek-V4-Flash执行生成的任务,保留1500条高评分记录,对Qwen3.6-35B-A3B进行监督微调。训练后,该模型在Terminal-Bench 2.1上的终端任务成功率从44.9%提高到58.4%,在SWE-bench Multilingual上的跨语言代码仓库问题解决率从63.3%提高到71.0%。这些指标衡量的是实际任务完成情况,表明这批示范对终端操作和代码修复任务具有训练价值。
任务附带的检查程序还可以直接提供强化学习所需的得分。NVIDIA团队让Qwen3.8-27B在生成的任务中执行操作,按完成情况评分并训练。在其FlashREINFORCE训练配置下,Terminal-Bench 2.1的单次任务通过率从49.4%提高到58.4%;该指标在Pi框架下按每项任务五次测试统计。
同一套任务用于另一种训练方式,结果也可能不同。NVIDIA尝试用GLM-5.3的执行记录微调Qwen3.8-27B,Terminal-Bench 2.1成绩反而从49.4%降至45.8%。可执行任务为训练提供了材料和评分依据,怎样利用它们仍需以训练后的任务表现来判断;收集到执行记录,并不代表已经获得有效的训练数据。
04
从单项操作到完整任务评测
Skill除了说明操作方法,也经常规定交付内容、核验步骤和质量要求。利用这些要求设计评测,可以把“Agent做出了一个结果”细化为:结果是否完整、必要步骤是否执行、后续工作是否正确使用了前面的成果。
Anthropic的skill-creator已提供较直接的测试流程:Claude依据Skill用途拟定测试请求,记录输入文件与预期结果,补充检查项,再比较有无Skill或不同版本的执行表现。开发者可以查看实际输出及通过率、耗时和Token用量。[4] 这让Skill中的要求有了对应的测试案例,修改方法后也能通过相同任务观察效果。
检查交付结果与必要步骤
评测需要区分“完成了多少项要求”和“有多少任务可以完整交付”。一份产物满足了大部分要求,仍可能遗漏必须交付的内容;只看逐项平均成绩,会掩盖这种差别。
穆罕默德·本·扎耶德人工智能大学Zhengxi Li、香港城市大学Junyi Zhou等人的SkillForgeBench,将Skill要求分成结果与过程两类评分条目,并经人工审阅和校准。结果评分检查交付内容,过程评分检查任务要求的操作与核验步骤。
在842项任务、OpenHands框架及提供Skill的配置下,Opus 4.8的结果要求平均达标率为85.7%,满足全部结果要求的任务占比为40.9%;满足全部过程要求的任务占比另行统计,为27.7%。[5]
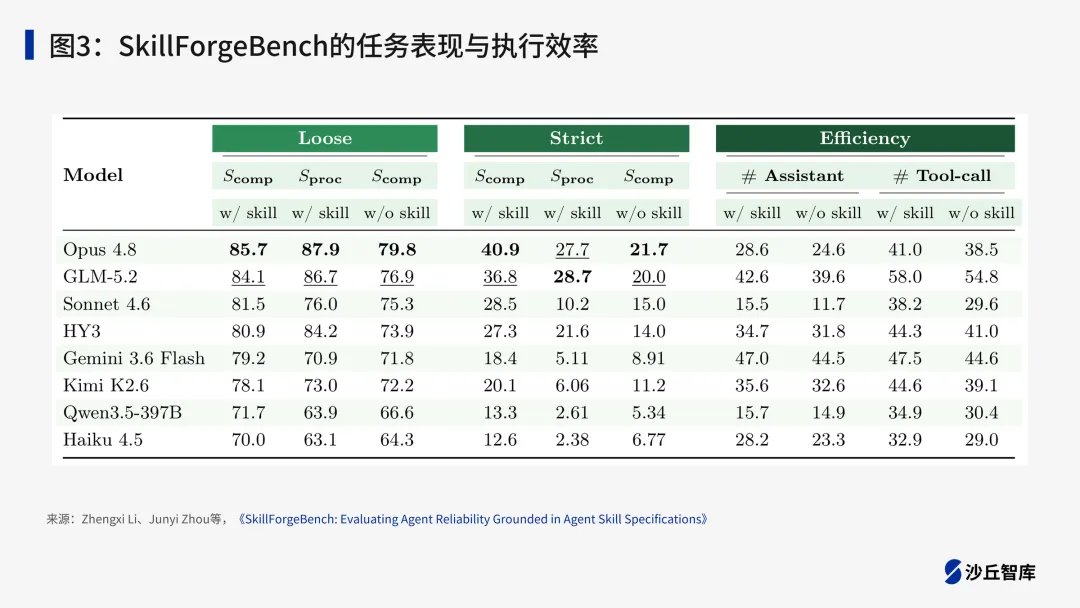
85.7%表示每项任务中结果要求的达标比例,再对所有任务取平均;40.9%表示满足全部结果要求的任务比例。两者的差距揭示了一个交付问题:多数要求能够完成,并不代表多数任务无需补做。27.7%则单独反映全部过程要求的满足情况,不能与40.9%合并理解为同一通过率。
过程检查也已进入厂商评测工具。AWS在Strands Evals和Amazon Bedrock AgentCore Evaluations中提供步骤遵循评估,让评判模型对照已读取的Skill和执行记录,检查各步骤完成得是否充分。其文档处理示例中,Agent已经提取文本,却未完成定位表格边界等步骤;这种遗漏需要查看执行过程才能识别。[6]
检查连续工作中的结果更新
单独测试各个Skill对应的工作,还无法检验它们连接后的表现。连续任务中,后一步可能依赖前一步的输出;前面的材料发生变化,已经完成的后续工作也可能需要重做。评测必须把这些依赖和变化纳入任务,才能发现Agent是否一直使用有效结果。
香港科技大学Yuxuan Liu等人的SkillHorizon,依据多个Skill的输入、操作和输出关系,设计连续工作任务。其财务环境要求Agent先处理多个来源的数据,再逐级汇总;原始数据修正后,相关处理结果和后续汇总都必须更新。[7]
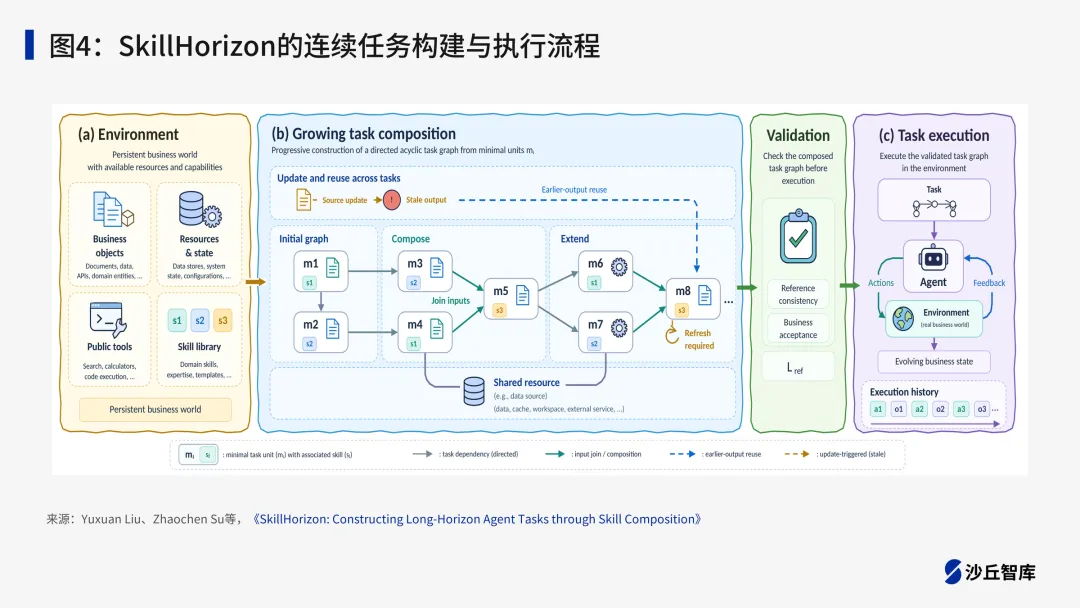
在这种评测中,Agent即使能够分别完成数据处理和汇总,继续引用旧结果仍会导致最终任务失败。把多个Skill对应的工作连成一项任务,测试的才是Agent能否跟踪前后依赖、处理变化,并完成整项交付。
参考资料
Weiyi Xu等 / 小红书AllSpark团队:Skill2Env: Capability-Oriented Environment Synthesis from Skills for General Agents、AgentEnv官方项目、团队官方介绍 Binfeng Xu等 / NVIDIA:Skill2Env: Reinforcing Agents with Collective Skills、NVlabs/Skill2Env开源工具、Harbor Hub任务数据 Zihao Cheng等:Terminal-World: Scaling Terminal-Agent Environments via Agent Skills Anthropic:skill-creator实现、Improving skill-creator: Test, measure, and refine Agent Skills Zhengxi Li、Junyi Zhou等:SkillForgeBench: Evaluating Agent Reliability Grounded in Agent Skill Specifications Sangmin Woo等 / AWS:Evaluate skill-equipped agents with Strands Evals and Amazon Bedrock AgentCore Yuxuan Liu、Zhaochen Su等:SkillHorizon: Constructing Long-Horizon Agent Tasks through Skill Composition
▎近期案例研究
OPPO多模态Agent重构手机交互范式实践
京东xLLM投机推理架构设计实践
比亚迪AI Native实践
小红书Self-GC多轮Agent上下文治理实践
中国电信智惠工程师FDE本土化交付实践
...
AI Coding Agent的工具选择:MCP、CLI、Skills与Hooks如何分工
AI编程规模化落地:先建Harness,再扩智能体
让AI Coding可控:企业如何评估与落地规范驱动开发
AI生产力如何衡量:从使用留存到组织转型的五项指标
角色智能体如何进入企业:从任务执行到职责担当
*更多AI研究可前往“沙丘智库”小程序查阅
