如何在企业内部落地本体建模,本体的工程化路线如何选择?
我们在前面的基础篇《本体建模:给业务世界画图纸》聊到了「图纸与楼」的分工:本体定义类与规则,图谱承载实例事实;画图纸慢而磨人,但楼越高图纸越值钱。
本体建模:给业务世界画图纸
这篇则是要回答工程化的三个问题:图纸的工序怎么排(方法论与工具链)、大模型改变了什么(草案生成与接地约束)、三条落地路线怎么选(标准栈、轻量 schema、行业复用)。
本体项目的死法九成不是技术死,是治理死——没人维护的图纸,比没有图纸更危险。技术先进性研究
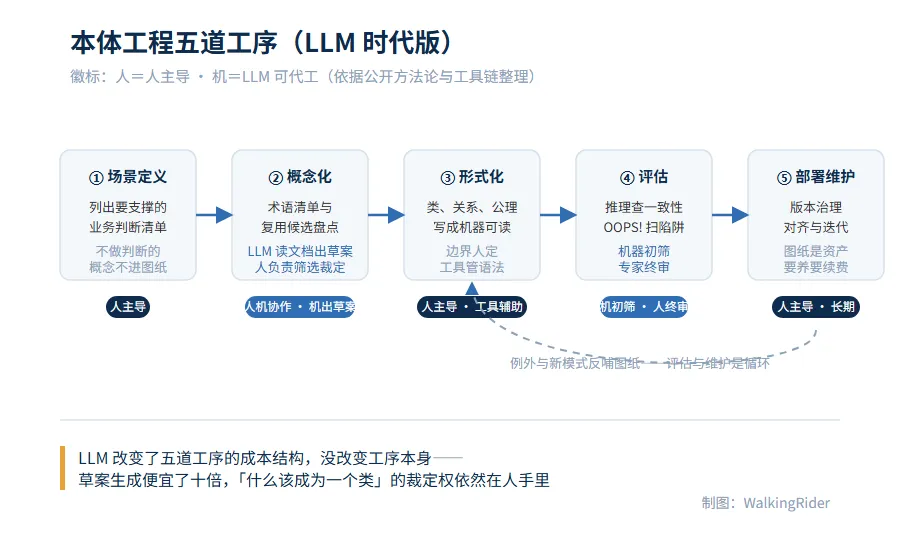
时间线基础篇铺过:1993年格鲁伯的定义、1995年企业本体、1998年瓜里诺的形式本体、2004与2009年 OWL 两代标准。这条标准线之外,还有一条常被忽略的方法论线——欧洲学界把本体建设从手艺活沉淀成工程流程(需求、复用、概念化、形式化、评估、维护的生命周期管理),工序化的思路流传至今。工具线同样久远:1987年起步的 Protégé,至今仍是免费开源的 OWL 编辑器主力,斯坦福官方维护着桌面版与 WebProtégé 协作版,全球的研究机构、组织和政府都在用。评估环节的工具化是工程成熟的标志。推理机(HermiT、Pellet、ELK 这类开源引擎)负责查逻辑一致性——两个不相交的类被同一实例占用,机器自动报错。OOPS!(本体陷阱扫描器,马德里理工本体工程组出品)则按结构、功能、可用性三个维度扫四十来种常见建模陷阱,每种标注严重级别——新手容易犯的「创建的类从未使用」「把关系方向画反」,机器先替你脸红一遍。五道工序——①场景定义、②概念化、③形式化、④评估、⑤部署维护——是行业三十年的共识骨架。2023年起,LLM 挤进了第二和第四道工序。当前 SOTA 与前沿动态(2023-2026)
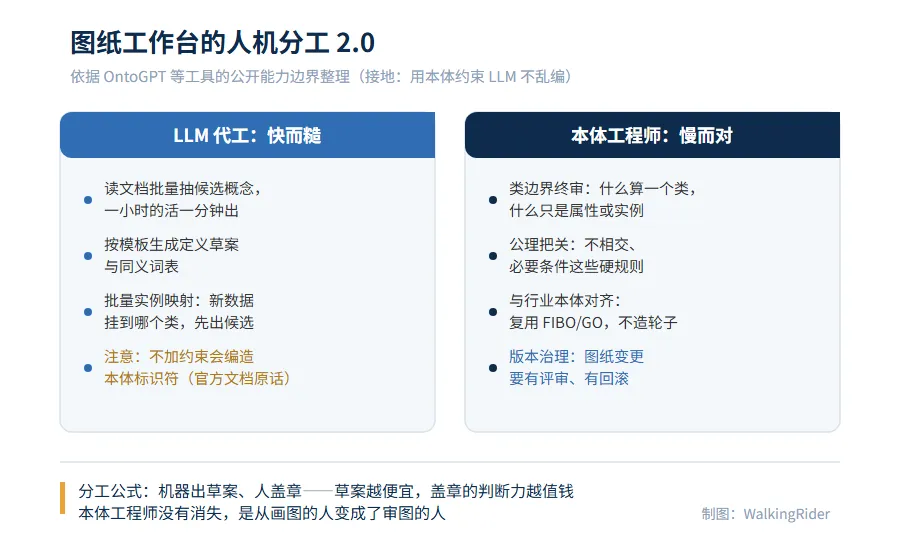
LLM 辅助本体工程是这三年最热的方向,两条代表线。一条是提取线。OntoGPT( monarch-initiative 出品的 Python 包)用本体约束住大模型的提取:给它一份文档和一个本体模板,它把疾病、药物、基因等实体按本体结构抽出来——官方文档有句值得抄在墙上的大实话:直接问大模型要本体标识符,它经常现编一个,或者把真实标识符安到错误的术语上——「接地」(grounding,把输出锚定在本体已有概念上)不是可选项,是保命项。2024年12月的综述性工作(arXiv:2412.00608)系统梳理了 LLM 自动抽取本体与生成知识图谱的路径,这条学术线已经很拥挤。另一条是实践线:GraphRAG 的实体类型表,本质就是一张轻量本体(后面可以详细展开聊聊)——大模型管线把「先定类型再抽取」变成了工程标配,本体方法论借 AI 的壳完成了最大规模的一次普及。人机分工的边界清晰:机器出草案(读文档抽候选概念、按模板生成定义、批量做实例映射),人盖图章(类边界裁定、公理把关、行业对齐、版本治理)。草案越便宜,盖章的判断力越值钱。趋势判断(给从业人员的「往哪看」)
判断一:本体工程师的角色从画图转向审图——招聘画像里,「能裁定概念边界」比「会操作 Protégé」值钱一个量级。判断二:轻量本体吃掉主流市场,重公理本体退守高价值阵地(监管报送、临床决策、跨组织互认)——中间地带会被证明是过度工程。判断三:智能体会把本体需求推向台前。模型直接参与业务执行时,「机器可以相信什么、什么条件下可以行动」必须显式化——这正是基础篇讲过的语义边界,如今有了买单方。工程落地研究
工具链格局
(商业侧补充:Stardog、Ontotext GraphDB 把编辑、推理、存储打包成企业平台;国内场景里行业本体(FIBO 金融、GO 生物)多为联盟运营,商业产品围绕落地服务生长。)SWOT:三条主流落地方案
方案 A:W3C 标准栈(Protégé+OWL+推理机+SHACL)
| |
|---|
| 表达力天花板(OWL 公理与推理);标准生态完整(编辑、推理、校验、查询全链路);学术与政务、生命科学的深厚积累 |
| 学习曲线陡峭,人才池小;开发周期以月计;推理性能调优门槛高 |
| 智能体时代「机器可读规则」的价值回归;可信数据空间与数据要素政策的语义基建需求 |
| 轻量路线「够用论」分流主流场景;后继人才断层;维护投入常被预算砍掉 |
方案 B:轻量 schema 先行(schema.org 风格+属性图约束)
| |
|---|
| 起步快,工程师零门槛上手;与属性图、图数据库天然亲和;GraphRAG 实体类型表即此路线,AI 生态直接复用 |
| 表达力有限,深层公理与推理缺位;语义约束靠纪律而非机器;跨组织互操作能力弱 |
| 企业知识库与 LLM 应用潮的直接需求;「先跑起来再进化」的工程共识 |
| 复杂场景的天花板;升级到标准栈时的迁移成本;标准栈阵营「不够严谨」的合规质疑 |
方案 C:行业本体复用(FIBO/GO/SNOMED 路线)
| |
|---|
| 站在行业共识之上,权威性与审计友好;少走弯路(GO 数十万标注的成熟度背书);跨组织对话有共同语言 |
| 读懂别人的图纸本身有学习成本;与内部概念的映射工作量大;更新节奏受制于行业组织 |
| 监管报送与跨境互认的刚需;行业联盟持续投入(EDM 理事会、GO 联盟都在演进) |
| 本地化适配的坑(监管口径差异);行业本体自身演进带来的跟随成本 |
选型建议与踩坑清单
三问选路线:业务判断要机器执行还是人看(机器执行→公理不能省,倾向 A);要不要跟行业伙伴互认(要→C 优先,A 兜底);团队几人、预算几年(两人以下一年内→B,别犹豫)。现实项目常见 B 起步、按场景局部升级到 A、对外的部分对齐 C——三条路线是工具箱不是信仰。大而全开局第一。「先建全域企业本体」是一九九〇年代的老坑,现代版是「先给智能体定义所有概念」——同一个坑换了个业主。场景清单没列出来之前,一个类都不该画。委员会造词第二。跨部门共建本体,概念定义容易变成政治妥协的产物——「客户」最终被定义成谁都能接受、谁都说不清的东西。解法是基础篇那句话:每个概念上台前答「支撑哪个判断」,答不出就出局。LLM 草案直连第三。OntoGPT 官方都把「会编造标识符」写在文档里了——草案必须过接地约束加人工抽检,直接把生成结果写进生产本体,等于把幻觉制度化。is-a 与 part-of 混淆第四。基础篇的口诀(读出声判「是一种」还是「一部分」)之外,加一道机器保险:OOPS! 这类扫描器对常见结构陷阱有自动检测,成本几乎为零。图纸腐化第五,也是最贵的。业务在变、监管在变,图纸不变——三个月后没人敢信它。版本治理要写进制度:变更有评审、有记录、有回滚,图纸的责任人要有名字。这一条做不到,前面全白干。结语
本体建模三十年,工具换了三代,工序还是那五道,死的理由还是那几个——立项求全、治理缺位、没人维护。大模型把草案的成本打到了地板上,这反而是好消息:当画图不再贵,真正稀缺的是判断力——什么该成为一个类、一条公理该多硬、一张图纸何时该改。图纸工作台的未来分工已经写在墙上:机器出草案,人盖章。