58 个医疗 AI 评测基准,和医护实际使用有多大差距?|NYU 研究解读
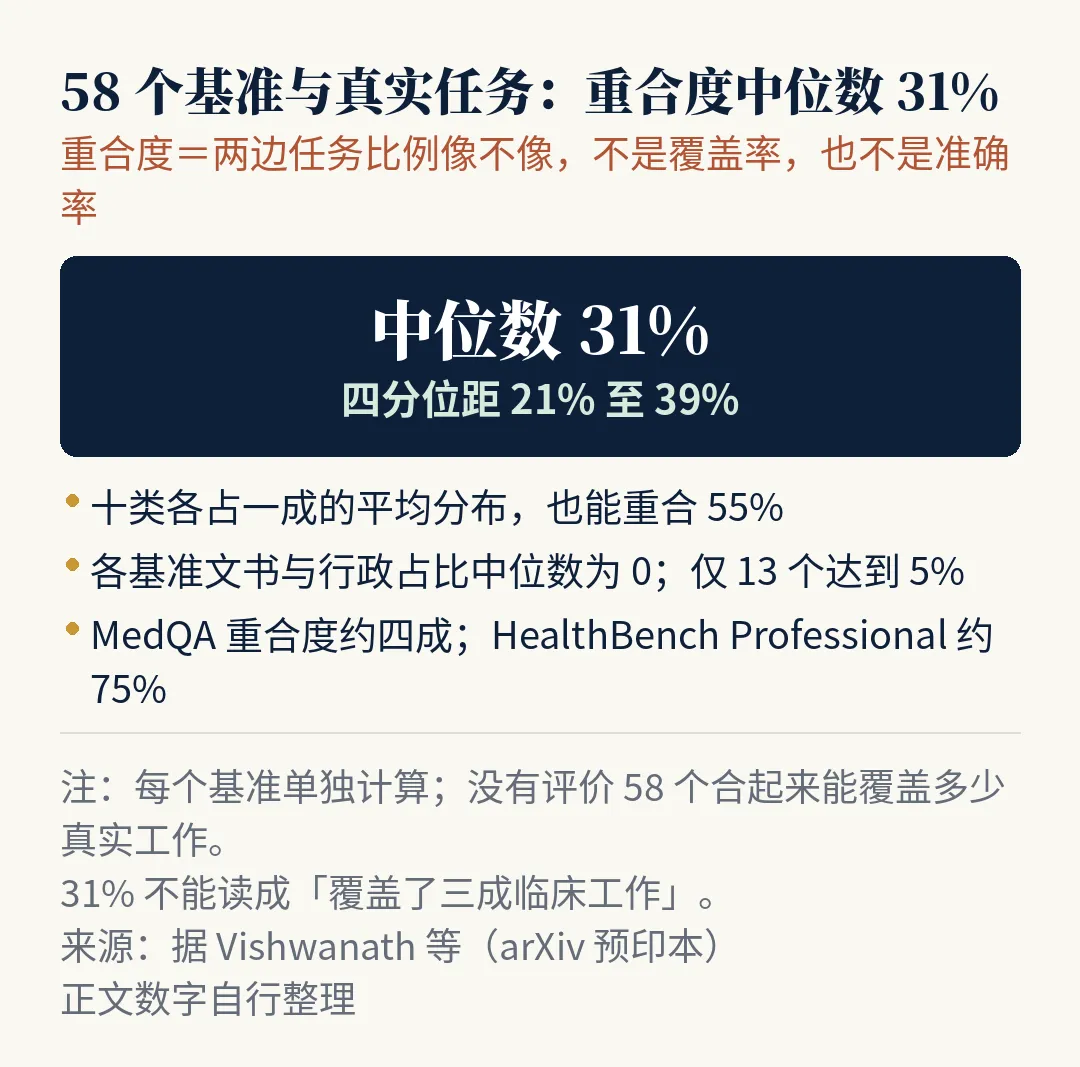
医疗大模型发布时,最常拿出来的是医考题成绩。可医护每天真拿 AI 干的活,和这些考题像不像?10 月 8 日,NYU Langone 的研究团队在 arXiv 发布了一份预印本(尚未经同行评审)。他们分析了这家纽约学术医疗系统 8 个月里 6,342 名医护发给院内 AI 助手的 12.8 万段对话,再用同一套标签,给 58 个公开、英文、纯文本医疗 AI 基准的题目分类、比对。结论是,单个基准与真实请求在任务构成上的相似度,中位数约 31%[注 1]。这个数衡量的是两边任务比例像不像,并不代表评测覆盖了三成临床工作,也不代表模型能力或评测准确率。这些基准与该助手实际接到的任务存在明显差异,单靠它们的分数,还不足以完整评价这一部署场景。更要紧的是,模型在完整题目上答对,和它在信息不全、任务复杂、有临床风险的真实工作流里做出恰当反应,是两种需要分别测量的能力。这项研究只分析了医护问了什么,没有记录助手答得对不对,也没有看这些回答是否影响了临床决策或患者结局。一、这个助手收到的请求:写文书、查知识,诊断不到 4%
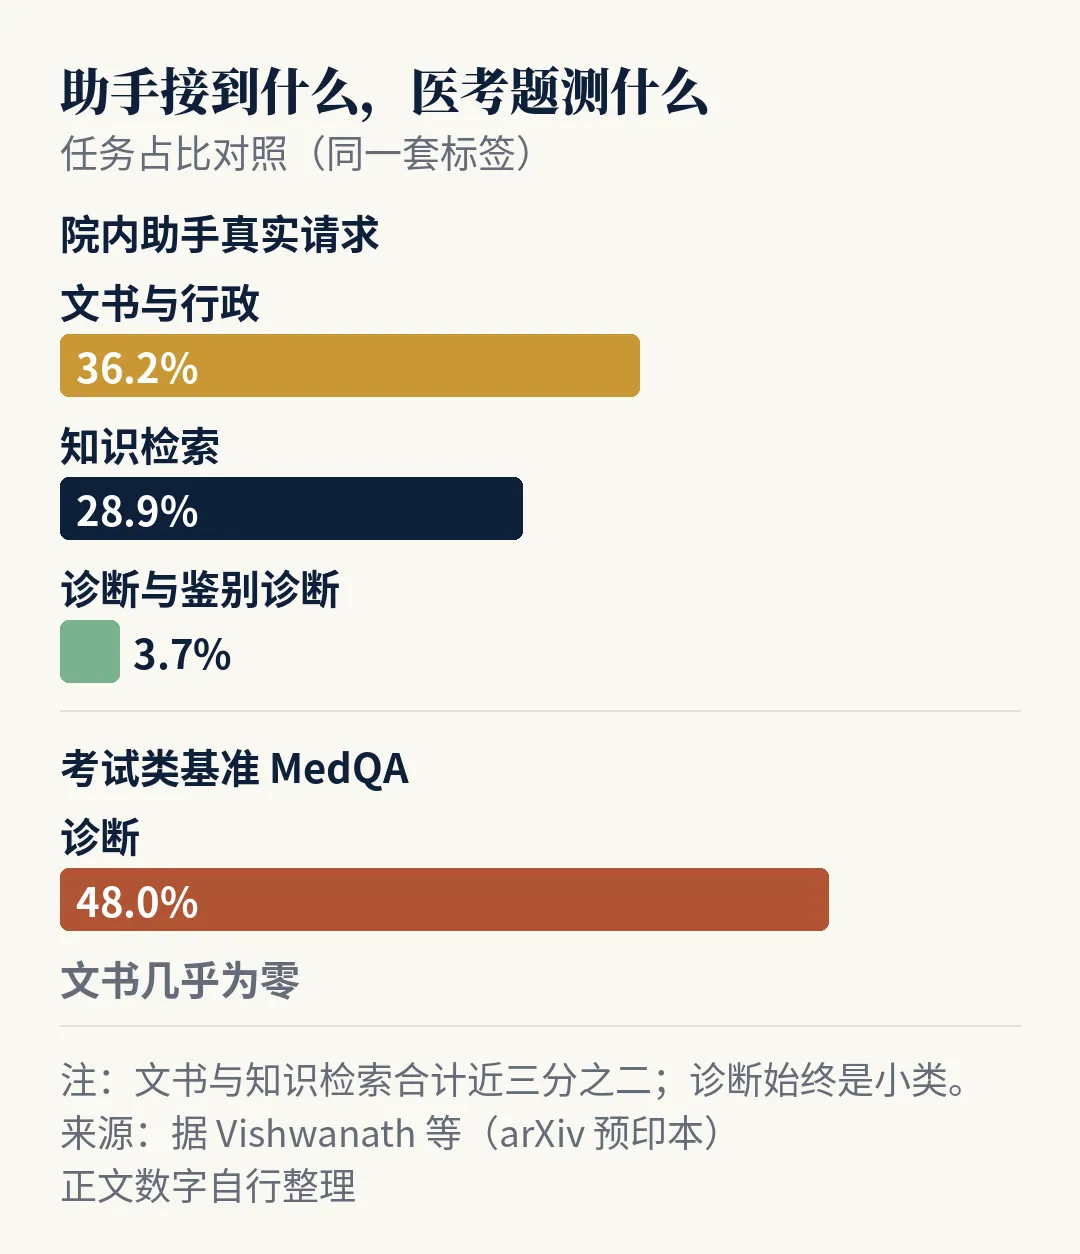
这个助手向这家医疗系统的全体员工开放,单点登录,医护直接打字或把临床文本粘贴进去。先看谁在用。一半的请求来自护士和执业护士、医师助理,注册护士单独约占三成(31.9%)。作者特别指出,这群人在临床 AI 评测里很少被考虑。再看问什么。文书与行政类请求占 36.2%,知识检索占 28.9%,两项合计近三分之二;诊断与鉴别诊断只占 3.7%[注2]。文书请求大多针对具体病人,主要是写临床记录、护理计划和出院指导,其次是整理病历摘要、回复患者门户消息。作者换了几种统计方法,诊断始终是小类,文书始终是最大类。医考题正好反过来。按同一套标签,考试类基准 MedQA 的题目里诊断占 48.0%,文书几乎为零。还有一个细节:作者尝试把真实请求归入美国医学会问卷使用的七类 AI 用途,约 30.6% 无法归类;排除非临床请求后,这一比例降至 13.1%。二、超过三分之一的请求,缺少直接回答的条件
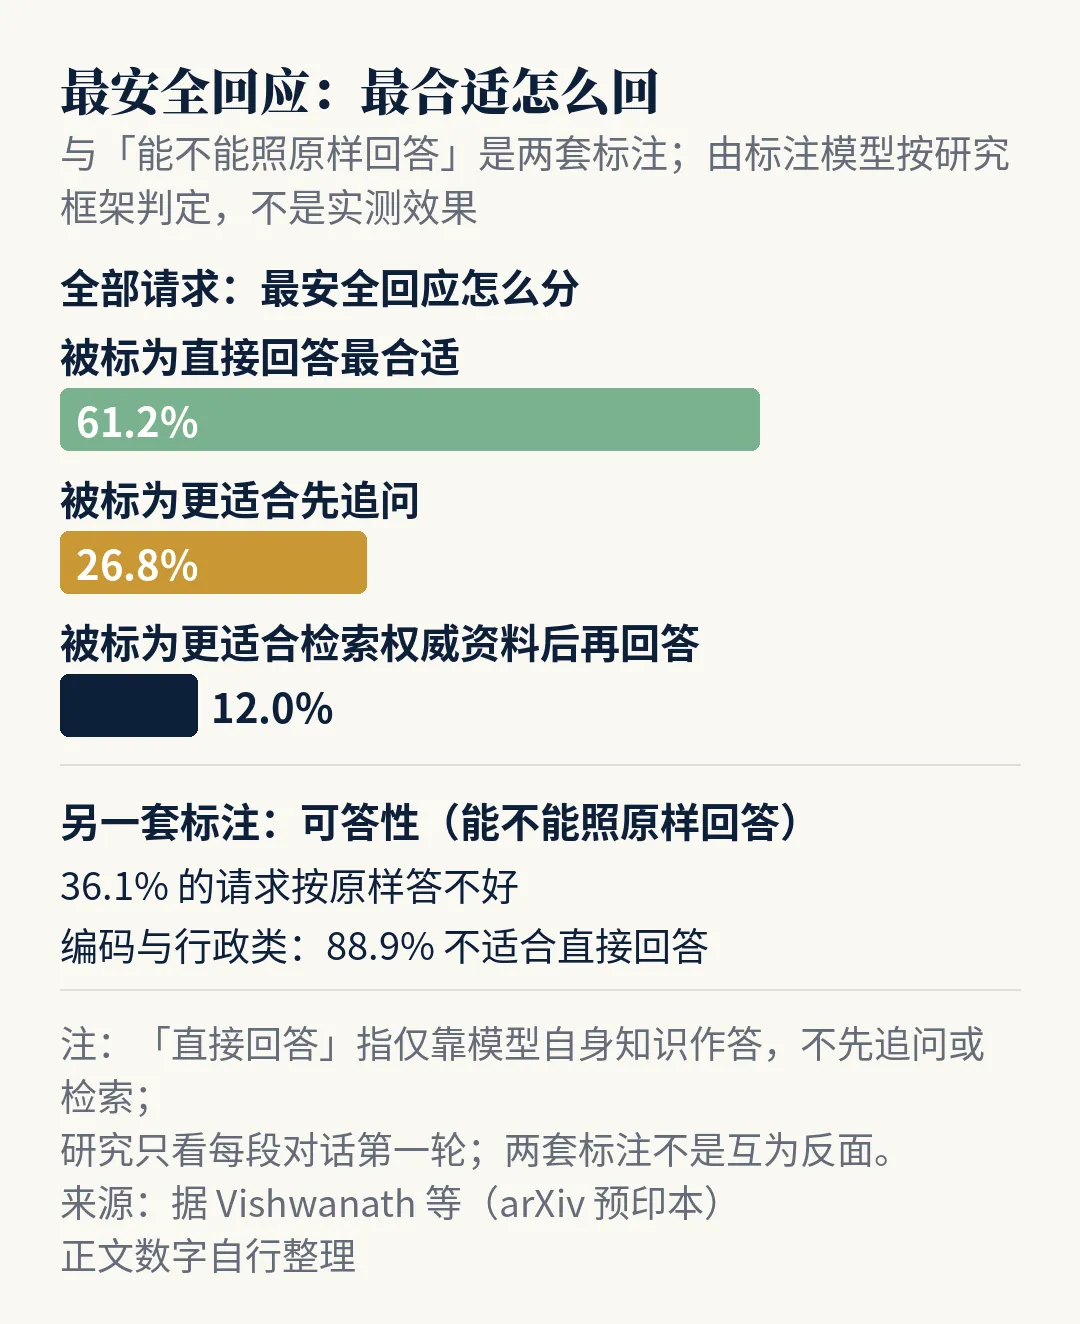
医考题通常会在题干里提供作答所需的信息。真实请求常常缺东西。研究给每条请求标了「能不能照原样回答」。36.1% 的请求按原样答不好;22.2% 缺少患者或本机构的信息,比如病史、检验结果、药品目录、医嘱套餐和计费规则。这是另一套标注,看的是最合适怎么回,不是前面那套可答性的反面。按研究者的标注框架,标注模型给出的「最安全回应」显示:61.2% 的请求被标为直接回答最合适,26.8% 被标为更适合先追问,12.0% 被标为更适合检索权威资料后再回答[注3]。这里的「直接回答」指仅靠模型自身知识作答,不先追问或检索。研究只看每段对话的第一轮,约 9% 的首轮消息甚至没有完整提出问题,有些医护可能先粘贴病历再提问。因此 26.8% 可说明信息补充值得纳入评测,但不能直接当成真实使用中必须追问的比例。编码与行政类请求最能说明问题。这类请求 88.9% 不适合直接回答,80.4% 需要患者或本机构的信息。它要的是具体患者的信息或这家医疗系统自己的规则,用公开数据训练的模型本来就不知道。高风险请求更常被标为需要补充信息或检索资料。被标为高或危急风险的请求里,84.5% 需要直接作答以外的回应,最常见的是先追问(60.0%)。药物与治疗合计约占全部请求两成,却占高或危急风险请求约六成。风险具体指:错误回答被未经核查地采纳后,可能造成的伤害;研究未测量实际伤害。作者据此认为,安全设计应更重视信息补充和权威资料检索,单纯扩大拒答范围可能帮助有限;这仍是基于请求特征的判断,实际降多少风险还需部署验证。三、58 个公开基准,与真实任务有多大偏差?
研究的做法,是把真实请求和基准题都分进同样的十类任务,比较两边的比例分布有多相似(原文用 1 减总变差距离,下称重合度)。每个基准最多抽取 200 题。一个十类各占一成的平均分布,也能和真实请求重合 55%。这个指标按每个基准单独计算,没有评价 58 个基准合起来能覆盖多少真实工作。58 个基准逐个算,重合度中位数 31%(四分位距 21% 至 39%),比平均分布还低。在抽样题目中,各基准的文书与行政任务占比中位数为 0;58 个基准里,只有 13 个的这一占比达到 5%。前沿模型发布报告里常用的 12 个基准,重合度中位数 40%,其中 9 个的诊断占比高于真实请求的 3.7%。专门设计来贴近临床的 4 个评测套件,包含 29 个基准,重合度中位数 35%,本研究未发现这组基准比前者更接近真实使用的明确证据[注4]。两个例子把差别摆得更清楚。作者全量细看的 MedQA,重合度约四成,只有 0.7% 的题被标为缺少患者或本机构的信息,97.6% 的题直接作答被标为最安全的回应。同属全量细看的 HealthBench Professional,是作者细看的 5 个基准里最接近的一个,重合度约 75%,也是唯一包含全部十类任务的,因为它在设计时专门采了临床咨询、科研和写作场景。作者的说法很直接:考试类基准能看出模型答没答对,看不出它知不知道什么时候该去查、该追问、该交给人。医生出题的基准纳入了更多需要追问、检索等处理的题目,66.9% 至 87.9% 的题需要直接作答以外的回应,但题目集中在会诊类临床问题。题目完整时答对,和信息不全时知道先停下来,是两种能力;考试类基准主要测前一种。31% 这个数依赖这一家医疗系统的请求分布和分类框架。标注模型的临床验证没有覆盖基准题目。本栏按原口径复算,结果与论文报告一致;补充核算见注5,复算不验证标签准确性。四、评测集该怎么配
作者的主张是,评测应当贴着真实临床使用来配,或许应当按部署定制。作者也承认,挑难题能让基准更有区分度,只是这样得到的分数不能当成上线后的错误率。专门评测诊断能力的基准有自身用途;评估综合助手时,还需要补充其他任务。对医院和厂商,比较实用的做法是先分析真实使用日志,弄清使用者、任务类型和请求特点,再据此建立能反映日常工作分布的评测集。评测不能完全照搬使用频率:药物、治疗等高风险任务要额外加强测试,新上线能力也应提前纳入;还要单独检查模型面对信息不全时是否知道追问、调用患者数据或检索本机构规范。最终不仅看回答是否正确,还要看模型能否选择适当的处理方式。不能只照频率配题,因为日志反映的是当前部署。原文没有说这个助手能读病历,医护也可能把需求带到别的工具上,作者写明看不到这部分[注 6]。今天的分布未必代表新产品能力上线后的任务。国内可以借用这套做法。美国一家医疗系统的任务比例,不能直接当作国内医院的比例。研究的边界也要看清。它只覆盖一家医疗系统、一个助手;临床人员对风险和最安全回应的判断一致性一般,绝对比例不如类别对比可靠。最要紧的是,这项研究只记录了医护问了什么,没有评估助手怎么答,更没有追踪对决策或患者结局的影响。这项研究没有证明哪种模型更可靠,却提醒我们:选择和使用评测时,要先看题目是否贴着上线后真正要处理的工作。评估综合助手时,除诊断外,还要把文书、知识检索,以及信息不全时该追问或检索,一并纳入。10 月 15 日,JAMA 也发表了一项基于 OpenEvidence 平台日志的使用研究,下一篇专门读它。· · ·
1. 研究为 arXiv 2610.11069v1 ,2026-10-08 09:29(北京时间)提交,截至 2026-10-16 只有这一版,未经同行评审。数据窗口为 2025-08-12 至 2026-04-03(2026-01-06 至 01-09 缺数据),覆盖 35 个专科;共 127,833 段对话,127,625 条得到有效标注。每段对话只标注医护的第一轮发言,9.0% 的第一轮没有可识别的请求,归入「其他」。助手的底层模型原文未披露。2. 文书有三个口径:文书与行政大类 36.2%,文书与工作流任务类 35.1%,讨论部分「起草临床或运营文书」33.6%。本文正文统一用 36.2%。3. 「最安全回应」由标注模型 GPT-5.6 sol 按研究框架判定,属于对请求特征的标注,没有干预实验。7 名临床人员对 100 条请求做了复核(每条 3 人),临床人员之间的一致性(Krippendorff α):最安全回应 0.40,潜在伤害 0.36,任务 0.64。在 34,190 条被标为最适合先追问的请求里,11,531 条是首轮没有可识别请求的对话,约占三分之一(本栏换算)。按临床人员共识校准,需要直接作答以外回应的比例为 44.8%;模型标为高或危急风险的请求占 13.2%,作者视为保守上限。正文「约六成」为本栏把原文两项(药物信息 38.8%、治疗与管理 21.2%)相加所得,基于模型标注。4. 每个基准最多随机抽 200 题,共标注 10,659 题。贴近临床的套件为 MedHELM、BRIDGE、ClinicBench、HealthBench;与前沿模型报告组的中位差为 −5.5 个百分点(95% CI −21.2 至 0.3)。区间跨零,尚不能确认两组存在差异,也不能据此认定两组等效。MedQA、HealthBench Professional 的数值取自 Extended Data Fig. 8 的全量细看版本。5. 本栏补充核算(非原作者分析):数据来源为作者公开的 Clinical AI Benchmark Atlas(CABA v1.0,GitHub nyuolab/CABA,2026-10-16 抓取)。按原口径复算,全部 58 个基准重合度中位 31.0%,与论文报告一致。另做三项补充核算:删除「其他」类并重新归一化后,中位 32.2%(改变纳入范围);合并为文书与行政、知识检索、临床推理、其他四大类后,中位约 36%(改变分类粒度);对 58 个基准做 bootstrap,中位数的 95% 区间为 27.8% 至 35.5%(重抽样下的波动)。合并类别可能提高重合度,不能据此强化「31% 很稳定」。核算沿用作者标签,不验证标签准确性,也不涉及标注器误差、多轮对话和换一家医疗机构等因素。6. 研究期内,这家医疗系统同时在推广 Abridge 的环境语音病历工具(Abridge 2025-09 公告称将部署给 1,000 多名临床人员),门诊病历这类需求可能有一部分没有进入这个助手。论文披露:资深作者 Oermann 持有 MarchAI、Artisight 股权,配偶受雇于 Eikon Therapeutics,并为 Sofinnova Partners 和 Google 提供咨询;第一作者 Vishwanath 为 ChartR Health 提供咨询。研究资助来自美国国家癌症研究所、W.M. Keck 基金会和韩国 IITP。来源说明:Vishwanath K, et al.《Clinician use of language models diverges from how the models are evaluated》,arXiv:2610.11069v1 ,2026-10-08,https://arxiv.org/abs/2610.11069 。基准逐题标签与汇总数据:Clinical AI Benchmark Atlas(CABA v1.0),https://github.com/nyuolab/CABA。Abridge 公告:https://www.abridge.com/blog/nyu-selects-abridge 。正文数字均出自论文正文、Extended Data 与 Methods;注 5 为本栏用公开数据的复核。