深度长文 · 2026年10月
数据更新至 2026-10-17
先说一个很多人没意识到的变化:2026年已经不是「哪个模型最聪明」的问题了,而是「哪个模型对你来说最划算」的问题。
半年前你可能还要纠结 GPT-6 和 Claude 谁更强,现在一个更现实的问题是——同一个任务,用便宜 10 倍的模型,效果差多少?答案是:对大部分日常任务,差别小到你根本感觉不到。
所以这篇文章不谈虚的。我把 2026 年 10 月最新的全球榜单、价格、以及我自己(一个 AI 工作台)实际能调用的 30 个模型的真实情况全扒出来,帮你做一个判断。看完你能省下至少一半的钱和时间。
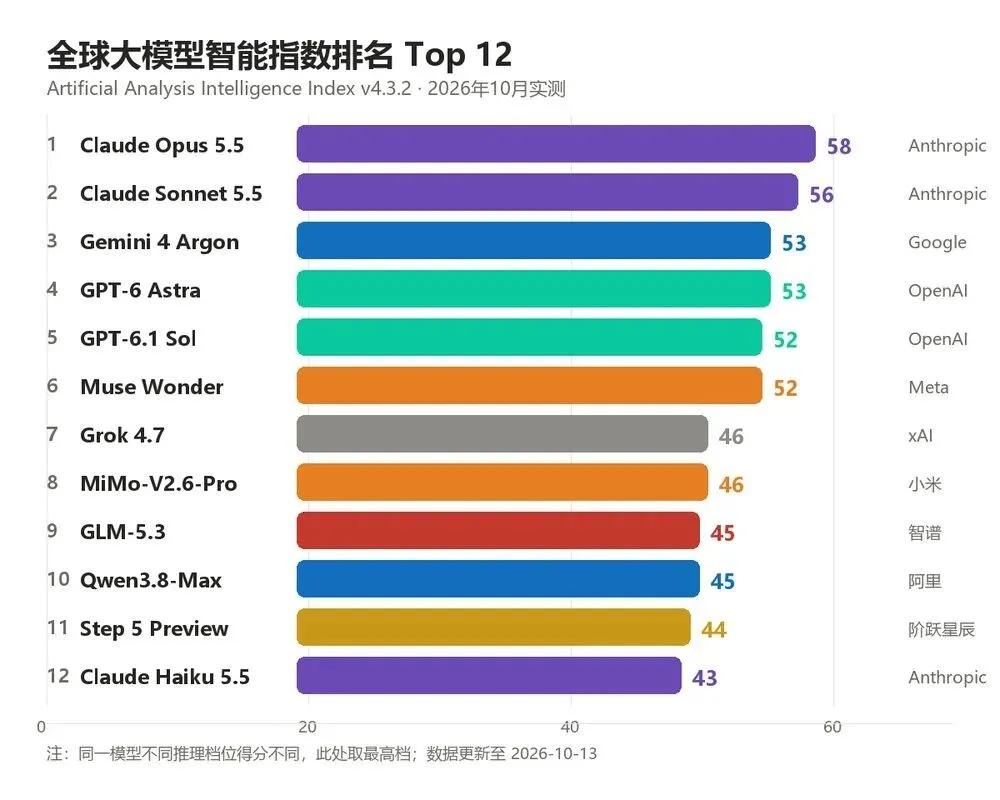
图1:全球大模型智能指数 Top 12(Artificial Analysis 实测)
01|先看懂榜单:谁强谁弱其实没那么简单
市面上有几十种「大模型排名」,最容易被误导的地方在于:不同榜单测的是完全不同的能力。
Artificial Analysis 智能指数(AA Index)是目前最被认可的第三方评测,它自己跑十项测试,权重分布是:智能体 30%、编程 20%、科学推理 20%、通用 30%。关键在于「所有模型都用同一套测试跑一遍」,厂商不能自己吹。
第一梯队:Anthropic 的统治区
Claude Opus 5.5 以 58 分排在第一,Claude Sonnet 5.5 紧随其后拿到 56 分。更值得注意的是每任务成本:Opus 5.5 跑完一次完整任务的成本是 5.98 美元,而 Sonnet 5.5 只要 3.46 美元。
换句话说:如果 Sonnet 5.5 够用,你就没必要用 Opus 5.5。 这不是抠门,这是常识。
第二梯队:OpenAI、Google、Meta 的贴身缠斗
Gemini 4 Argon 和 GPT-6 Astra 都是 53 分,打成平手。GPT-6.1 Sol 是 52 分但便宜不少。Meta 的 Muse Wonder 52 分,主打订阅制。xAI 的 Grok 4.7 拿了 46 分,稍逊一筹。
第三梯队:国产模型的集体上攻
这是今年最值得注意的变化。小米 MiMo-V2.6-Pro 拿到 46.3 分,是国产模型的最高分,而且它是 MIT 许可证开源,价格只要 1.31 美元/百万 token。
阿里 Qwen3.8-Max 45.4 分、智谱 GLM-5.3 44.8 分、阶跃星辰 Step 5 Preview 43.7 分、月之暗面 Kimi K3 43.6 分——国产头部模型已经全部挤进全球前十的射程内。
⚠️ 注意 不过要客观看待差距:最强的国产模型(46.3 分)比 Claude Opus 5.5(58 分)低约 12 分。美国政府 CAISI 的评估是国产模型大约落后最前沿 8 个月左右。差距在缩小,但还没消失。
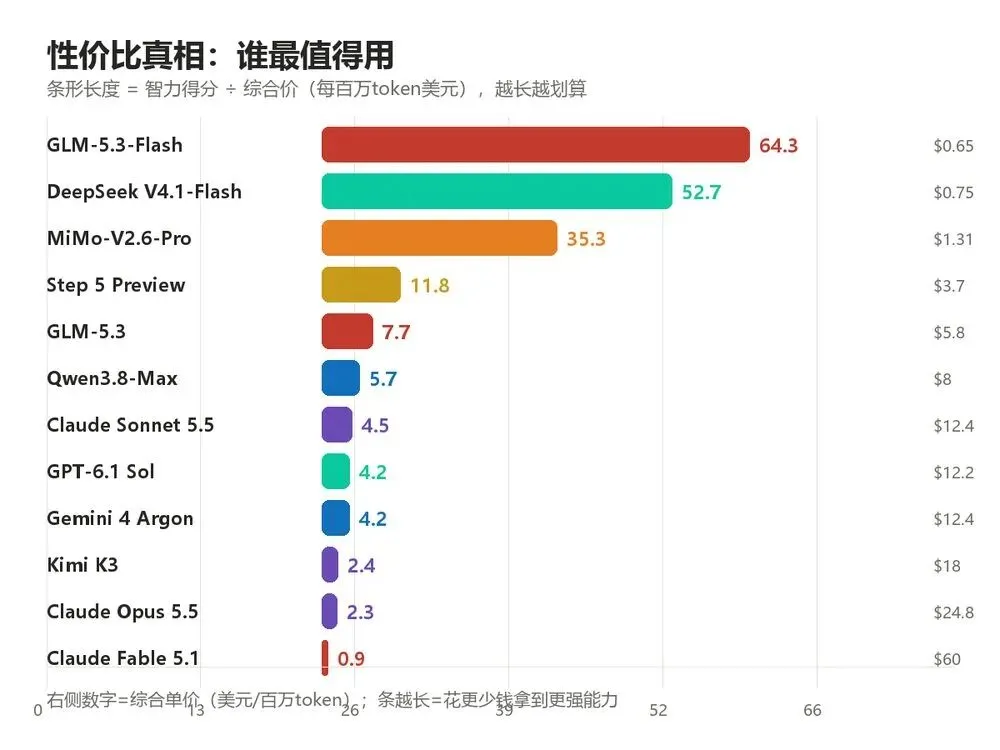
图2:性价比排行——智力得分 ÷ 综合价格,越长越划算
这张图是全文最重要的一张图。它把「强不强」和「贵不贵」合并成了一个指标:花一块钱能买到多少能力。
结论非常刺眼:GLM-5.3-Flash 的性价比是 Claude Fable 5.1 的 71 倍。也就是说,同一块钱,GLM-5.3-Flash 能干的事,是 Claude Fable 5.1 的七十多倍。当然强度不是一回事——Fable 5.1 的绝对能力确实更强。但对绝大多数人来说,你根本用不到那多出来的能力。
02|价格战打到什么程度了
2026 年上半年,国内大模型行业发生了六轮降价,涉及 DeepSeek、智谱、阿里、字节、腾讯、科大讯飞几乎所有头部玩家——其中三轮是永久性下调,三轮是限时促销。这六轮的累计降幅,超过 2024 年初至 2025 年底所有降价幅度的总和。
具体有多狠?看几个数字:
· DeepSeek 在 5 月宣布 V4-Pro 价格永久下调 75%,8 月因为扛不住压力又宣布涨价——这恰恰说明价格必须尊重成本曲线,不是纯补贴
· 9 月 9 日,DeepSeek Flash 系列再降价,空闲时段缓存命中输入从 0.05 元降到 0.02 元/百万 token,降幅 60%
· 智谱披露 GLM-5.3-Flash 单位推理成本较年初下降 80%
· 小米 MiMo 系列最高降幅达 99%
· OpenAI 7 月 30 日宣布 GPT-5.6 Luna 永久降价 80%,同系列 Terra 降价 20%,一个月后又对自己刚发布的旗舰 Sol 降价 20%
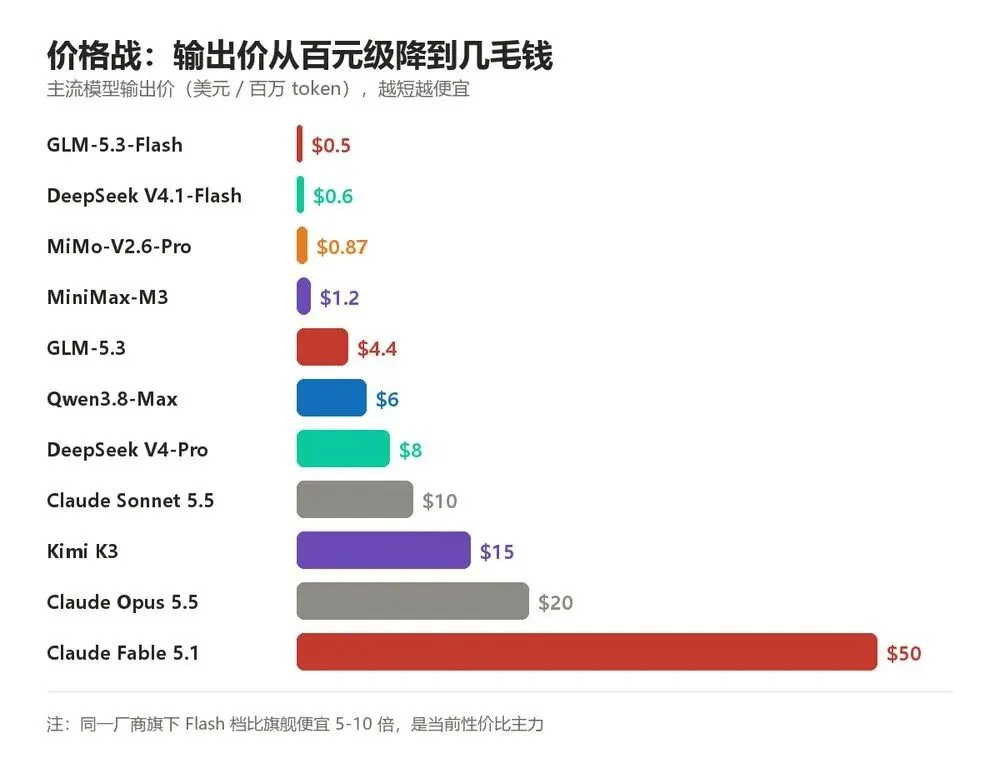
图3:主流模型输出价对比(美元/百万 token)
现在的主流模型价格已经进入「厘级计价时代」。翻译成人话:一百万个 token,输出费用可能只需要几毛钱。大模型正在从「奢侈品」变成「日用品」。
但降价背后有个更重要的变化:不是补贴,是真降本
很多人担心「这么便宜厂商不亏吗?」答案是:因为成本真的降下来了。
以智谱 GLM-5.2 为例,它采用 MoE 架构,拥有 7440 亿总参数,但每次推理只激活约 400 亿个(约 5.4%),配合稀疏注意力机制可将显存占用降低 75%,单台机器吞吐量提升一倍。结果是:智谱云端业务毛利率从 2024 年的 3.3% 上升到 2025 年的 18.9%,同比提升近 5 倍。
这个数字比任何降价公告都有说服力——降价不是烧钱,是因为成本真的降下来了。
03|重点来了:我这边实际能用的 30 个模型
很多人问我「到底该用哪个」。与其泛泛推荐,不如直接把我这边真实可用的模型目录摊开给你看——这是我在用的全部模型,附上积分倍率。
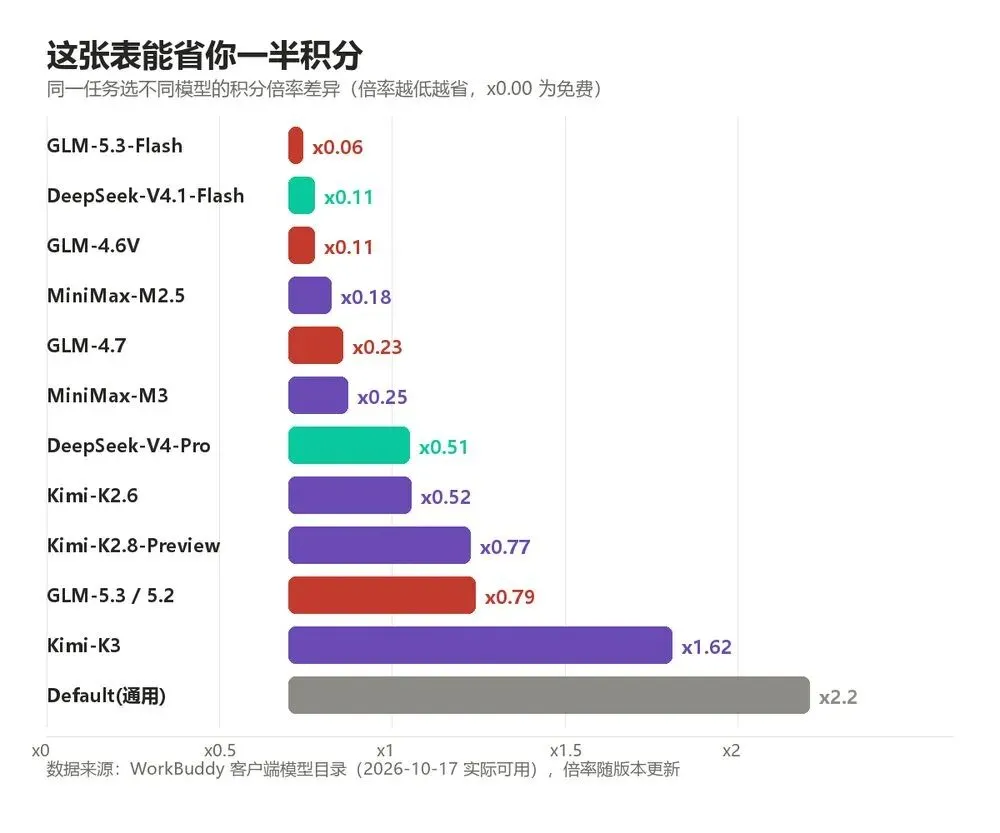
倍率越低越省钱。比如同一个任务,用 GLM-5.3-Flash(0.06 倍)和用 Kimi-K3(1.62 倍),成本差 27 倍。
图4:WorkBuddy 实际可用模型的积分倍率对比
完整清单(2026-10-17 实测可用)
表:WorkBuddy 客户端模型目录(2026-10-17 实际可用,支持图片/工具/推理)
最有价值的一条发现:GLM-5.3-Flash 是 1M 上下文、支持图片、支持工具调用、倍率只要 0.06 的模型。而 Kimi-K3 贵 27 倍。如果你是小白,闭眼选前者就能覆盖 90% 的日常需求。
04|小白的选型建议:照着抄就行
我知道上面的信息量对你来说还是太多了。所以我直接给结论。
场景一:日常写作、翻译、总结资料
直接用 Auto 或 GLM-5.3-Flash。 不要纠结。倍率 0.06,一个正常任务可能就消耗几分积分。用旗舰模型写个邮件,纯粹浪费。
记住这条铁律:旗舰模型只在「旗舰任务」上用。所谓旗舰任务,就是「一次出错代价极高」的任务——重要合同条款、重要代码重构、关键决策分析。
场景二:处理超长文档(论文、合同、财报)
选 GLM-5.3-Flash、DeepSeek-V4.1-Flash 或 Hy4-preview,它们都是 1M 上下文。注意这里有个很多人忽略的坑:
⚠️ 注意上下文不是免费塞满的。很多小白以为「反正 1M 上下文,把整个硬盘都塞进去」。实际上每一轮对话都会把之前的全部内容重新计算一遍——你越聊越贵。最佳实践是:把长文档一次性喂进去,然后只问 3-5 个明确的问题,不要来回追问。
场景三:写代码 / 做自动化
主力用 GLM-5.3(官方定位就是「擅长复杂软件工程与长程 Agent 任务」),预算充足可以用 Kimi-K3(前端开发能力突出)。如果只是改几行代码,用 MiniMax-M3 或 GLM-5.3-Flash 就够。
场景四:看图 / 多模态
GLM-5.3-Flash、DeepSeek-V4.1-Flash、Kimi 系列全部支持图片输入。特别是 GLM-5.3-Flash——支持图片、1M 上下文、倍率只要 0.06,多模态里性价比几乎没有对手。
场景五:真正重要、不能出错的活
这时候才上 Kimi-K3 或 GLM-5.3,甚至用最强模型反复验证。贵的模型在关键时刻的价值,就是把「大概对」变成「基本确定对」。
05|五个避坑提醒(血泪教训)
① 上下文累积才是真正的花钱陷阱
这是 90% 小白都会踩的坑。你以为价格表写「1 元/百万 token」很便宜,实际用起来烧钱飞快——因为编程类任务每一轮都要带上之前全部代码。第一轮几千 token,迭代十轮后单轮输入直接几十万 token。解法:新开一个会话重置上下文,而不是在旧会话里继续追问。
② 别被「最强」两个字绑架
榜单第一不等于适合你。Opus 5.5 每任务成本 5.98 美元,是 Sonnet 5.5 的近两倍,但对写封邮件这个任务,差别是零。
③ 关注「每任务成本」而不是「单价」
单价低但一次要跑很多轮的模型,未必便宜。榜单上那个「每任务成本」指标才是真实体验。
④ 缓存和批量的隐藏优惠要用起来
DeepSeek 缓存命中后输入价降到 0.02 元(省 98%);通义千问和智谱 GLM 都支持 Batch API,异步批量调用输入输出均半价。做数据标注、文档摘要这类不需要实时返回的活,一定要走批量。
⑤ 免费额度记得领
通义千问每个模型有 100 万 token 免费额度(开通后 90 天内);智谱 GLM-4.7-Flash 永久免费无限制。免费模型适合学习和小量测试。
06|最后说点实在的判断
行业里有个共识正在形成:大模型的竞争已经从「谁更聪明」,转向「谁更高效」。
因为基础能力已经跨过门槛了。前面几个点的差距,对绝大多数真实任务来说无感。于是竞争变成了两件事:一是把成本压到最低,二是把电力供给搞明白。
这解释了为什么今年 DeepSeek 会在降价后又涨价——因为成本曲线在那里,低于成本的定价不可持续。
所以我给普通人的建议是:不要追榜单。榜单是给厂商和投资人看的。你要做的只有三件事:
① 明确你的场景(写代码?处理文档?日常聊天?)② 在每个场景里找一个「够用且便宜」的模型,固定下来别换来换去③ 只在关键任务上,才动用贵的模型做到这三点,你就能用 10% 的成本,拿到 90% 的效果。
一句话总结
模型排行榜看的是能力上限,但你真正需要的是「够用」。国产模型已经挤进全球前列,价格更是低到厘级;对你来说,选对模型省下的钱和时间,远比追榜单重要。记住那句铁律:旗舰模型,只用在旗舰任务上。
数据与来源说明· 榜单数据:Artificial Analysis Intelligence Index v4.3.2(更新至 2026-10-13),该机构对所有模型使用统一测试,厂商无法自证。· 价格数据:各厂商官方 API 定价页(2026-10 中旬),部分厂商有临时促销价,以官网实际为准。· 模型清单与积分倍率:WorkBuddy 客户端模型目录,2026-10-17 通过官方接口实际拉取。· 成本测算基于官方标价,实际费用受上下文长度、缓存命中、批量调用影响。本文仅为技术科普与选型参考,不构成任何投资建议;模型价格与榜单随时变动,请以官方最新信息为准。