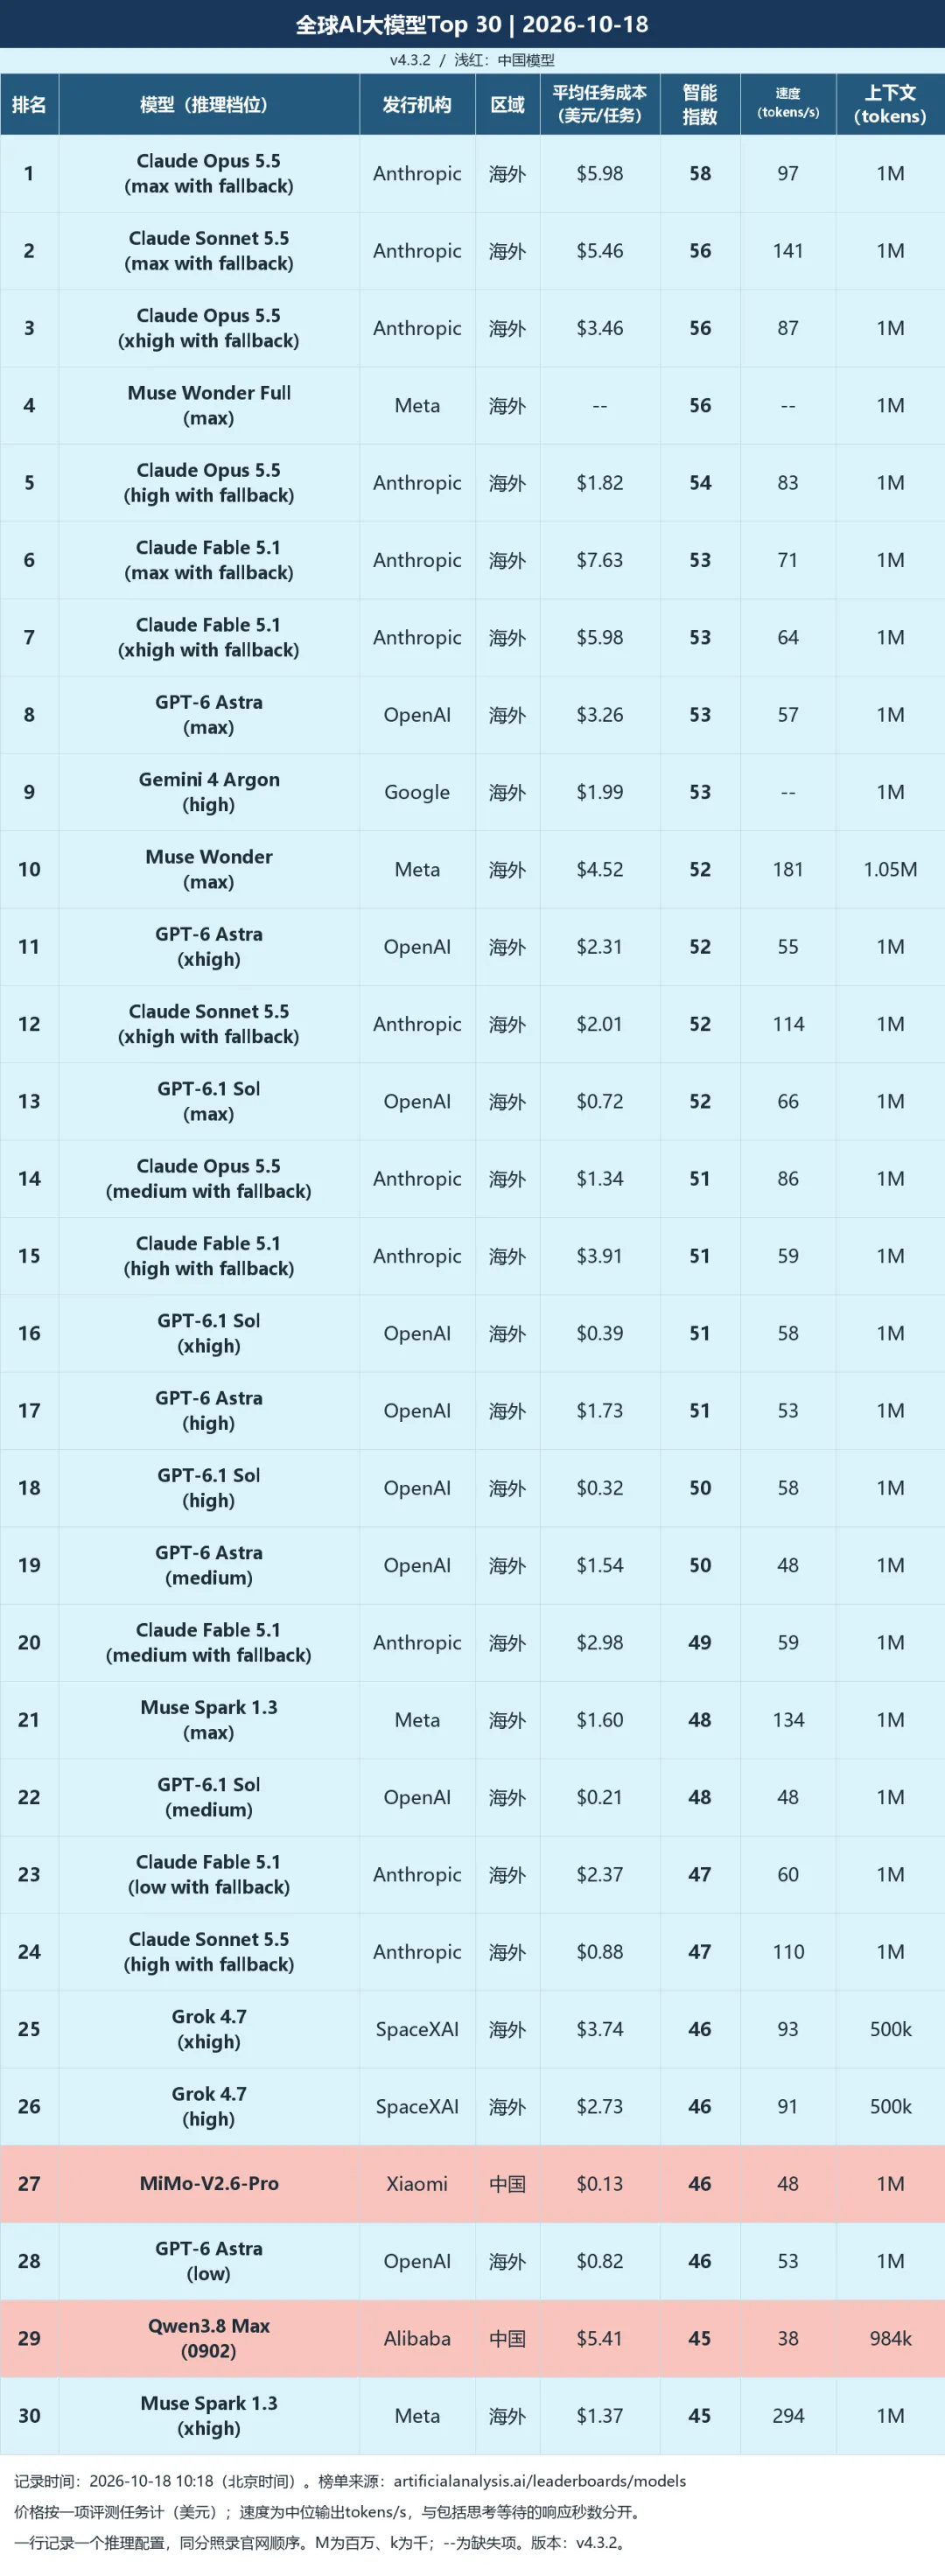
10月18日这版榜单,前30的顺序、分数和任务成本都与10月15日已发表榜单一致,变化在速度与等待时间。完整30名仍放在一张图里,浅红色标出中国模型,图后分开看几组容易读错的数值。
第1名还是Claude Opus 5.5(max with fallback),58分、每项任务5.98美元。后面依次是Sonnet 5.5 max、Opus 5.5 xhigh和Muse Wonder Full max,三行均为56分。对照两期快照,前30名单和显示分数均未变;不能把上期Meta进入前四的变化再报一次。
56分相同,费用却不能放在一列直接比较。Sonnet max为5.46美元,Opus xhigh为3.46美元,Wonder Full仍是“--”。缺失项还没补齐,既不能按0计算,也不能据此说它更省钱。这里展示的都是官网评测任务成本,不是每百万token的API单价。
Opus max还有个值得留意的变化:输出速度从上期95增至97 tokens/s,官网总响应时间却从684.50秒变成733.40秒。速度那一列略高,并没有让等待变短。两次快照也不是同一批请求的配对实验,不能据此判断模型变强、变弱或服务一定变慢了。
GPT-6.1 Sol max仍为52分、0.72美元,排第13。输出速度由48变成66 tokens/s,总响应时间则由312.11秒变成331.76秒。再看首块输出延迟,本次是324.19秒,接近总时长。只截一列66 tokens/s来介绍它,会漏掉用户真正等候的那段时间。
第10名Muse Wonder max同为52分、4.52美元,今天是181 tokens/s,首块延迟40.62秒,总响应54.45秒。它的任务成本约为Sol max的6.28倍。分数相同而等待不同,这才是需要按用途取舍的地方;它们并不是拿同一篇论文做的实测,也不能直接算出“每篇论文”的差价。
Sol medium为48分、0.21美元,本次总响应14.31秒。整理文献字段这类工作,可以先比较medium与max的错引、漏项和返工量,再决定是否值得等更久。长图保留原来的速度列;这里补充的首块延迟和总响应,均取自同一份官网快照的另外两列,没有混用模型详情页的后续数值。
MiMo-V2.6-Pro和Qwen3.8 Max(0902)仍是前30里的两行中国模型,名次分别为27、29,分数与任务成本分别为46分、0.13美元,以及45分、5.41美元。两者这三项展示值都没变。MiMo本次速度48 tokens/s、总响应56.30秒;Qwen为38 tokens/s、68.34秒,费用高低并不能替代这两列信息。
GLM-5.3 max仍排第31,45分、2.01美元;Step 5 Preview仍排第32,44分、1.03美元。上期已经在图外,今天不是再次“跌出前30”。GLM与图内第30名同为45分,截图截到哪里不等于能力分界。本次GLM为81 tokens/s、总响应33.74秒,Step为91 tokens/s、29.62秒,选候选模型时仍可留着它们。
做中文情感识别,不能把这两席当成完整的国产候选范围。总榜主要衡量英语文本能力;中文反讽、上下文依赖和情绪类别混淆,需要另用目标数据检验。比较时固定标签定义与数据划分,逐类看召回率和混淆矩阵。总分接近的模型,也可能在同一类情绪上犯不同的错。
Haiku 5.5 max仍排第34,43分、0.21美元。输出速度从上期237变成235 tokens/s,总响应由339.16秒变成338.50秒,前后只差0.66秒。这样的小幅差别,没必要写成一次提速。对交互使用来说,五分多钟的等待仍然存在。
本次max的首块延迟为336.37秒,总响应为338.50秒。high配置则是38分、0.08美元、188 tokens/s,首块延迟24.92秒、总响应27.58秒。至少在这组官网测量中,两档的等待差别主要出现在首块输出之前;表格并没有告诉我们内部具体执行了哪些步骤。
要反复追问论文细节,等待会一次次累积;把材料放进队列,过一会儿回来取结果,又是另一种用法。不能只因为名字叫Haiku就默认它所有档位都适合快速交互。这些秒数也不是处理任意一篇文档的固定耗时,自己的输入长度和输出要求仍须单独测试。
这一期没有换榜首,也没有新的前30成员。值得更新的是运行指标,而不是给旧名次重新编一个变化故事。前30的分数与任务成本逐项相同,只能说明官网当前展示值相同;并不证明每个单项测评、模型内部版本和实际使用体验都没有变化。
初筛情感识别模型时,可以取一小组包含反讽、情绪转折和多轮上下文的样本,固定提示与标签,记录预测、原文证据、等待和实际调用费用。先找出明显不合适的候选,再用独立测试集比较macro-F1。这种小样本排查是为了少走弯路,不能代替正式实验,也不能拿几段答得好的对话证明某个模型全面领先。
本期仍采用Artificial Analysis Intelligence Index v4.3.2,图像、语音和多语言评估另行提供。Gemini 4 Argon high仍是53分、1.99美元,速度与响应时间留空;Wonder Full的费用也仍未知。挑模型时,这些空白应该保留在判断里,不能用想象中的性能或成本替它们填上。
数据来源: Artificial Analysis LLM Leaderboard(https://artificialanalysis.ai/leaderboards/models)
评测方法: Artificial Analysis Intelligence Index v4.3.2(https://artificialanalysis.ai/methodology/intelligence-benchmarking)
官方更新日志: Artificial Analysis Changelog(https://artificialanalysis.ai/changelog)
数据截点: 2026年10月18日