💡 摘要:选 Embedding 别只盯总分榜。看 Retrieval、看中文、看尺寸与 Max Tokens,再用自己的问答对打一版私有评测。
榜单第一 ≠ 你业务第一。MTEB 上英语检索很猛的模型,落到中文制度、客服话术上,可能被小一号的中文模型反超——因为评测分布 ≠ 你的数据分布。
换过模型却「感觉差不多」的,多半缺两样东西:没有固定的私有题集,以及同时换了分块、Top-K、提示词——变量搅在一起,分不清是嵌入的功劳还是别的。
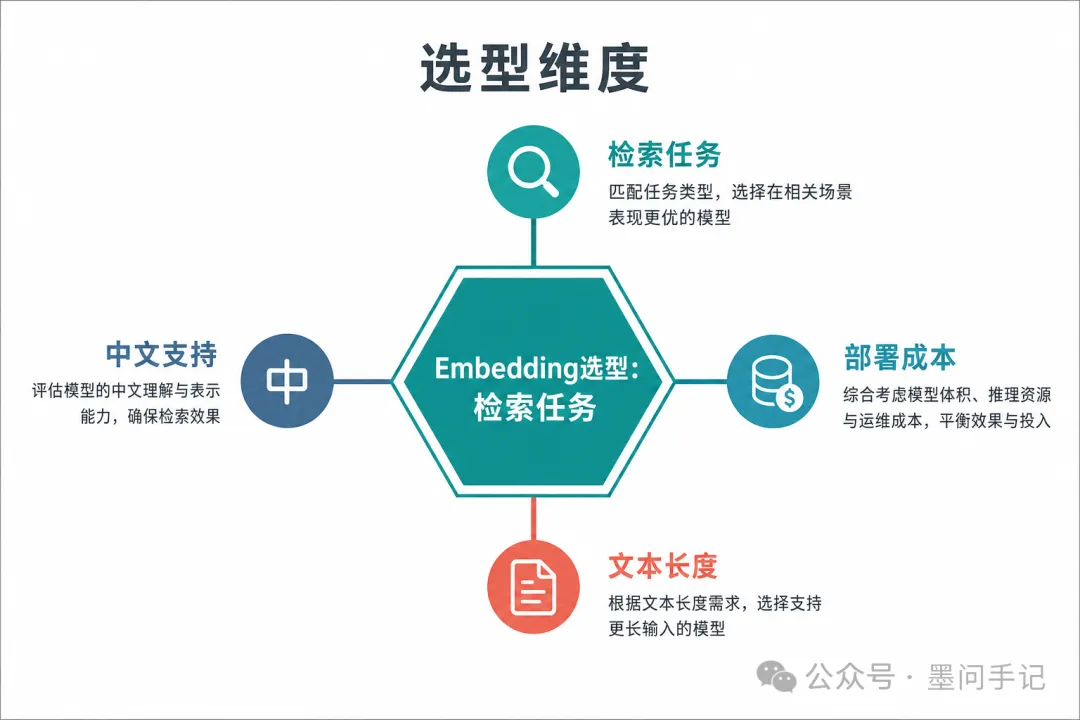 图1|别只看平均分:Retrieval + 中文 + 资源 + 长度一起权衡
从 MTEB 开始,但别停在那里
MTEB(Massive Text Embedding Benchmark)是目前最常用的公开榜。需要同时盯四个轴:
对 RAG,优先看子榜里的 Retrieval(检索),而不是分类、聚类拉高的平均分。中文还要多看一眼:是否明确支持中文 / 多语言,以及社区是否还在维护(C-MTEB、中文业务评测文章都可作参考)。
榜单的正确用法是:快速砍掉明显不合格的模型,而不是替你做最终决策。
选型时必问的七个问题
- 任务对不对:是不是 Retrieval 强,而不是只会做分类?
- 语言对不对:中文语料、中英混合、术语表,模型见过吗?
- 能不能部署:笔记本 CPU、单卡 24G、还是只能调 API?
- 维度吃不吃得消:百万级文档 × 1024 维,磁盘和内存还扛得住吗?
- Max Tokens 够不够:你的平均块是 256 还是 2k?模型窗口要盖得住。
- 谁发的、许可证怎样:BAAI、阿里等机构模型更常见;MIT / Apache 对商用更省心。
- 成本怎么算:API 按 token 计费;自托管算显卡折旧 + 运维人力。
还有一个常被忽略的点:查询侧与文档侧是否同一模型、同一指令模板。有的模型要求 query 加前缀、document 不加——漏了前缀,榜单分再高也复现不出来。
中文 / 多语言,可以怎么起手
榜单在变,但选型逻辑稳定。结合当前公开评测与社区实践,中文 RAG 可这样起手(仍要以私有集为准):
| | |
|---|
| Qwen3-Embedding | 2025–2026 多语言与检索榜上常见前列;中文语境友好 |
| BGE-M3 | 一个模型可出稠密 + 稀疏 + 多向量;长文本到 8192 token 量级;MIT,工程上很常见 |
| bge-small-zh-v1.5 | |
| 各家 Embedding API(按官方最新价与中文评测挑) | |
说明几点,避免踩坑:
- BGE-M3 仍值得保留在候选里:不一定永远「总分第一」,但「稠密+稀疏一体」对中文关键词(专有名词、编号、错误码)很香。
- Qwen3-Embedding 适合作为「效果上限」候选;0.6B 常可当基线,再按资源升到 4B / 8B。
BAAI/bge-small-zh-v1.5 依然是很好的教学与 CI 基线——先保证流水线对,再谈换榜一。 - 维度不是越大越好:存储与 ANN 成本线性涨;若模型支持 Matryoshka / 可截断维度,可先用短向量做召回粗筛。
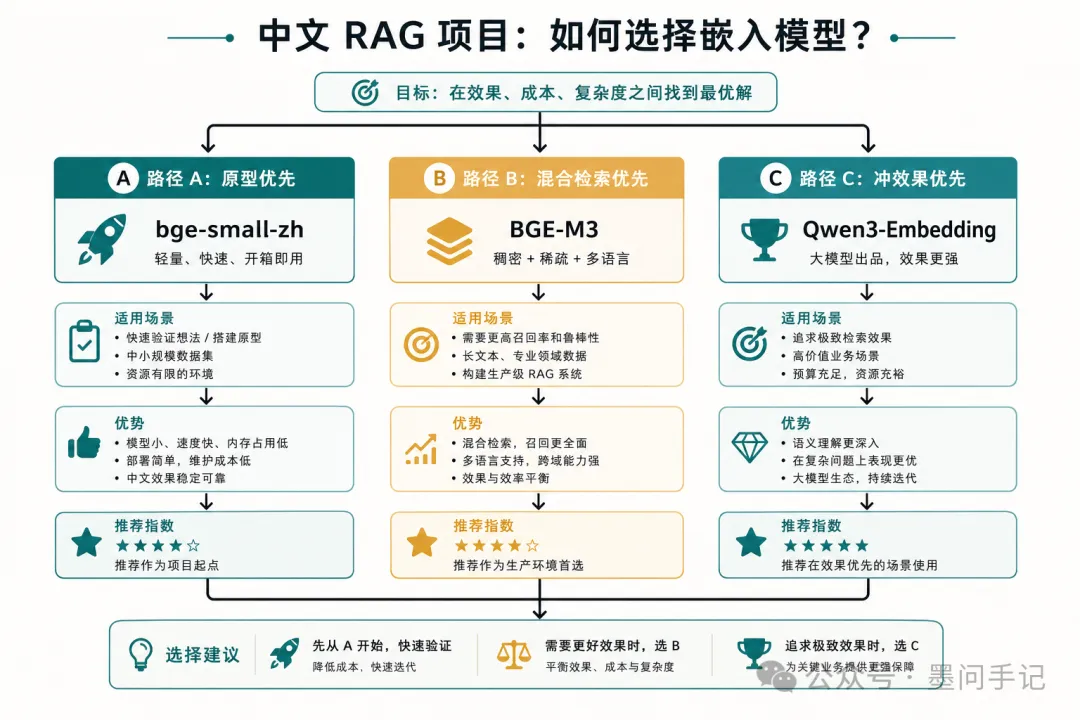 图2|原型用小模型;要混合检索看 BGE-M3;要冲效果再上更大编码器
私有评测:比刷榜更重要的三步
(1) 定基线从上面表格里挑 2–3 个模型:一个小、一个中、一个「你最想上的」。分块策略、Top-K、是否重排——全部钉死,只换 Embedding。
(2) 做题集从真实日志抽 30–100 条:问题 → 应该命中的文档块(或段落 ID)。制度问答就用制度原文;客服就用工单里「标准答复对应的知识条」。题集要覆盖同义改写、专有名词、否定句,而不是只会抄标题。
(3) 只比检索指标同一套分块,看:
效果差时,先别急着怪模型——分块切坏了、中英文混着没清洗、元数据过滤写错,都会表现为「模型不行」。几轮对比之后,再决定是换模型,还是先修分块。
实用决策口诀
先看语言与 Retrieval再看显存与 Max Tokens用私有题集打三轮小模型定基线,大模型换精度需要关键词+语义 → 优先考虑带稀疏能力的模型(如 BGE-M3)
这篇你带走什么
- MTEB 用来初筛;RAG 盯 Retrieval + 语言 + 尺寸 + Max Tokens。
- 中文场景 2026 年常见组合:小 BGE 做基线,BGE-M3 做混合检索,Qwen3-Embedding 冲效果。
- 最终赢家一定是在你私有问答集上 Recall 最高的那个,不是截图里的榜一。
