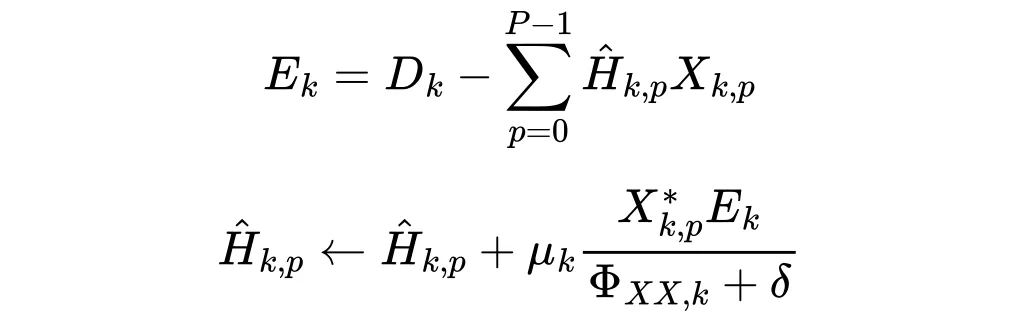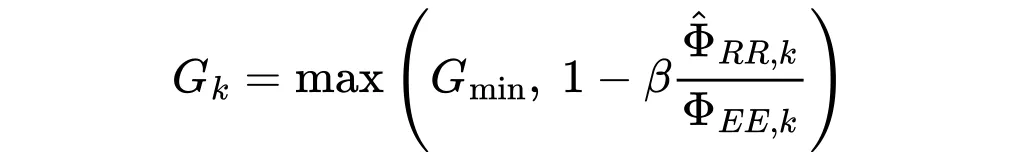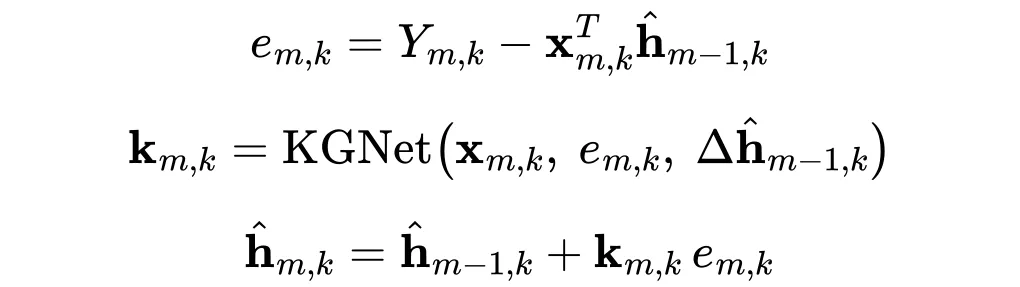AEC 回声消除技术
免提通话、会议、智能音箱、全双工语音交互、K 歌等场景里,扬声器放出的声音会被麦克风再次拾取,形成声学回声。回声消除(Acoustic Echo Cancellation,AEC)要做的事很明确:在尽量保住近端语音的前提下,把回声从麦克风信号里去掉。
本文按三条技术路线梳理现有方案:传统信号处理、端到端 DNN AEC、线性 AEC + DNN 非线性处理。其中 Neural Kalman Filter(NKF)、Meta-AF 等“神经网络增强的线性自适应滤波”归入第三条路线,作为线性级的进阶方向。每条路线都会给出原理、代表方案、代表论文和开源代码,最后补上评测方法、业界落地情况和端侧选型建议。
目录
1. 问题建模与核心难点
2. 三条技术路线总览
3. 路线一:传统信号处理
4. 路线二:端到端 DNN AEC
5. 路线三:线性 AEC + DNN 非线性处理
6. 数据集与评测
7. 业界落地方案
8. 端侧选型建议
1. 问题建模与核心难点
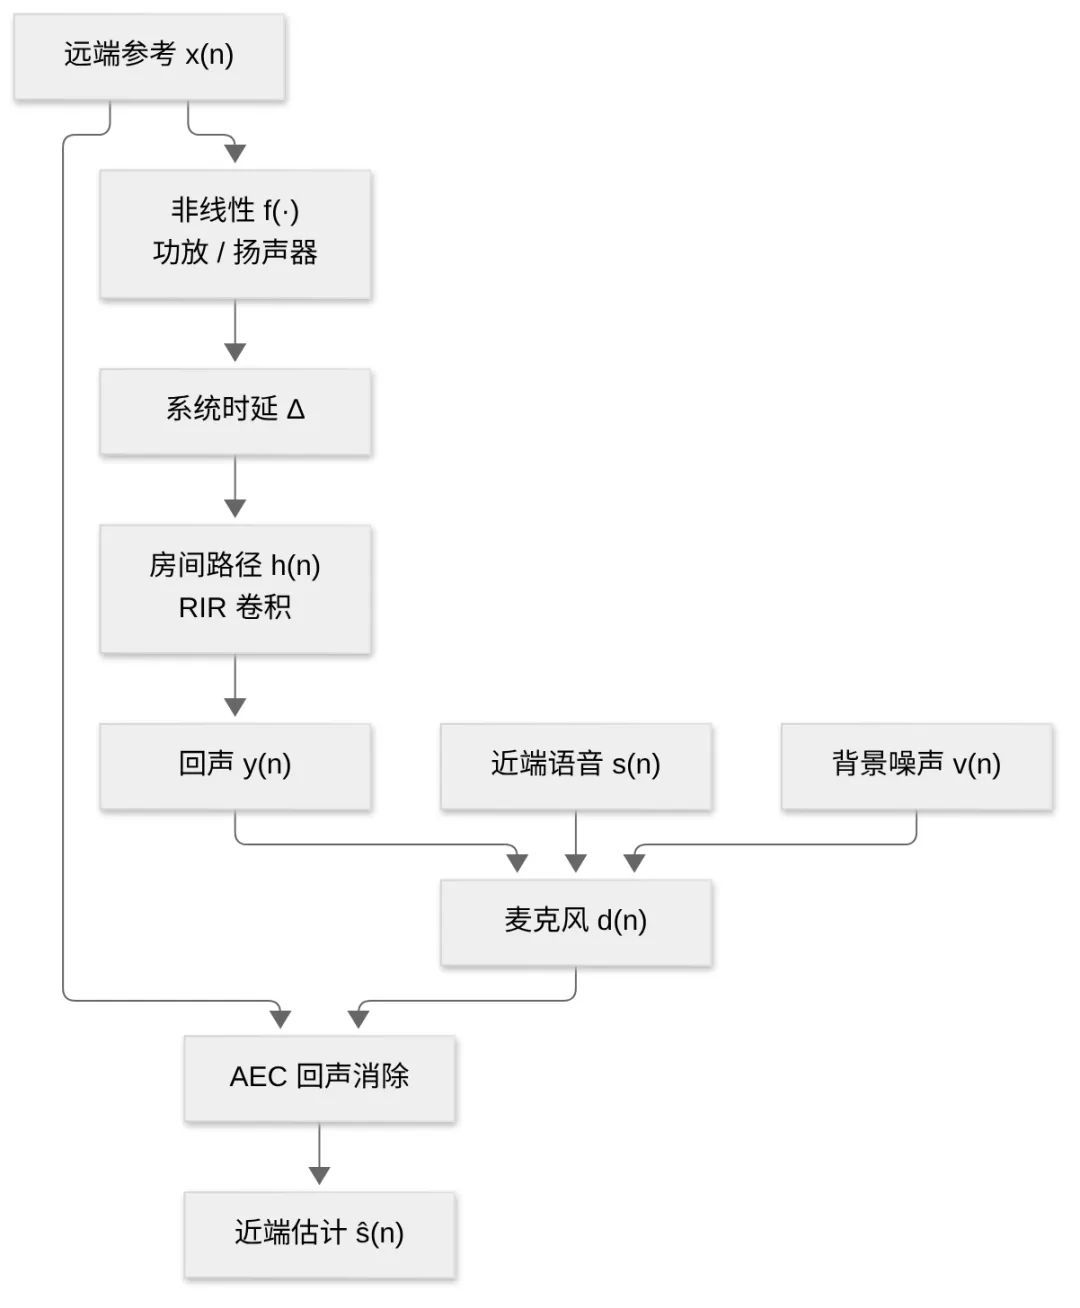
图 1 AEC 问题建模与信号流
麦克风信号可以写成:
d(n) = s(n) + y(n) + v(n)y(n) = h(n) ∗ f(x(n − Δ))
其中 ∗ 表示卷积。
符号 | 含义 |
|---|
x(n) | 远端参考信号,即扬声器播放的内容(通话中的对方语音、K 歌中的伴奏) |
Δ | 参考信号和麦克风信号之间的系统时延(播放缓冲、采集缓冲、驱动) |
f(·) | 功放和扬声器的非线性(削波、谐波失真) |
h(n) | 房间回声路径(房间冲激响应 RIR) |
s(n) | 近端语音,需要保留 |
v(n) | 背景噪声 |
AEC 的核心难点:
时延不对齐:系统缓冲带来的时延不固定,Android 上常见 50–300 ms,且会抖动或跳变。时延没有对齐时,线性滤波器和 DNN 都会失效。
非线性回声:小尺寸扬声器在大音量下会削波并产生谐波,线性滤波器无法建模这部分回声。
双讲:近端语音和回声同时存在。自适应滤波器容易在双讲时发散,后级抑制容易误伤近端语音(“吃字”)。
回声路径突变:人或设备移动、音量调节都会改变回声路径,要求快速重新收敛。
多通道参考信号:立体声参考信号高度相关,会导致自适应滤波解不唯一。
资源约束:端侧通常要求算法时延不超过 20–30 ms、计算量在几十到几百 MMAC/s。
2. 三条技术路线总览
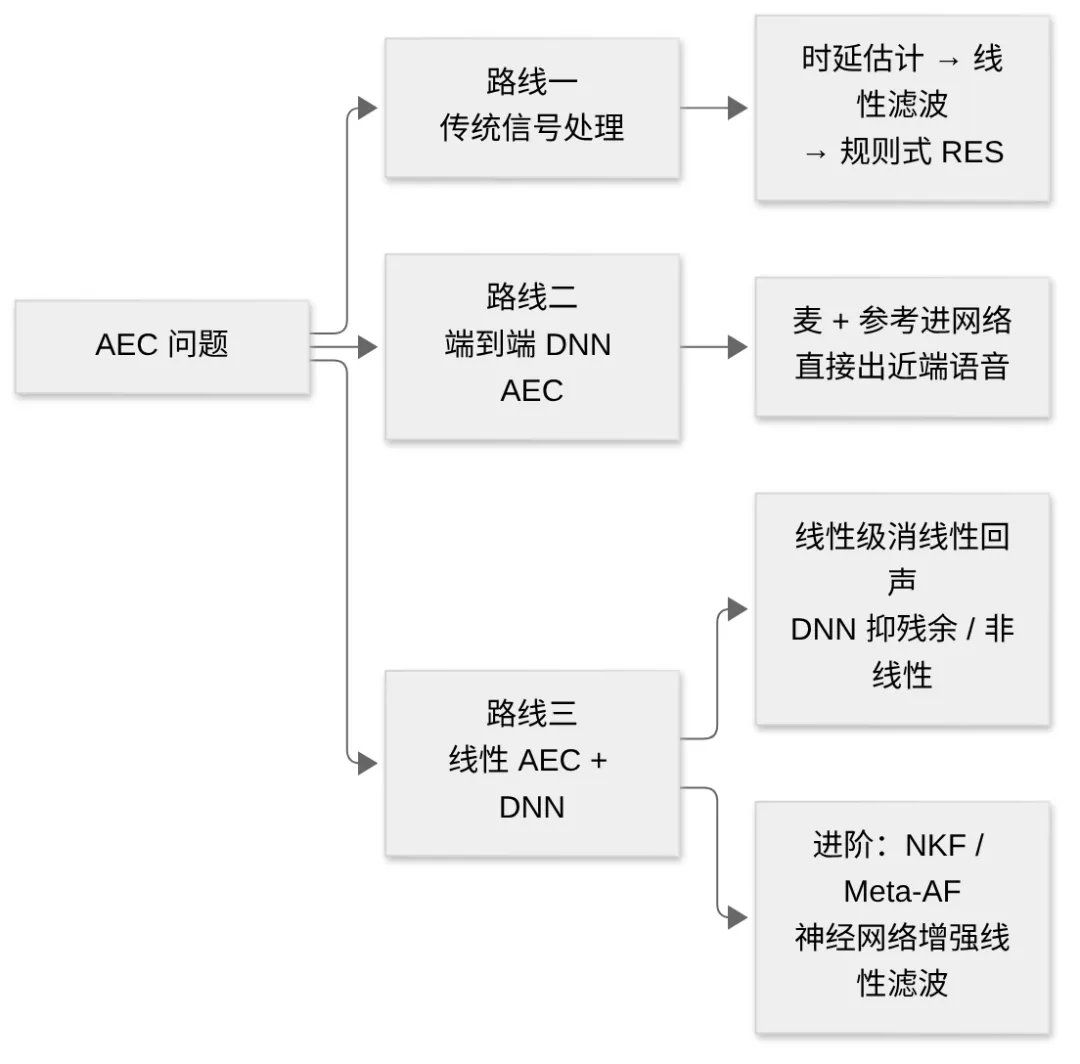
图 2 三条技术路线总览
路线一:传统信号处理
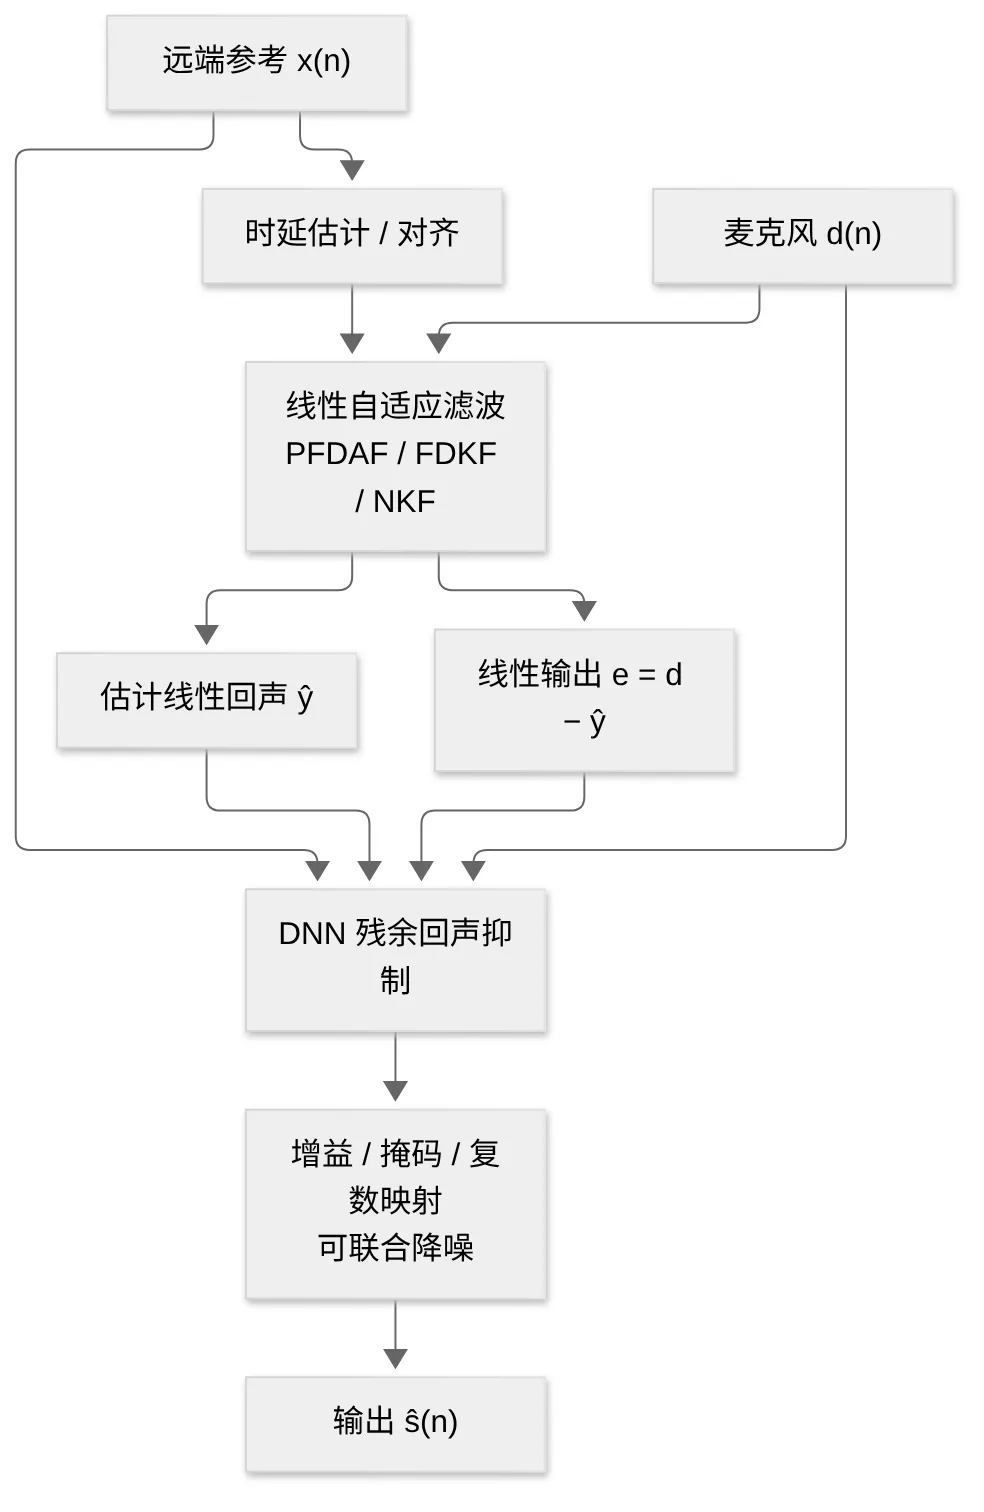
核心思路:时延估计 → 线性自适应滤波 → 规则式残余回声抑制
代表方案:WebRTC AEC3、SpeexDSP MDF、频域 Kalman
典型复杂度:极低,几 MMAC/s
适用场景:MCU/DSP、低成本设备、各类方案的基线
路线二:端到端 DNN AEC
核心思路:麦克风信号和参考信号一起输入网络,直接输出近端语音
代表方案:DeepVQE、Align-CRUSE、DTLN-aec、MSA-DPCRN、CAGCRN、JointAEC-NS、CGGN16
典型复杂度:54K–10M 参数
适用场景:PC、云端为主;也有极小模型尝试
路线三:线性 AEC + DNN 非线性处理
核心思路:线性自适应滤波去除线性回声,DNN 抑制残余和非线性回声,通常同时降噪
代表方案:PercepNet-AEC、MTFAA-Net、EchoFree、MSA-EchoLite
典型复杂度:低到中,0.05M–1M 参数
适用场景:端侧主流:手机、耳机、车载、音箱
↳ 路线三进阶方案:神经网络增强的线性自适应滤波
核心思路:保留线性滤波结构,用小网络学习步长、Kalman 增益或更新规则
代表方案:NKF、Meta-AF、DNN 控制的 FDAF
典型复杂度:极低,几 K 参数
适用场景:替换第三条路线里的线性级,提升收敛和双讲稳健性
目前成熟的产品方案基本都走第三条路线。纯端到端方案效果上限高,但端侧落地时,双讲下的近端语音失真和泛化风险较大。
3. 路线一:传统信号处理
3.1 系统结构
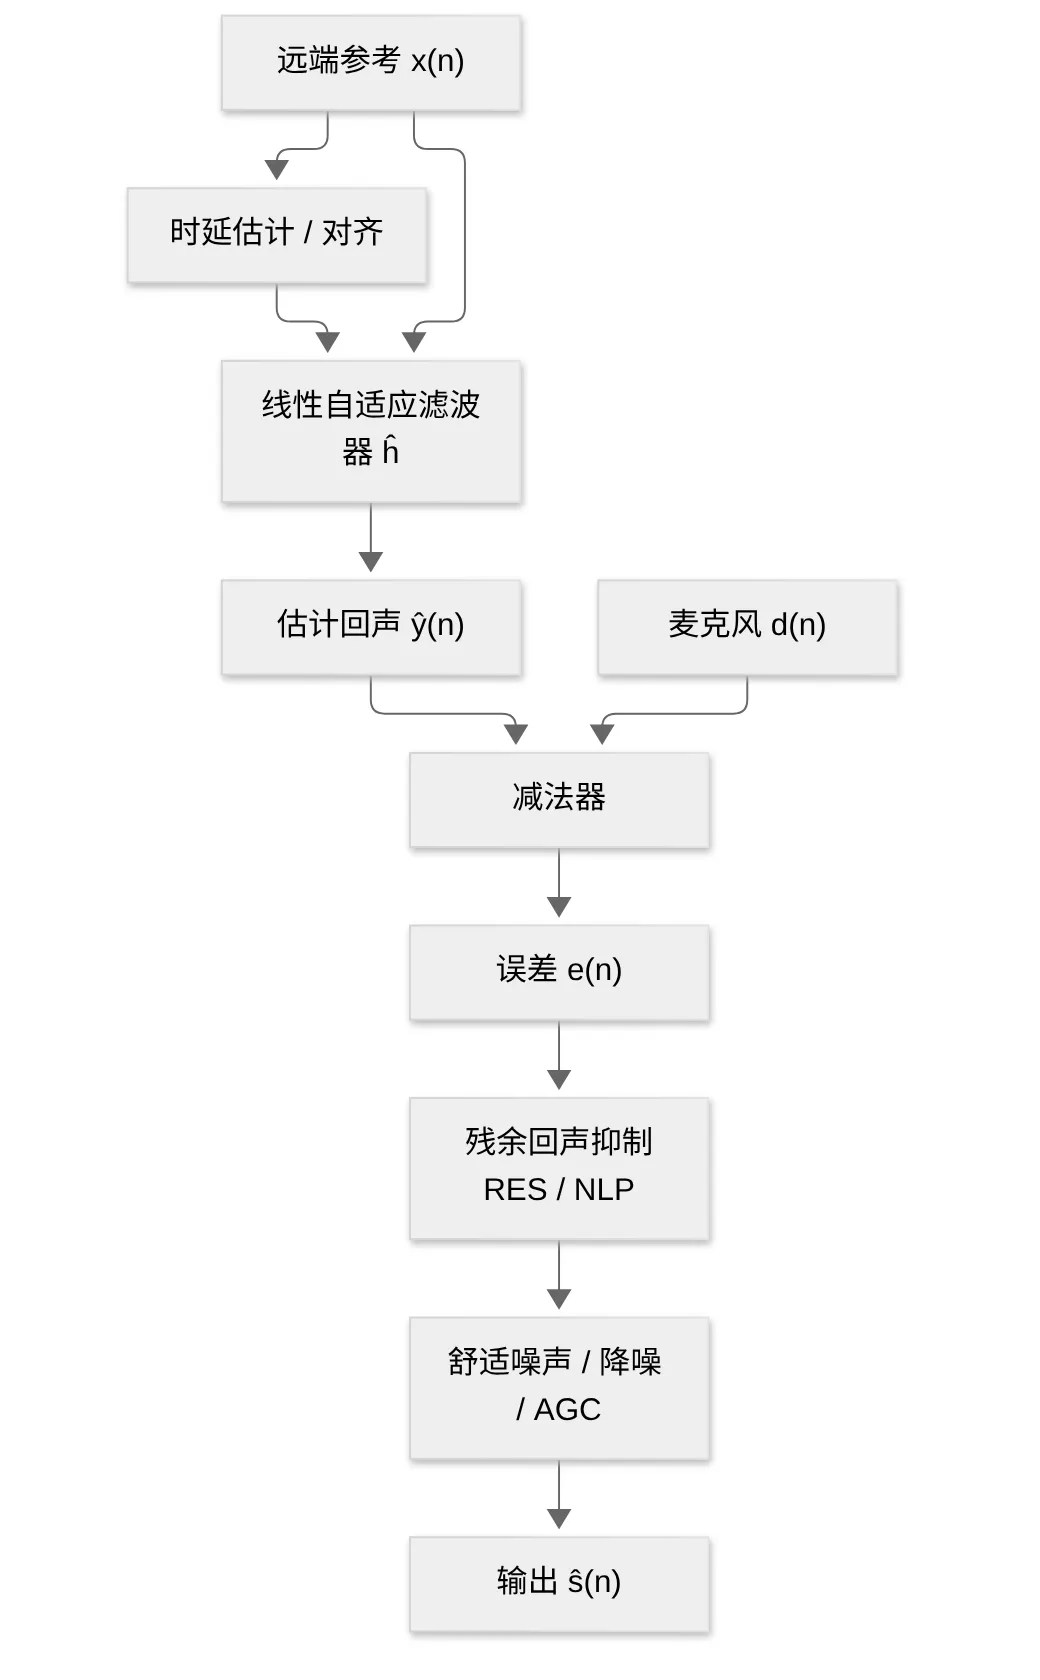
图 3 路线一:传统信号处理系统结构
一般情况下,线性级能去掉约 20–30 dB 的线性回声,剩下的残余回声和非线性回声交给残余回声抑制处理。
3.2 时延估计
互相关 / GCC-PHAT:在参考信号和麦克风信号之间搜索互相关峰值,简单可靠。
二值谱匹配:WebRTC AECM 的 delay estimator,对谱能量做二值化后匹配,计算量极低。
匹配滤波器组:WebRTC AEC3 用多个短匹配滤波器覆盖不同时延区间,选收敛最好的一个。
时延估计要持续运行,以便跟踪时延跳变。估计错误会直接导致回声泄漏。
3.3 线性自适应滤波
算法 | 特点 |
|---|
NLMS | 时域实现,结构简单;滤波器长时计算量大、收敛慢 |
IPNLMS / PNLMS | 按系数大小分配步长,稀疏回声路径下收敛更快 |
APA(仿射投影) | 对有色信号(语音)收敛比 NLMS 快,计算量更高 |
FDAF / PFDAF(MDF) | 分块频域实现,长滤波器也能以低复杂度实现,是业界主力,Speex 和 WebRTC 都用这类 |
频域 Kalman(FDKF / PFDKF) | 把回声路径看作状态,Kalman 增益自动调节步长;双讲和路径变化下更稳健,近年重视度提高 |
双路径滤波器结构 | 前景和背景两个滤波器,一快一慢,比较后择优输出,例如 AEC3 的 refined filter 和 coarse filter |
分块频域自适应滤波的基本更新式(第 k 个频点,共 P 个分块):
其中 Xk,p∗ 是参考信号频谱的共轭,ΦXX,k 是参考信号功率谱,δ 是防止除零的正则项。步长 μk 的控制方式决定了双讲稳健性和收敛速度,这也是后面“神经网络增强自适应滤波”要学习的部分。
双路径滤波器(双回声路径,Ochiai 1977)在同一对参考和麦克风上并行跑两个自适应滤波器。背景滤波器步长大,每帧按误差更新,回声路径变化时跟得快,但双讲时误差里混有近端语音,系数也容易走偏。前景滤波器负责实际抵消:只有背景滤波器的残余功率持续低于前景时,才把背景系数拷贝过来。双讲期间背景误差变大,拷贝停住,输出仍用上一次可靠的回声路径。每路内部的更新可以是 NLMS、PNLMS 或 MDF,双路径规定的是系数何时从背景拷到前景。AEC3 的 refined / coarse、MTFAA-Net 的双回声路径 PNLMS、PercepNet-AEC 的 two-echo-path 都是这个结构。
3.4 双讲检测与步长控制
硬判决式双讲检测:Geigel 算法(能量比)、基于互相关的检测器(Benesty 2000),检测到双讲就冻结滤波器更新。
连续步长控制:根据残余回声、近端语音和噪声的估计连续调节步长,没有显式双讲判决,例如 Speex 采用 Valin 2007 的可变学习率方法。
Kalman 框架:同样不需要显示双讲判决,用观测噪声协方差(包含近端语音和噪声)自然地抑制双讲期间的更新,是一种理论上更统一的做法。
3.5 非线性回声
Hammerstein 模型:无记忆非线性预处理(多项式、限幅器)加线性 FIR(Stenger & Kellermann 2000)。
Volterra 滤波:二阶或更高阶核,建模能力强,但计算量大、收敛慢。
函数链自适应滤波(FLAF):用三角函数等基函数扩展输入。
产品中通常不在线性级建模非线性,而是交给残余回声抑制,因为非线性模型参数难以稳定地在线估计。
3.6 残余回声抑制
在线性 AEC 的输出上做频域增益抑制:
Φ̂RR,k:残余回声功率谱估计,通常由估计回声乘以回声泄漏系数得到,或由 ERLE 估计推算。
ΦEE,k:线性 AEC 输出的功率谱;β 是过抑制系数;Gmin 是增益下限。
抑制越激进,残余回声越少,但双讲时越容易伤到近端语音。这是传统残余回声抑制最难调的权衡。
通常和降噪合并成一个增益函数,并配合舒适噪声生成,避免“静音洞”。
3.7 立体声与多通道 AEC
立体声参考信号高度相关,导致自适应滤波解不唯一,回声路径估计不准(Sondhi 1995)。
常见解决办法是对参考信号做去相关预处理:加入少量非线性、相位调制或互补梳状滤波。
多麦克风设备常把 AEC 和波束形成联合设计(先 AEC 后波束形成,或反之),需要权衡计算量和性能。
3.8 开源实现
WebRTC AEC3(官方)
仓库:webrtc.googlesource.com/src(https://webrtc.googlesource.com/src) modules/audio_processing/aec3
语言:C++
说明:Chrome、Meet 在用的产品级方案;依赖 WebRTC 构建系统
AEC3 独立抽取版
仓库:ewan-xu/AEC3(https://github.com/ewan-xu/AEC3)
语言:C++
说明:从 WebRTC 中抽出,可单独编译,demo.cc 直接处理 wav
AEC3 CMake 版
仓库:khomin/webrtc_aec3_qt6_cmake(https://github.com/khomin/webrtc_aec3_qt6_cmake)
语言:C++
说明:基于上面的抽取版,带 CMake 和实时 demo
PulseAudio 维护版
仓库:gitlab.freedesktop.org/pulseaudio/webrtc-audio-processing(https://gitlab.freedesktop.org/pulseaudio/webrtc-audio-processing)
语言:C++
说明:完整的音频处理模块(AEC3、降噪、AGC),meson 构建
AEC3 Python 绑定
仓库:pywebrtc-audio(https://github.com/letv-mtb/pywebrtc-audio)、RustedBytes/aec3-py(https://github.com/RustedBytes/aec3-py)
语言:Python
说明:前者可 pip install,适合批量跑基线
SpeexDSP
仓库:xiph/speexdsp(https://github.com/xiph/speexdsp)
语言:C
说明:mdf.c 是 MDF 加可变步长,preprocess.c 做残余回声抑制和降噪;代码短、支持定点,最适合嵌入式移植
pyaec
仓库:ewan-xu/pyaec(https://github.com/ewan-xu/pyaec)
语言:Python
说明:LMS、NLMS、RLS、APA、Kalman、Volterra、FLAF、FDAF、PFDAF、FDKF、PFDKF 的极简实现,适合学习
PFDKF
仓库:echocatzh/PFDKF(https://github.com/echocatzh/PFDKF)
语言:Python
说明:分块频域 Kalman 滤波,MIT 许可
3.9 方案优缺点
代表论文:[1]–[9]。
本章参考文献
[1] J. S. Soo, K. K. Pang, "Multidelay block frequency domain adaptive filter," IEEE Trans. ASSP, 1990.
[2] J. Benesty, S. L. Gay, "An improved PNLMS algorithm," ICASSP, 2002.
[3] G. Enzner, P. Vary, "Frequency-domain adaptive Kalman filter for acoustic echo control in hands-free telephones," Signal Processing, 2006.
[4] J.-M. Valin, "On adjusting the learning rate in frequency domain echo cancellation with double-talk," IEEE TASLP, 2007.
[5] H. Buchner, J. Benesty, W. Kellermann, "Generalized multichannel frequency-domain adaptive filtering," IEEE TSAP, 2005.
[6] J. Benesty, D. R. Morgan, J. H. Cho, "A new class of doubletalk detectors based on cross-correlation," IEEE TSAP, 2000.
[7] A. Stenger, W. Kellermann, "Adaptation of a memoryless preprocessor for nonlinear acoustic echo cancelling," Signal Processing, 2000.
[8] E. Hänsler, G. Schmidt, Acoustic Echo and Noise Control: A Practical Approach, Wiley, 2004.
[9] M. M. Sondhi, D. R. Morgan, J. L. Hall, "Stereophonic acoustic echo cancellation — an overview of the fundamental problem," IEEE SPL, 1995.
4. 路线二:端到端 DNN AEC
4.1 系统结构
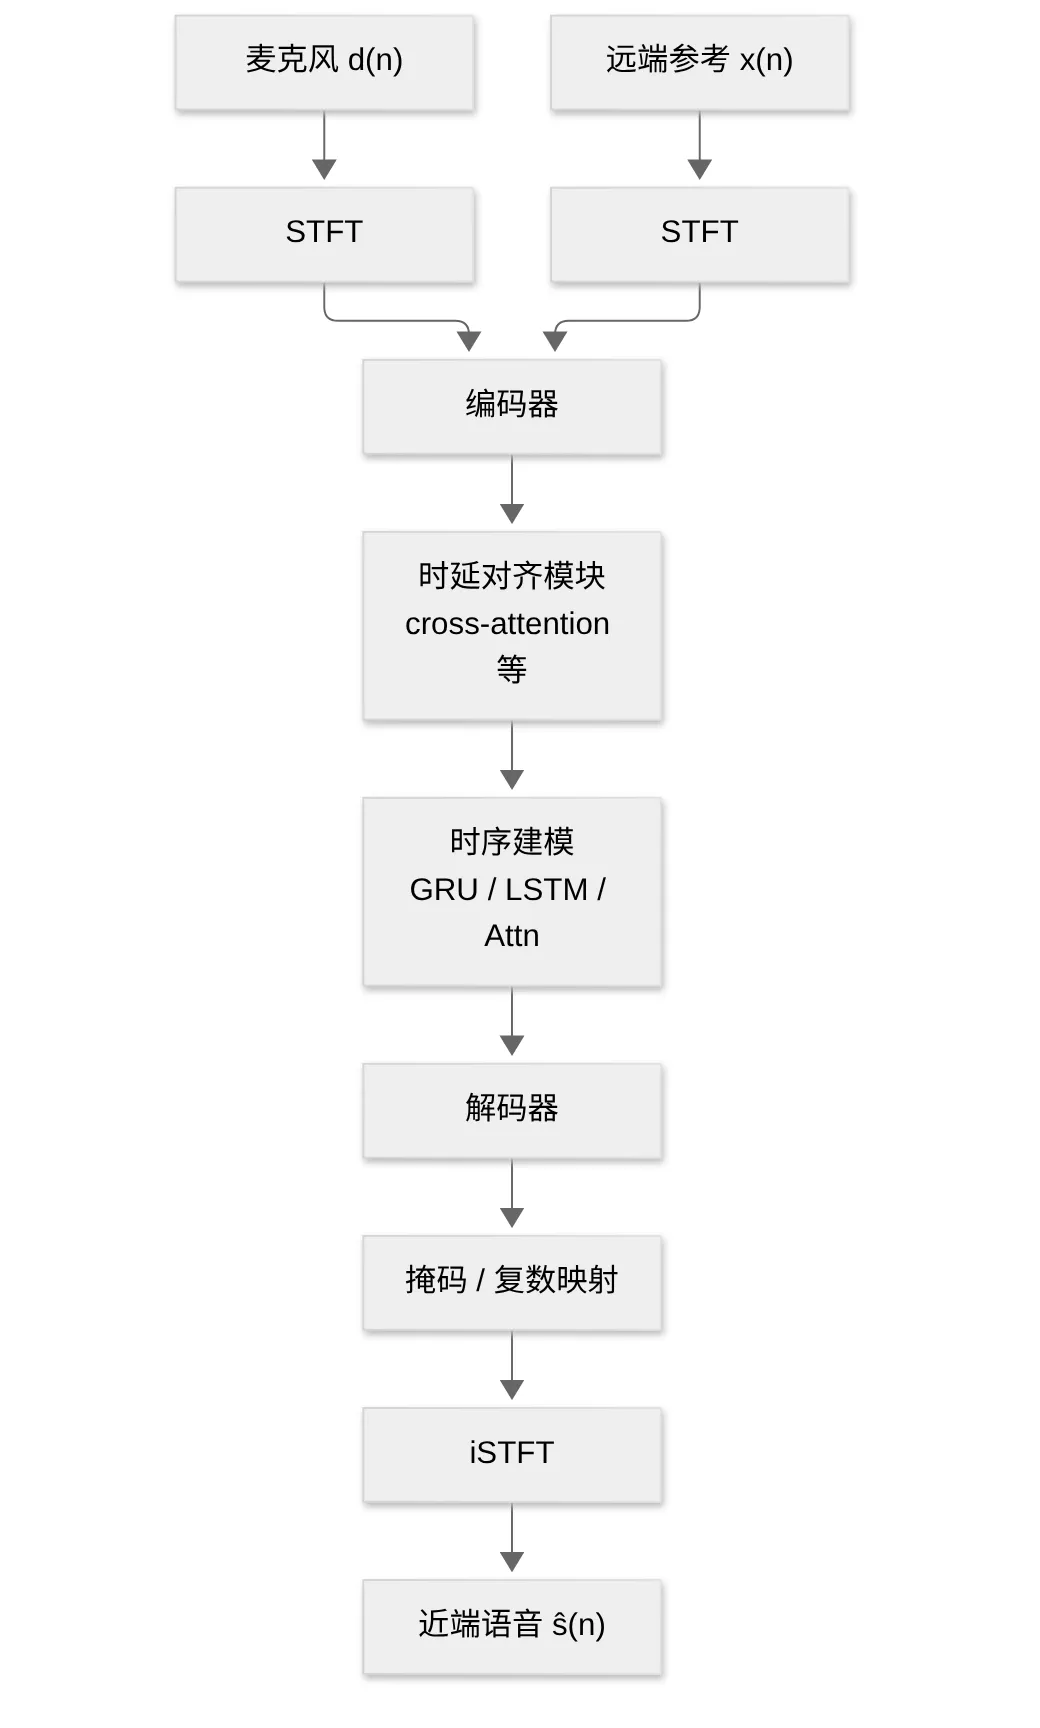
图 4 路线二:端到端 DNN AEC 系统结构
网络直接从麦克风信号和参考信号学习回声去除,不需要显式的线性自适应滤波器。大多数方案还会同时完成降噪和去混响。
4.2 关键技术:网络内时延对齐
早期端到端方案假设输入已经对齐,或依赖外部 DSP 时延估计,实际落地时容易失效。Align-CRUSE 和 DeepVQE 引入了 cross-attention 对齐模块:
分别提取麦克风特征 Q 和参考特征 K。
在 dmax 个候选时延上计算相似度,softmax 得到“软时延分布”。
用这个分布对参考特征加权求和,得到对齐后的参考特征,再和麦克风特征融合。
这相当于把 DSP 中的互相关时延估计器做成可微模块,和整个网络联合训练,可以同时保留多个时延假设,适应时延抖动。Align-CRUSE 已经部署在 Microsoft Teams 中。
4.3 代表方案
BLSTM-AEC
年份:2018
核心结构:双向 LSTM 估计掩码
参数量:—
要点:最早把 AEC 当作有监督分离问题 [10]
论文:Interspeech 2018 [10]https://www.isca-archive.org/interspeech_2018/zhang18g_interspeech.html
CRN-AEC
年份:2019
核心结构:卷积循环网络
参数量:—
要点:同时处理非线性回声和噪声 [11]
论文:Interspeech 2019 [11]https://www.isca-archive.org/interspeech_2019/zhang19o_interspeech.html
CAD-AEC
年份:2020
核心结构:上下文注意力
参数量:—
要点:用注意力建模参考和麦克风信号的关系 [12]
论文:ICASSP 2020 [12]https://ieeexplore.ieee.org/document/9053508
DTLN-aec
年份:2021
核心结构:STFT-LSTM 加学习变换-LSTM 两级
参数量:1.8M / 3.9M / 10.4M
要点:AEC Challenge 2021 第 3 名,开源 TFLite 模型 [13]
论文:ICASSP 2021 [13]https://arxiv.org/abs/2010.14337
项目:官方(仅推理,TFLite):https://github.com/breizhn/DTLN-aec社区训练复现(TF2):https://github.com/allen0125/dtln-aec
Align-CRUSE
年份:2022
核心结构:CRUSE 加 cross-attention 对齐
参数量:0.75M
要点:低复杂度、20 ms 算法时延,部署在 Teams [14]
论文:arXiv 2022 [14]https://arxiv.org/abs/2208.11308
项目:无官方代码;只有非官方对齐模块:https://github.com/lhwcv/self_attention_alignment
DeepVQE
年份:2023
核心结构:U-Net、残差块、对齐模块、子像素卷积、复数卷积掩码(CCM)
参数量:4.1M / 7.5M
要点:微软未正式提交 ICASSP AEC Challenge 2023的方案。MS-1 / MS-2 综合分 0.856 / 0.854,MS-1 高于正式第 1 名;算法延迟加缓冲延迟 20 ms [15]
论文:Interspeech 2023 [15]https://arxiv.org/abs/2306.03177
项目:均为非官方实现:https://github.com/Xiaobin-Rong/deepvqehttps://github.com/Okrio/deepvqehttps://github.com/richiejp/deepvqe-ggml
MSA-DPCRN
年份:2024
核心结构:非对称双路径 CRN + 注意力特征融合;GCC-PHAT 在网络外做时延对齐
参数量:参数量未给出;约 297 M FLOPs/s
要点:无线性 AEC。麦克风和参考频谱进网络,SFP/RFP 两路编码 [16]
论文:Interspeech 2024 [16]https://www.isca-archive.org/interspeech_2024/ni24_interspeech.html
项目:官方:https://github.com/deepnetni/msa-dpcrn
CAGCRN
年份:2025
核心结构:ERB 压缩 + 门控 CRN + CATA 软对齐 + TFAG
参数量:0.07M / 0.11 G FLOPs
要点:无线性 AEC,无传统时延估计。可学习窗长的 cross-attention 在网络内对齐麦克风和远端参考 [17]
输入:麦克风与远端参考频谱;前端无线性自适应滤波器,也无 GCC-PHAT 类时延估计
时延对齐:CATA:远端特征按可学习的整数窗长滑窗,cross-attention 对多个候选时延软加权
细节:ERB 子带压缩 → 因果门控卷积编解码 + TF-GRU;窗长 32 ms、帧移 16 ms
结果:AEC Challenge 盲测集双讲 EchoMOS 4.75
论文:Interspeech 2025 [17]https://www.isca-archive.org/interspeech_2025/wang25d_interspeech.html
项目:官方(MIT):https://github.com/Tokisywyy/AECNS-CAGCRN
JointAEC-NS
年份:2026
核心结构:3 层因果 Conv2d + 频率均值池化 + 双路单向 GRU + 逐帧门控,sigmoid 掩码乘在实部和虚部上
参数量:54.6K
要点:联合回声和降噪,无论文。16 kHz,20 ms 窗 / 10 ms 帧移,因果。掩码取值 [0, 1],只衰减、不翻转相位。单线程 CPU RTF 0.015
输入:麦克风与参考的 STFT(512 点 FFT,257 频点)在通道维拼成 4 通道;无线性 AEC
时延对齐:无。参考支路经逐帧 sigmoid 门控加到麦克风支路,不是跨时间的 cross-attention
细节:卷积 32 通道、GRU 隐藏维 32;输出头把 32 维向量线性展开为各频点实部、虚部掩码
训练:SI-SNR、复数谱 MSE、幅度 L1 加权(0.5 / 0.3 / 0.2);数据由 LibriSpeech 与 DEMAND 合成
结果:自建 50 条合成验证集:SI-SNR 14.2 dB、PESQ 1.85、STOI 0.90,ERLE 仅 1.2 dB。同表 WebRTC、RNNoise 基线 ERLE 为负、SI-SNR 约 −40 dB,不能与 AEC Challenge 结果比较
备注:频率均值池化丢失频谱细节,掩码的频率形状只由一个全连接层决定
论文:无(仅开源代码)
项目:MIT,2026 年 3 月发布:https://github.com/miuda-ai/joint_aec_ns
CGGN16(KD-AEC)
年份:2026
核心结构:卷积分组 GRU 编解码,复数掩码乘在麦克风频谱上
参数量:学生 0.2M / 0.25 G FLOPS;教师 2.4M / 12.47 G FLOPS
要点:无线性 AEC,无传统时延估计。只做回声抑制。学生经两阶段知识蒸馏,计算量约为教师的 2% [18]
输入:只有远端参考 x(n) 和麦克风 y(n)(论文图 1);无线性级,只做回声抑制、不降噪
时延对齐:无 GCC 或自适应滤波器做时延补偿
细节:过采样滤波器组,帧长 1024、帧移 128、DFT 长度 512,算法时延 40 ms;学生 CGGN16-S 取 F = 8、g = 2,教师 F = 64、g = 16
训练:先用教师输出的频域 logMSE 蒸馏,再在真值上微调
对照:表 II 中 FDKF、DLAC-Kalman 是对照基线;论文称 DLAC-Kalman 为 classical/DNN hybrid,不算进 CGGN16
代码:CGGN16.py 的 forward 在通道维拼接麦克风与远端参考 STFT,默认 output_type='mask',无 NLMS、MDF 或 Kalman
论文:arXiv 2026 [18]https://arxiv.org/abs/2608.25596
项目:官方(EC-Evaluation-Toolbox):https://github.com/ifnspaml/EC-Evaluation-Toolbox/blob/master/04_Model_Definitions/CGGN16.py
4.4 开源实现
DeepVQE
仓库:Xiaobin-Rong/deepvqe(https://github.com/Xiaobin-Rong/deepvqe)
类型:非官方 PyTorch
说明:包含对齐模块代码;预训练权重只在 DNS3 上训练了降噪,没有训练 AEC
DeepVQE
仓库:Okrio/deepvqe(https://github.com/Okrio/deepvqe)
类型:非官方 PyTorch
说明:侧重 AEC 的复现
DeepVQE
仓库:richiejp/deepvqe-ggml(https://github.com/richiejp/deepvqe-ggml)
类型:PyTorch + C++/GGML
说明:完整 8M 参数版本,有 AEC 预训练权重和 C API
LocalVQE
仓库:localai-org/LocalVQE(https://github.com/localai-org/LocalVQE)
类型:DeepVQE 派生,C++/GGML
说明:流式推理,模型从 1.3M 到 200K,另有约 49K 参数的 GTCRN-AEC 精简版;2026 年社区新项目,需要自己评测
DTLN-aec
仓库:breizhn/DTLN-aec(https://github.com/breizhn/DTLN-aec)
类型:官方(只有推理)
说明:三种规模的 TFLite 模型
DTLN-aec 训练
仓库:allen0125/dtln-aec(https://github.com/allen0125/dtln-aec)
类型:社区复现
说明:TF2 训练流程,中文文档
Align-CRUSE 对齐模块
仓库:lhwcv/self_attention_alignment(https://github.com/lhwcv/self_attention_alignment)
类型:非官方
说明:只实现了对齐模块,可以移植到自己的模型中
JointAEC-NS
仓库:miuda-ai/joint_aec_ns(https://github.com/miuda-ai/joint_aec_ns)
类型:社区
说明:54.6K 参数,因果、10 ms 帧移,带 ONNX 流式导出。无论文,自测 ERLE 约 1.2 dB
MSA-DPCRN
仓库:deepnetni/msa-dpcrn(https://github.com/deepnetni/msa-dpcrn)
类型:官方
说明:推理只做 GCC-PHAT 时延对齐,再把麦克风和参考送进 ONNX。含训练数据生成脚本,是 MSA-EchoLite 团队的前作
CAGCRN
仓库:Tokisywyy/AECNS-CAGCRN(https://github.com/Tokisywyy/AECNS-CAGCRN)
类型:官方
说明:MIT。0.07M,ERB + 网络内 CATA 软对齐,无线性 AEC。README 较简略
CGGN16
仓库:ifnspaml/EC-Evaluation-Toolbox(https://github.com/ifnspaml/EC-Evaluation-Toolbox/blob/master/04_Model_Definitions/CGGN16.py)
类型:官方
说明:04_Model_Definitions/CGGN16.py。麦克风 + 远端参考进网络,默认复数掩码。同仓库另有独立的 FDKF,不是 CGGN16 的前级
4.5 方案优缺点
本章参考文献
[10] H. Zhang, D. Wang, "Deep learning for acoustic echo cancellation in noisy and double-talk scenarios," Interspeech, 2018.https://www.isca-archive.org/interspeech_2018/zhang18g_interspeech.html
[11] H. Zhang, K. Tan, D. Wang, "Deep learning for joint acoustic echo and noise cancellation with nonlinear distortions," Interspeech, 2019.https://www.isca-archive.org/interspeech_2019/zhang19o_interspeech.html
[12] A. Fazel et al., "CAD-AEC: Context-aware deep acoustic echo cancellation," ICASSP, 2020.https://ieeexplore.ieee.org/document/9053508
[13] N. L. Westhausen, B. T. Meyer, "Acoustic echo cancellation with the dual-signal transformation LSTM network," ICASSP, 2021. arXiv:2010.14337
[14] E. Indenbom et al., "Deep model with built-in cross-attention alignment for acoustic echo cancellation," 2022. arXiv:2208.11308
[15] E. Indenbom, N.-C. Ristea, M. Chernov, R. Aichner, "DeepVQE: Real time deep voice quality enhancement for joint acoustic echo cancellation, noise suppression and dereverberation," Interspeech, 2023. arXiv:2306.03177
[16] Y. Ni, C. Pang, C. Huang, C. Zou, "MSA-DPCRN: A multi-scale asymmetric dual-path convolution recurrent network with attentional feature fusion for acoustic echo cancellation," Interspeech, 2024.https://www.isca-archive.org/interspeech_2024/ni24_interspeech.html
[17] Y. Wang, Y. Liu, J. Liu, K. Niu, Z. He, "CAGCRN: Real-time speech enhancement with a lightweight model for joint acoustic echo cancellation and noise suppression," Interspeech, 2025.https://www.isca-archive.org/interspeech_2025/wang25d_interspeech.html
[18] E. Seidel, P. Mowlaee, T. Fingscheidt, "Knowledge distillation for efficient acoustic echo control," 2026. arXiv:2608.25596
5. 路线三:线性 AEC + DNN 非线性处理
5.1 系统结构
图 5 路线三:线性 AEC + DNN 非线性处理
这条路线把两个子问题分开:
这是目前端侧产品最主流的方案。国内 RTC 厂商宣传的“AI 回声消除”,多数就是指这里的 DNN 残余回声抑制。
5.2 DNN 残余回声抑制的设计要点
输入选择:常见组合是“线性 AEC 输出 + 参考信号”,或“麦克风 + 线性 AEC 输出 + 估计回声”。估计回声 ŷ 和残余回声的相关性比原始参考信号更高,是很有效的输入。
特征域:
输出形式:实数增益或幅度掩码(简单稳健)、复数掩码或 CCM(可修正相位)、深度滤波(利用相邻帧和相邻频点)。
LAEC 作为条件信息:MTFAA-Net 不直接用线性 AEC 的输出替代麦克风信号,而是把它作为条件输入给 DNN,避免线性级自身的失真被带到输出里。
损失函数:在语音保真损失之外,加入回声感知损失(对残余回声区域加权),或者提供抑制强度可调的权衡项。
联合降噪:单模型同时做回声抑制和降噪,比两个模型级联更省算力,还能避免误差累积(ULCNet-AENR、DeepVQE-S)。
轻量化手段:频带压缩、分组 RNN、双路径建模。知识蒸馏的例子是端到端的 CGGN16,学生计算量约为教师的 2%,见第 4 节 [18]。
5.3 代表方案
PercepNet-AEC(Amazon)
年份:2021
线性滤波器:Speex MDF(AUMDF):双回声路径,Valin 2007 可变学习率,分块 PNLMS 分配各块步长
时延补偿:8 kHz 上另跑一个 400 ms 辅助 AEC,取滤波器峰值作为时延
DNN 后级处理:PercepNet(ERB 频带 + GRU + 基音梳状滤波)
参数量 / 计算量:低复杂度
要点:联合回声和降噪,适合端侧;官方未开源 [19]
论文:ICASSP 2021 [19]https://arxiv.org/abs/2102.05245
项目:官方未开源;非官方复现(未完成,只有 MDF 和特征部分):https://gitee.com/oucxlw/Hybrid-AEC-based-on-PercepNet
MTFAA-Net(百度)
年份:2022
线性滤波器:双回声路径 PNLMS
时延补偿:广义互相关(GCC)时延补偿
DNN 后级处理:多尺度时频卷积 + 轴向自注意力
参数量 / 计算量:—
要点:ICASSP 2022 AEC 和 DNS 挑战赛双第一;线性 AEC 作为条件信息 [20]
论文:ICASSP 2022 [20]https://ieeexplore.ieee.org/document/9746610
项目:非官方 PyTorch(MIT,只有网络部分):https://github.com/echocatzh/MTFAA-Net
DHF-AEC(快手)
年份:2022
线性滤波器:SpeexDSP MDF,长度 160 ms,帧长 30 ms、帧移 10 ms
时延补偿:互相关估计因果延迟并补偿
DNN 后级处理:宽带 GRU-CrossNet 与 TCN-CrossNet 融合,再接 16–48 kHz 高频网络
参数量 / 计算量:17.4M / 1.95G FLOPs;RTF 0.10
要点:ICASSP 2022 AEC Challenge 第 2 名;联合信号损失和 ASR 损失 [21]
论文:ICASSP 2022 [21]https://ieeexplore.ieee.org/document/9746272
DPT-AEC(小米)
年份:2022
线性滤波器:分块频域 Kalman 为主路,并行变步长 NLMS 构成双路径
时延补偿:用 MDF 估计时延后平移远端参考
DNN 后级处理:卷积编码器 + 双路径 Transformer,复数掩码作用于线性 AEC 输出
参数量 / 计算量:DNN 51.5M;RTF 0.33
要点:48 kHz,算法时延 40 ms。论文写明 AEC 挑战赛第 4 名 [22]
论文:ICASSP 2022 [22]https://ieeexplore.ieee.org/document/9747347
GFTNN (西工大)
年份:2022
线性滤波器:用的 wRLS,并与 MDF 对比
时延补偿:GCC-PHAT
DNN 后级处理:门控卷积 F-T-LSTM + 多任务(含 VAD)+ 回声感知损失
参数量 / 计算量:提交模型约 4.8M
要点:ICASSP 2022 AEC Challenge 第 3 名;wRLS 比 MDF 收敛更好 [23]
论文:ICASSP 2022 [23]https://arxiv.org/abs/2202.06850
ByteAudio-18(字节)
年份:2023
线性滤波器:子带 NLMS:后滤波器按动态步长自适应,前滤波器保存其稳定状态;比较两路残余能量后选误差信号
时延补偿:子带互相关,每个子带估计多个时延,投票得到最终时延后再平移参考
DNN 后级处理:两级网络逐步抑制残余回声。个性化赛道用 ECAPA-TDNN 提取说话人嵌入
参数量 / 计算量:1.48M / 1.64M,RTF 0.283 / 0.310
要点:两个赛道第 1 名。论文表 1:非个性化综合分 0.852,个性化 0.854 [24]
论文:ICASSP 2023 [24]https://ieeexplore.ieee.org/document/10096411
TCN-CorssNet(快手)
年份:2023
线性滤波器:信号处理线性 AEC,输出与近端、远端一起送入网络;本文未写具体算法
时延补偿:未写明
DNN 后级处理:宽带 TCN-CrossNet(ConvGLU、DTCM)与 GRU-CrossNet 融合,估计 0–8 kHz 掩码;高频网络用宽带掩码估计 8–24 kHz 掩码
参数量 / 计算量:32.6M;10 ms 帧在 i7 上 1.913 ms(含线性 AEC)
要点:非个性化第 2 名,综合分 0.831。48 kHz 非对称窗,算法延迟 20 ms。挑战赛总结表标成非混合 [25]
论文:低时延 DHF,ICASSP 2023 [25]https://ieeexplore.ieee.org/document/10095865
TBNN(西工大)
年份:2023
线性滤波器:子带 NLMS,估计线性回声 y 和误差 e
时延补偿:子带互相关估计时延,对齐参考
DNN 后级处理:宽带 GCRN(U² 编码器)做频谱映射;高频网络用宽带结果预测复数掩码
参数量 / 计算量:9.56M,RTF 0.35(后滤波 0.28,时延估计加自适应滤波 0.07)
要点:非个性化第 3 名,与第 2 名统计并列。总体 MOS 4.344,WAcc 0.795 [26]
论文:ICASSP 2023 [26]https://arxiv.org/abs/2303.06828
S-TFGCRN(理想汽车)
年份:2023
线性滤波器:NLMS,估计线性回声 y,滤波器输出为误差 e
时延补偿:GCC-PHAT
DNN 后级处理:PQMF 分成 4 个子带;辅助双路 VAD 和回声估计,推理时可去掉
参数量 / 计算量:3.83M,RTF 0.1983
要点:非个性化第 4 名。窗长 20 ms、帧移 10 ms。总体 MOS 4.320,WAcc 0.790 [27]
论文:ICASSP 2023 [27]https://arxiv.org/abs/2303.06404
TaylorAECNet
年份:2023
线性滤波器:分块频域 Kalman(PFDKF),用对齐后的参考和麦克风得到误差 e
时延补偿:GCC-PHAT
DNN 后级处理:Taylor 展开式全带后滤波,门控相位编码、时频卷积、VAD、回声加权损失
参数量 / 计算量:19.18M,RTF 0.224
要点:非个性化第 5 名。总体 MOS 4.241,WAcc 0.767,综合分 0.803。挑战赛总结表把 Hybrid 标成否 [28]
论文:ICASSP 2023 [28]https://arxiv.org/abs/2303.06379
ULCNet-AENR
年份:2024
线性滤波器:对角化分块频域 Kalman(10 段)
时延补偿:未单列,时延含在分块 Kalman 内;训练去掉时延超过 1.5 s 的样本
DNN 后级处理:超低复杂度网络,联合回声和降噪
参数量 / 计算量:参数量约为同类 SOTA 的 1/10,计算量约为 1/4
要点:线性 Kalman 滤波 + 轻量网络 [29]
论文:arXiv 2024 [29]https://arxiv.org/abs/2408.15746
项目:暂无公开代码
EchoFree
年份:2025
线性滤波器:分块频域 Kalman(PFDKF,10 段,FFT 256)
时延补偿:未单列,时延由滤波器长度覆盖
DNN 后级处理:Bark 域 U-Net 后滤波 + 自监督模型两阶段训练
参数量 / 计算量:278K / 30 MMACs
要点:接近 DeepVQE-S 的效果 [30]
论文:arXiv 2025 [30]https://arxiv.org/abs/2508.06271
项目:暂无公开代码;demo 页:https://echofree2025.github.io/EchoFree-demo/
MSA-EchoLite
年份:2026
线性滤波器:PFDAF(分块频域自适应滤波)
时延补偿:未单列,由 PFDAF 得到对齐后的线性回声估计
DNN 后级处理:Bark 域非对称双分支编码器 + 回声感知调制模块
参数量 / 计算量:0.2M / 约 100 M FLOPs/s
要点:在紧凑的隐空间里建模麦克风和回声特征的差异与相关性 [31]
论文:arXiv 2026 [31]https://arxiv.org/abs/2608.03650
项目:暂无公开代码
ICASSP 2023 AEC Challenge 非个性化赛道要求 48 kHz,算法延迟加缓冲延迟不超过 20 ms,正式前五名都属于线性滤波加神经网络,快手低时延 DHF的方案在挑战赛总结表中标为非混合,但论文第 2.2 节写明网络输入包含信号处理线性 AEC 的输出。第 2、3 名统计上并列,官方以更低的实时率把快手排在第 2,具体排名见 [41]。算法 RTF 实时性的考量是PC上运行,没有强制约束特定的端侧芯片型号,因此 AEC 比赛的模型方案目标是追求客观性能指标,对于计算量的限制不大。
5.4 开源实现
MTFAA-Net
仓库:echocatzh/MTFAA-Net(https://github.com/echocatzh/MTFAA-Net)
类型:非官方 PyTorch
说明:MIT 许可,只有网络部分,线性 AEC 要自己接
PercepNet-AEC 复现
仓库:gitee: oucxlw/Hybrid-AEC-based-on-PercepNet(https://gitee.com/oucxlw/Hybrid-AEC-based-on-PercepNet)
类型:非官方(未完成)
说明:复现 5.3 的 PercepNet-AEC [19],只完成了 MDF 和特征部分
EchoFree(只有 demo 页(https://echofree2025.github.io/EchoFree-demo/))、ULCNet-AENR、MSA-EchoLite、PercepNet-AEC 目前没有公开代码。
5.5 进阶方向:神经网络增强的线性自适应滤波
5.5.1 动机
第三条路线的瓶颈之一在线性级本身。传统自适应滤波器的步长或 Kalman 协方差依赖手工设计的估计器,在双讲、回声路径突变、低信噪比时容易出现:
一旦线性级出问题,后级 DNN 要处理的残余回声会大幅增加,甚至需要承担本该由线性级完成的工作。
进阶思路是:保留线性自适应滤波的结构(可解释、泛化好、计算量极低),只用一个很小的网络替代其中手工设计的“控制部分”,例如步长、Kalman 增益或整个更新规则。
5.5.2 方案结构
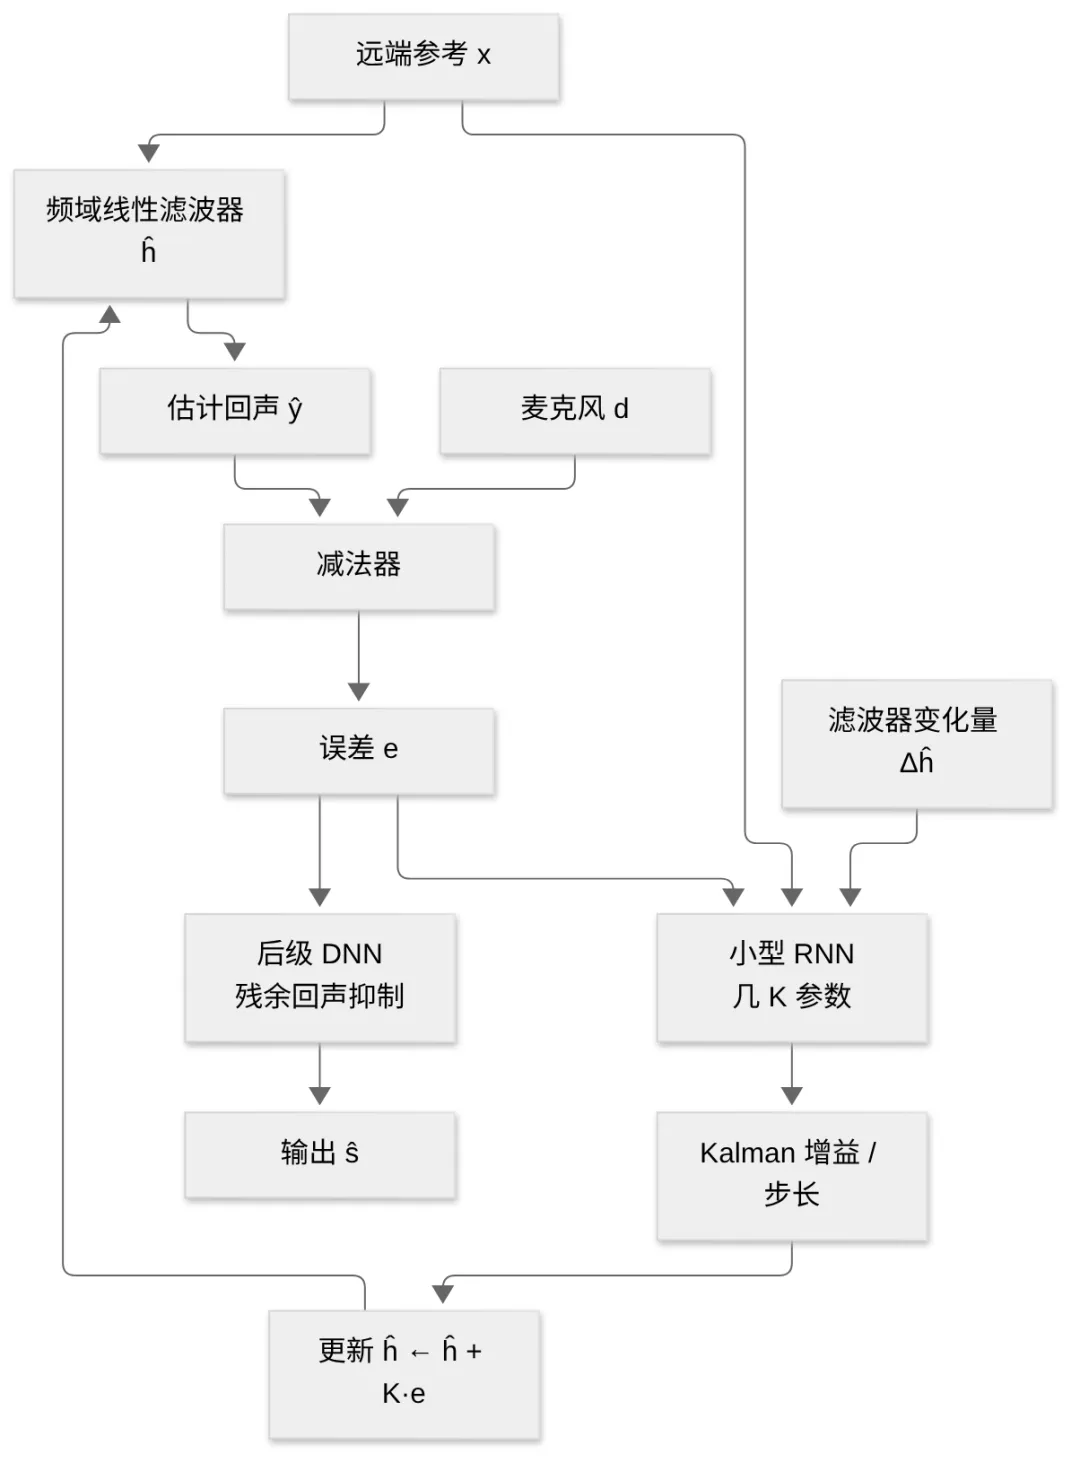
图 6 神经网络增强的线性自适应滤波
两级可以分开训练,也可以端到端联合训练。
5.5.3 代表方案
DNN 控制步长的 FDAF
年份:2022
思路:用 DNN 估计频域自适应滤波的步长 / 自适应控制量,端到端训练
规模:约 M 级
说明:Haubner & Kellermann [32],后续扩展到 AEC、波束形成和后滤波的联合控制 [33]
论文:ICASSP 2022 [32]https://arxiv.org/abs/2106.01262EUSIPCO 2022 [33]https://arxiv.org/abs/2203.01793
Meta-AF(Adobe/UIUC)
年份:2022–2023
思路:元学习:用 GRU 直接学出自适应滤波器的更新规则,可用于 AEC、均衡、WPE 去混响、GSC 波束形成
规模:小型 GRU
说明:在 AEC 上优于调好参数的 NLMS、RLS、Kalman 和 Speex 基线 [34][35]
论文:IEEE TASLP 2023 [34]https://arxiv.org/abs/2204.11942IWAENC 2022 [35]https://arxiv.org/abs/2209.09955
项目:官方(JAX,release 含训练好的权重):https://github.com/adobe-research/MetaAF
NKF(Neural Kalman Filter)
年份:2023
思路:在时频域逐频点运行 Kalman 滤波,用复数 GRU 隐式建模状态噪声和观测噪声协方差,直接输出 Kalman 增益
规模:5.3K 参数,RTF 0.09
说明:收敛和重新收敛明显快于传统 Kalman 和 Meta-AF,近端语音失真小;只处理线性回声,时延大时需要先做时延补偿 [36]
论文:ICASSP 2023 [36]https://arxiv.org/abs/2207.11388
项目:官方:https://github.com/fjiang9/NKF-AEC社区 C++ 流式移植(ONNX):https://github.com/William1617/REAL_TIME_NKF_AEC
NKF 的核心更新(第 k 个频点、第 m 帧,滤波器阶数为 L):
其中 xm,k 是最近 L 帧的参考信号频谱,Ym,k 是麦克风频谱,Δĥm−1,k 是上一次滤波器的变化量,KGNet 是输出 Kalman 增益的小型复数 GRU 网络。
所有频点共享同一个小网络,所以参数量只有几 K,但 RNN 需要在每个频点上逐帧运行。
5.5.4 开源实现
NKF-AEC(官方)
仓库:fjiang9/NKF-AEC(https://github.com/fjiang9/NKF-AEC)
说明:论文 [36] 的官方实现。L = 4,16 kHz。python nkf.py -x ref.wav -y mic.wav -o res.wav;时延大时加 -a,用 GCC-PHAT 先对齐
NKF C++ 实时版
仓库:William1617/REAL_TIME_NKF_AEC(https://github.com/William1617/REAL_TIME_NKF_AEC)
说明:同一篇论文 [36] 的社区流式移植:把官方 NKF 简化成 ONNX,再用 C++ 推理。不是另一套算法
Meta-AF(官方)
仓库:adobe-research/MetaAF(https://github.com/adobe-research/MetaAF)
说明:JAX 实现,zoo/aec 包含训练、评测、Kalman 和 Speex 基线,release 里有训练好的权重
5.5.5 在整体方案中的定位
它不能单独构成完整的 AEC,因为只处理线性回声,仍然需要后级 DNN(或传统残余回声抑制)处理残余和非线性回声。
它是对第三条路线中“线性级”的升级:计算量几乎不增加,但能提高双讲稳健性和重新收敛速度,从而减轻后级 DNN 的负担。
推荐的进阶组合:时延估计 + NKF(或 PFDKF)+ 轻量 DNN 残余回声抑制和降噪。
5.6 方案优缺点
优点:
缺点:
系统复杂度高于单一模型,需要维护时延估计、线性滤波、DNN 三个模块。
线性级发散或时延估计错误时,DNN 也难以补救(引入神经网络增强自适应滤波或网络内对齐可以缓解)。
DNN 训练数据需要经过线性级处理后生成,数据流水线更复杂。
本章参考文献
[18] E. Seidel, P. Mowlaee, T. Fingscheidt, "Knowledge distillation for efficient acoustic echo control," 2026. arXiv:2608.25596
[19] J.-M. Valin et al., "Low-complexity, real-time joint neural echo control and speech enhancement based on PercepNet," ICASSP, 2021. arXiv:2102.05245
[20] G. Zhang et al., "Multi-scale temporal frequency convolutional network with axial attention for speech enhancement," ICASSP, 2022.https://ieeexplore.ieee.org/document/9746610
[21] H. Zhao, N. Li, R. Han, L. Chen, X. Zheng, C. Zhang, L. Guo, B. Yu, "A deep hierarchical fusion network for fullband acoustic echo cancellation," ICASSP, 2022.https://ieeexplore.ieee.org/document/9746272
[22] X. Sun, C. Cao, Q. Li, L. Wang, F. Xiang, "Explore relative and context information with transformer for joint acoustic echo cancellation and speech enhancement," ICASSP, 2022.https://ieeexplore.ieee.org/document/9747347
[23] S. Zhang et al., "Multi-task deep residual echo suppression with echo-aware loss," ICASSP, 2022.https://arxiv.org/abs/2202.06850
[24] Z. Chen, X. Xia, S. Sun, Z. Wang, C. Chen, G. Xie, P. Zhang, Y. Xiao, "A progressive neural network for acoustic echo cancellation," ICASSP, 2023.https://ieeexplore.ieee.org/document/10096411
[25] H. Zhao, N. Li, R. Han, X. Zheng, C. Zhang, L. Guo, B. Yu, "A low-latency deep hierarchical fusion network for fullband acoustic echo cancellation," ICASSP, 2023.https://ieeexplore.ieee.org/document/10095865
[26] Z. Zhang, S. Zhang, M. Liu, Y. Leng, Z. Han, L. Chen, L. Xie, "Two-step band-split neural network approach for full-band residual echo suppression," ICASSP, 2023. arXiv:2303.06828
[27] J. Sun, D. Luo, Z. Li, J. Li, Y. Ju, Y. Li, "Multi-task sub-band network for deep residual echo suppression," ICASSP, 2023. arXiv:2303.06404
[28] W. Xu, Z. Guo, "TaylorAECNet: A Taylor style neural network for full-band echo cancellation," ICASSP, 2023. arXiv:2303.06379
[29] "A hybrid approach for low-complexity joint acoustic echo and noise reduction," 2024. arXiv:2408.15746
[30] "EchoFree: Towards ultra lightweight and efficient neural acoustic echo cancellation," 2025. arXiv:2508.06271
[31] "Echo-aware modulation for compact-latent frequency-time modeling in lightweight acoustic echo cancellation (MSA-EchoLite)," 2026. arXiv:2608.03650
[32] T. Haubner, W. Kellermann, "End-to-end deep learning-based adaptation control for frequency-domain adaptive system identification," ICASSP, 2022.https://arxiv.org/abs/2106.01262
[33] T. Haubner, W. Kellermann, "Deep learning-based joint control of acoustic echo cancellation, beamforming and postfiltering," EUSIPCO, 2022.https://arxiv.org/abs/2203.01793
[34] J. Casebeer, N. J. Bryan, P. Smaragdis, "Meta-AF: Meta-learning for adaptive filters," IEEE TASLP, 2023. arXiv:2204.11942
[35] J. Wu, J. Casebeer, N. J. Bryan, P. Smaragdis, "Meta-learning for adaptive filters with higher-order frequency dependencies," IWAENC, 2022.https://arxiv.org/abs/2209.09955
[36] D. Yang, F. Jiang, W. Wu, X. Fang, M. Cao, "Low-complexity acoustic echo cancellation with neural Kalman filtering," ICASSP, 2023. arXiv:2207.11388
[41] R. Cutler et al., "ICASSP 2023 acoustic echo cancellation challenge," 2023. arXiv:2309.12553
6. 数据集与评测
6.1 数据集
Microsoft AEC Challenge
链接:microsoft/AEC-Challenge(https://github.com/microsoft/AEC-Challenge)
说明:事实上的标准基准。包含 1 万多台真实设备的录音、合成训练集、历届盲测集(ICASSP 2021/2022/2023、Interspeech 2021),并提供全频带数据
DNS Challenge
链接:microsoft/DNS-Challenge(https://github.com/microsoft/DNS-Challenge)
说明:近端干净语音和噪声来源,常用于合成近端信号
RIR 数据集
链接:OpenSLR RIR、自录 RIR
说明:用于合成回声路径
测试场景按 AEC Challenge 的惯例分为:远端单讲(FEST,只有回声)、近端单讲(NEST,只有近端语音)、双讲(DT)。
6.2 评测指标
EchoMOS(AECMOS)
适用场景:远端单讲、双讲
含义:残余回声的主观烦扰程度,1–5 分,5 分表示听不到回声
DegMOS / Other MOS(AECMOS)
适用场景:近端单讲、双讲
含义:回声以外的劣化(近端语音被抑制、失真、伪影、残留噪声),1–5 分
ERLE
适用场景:远端单讲
含义:回声返回损耗增强,10 log10(E[d2] / E[ŝ2]),衡量回声消得多干净
PESQ / STOI / SI-SDR
适用场景:双讲、近端单讲(需要干净参考)
含义:近端语音质量和可懂度
收敛时间 / 重新收敛时间
适用场景:回声路径突变测试
含义:线性级的动态性能
WAcc / WER
适用场景:双讲、近端单讲
含义:对语音识别的影响,AEC Challenge 2023 起纳入最终评分
AECMOS 是无参考指标,输入只需要麦克风信号、参考信号和处理后的输出,因此可以用在没有干净标签的真实录音盲测集上。ONNX 模型和本地推理脚本在 AEC-Challenge/AECMOS(https://github.com/microsoft/AEC-Challenge/tree/main/AECMOS) 中 [37]。
6.3 评测工具
AECMOS
链接:microsoft/AEC-Challenge/AECMOS(https://github.com/microsoft/AEC-Challenge/tree/main/AECMOS)
说明:EchoMOS / DegMOS 本地 ONNX 推理
EC-Evaluation-Toolbox
链接:ifnspaml/EC-Evaluation-Toolbox(https://github.com/ifnspaml/EC-Evaluation-Toolbox)
说明:TU Braunschweig 出品(MATLAB),覆盖收敛过程、回声路径突变、强非线性、时延等测试条件,提供 PESQ-BB、ERLE-BB 等指标 [38]
aec-evaluation
链接:gdalsanto/aec-evaluation(https://github.com/gdalsanto/aec-evaluation)
说明:Python 封装的 PESQ、STOI、ERLE 等指标
6.4 行业相关标准
本章参考文献
[37] M. Purin, S. Sootla, M. Sponza, A. Saabas, R. Cutler, "AECMOS: A speech quality assessment metric for echo impairment," ICASSP, 2022. arXiv:2110.03010
[38] E. Seidel, P. Mowlaee, T. Fingscheidt, "Convergence and performance analysis of classical, hybrid, and deep acoustic echo control," 2024(EC-Evaluation-Toolbox).
[39] K. Sridhar et al., "ICASSP 2021 acoustic echo cancellation challenge: Datasets, testing framework, and results," ICASSP, 2021. arXiv:2009.04972
[40] R. Cutler et al., "ICASSP 2022 acoustic echo cancellation challenge," ICASSP, 2022. arXiv:2202.13290
7. 业界落地方案
WebRTC AEC3(Google)
所属路线:传统信号处理
架构:匹配滤波时延估计 + 双滤波器 PFDAF + 基于 ERLE 的残余回声抑制
说明:开源里最成熟,Chrome、Meet 和大量 RTC 厂商都以它为基础
WebRTC AECM
所属路线:传统信号处理
架构:定点、低复杂度移动端方案
说明:已基本被 AEC3 取代
SpeexDSP
所属路线:传统信号处理
架构:MDF + 可变步长 + 残余回声抑制
说明:轻量易移植,嵌入式常用
Apple VPIO / Android AcousticEchoCanceler
所属路线:传统信号处理为主
架构:系统级 / 硬件级
说明:Android 各厂商效果差异大,RTC 厂商通常自带 AEC
Microsoft Teams
所属路线:端到端 DNN
架构:Align-CRUSE / DeepVQE 系列
说明:PC 和云端算力充足
高通 Fluence 等 DSP 厂商
所属路线:混合
架构:线性 AEC + 残余回声抑制 + 降噪 + 波束形成
说明:耳机、车载、IoT
国内 RTC 厂商(声网、腾讯、字节火山等)
所属路线:混合
架构:AEC3 类线性级 + 自研 AI 残余回声抑制和降噪
说明:“AI 回声消除”多数指 DNN 残余回声抑制这一级
8. 端侧选型建议
8.1 按资源选型
资源档位 | 推荐方案 |
|---|
MCU / 低端 DSP(< 10MMAC/s) | SpeexDSP MDF 或 PFDKF + 规则式残余回声抑制 |
中端 DSP(30–100 MMAC/s) | PFDKF 或 NKF + 轻量 DNN 残余回声抑制和降噪(参考 EchoFree 的规模);同档也可以直接用 CAGCRN 这类 0.07M 的端到端模型 |
手机 SoC(100–300 MMAC/s) | 线性 AEC + MTFAA / DeepVQE-S 级别的 DNN,或 MSA-DPCRN 这类带外部时延对齐的端到端模型 |
PC / 云端 | DeepVQE 等端到端方案 |
8.2 推荐落地路线
建立基线:在 AEC Challenge 数据和自有录音上跑 SpeexDSP、AEC3(pywebrtc-audio)、NKF-AEC,用 AECMOS + ERLE 评测,摸清线性和传统方案的上限。
线性级选型:嵌入式优先 SpeexDSP MDF 或 PFDKF;需要更好的收敛和双讲稳健性时换成 NKF(约 5K 参数,几乎不增加算力)。
DNN 残余回声抑制:以 EchoFree 或 LocalVQE 的 GTCRN-AEC 精简版为起点,在现有 GTCRN 降噪结构上增加参考信号和估计回声作为输入通道,扩展成联合回声消除和降噪的模型。CAGCRN、JointAEC-NS 属于端到端方案,见第 4 节,不作为这一级的起点。
上限参考:用 deepvqe-ggml 的预训练权重评估大模型效果,确定轻量模型需要多大容量;必要时用知识蒸馏把大模型能力迁移到小模型。
8.3 K 歌场景的特殊考虑
参考信号是伴奏音乐:频谱宽、能量持续,线性滤波器收敛条件比语音参考好,但系统始终处于“远端有信号”的状态。
双讲几乎一直存在:用户在伴奏播放时持续演唱,残余回声抑制必须偏保守,否则歌声会被吃掉;DegMOS 类指标比 EchoMOS 更关键。
近端是歌声:基频高、动态范围大、谐波丰富。用语音数据训练的残余回声抑制容易把歌声高次谐波误判成回声,训练数据中需要加入歌声。
外放非线性明显:推荐“FDKF / NKF 线性级 + 轻量 DNN 残余回声抑制”的混合方案。
伴奏参考通常可以精确获取(由 App 自己播放),时延相对稳定,可以用较强的时延先验简化对齐模块。