Fluent仿真核数越多越快吗?新手如何选择合适的CPU核数?
- 更新时间 2026-10-18 07:37:16
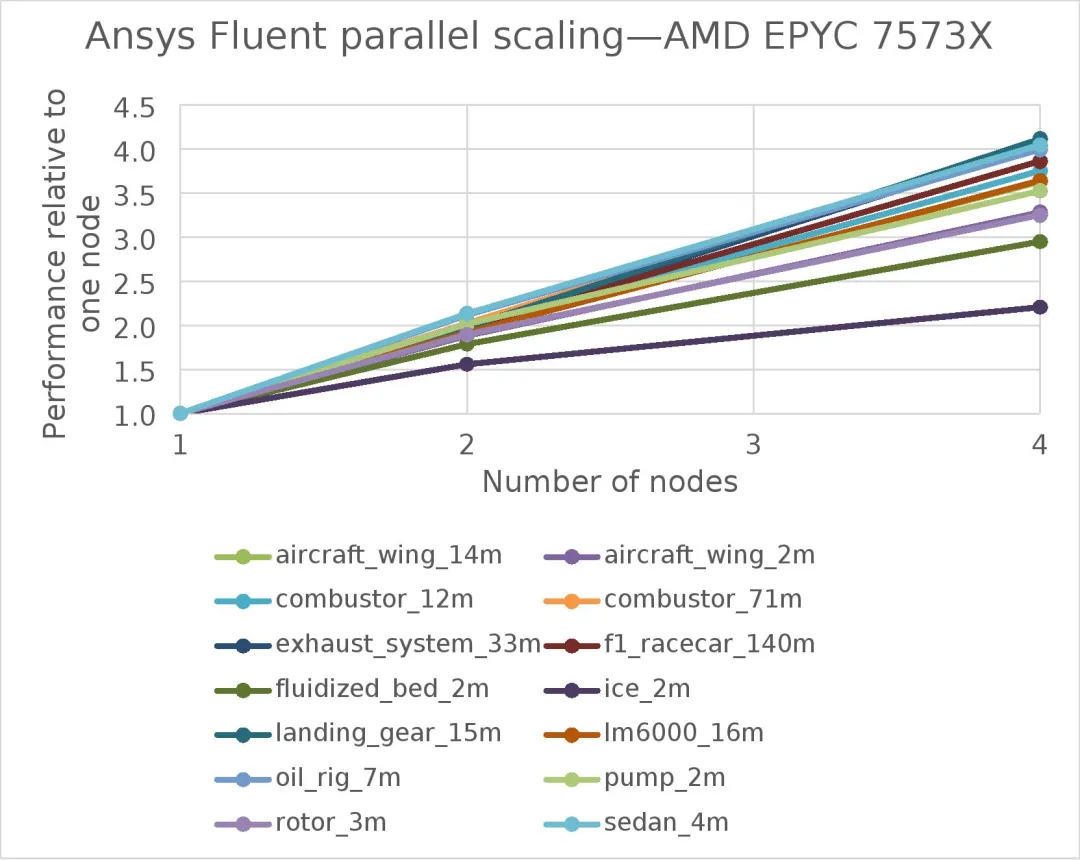
在使用ANSYS Fluent进行流体仿真时,计算速度往往是新手最关心的问题之一。尤其是面对几百万甚至上千万网格的模型,求解过程可能需要数小时甚至数天。为了缩短计算时间,不少人会选择增加CPU核数,认为核数越多,仿真速度就越快。然而,实际计算中经常出现这样的现象:使用16核运行的速度可能比8核快不了多少,甚至使用32核还不如16核。为什么会出现这种情况?对于Fluent新手而言,究竟应该如何选择合适的CPU核数?
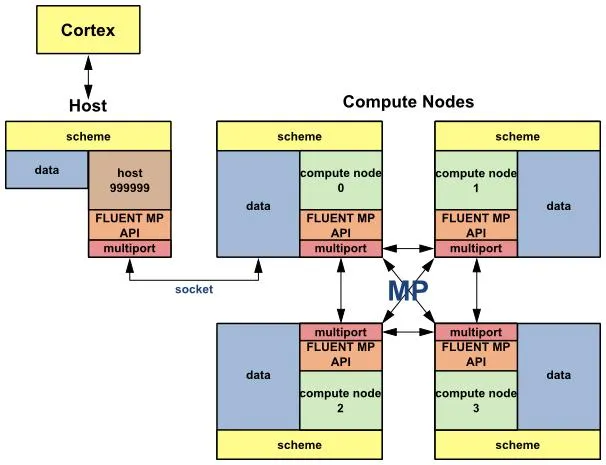
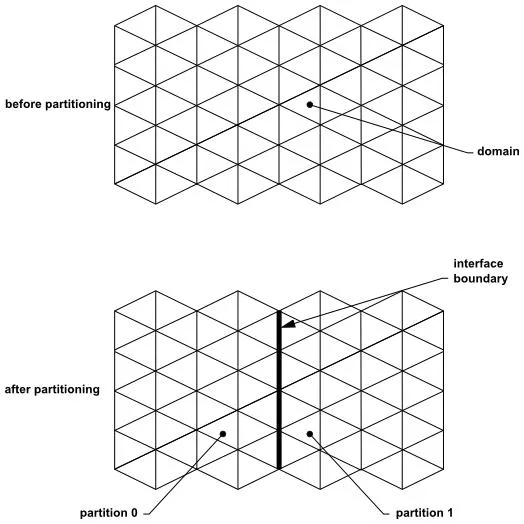
为什么增加CPU核数不一定能提高计算速度? 01 Fluent支持并行计算,其基本原理是将整个计算区域划分为多个网格分区,再由不同的CPU计算进程分别处理。
例如,一个包含200万个网格单元的模型,如果使用8核并行计算,理想情况下,每个计算进程大约负责25万个网格单元。
这种方式能够让多个计算进程同时工作,从而缩短计算时间。
但是,并行计算并不是简单地把任务平均分配出去。不同计算进程之间还需要不断交换数据,特别是在计算压力、速度和温度等物理量时,相邻网格分区之间必须进行信息传递。
随着CPU核数增加,每个进程承担的计算量逐渐减少,但数据通信、同步等待和分区管理带来的额外开销可能增加。
当通信开销抵消了增加核数带来的收益时,并行计算效率就会下降。
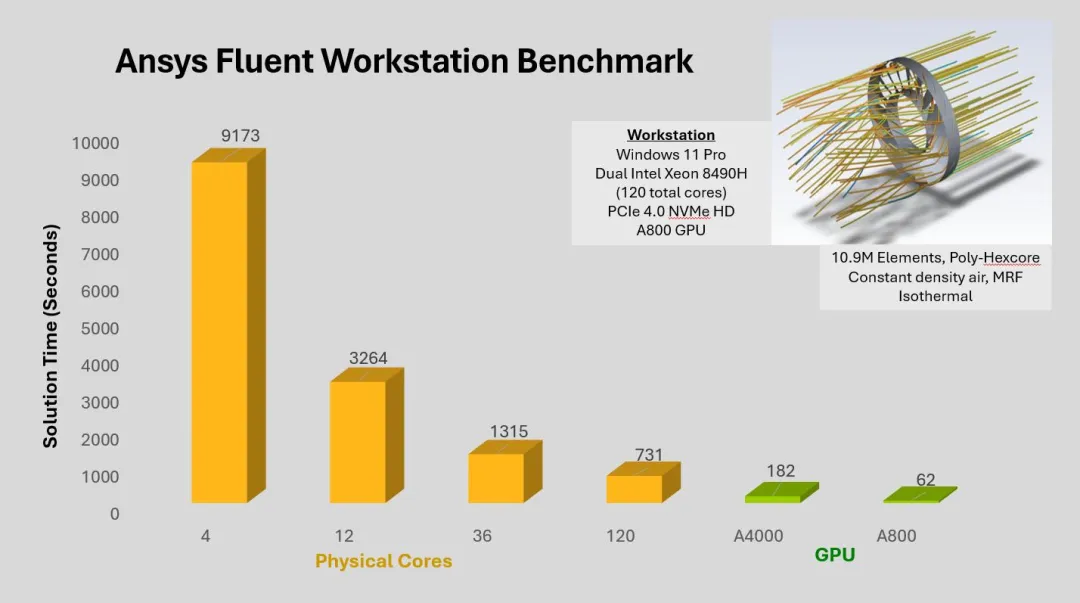
因此,Fluent并行计算存在收益递减现象,核数越多并不意味着计算一定越快。 Ansys官方文档也明确指出,计算进程增加到一定程度后,通信与计算的比例会增大,导致并行效率降低。
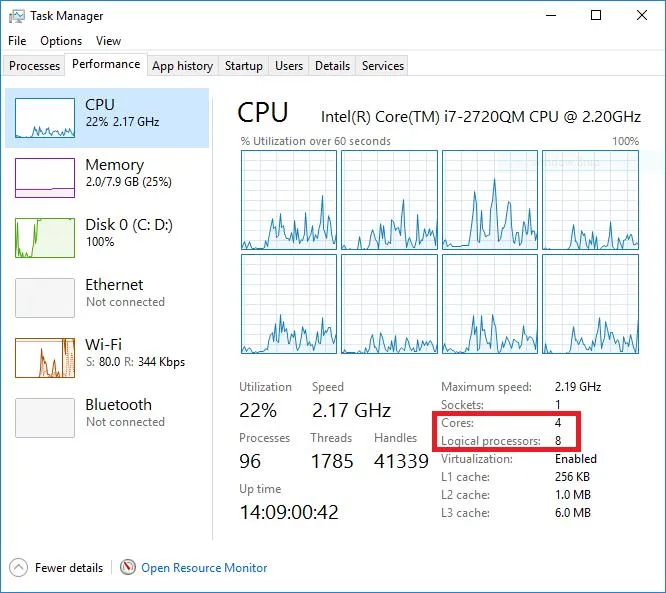
首先弄清楚物理核心与逻辑处理器的区别 02 选择CPU核数之前,需要了解计算机实际拥有多少物理核心。
例如,某台工作站搭载一颗8核心16线程的处理器。在Windows任务管理器中,通常可以看到:内核:8;逻辑处理器:16,其中,8代表物理核心数量,16代表启用超线程技术后操作系统识别的逻辑处理器数量。
需要注意,16个逻辑处理器并不等于16个独立的物理核心。
超线程技术能够提高部分程序的硬件资源利用率,但对于Fluent这类计算密集型软件,额外逻辑线程带来的性能提升往往有限。
Ansys的HPC许可文档指出,超线程核心通常只能带来很小的加速,甚至没有明显收益,因此不建议单纯依靠超线程增加Fluent并行核数。
对于新手而言,建议首先以物理核心数量作为并行计算的主要参考。例如,使用8核心16线程的处理器时,可以优先测试4核、6核和8核的求解性能,而不是直接选择16核。
根据网格数量初步选择CPU核数 03 网格数量是影响Fluent并行效率的重要因素之一。一般而言,网格规模越大,能够有效利用的CPU核数通常也越多。
如果网格数量较少,却分配了大量计算核心,就会导致每个进程承担的网格单元过少,通信开销占比明显增加。
在常规CPU并行求解中,可以暂时按照每核约10万至20万个网格单元进行初步估算。这只是用于确定测试范围的经验起点,并非Fluent对所有模型的统一要求。
例如,针对常规单相流动问题,可以参考以下测试方案:
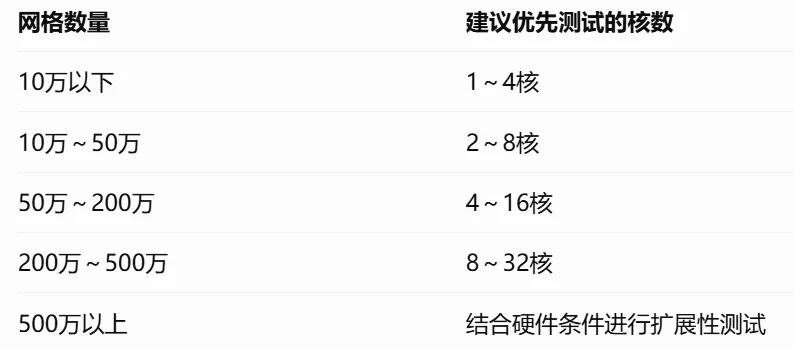
需要强调的是,上表仅用于确定性能测试范围,并不意味着这些核数一定最优,也不代表必须配置相应数量的CPU核心。
例如,同样是200万个网格,普通管道流动模型和复杂的多相流模型,其计算负载可能存在明显差异。
对于涉及组分输运、燃烧、离散相或者复杂湍流模型的仿真,每个网格单元需要完成的计算任务更多,因此可能具有不同的并行扩展特性。
网格数量只能用于初步估算核数,真正合理的核数仍然需要通过计算测试确定。
CPU性能和内存同样影响计算速度 04 Fluent的求解速度不仅取决于CPU核数,还受到CPU主频、缓存、内存容量以及内存带宽等因素的影响。
首先是CPU主频。对于规模较小、并行效率不高的模型,单核计算性能较强的CPU可能具有明显优势。某些情况下,高主频的8核处理器可能比低主频的16核处理器表现更好。
其次是内存容量。Fluent需要在内存中存储网格、流场变量以及求解过程中产生的各种数据。当内存不足时,操作系统可能频繁使用磁盘交换空间,造成计算速度大幅下降。
另外,内存带宽也是容易被忽略的因素。随着并行核心增加,多个计算进程会同时访问内存。如果内存带宽已经成为性能瓶颈,即使继续增加CPU核数,也很难实现明显加速。
Ansys官方硬件建议同样强调,不能只关注处理器核心数量,而忽略内存带宽与内存配置。
因此,如果计算机同时承担建模、网格划分及后处理等任务,可以适当预留部分CPU和内存资源,避免多个程序相互争夺硬件资源。
如何通过实际测试找到最优核数? 05 对于Fluent新手,最可靠的方法并不是直接套用某个固定核数,而是针对自己的模型开展简单的并行性能测试。
假设某个模型包含200万个网格单元,计算机配备16个物理核心,可以分别采用4核、8核、12核和16核进行测试。具体操作如下:
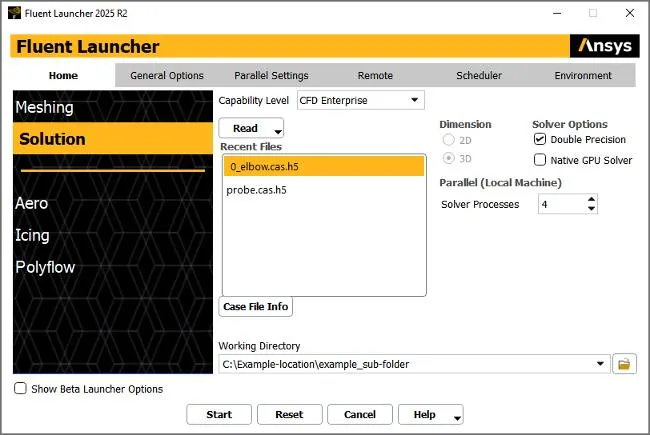
首先,在Fluent启动界面选择并行计算,并在 Solver Processes 中设置需要使用的求解进程数量。
随后,使用完全相同的网格、物理模型、离散格式和求解设置进行计算。
对于稳态仿真,可以在相同初始条件下分别运行100步或200步迭代,记录实际耗时。
对于瞬态仿真,则建议采用相同的时间步长和时间步数进行比较。
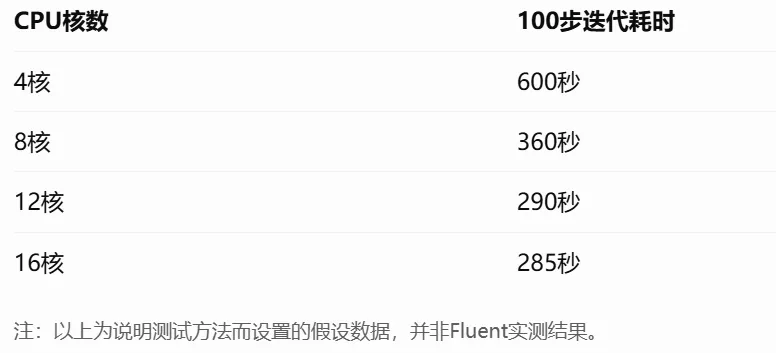
假设得到以下测试结果:
为什么增加CPU核数不一定能提高计算速度? 01 Fluent支持并行计算,其基本原理是将整个计算区域划分为多个网格分区,再由不同的CPU计算进程分别处理。
例如,一个包含200万个网格单元的模型,如果使用8核并行计算,理想情况下,每个计算进程大约负责25万个网格单元。
这种方式能够让多个计算进程同时工作,从而缩短计算时间。
但是,并行计算并不是简单地把任务平均分配出去。不同计算进程之间还需要不断交换数据,特别是在计算压力、速度和温度等物理量时,相邻网格分区之间必须进行信息传递。
随着CPU核数增加,每个进程承担的计算量逐渐减少,但数据通信、同步等待和分区管理带来的额外开销可能增加。
当通信开销抵消了增加核数带来的收益时,并行计算效率就会下降。
因此,Fluent并行计算存在收益递减现象,核数越多并不意味着计算一定越快。 Ansys官方文档也明确指出,计算进程增加到一定程度后,通信与计算的比例会增大,导致并行效率降低。
首先弄清楚物理核心与逻辑处理器的区别 02 选择CPU核数之前,需要了解计算机实际拥有多少物理核心。
例如,某台工作站搭载一颗8核心16线程的处理器。在Windows任务管理器中,通常可以看到:内核:8;逻辑处理器:16,其中,8代表物理核心数量,16代表启用超线程技术后操作系统识别的逻辑处理器数量。
需要注意,16个逻辑处理器并不等于16个独立的物理核心。
超线程技术能够提高部分程序的硬件资源利用率,但对于Fluent这类计算密集型软件,额外逻辑线程带来的性能提升往往有限。
Ansys的HPC许可文档指出,超线程核心通常只能带来很小的加速,甚至没有明显收益,因此不建议单纯依靠超线程增加Fluent并行核数。
对于新手而言,建议首先以物理核心数量作为并行计算的主要参考。例如,使用8核心16线程的处理器时,可以优先测试4核、6核和8核的求解性能,而不是直接选择16核。
根据网格数量初步选择CPU核数 03 网格数量是影响Fluent并行效率的重要因素之一。一般而言,网格规模越大,能够有效利用的CPU核数通常也越多。
如果网格数量较少,却分配了大量计算核心,就会导致每个进程承担的网格单元过少,通信开销占比明显增加。
在常规CPU并行求解中,可以暂时按照每核约10万至20万个网格单元进行初步估算。这只是用于确定测试范围的经验起点,并非Fluent对所有模型的统一要求。
例如,针对常规单相流动问题,可以参考以下测试方案:
需要强调的是,上表仅用于确定性能测试范围,并不意味着这些核数一定最优,也不代表必须配置相应数量的CPU核心。
例如,同样是200万个网格,普通管道流动模型和复杂的多相流模型,其计算负载可能存在明显差异。
对于涉及组分输运、燃烧、离散相或者复杂湍流模型的仿真,每个网格单元需要完成的计算任务更多,因此可能具有不同的并行扩展特性。
网格数量只能用于初步估算核数,真正合理的核数仍然需要通过计算测试确定。
CPU性能和内存同样影响计算速度 04 Fluent的求解速度不仅取决于CPU核数,还受到CPU主频、缓存、内存容量以及内存带宽等因素的影响。
首先是CPU主频。对于规模较小、并行效率不高的模型,单核计算性能较强的CPU可能具有明显优势。某些情况下,高主频的8核处理器可能比低主频的16核处理器表现更好。
其次是内存容量。Fluent需要在内存中存储网格、流场变量以及求解过程中产生的各种数据。当内存不足时,操作系统可能频繁使用磁盘交换空间,造成计算速度大幅下降。
另外,内存带宽也是容易被忽略的因素。随着并行核心增加,多个计算进程会同时访问内存。如果内存带宽已经成为性能瓶颈,即使继续增加CPU核数,也很难实现明显加速。
Ansys官方硬件建议同样强调,不能只关注处理器核心数量,而忽略内存带宽与内存配置。
因此,如果计算机同时承担建模、网格划分及后处理等任务,可以适当预留部分CPU和内存资源,避免多个程序相互争夺硬件资源。
如何通过实际测试找到最优核数? 05 对于Fluent新手,最可靠的方法并不是直接套用某个固定核数,而是针对自己的模型开展简单的并行性能测试。
假设某个模型包含200万个网格单元,计算机配备16个物理核心,可以分别采用4核、8核、12核和16核进行测试。具体操作如下:
首先,在Fluent启动界面选择并行计算,并在 Solver Processes 中设置需要使用的求解进程数量。
随后,使用完全相同的网格、物理模型、离散格式和求解设置进行计算。
对于稳态仿真,可以在相同初始条件下分别运行100步或200步迭代,记录实际耗时。
对于瞬态仿真,则建议采用相同的时间步长和时间步数进行比较。
假设得到以下测试结果:
Fluent支持并行计算,其基本原理是将整个计算区域划分为多个网格分区,再由不同的CPU计算进程分别处理。
例如,一个包含200万个网格单元的模型,如果使用8核并行计算,理想情况下,每个计算进程大约负责25万个网格单元。
这种方式能够让多个计算进程同时工作,从而缩短计算时间。
但是,并行计算并不是简单地把任务平均分配出去。不同计算进程之间还需要不断交换数据,特别是在计算压力、速度和温度等物理量时,相邻网格分区之间必须进行信息传递。
随着CPU核数增加,每个进程承担的计算量逐渐减少,但数据通信、同步等待和分区管理带来的额外开销可能增加。
当通信开销抵消了增加核数带来的收益时,并行计算效率就会下降。
因此,Fluent并行计算存在收益递减现象,核数越多并不意味着计算一定越快。 Ansys官方文档也明确指出,计算进程增加到一定程度后,通信与计算的比例会增大,导致并行效率降低。
选择CPU核数之前,需要了解计算机实际拥有多少物理核心。
例如,某台工作站搭载一颗8核心16线程的处理器。在Windows任务管理器中,通常可以看到:内核:8;逻辑处理器:16,其中,8代表物理核心数量,16代表启用超线程技术后操作系统识别的逻辑处理器数量。
需要注意,16个逻辑处理器并不等于16个独立的物理核心。
超线程技术能够提高部分程序的硬件资源利用率,但对于Fluent这类计算密集型软件,额外逻辑线程带来的性能提升往往有限。
Ansys的HPC许可文档指出,超线程核心通常只能带来很小的加速,甚至没有明显收益,因此不建议单纯依靠超线程增加Fluent并行核数。
对于新手而言,建议首先以物理核心数量作为并行计算的主要参考。例如,使用8核心16线程的处理器时,可以优先测试4核、6核和8核的求解性能,而不是直接选择16核。
网格数量是影响Fluent并行效率的重要因素之一。一般而言,网格规模越大,能够有效利用的CPU核数通常也越多。
如果网格数量较少,却分配了大量计算核心,就会导致每个进程承担的网格单元过少,通信开销占比明显增加。
在常规CPU并行求解中,可以暂时按照每核约10万至20万个网格单元进行初步估算。这只是用于确定测试范围的经验起点,并非Fluent对所有模型的统一要求。
例如,针对常规单相流动问题,可以参考以下测试方案:
需要强调的是,上表仅用于确定性能测试范围,并不意味着这些核数一定最优,也不代表必须配置相应数量的CPU核心。
例如,同样是200万个网格,普通管道流动模型和复杂的多相流模型,其计算负载可能存在明显差异。
对于涉及组分输运、燃烧、离散相或者复杂湍流模型的仿真,每个网格单元需要完成的计算任务更多,因此可能具有不同的并行扩展特性。
网格数量只能用于初步估算核数,真正合理的核数仍然需要通过计算测试确定。
Fluent的求解速度不仅取决于CPU核数,还受到CPU主频、缓存、内存容量以及内存带宽等因素的影响。
首先是CPU主频。对于规模较小、并行效率不高的模型,单核计算性能较强的CPU可能具有明显优势。某些情况下,高主频的8核处理器可能比低主频的16核处理器表现更好。
其次是内存容量。Fluent需要在内存中存储网格、流场变量以及求解过程中产生的各种数据。当内存不足时,操作系统可能频繁使用磁盘交换空间,造成计算速度大幅下降。
另外,内存带宽也是容易被忽略的因素。随着并行核心增加,多个计算进程会同时访问内存。如果内存带宽已经成为性能瓶颈,即使继续增加CPU核数,也很难实现明显加速。
Ansys官方硬件建议同样强调,不能只关注处理器核心数量,而忽略内存带宽与内存配置。
因此,如果计算机同时承担建模、网格划分及后处理等任务,可以适当预留部分CPU和内存资源,避免多个程序相互争夺硬件资源。
对于Fluent新手,最可靠的方法并不是直接套用某个固定核数,而是针对自己的模型开展简单的并行性能测试。
假设某个模型包含200万个网格单元,计算机配备16个物理核心,可以分别采用4核、8核、12核和16核进行测试。具体操作如下:
首先,在Fluent启动界面选择并行计算,并在 Solver Processes 中设置需要使用的求解进程数量。
随后,使用完全相同的网格、物理模型、离散格式和求解设置进行计算。
对于稳态仿真,可以在相同初始条件下分别运行100步或200步迭代,记录实际耗时。
对于瞬态仿真,则建议采用相同的时间步长和时间步数进行比较。
假设得到以下测试结果:
从表中可以发现,CPU核数由4增加至12时,计算速度明显提升。但是,从12核增加至16核后,计算时间仅减少5秒。这说明在该测试条件下,继续增加核心数量的收益已经非常有限。如果这台计算机还需要执行其他任务,选择12核可能比16核更合理。
另外,Fluent本身也提供并行性能分析工具,可以通过 Parallel → Timer → Usage 查看计算耗时与通信统计信息,辅助判断并行效率。
测试时应尽量保持机器负载一致,并排除首次启动、文件读取等额外因素的干扰。
误区一:CPU使用率越高,说明仿真越快。CPU使用率只能反映处理器的忙碌程度,并不能直接代表求解效率。部分计算进程可能花费大量时间等待数据通信,因此仍应以实际计算耗时作为主要判断依据。
误区二:网格数量越大,就应该使用所有核心。大型模型往往能够利用更多核心,但仍然受到内存带宽、网格分区质量和求解算法的限制。对于跨服务器并行计算,还需要考虑网络延迟与通信带宽。
误区三:增加核数能够改善计算收敛性。增加核数的主要目的是缩短计算时间,并不能直接解决网格质量差、边界条件不合理或求解参数设置不当等问题。
误区四:电脑有多少核,Fluent就能使用多少核。实际可用核数还可能受到软件许可证限制。常规Fluent商业求解许可证通常包含4个CPU并行核心,使用更多核心一般需要相应的HPC许可;具体应以所使用的软件版本和许可证类型为准。
对于Fluent仿真而言,合理选择CPU核数,本质上是在计算负载、并行通信与硬件资源之间寻找平衡。核数过少,无法充分发挥多核处理器的计算能力;核数过多,又可能因为通信开销、内存带宽不足等原因降低并行效率。对于刚接触Fluent的新手,建议先了解计算机的物理核心数量,再结合网格规模和物理模型复杂程度初步选择核数,最后通过不同核数下的实际计算耗时进行比较。与其盲目追求更多的CPU核心,不如为具体模型找到合适的并行配置,这才是提高Fluent仿真效率更有效的方法。
往期文章推荐
GPT Codex 怎么用?一篇讲给 CFD 工程师的实用教程
