2026年10月大模型混战:Claude、Gemini、GPT-6同时发招,普通人到底该用哪个(建议收藏)
两周内四家旗舰同期发布、五个开源模型放开权重。这篇文章一次讲清:谁最强、谁最便宜、不同场景该选哪个。如果你最近觉得AI新闻看不过来,不是你的问题。2026年10月的前两周,Google、Anthropic、OpenAI、DeepSeek四家在同一个月放出旗舰级更新,Meta、Mistral、Reflection、Aleph Alpha又扎堆开放模型权重。模型发布的密集程度,是过去十年没有过的。
更关键的是,这一轮发布潮透出三个和每个用AI的人有关的信号:能力天花板又被抬高了一截;调用价格继续下探;国产模型与美国顶尖的差距,收窄到了个位数百分比。
追榜单本身没有意义,但看懂格局有意义。这篇文章不站队,只做三件事:把十月发生的事讲清楚,把四个旗舰摆到一起横评,告诉你不同场景该选哪个。
没有全能第一,只有场景最优。按你要做的事选模型,比追榜单第一名有用得多。热闹很多,先记住四个数字,格局就清楚了。
Gemini 4 Argon 的上下文上限,从上一代的6.4万一跃到100万。整本书、整个代码库,可以一次丢进去。Claude Opus 5.5 在 Artificial Analysis 综合智能榜的得分,位列全球第一,前三名被 Anthropic 包揽。GPT-6 Astra 超快推理模式的输出速度,跑在英伟达 Blackwell GPU 上,最高达标准模式的8倍。彭博社测算:中美顶尖模型的能力差距,已从年初的15%收窄到3%。追赶者是 DeepSeek V4.1 Flash。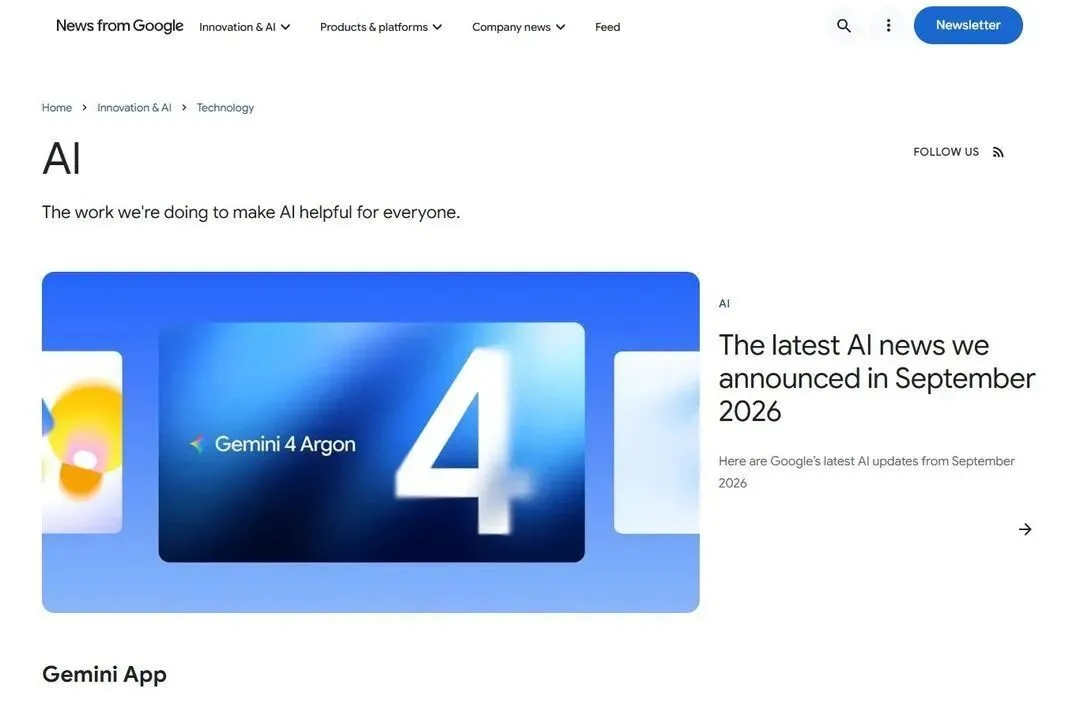 Google 官方博客首页,Gemini 4 Argon 是当前主推
榜单分数只说明一部分。真正影响使用体验的是性格:谁擅长长任务,谁便宜够用,谁快得离谱。把四个旗舰摆在一起看,比单独看发布会清楚得多。
Artificial Analysis 综合智能榜57.6分全球第一,长文档、复杂推理、深度写作的默认首选。定价每百万token输入4美元、输出20美元,上下文100万。适合:写报告、做分析、啃长文。定位真实世界编程与企业知识工作的旗舰,DeepSWE v1.1得分77.9%,LMSys Text Arena 1525分登顶。上下文100万token,入门价输入2美元、输出10美元每百万token。适合:大代码库、跨文档调研。GPT-6家族旗舰,超快推理模式输出速度最高8倍,插件生态最全。定价每百万token输入10美元、输出50美元,上下文100万。适合:追求速度、重度插件用户。国产开源高性价比代表,能力对标顶尖、价格打到地板,上下文100万。彭博测算中美差距已收窄至3%。适合:预算敏感、中文场景、开发者。一个反常识的结论:分数最高的不一定最适合你。日常写文案用 Opus 5.5 是杀鸡用牛刀,简单问答用 Astra 是花冤枉钱。匹配场景,比迷信榜单省钱得多。
 ChatGPT 界面,GPT-6 家族已面向开发者开放
比旗舰发布更值得关注的,是开源阵营这个月的爆发。至少五个开放权重模型发布,而且不是玩具级,是能上生产环境的级别。
Meta 放出 Muse Spark Open:8160亿参数,原生支持文本、图像、视频、音频输入,权重直接可下载。Reflection 的 Beam:5010亿总参数、230亿激活,用240万亿token训练,推理效率号称比 GLM 5.2 高3到4倍,采用 Apache 2.0 协议。Mistral Large 4 更激进:总参数一万亿、激活490亿,原生多模态,训练语料覆盖160多种语言,月底开放权重。
欧洲的 Aleph Alpha 发布 Kolibri:780亿参数MoE架构、每token激活34.6亿,100万上下文,Apache 2.0,主打本地部署。JetBrains 的 Mellum 2.1 则面向能自托管的编程智能体。
开源对普通人的意义很直接:数据不出门。公司内网文件、个人隐私资料、涉密文档,都可以用开源权重在本地跑。这个月之前这叫将就,这个月之后这叫好用。
顺便说一句 Anthropic 的产品节奏:9月22日 Opus 5.5、9月28日 Sonnet 5.5、10月7日 Haiku 5.5,三周发三代。Haiku 5.5 主打便宜快,官方测算平均成本比上一代低75%左右。旗舰打架,最终受益的是用户。
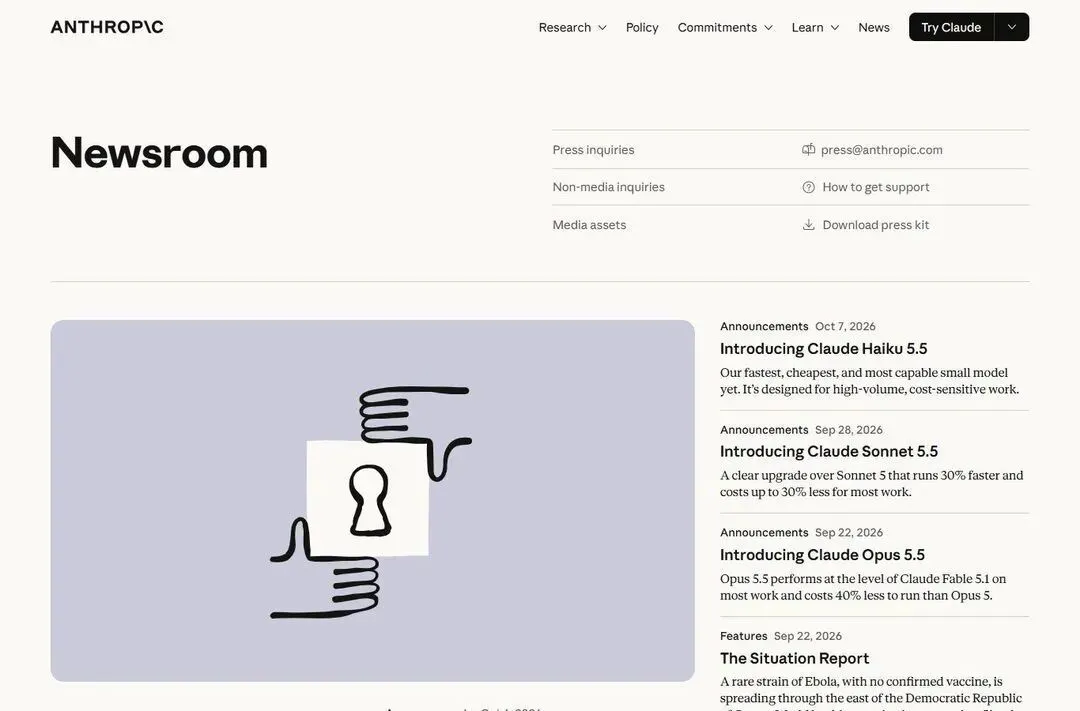 Anthropic 官方新闻室:Opus 5.5、Sonnet 5.5、Haiku 5.5 三周三代
选型不用懂技术细节,记住四句话就够。
写代码、啃大项目选 Gemini 4 Argon 或 Claude Opus 5.5。两者在编程评测上都属第一梯队:Argon 的100万上下文适合把整个仓库丢进去,Opus 5.5 的强项是跨文件推理和代码重构。日常写作、分析、学习选 Claude Opus 5.5。综合智能榜第一不是刷出来的,长文写作和结构化分析确实稳。除非你预算敏感,那就跳到第三条。省钱优先、中文场景选 DeepSeek V4.1 Flash。能力对标顶尖、价格打到地板,国产模型的中文语感天然占优,API还支持网页搜索与抓取。高频分类、路由、判断选 GPT-6 Luna Decisions。OpenAI 10月6日放出的决策专用API,只返回结构化答案,官方称比标准接口快10倍,适合批量判断类任务。三个省钱提醒。一,多数任务不需要旗舰,中档模型性价比更高:Sonnet 5.5 比 Opus 5.5 快三成、便宜三成,Haiku 5.5 平均成本再降75%。二,能开缓存的场景开缓存,重复上下文能省一半以上。三,开源权重加本地部署是长期成本最低的解,面壁智能的 MiniCPM-V 4.7 甚至能在iPhone上以3GB内存跑出每秒13个token。
 DeepSeek 官网首页,V4.1 Flash 已更新上线
第一,能力在涨价还是在降价?在降价。两年前只有大公司用得起的推理能力,现在个人调用无压力。用不用AI,已经从会不会变成用不用。
第二,差距在缩小。中美顶尖模型差距收窄到3%,国产模型从平替变成可选。中文场景、数据合规、成本控制,都多了底气。
第三,评价体系在变。Artificial Analysis 这类第三方榜单影响力持续上升,厂商刷分、用户看分。会选模型,正在变成和会用模型一样重要的能力。
最后一句实话:模型每周都在更新,但会选模型、会写提示词、能把工具接进工作流的能力不过期。后者才是普通人该攒的。
 Gemini 4 界面:看看你可以用 Gemini 4 做些什么
- Claude Opus 5.5:综合智能榜第一,长任务首选
- Gemini 4 Argon:100万上下文,编程调研之王
- DeepSeek V4.1 Flash:性价比之王,中文占优
- 开源四小龙:Muse Spark Open / Beam / Mistral Large 4 / Kolibri
- 选型口诀:长任务选Claude、大项目选Gemini、省钱选DeepSeek、批量判断选Luna
选对了模型,下一步是让它们替你干活。下一篇写《把四家模型接进一个工具:普通人也能搭的AI工作流》——不写代码,半小时搭好,关注「AI云前哨」,不错过。
