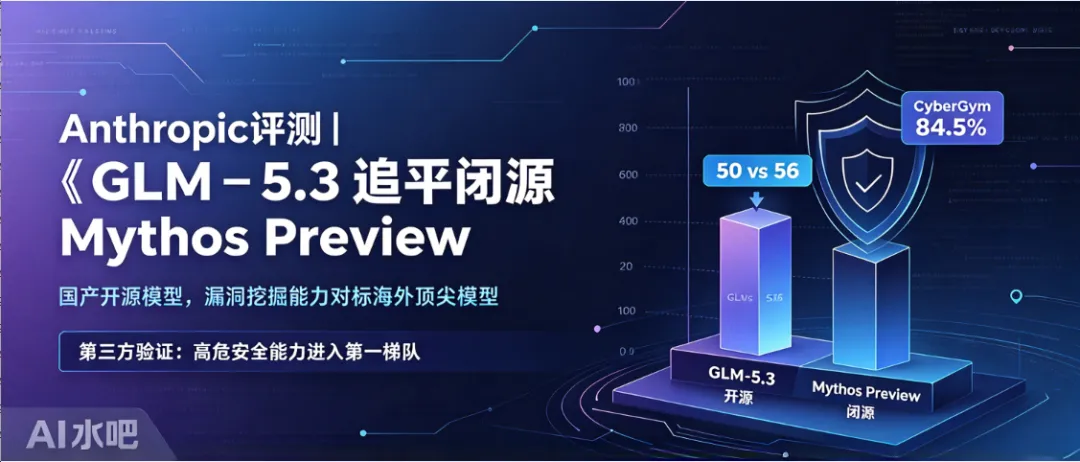
Anthropic 在 9 月 29 日发布网络安全专项研究报告,爆出重磅结论:智谱 GLM‑5.3 在漏洞利用测试上,性能接近 Anthropic 内部未对外发布的 Mythos Preview。
Mythos Preview 是 Anthropic 的前沿旗舰模型,仅小范围定向开放,以强大的自主漏洞挖掘、端到端攻击链构建能力闻名,此前长期处于闭源状态。而 GLM‑5.3 作为开源权重模型,拿到对标成绩,在行业内引发不小震动。
核心测试数据(ExploitBench)
ExploitBench 是评估 AI 自主挖掘、利用真实软件漏洞的权威基准。
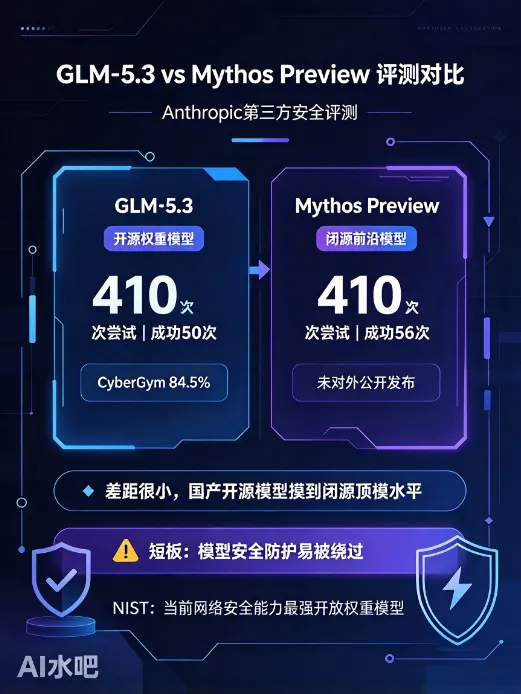
- GLM‑5.3:410 次测试尝试,50 次成功完成端到端漏洞利用
- Claude Mythos Preview:410 次测试尝试,56 次成功二者差距很小,代表 GLM‑5.3 已经具备自主搭建完整漏洞攻击链的能力。报告中提到,研究团队使用 GLM‑5.3,在隔离环境下成功发现浏览器未知漏洞,并且完整验证攻击链路。
补充:在 CyberGym 白盒漏洞识别任务,GLM-5.3 得分 84.5%,甚至略高于 Mythos Preview。
关键区别:开源 vs 闭源
✅ GLM‑5.3:开源权重模型,任何人都可以下载部署、本地运行。
✅ Mythos Preview:Anthropic 内部前沿模型,不对外公开发布,仅限定向小范围测试。这也是本次事件最有冲击力的一点:国产开源模型,在高危网络安全能力上摸到了海外闭源顶尖模型的水平。
⚠️ 报告同时给出风险提示
Anthropic 也在报告强调安全隐患:测试中,攻击者可以用简单手段,64%~100% 概率绕过 GLM‑5.3 内置安全防护;而同类攻击手段无法攻破 Claude 系列防护。这意味着 GLM‑5.3 虽然能力强,但安全防护门槛还有提升空间。NIST 下属 CAISI 评估,GLM‑5.3 是当前网络安全能力最强的开放权重大模型。
行业解读
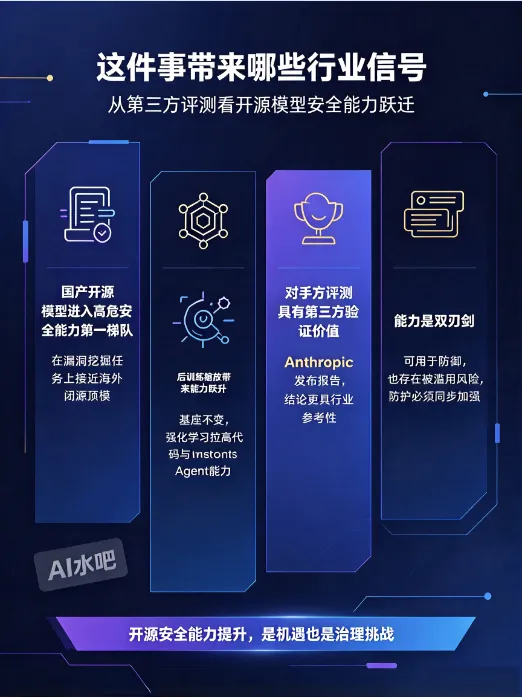
过去,顶尖的自主漏洞挖掘能力,一直被海外少数闭源前沿模型垄断。GLM‑5.3 依托 “后训练缩放” 方案,基座不变,依靠大规模强化学习把代码、Agent、安全能力拉到新高度。这份 Anthropic 出具的评测,相当于对手方认可国产开源模型在高危安全任务上,已经摸到顶级闭源模型的门槛。但能力是双刃剑:强大漏洞挖掘能力,既可用来防守、发现系统隐患;也可能被攻击者利用挖掘漏洞,安全防护是不可忽视的重点。
一句话小结:Anthropic 实测,智谱 GLM‑5.3 漏洞利用能力接近闭源 Mythos Preview,作为开源模型意义重大,但模型安全防护存在短板。
💬 互动话题开源模型拥有顶尖漏洞挖掘能力,机遇和风险哪个更大?欢迎评论区聊聊。
#GLM5.3 #MythosPreview #智谱AI #大模型安全