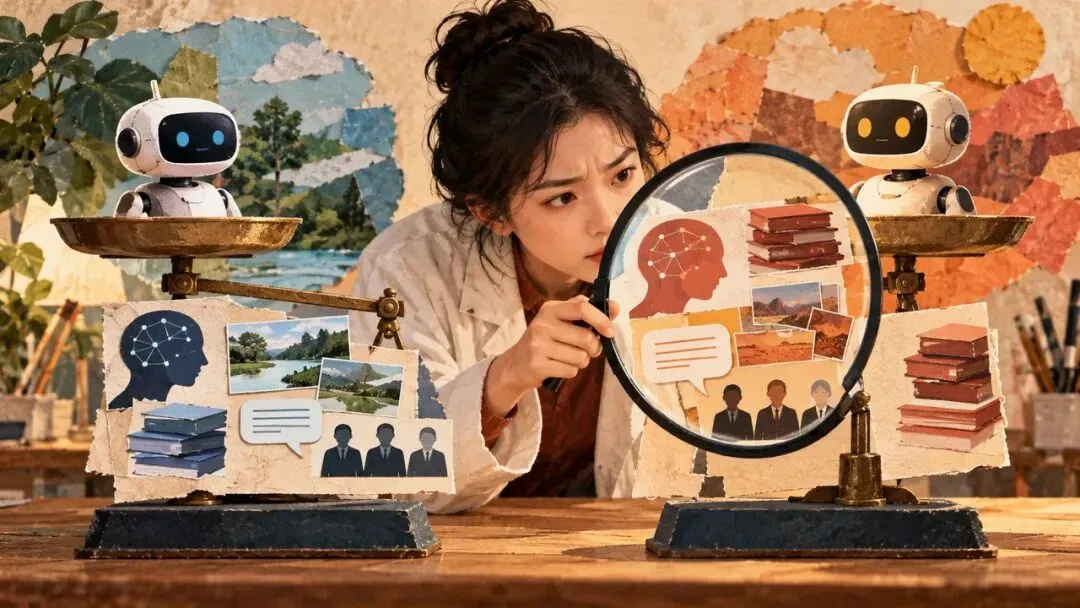
把提示词版本、测试集、自动评测、人工反馈和生产 Trace 放进同一个平台,确实能让 AI 应用迭代顺畅很多。但工具越完整,团队越容易忽略一个基本问题:两次评测到底是不是在比较同一件事?
本期主项目是 Agenta-AI/agenta。截至 2026 年 10 月 13 日,公开 GitHub 索引显示约 4,827 Stars,主要语言 TypeScript,仓库持续活跃,最近更新在 10 月 11 日,最新 Release 为 v0.122.4。项目核心代码以 MIT 为主,企业目录另有独立许可,使用前应按具体目录确认。
先说结论:一体化平台不能替代实验契约
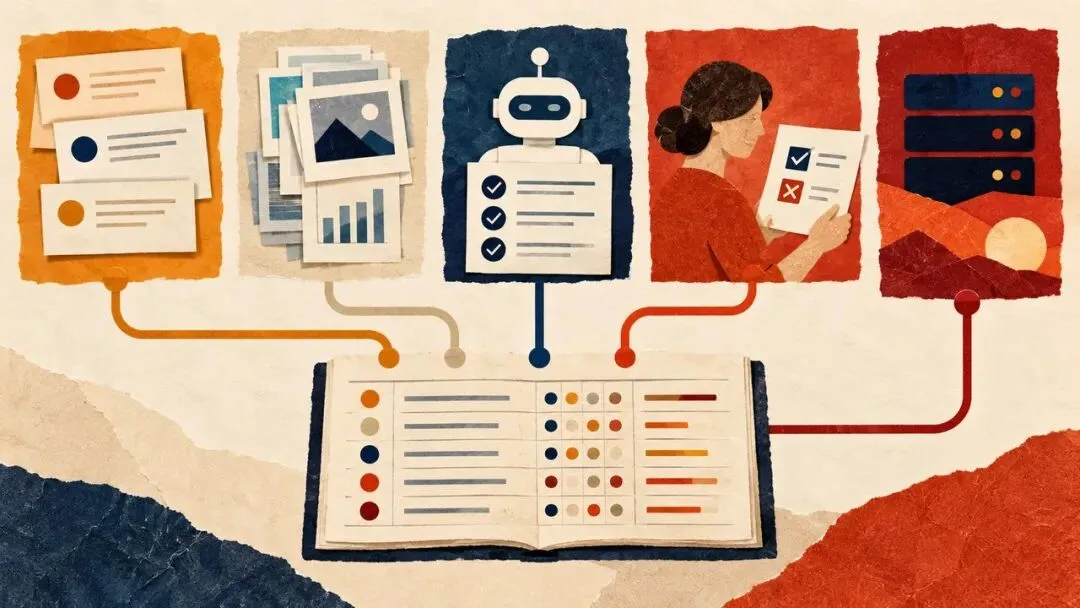
Agenta 把提示词管理、评测、可观测和协作放到一个工作区。对测试团队而言,最大的价值不是少开几个页面,而是有机会把“版本—数据—结果—反馈—生产样本”串成一条可追溯链路。
但如果每次运行换了模型、参数、数据集、Judge 或评分提示词,分数变化就无法归因。平台能保存结果,却不会自动保证实验公平。真正的门禁需要一份实验契约:哪些变量必须冻结,哪些变量允许变化,结果达到什么条件才可发布。
第一件事:给每次评测建立可复现身份
一次有效比较至少要绑定提示词版本、模型与参数、测试集版本、评测器版本、Judge 模型、评分提示词和运行时间。只记录一个平均分远远不够,因为同名测试集可能已被增删,Judge 也可能在供应商升级后发生漂移。
Agenta 的提示词版本、测试集、评测与 Trace 能放在同一工作区,这为追溯提供了基础。测试团队要进一步约定:一次基线确认后,不允许静默覆盖;任何影响结果的配置变化都生成新版本;评测报告必须能回到具体输入与单条输出。
第二件事:平均分不能掩盖样本结构
一个版本从 78 分涨到 82 分,可能是所有场景都有小幅改善,也可能只是简单样本比例增加。后者看起来更漂亮,却对真实风险没有帮助。
测试集应按业务场景、用户类型、语言、输入长度、风险等级和历史故障分层。除了总体均值,还要看关键切片、失败分布和最差样本。生产流量进入测试集前也要去重、脱敏和抽样,避免把高频简单问题无限复制,稀释真正困难的长尾问题。
自动评测和人工评测要互相校准
自动评测适合规模化回归,人工评测适合发现标准遗漏。二者不是替代关系。LLM-as-a-Judge 能快速评分,但会受到顺序、措辞、模型偏好和评分提示词影响;人工标注也有尺度不一致、疲劳和上下文缺失的问题。
比较稳妥的做法,是先用一批多人复核的锚点样本定义尺度,再观察自动 Judge 与人工结论的一致率。出现明显分歧时,不要简单服从其中一方,而要回到评分标准:是 Judge 不稳定,还是人工标准本身含糊?
Agenta 提供自动与人工评测的汇合位置,真正的质量工作是把分歧沉淀成规则、示例和新测试用例,而不是只留下一个投票结果。
Trace 的价值,是把线上失败变成回归资产
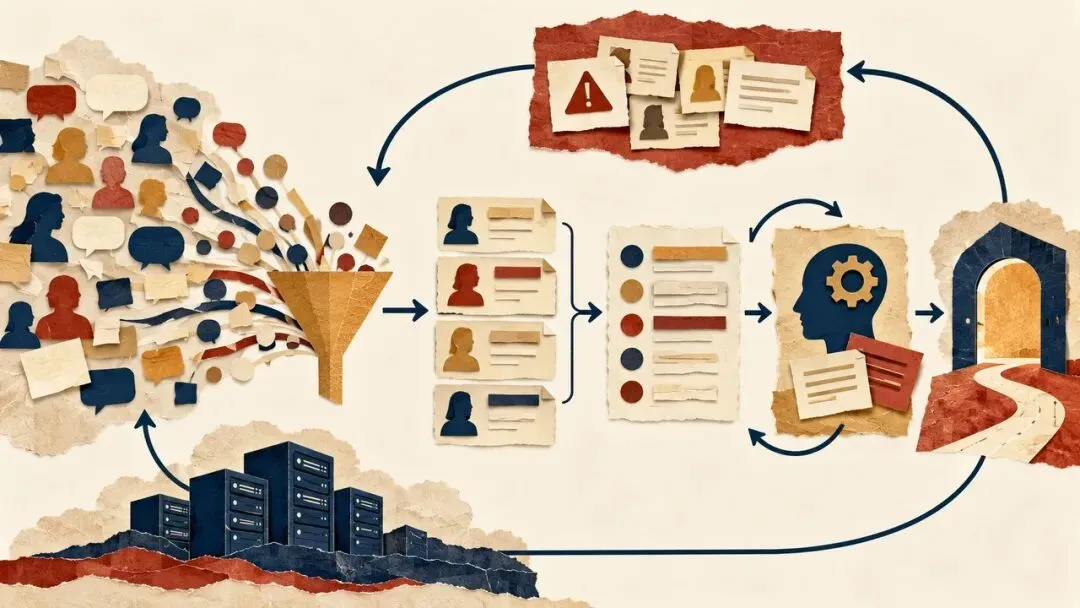
可观测平台常见的问题,是 Trace 很多,但测试集几年不变。Agenta 把可观测与评测放在一起,最值得利用的是闭环:从生产 Trace 中筛出失败、低分、用户纠正或异常耗时样本,脱敏后进入候选集,人工确认,再加入版本化回归集。
这个过程必须控制偏差。只挑最离谱的失败,会让测试集过度极端;只抽高频问题,又会漏掉高风险长尾。建议同时维护核心业务集、历史故障集、随机流量集和对抗集,并分别设置门槛。
优点和边界都很明显
Agenta 的优势是工作流完整:提示词版本、对比实验、自动评测、人工反馈和 Trace 能形成连续上下文;自托管选项也适合需要控制数据边界的团队。近期频繁发布说明项目仍在快速演进。
边界也不小。部署和维护一体化平台的成本高于单一测试库;评测质量依赖团队自己的数据与标准;企业协作能力存在许可边界;快速版本迭代意味着接口、部署和迁移都要回归。它提供评测基础设施,不提供天然可信的指标。
3 个替代方案怎么选
如果优先考虑代码化测试、断言和 CI,Promptfoo 更轻,适合把提示词回归直接放进流水线。如果重点是开源可观测、Trace 与在线评测,Langfuse 更成熟。如果希望把实验、评测和可观测集中管理,同时重视 Python SDK 与数据科学工作流,可以看 Opik。
Agenta 更适合产品、研发与测试共同迭代提示词和 Agent 的团队;Promptfoo 偏工程门禁,Langfuse 偏生产可观测,Opik 偏实验追踪与评测。选择时先看团队最痛的断点,不必为了功能数量追求全家桶。
测试团队的最小门禁
冻结模型、参数、数据集和 Judge 版本;按场景切片比较,不只看均值;用人工锚点定期校准自动评分;保存单条输入、输出、理由与失败分类;从 Trace 建立受控回流;最后设定关键切片不得退化、严重失败为零、成本与延迟不越线的组合门槛。
结束语
评测平台最有价值的不是制造更多分数,而是让每个分数都能解释、复现和追责。Agenta 提供了连接提示词、评测与生产反馈的工作台;是否真正形成质量闭环,取决于团队有没有把实验契约写清楚。
GitHub 项目地址:
https://github.com/Agenta-AI/agenta