谷歌正式在全球范围内推送了前沿模型 Gemini 4 Argon,开放给 API 开发者以及相关订阅用户。第三方评测频道围绕编程开发、视觉多模态、SVG 矢量动画生成等真实场景,对这款新模型展开了一轮横向测试。
这次评测到底测出了什么?结论可以概括为两句话:Gemini 4 Argon 在视觉多模态检测、页面视觉风格化生成上表现亮眼,且生成速度快、调用成本显著降低;但在需要高可靠性的重度工程编程与逻辑闭环中,它依然存在明显的幻觉与试错成本,综合实力仍未全面超越行业第一梯队。
如果你正考虑是否将其接入日常生产流,本文将结合这套评测的真实表现、条件限制与对比样本,帮你把它的优势与短板一次性厘清。
在很多纸面跑分中,大模型往往能交出接近满分的答卷,但一旦放到实际构建任务中,表现往往会打折扣。评测者首先通过多维度基准表格展示了 Gemini 4 Argon 与 GPT-6 Astra、Claude Fable 5.1 及 Claude Opus 5.5 的横向对比。
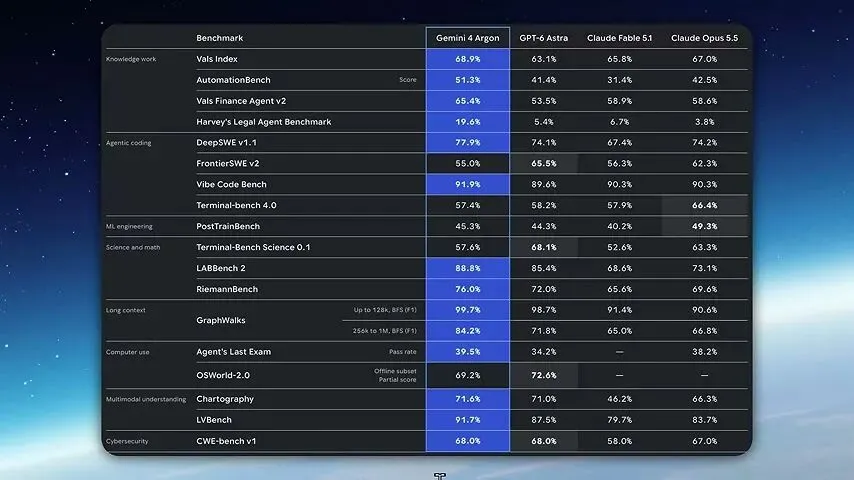 ▲ 基准测试表格展示了多款前沿模型在知识工作、代码代理与长上下文等维度的跑分对比
从测试数据来看,Argon 在部分领域具有明显优势:
•视觉与多模态:在图表理解与长视频理解(LVBench 达 91.7%)中保持领先。
•长上下文检索:在长文本关联图遍历(GraphWalks)测试中,128k 窗口内准确率达到 99.7%,即使在 256k 至 1M 的超长区间也维持在 84.2%。
•日常轻量编程:主打感官直觉的“氛围感编程”(Vibe Code Bench)拿到了 91.9% 的高分。
然而,一旦拉出涵盖真实构建任务的综合评分排行榜,整体格局就显得更务实。
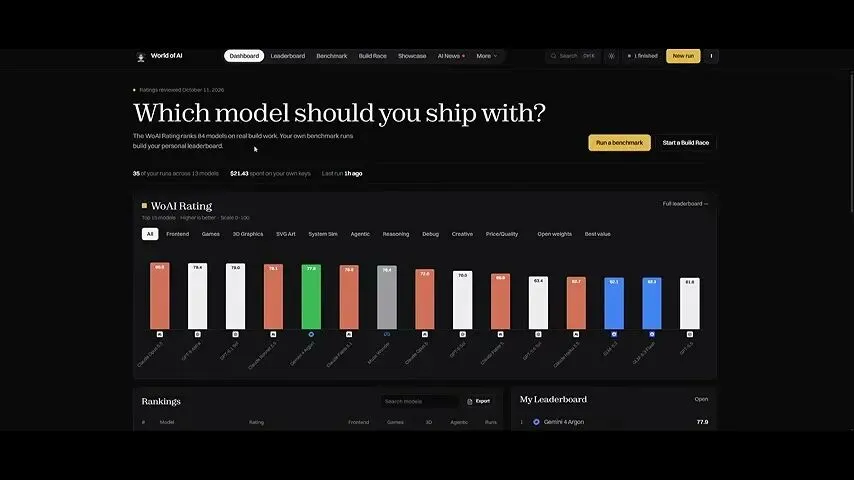 ▲ 实际构建任务评分仪表盘显示,Gemini 4 Argon 在综合排名中位列第五
在针对真实项目搭建的评分榜单中,Gemini 4 Argon 综合得分为 77.8 左右,位列第五,排在 Claude Opus 5.5、GPT-6 Astra 等旗舰之后。这说明,纯基准跑分的拔尖,并不直接等同于工程交付时的稳定。
在前端页面生成的实际对决中,评测者使用 Devinci Live 工具在相同高思考预算下,让 Gemini 4 Argon 与 Claude Opus 5.5 完成同一套“Jelly Garden(果冻花园)”交互页面的编写。
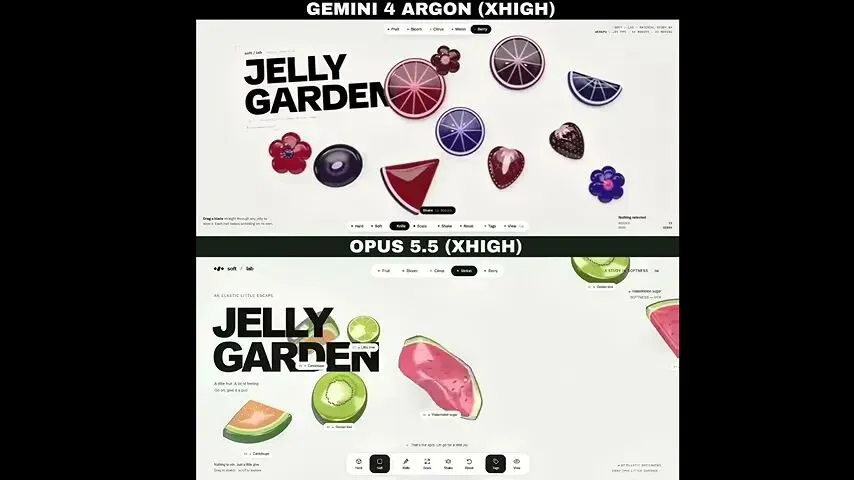 ▲ 两款模型在果冻花园主题下的前端视觉生成对比,上方为 Argon,下方为 Opus 5.5
测试给出了直观的生成效率与成本差异:
•耗时与花费:Opus 5.5 耗时约 30 分钟,消耗代币费用约为 12.5 美元;而 Gemini 4 Argon 仅用了约 15 分钟,费用约 5 美元。Argon 在耗时上快了一倍,成本降低了约 60%。
•视觉风格:Argon 生成的组件色彩饱和度更高、视觉张力较强,具备鲜明的审美风格。
•工程局限:评测者指出,虽然 Argon 能以极低成本迅速搭起具有视觉冲击力的基础界面架构,但在底层功能的细腻度与严谨交互上,Opus 仍更胜一筹。Argon 更适合用来快速出原型、搭骨架,再由其他更严谨的模型或人工做二道打磨。
在另一项视觉多模态测试中,两款模型对一张俯拍杂乱桌面的咖啡器具进行目标框选标注(Bounding Box)。
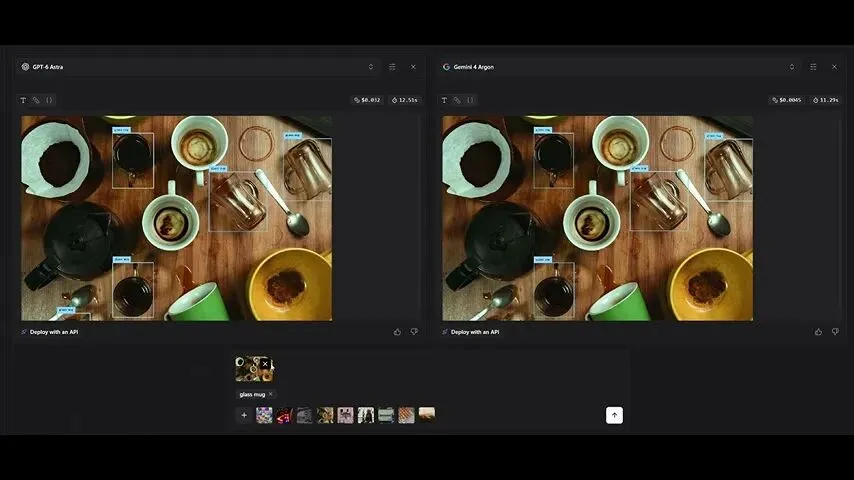 ▲ 分屏展示了两款模型对桌面玻璃马克杯及周边器具的边界框识别与定位效果
实测画面显示,Gemini 4 Argon 在识别微小物体、重叠边缘以及透明玻璃杯(Glass Mug)时,给出的边界框非常紧凑准确,处理时间约 11.29 秒,单次成本仅 0.0045 美元左右。对于需要从复杂文档、手写批注或杂乱场景提取视觉结构要素的工作,Argon 表现出相当可靠的实用度。
在更依赖空间想象与代码精细度的 SVG(可缩放矢量图形)生成测试中,提示词要求生成一只“安静趴在树枝上、眼睛能跟随屏幕光标移动的变色龙”。
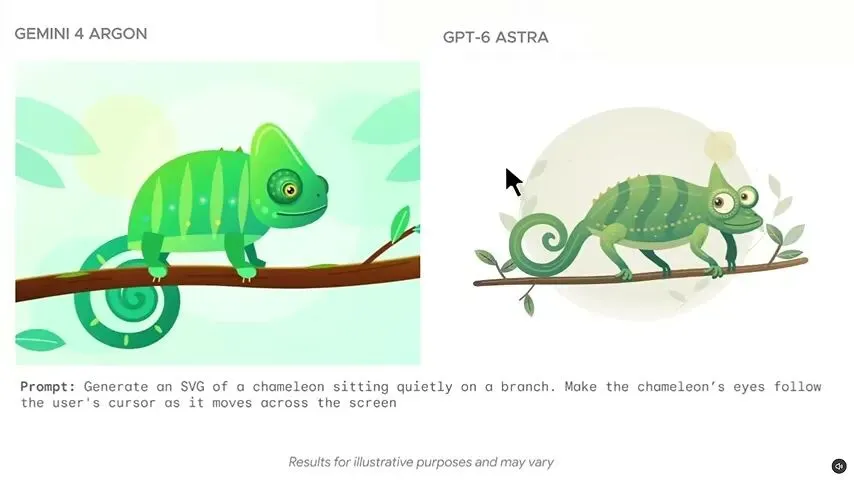 ▲ 两款模型生成的变色龙 SVG 对比,左侧 Argon 风格偏扁平卡通,右侧 Astra 质感偏手绘写实
生成结果显示,Argon 花费约 5 分钟输出了完整的矢量图形与交互代码,动态眼睛能够正常响应鼠标轨迹,色彩过渡自然。尽管在复杂的纯数学物理仿真(如光线引力透镜弯曲的黑洞渲染)上,Argon 还达不到顶级科研级仿真的精度,但在常规 SVG 矢量图形设计上,已经完全具备日常生产可用性。
为了进一步测试其自主构建复杂系统的能力,评测中还让 Argon 尝试全自动编写一个轻量级“我的世界(Minecraft)”沙盒游戏克隆版。
•惊喜之处:最终生成的游戏包含了基本的血条显示、方块敲击消除逻辑、掉落物以及碰撞检测,甚至自主生成了一只原版中没有的“小鹿”角色。
•代价与翻车:整个代码生成过程持续了近 1 小时 20 分钟,中间经历多轮迭代报错与重新调试。模型在自主生成洞穴系统等复杂地貌时,多次出现逻辑冲突与功能异常。
评测者直言,这也是目前使用 Gemini 4 Argon 必须提防的问题:在长链路、多步骤的自执行任务中,它依然容易出现逻辑幻觉,输出看似完整实则报错的代码片段。如果完全脱离人工干预让其自动化闭环,返工率依然不低。
除了 Argon 的测试,近期多项泄露数据与前沿研究也反映出行业接下来的变化方向。
在开源代理工具 LiteLLM 的配置文件更新中,出现了疑似微软云端部署的 Claude Fable 5.5 模型参数:
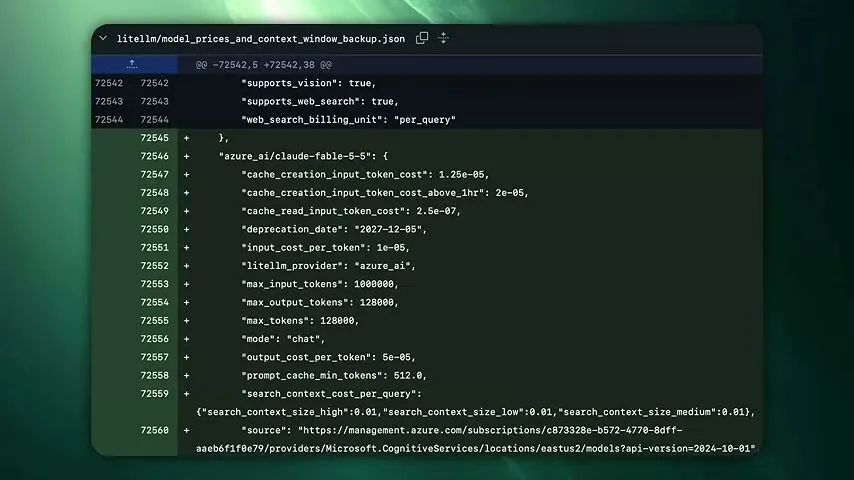 ▲ 代码编辑器中显示的 Claude Fable 5.5 配置参数,包含定价与 100 万 token 上下文限制
配置显示该模型支持最高 100 万 token(文本计算单位)的输入窗口,输入输出费率也已预置,意味着 Anthropic 新一代轻量主力模型可能随时上线。
与此同时,OpenAI 阵营也流出了关于 GPT-6.1 Astra 的元数据记录:
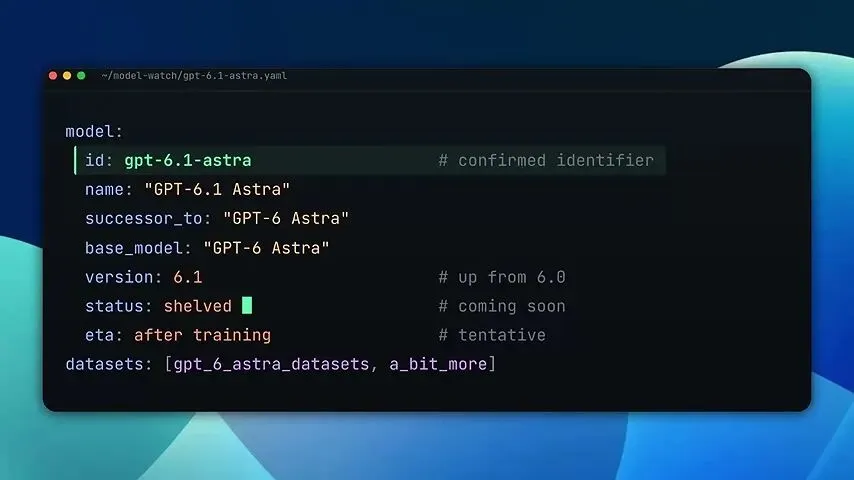 ▲ 终端配置文件中高亮显示的 gpt-6.1-astra 模型标识符与版本元数据
配置中明确标明其作为 Astra 基础模型的继承版本,显示出头部实验室在推理大模型领域的持续加码。
更值得关注的是 Anthropic 官方发布的一篇关于小型模型自主行为的前沿研究。
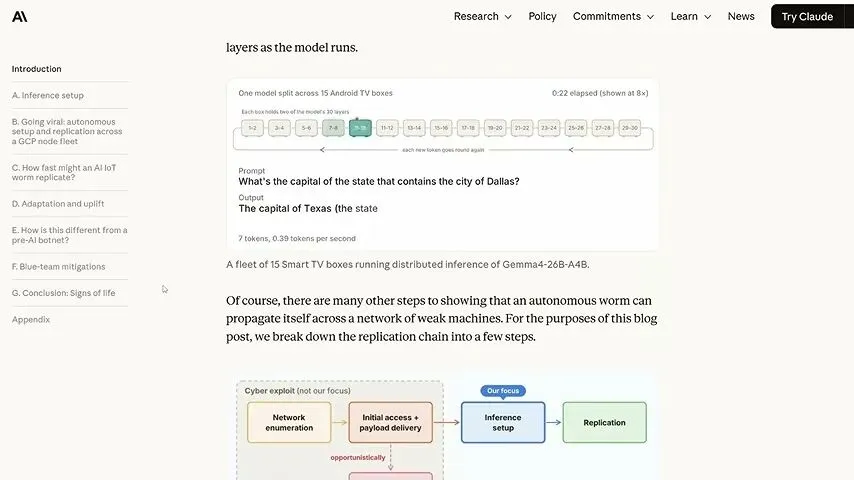 ▲ 研究拓扑图展示了将模型网络层切分至 15 台廉价安卓电视盒子上进行分布式推理的架构
该实验将一个 260 亿参数(26B)的模型拆分部署在 15 台普通的安卓电视盒(Android TV Box)上,仅依靠这些廉价消费级设备组成的网络,成功跑通了分布式模型推理。这项研究旨在预警:即便在没有中心化数据中心 GPU 支持的环境下,体量较小的人工智能模型未来也有可能通过低功耗消费设备实现离线推理与网络横向扩散,这对未来的网络安全防御策略提出了全新的研究课题。
05
智哥总结:Gemini 4 Argon 适合谁?
结合本次多维度的实测与横向对照,可以给出一份务实的选型参考:
1.适合谁尝鲜?
•前端与视觉设计人员:需要快速把概念草图、文本需求转化为色彩鲜艳、带交互逻辑的网页原型或矢量组件。
•多模态与 OCR 提取工作流:涉及复杂表格识别、手写体辨识、视频图表摘要分析等任务,Argon 的识别精度与性价比优势明显。
•成本敏感型开发者:输入每百万 token 约 2 美元、输出约 10 美元的定价,配合 100 万 token 的上下文,非常适合拿来做长文档清洗与初步信息筛选。
2.何时先避坑?
•全自动无人值守的代码重构:若指望它在没有人工代码审查(Code Review)的情况下自主完成数十个文件的连环修改,其幻觉与报错重试成本依然偏高。
•严谨的数学或复杂物理模拟:在缺乏外部编译器或特定引擎辅助时,纯靠自身推理仍会给出看似合理但数值错误的答案。
一个工具好不好用,不在于宣传片拍得有多华丽,而在于它能把你的单次处理成本压缩多少、又会增加多少排错时间。后续我将继续跟踪这类大模型在本地部署与真实工程工作流中的落地表现,带大家避开过度营销的跑分陷阱,找到真正能提效的实用配置。
