「AI 测试地图」系列的第三篇。第 2 层(输出质量层)的落地篇——上一篇讲它会怎么坏,这一篇讲怎么证明它坏了。
这篇欠了两次:地图篇和自查表篇的文末都预告过它。读完你会拿到一张评测集的列定义、三档评分的具体写法、LLM 当裁判时最容易踩的四个坑,以及可直接复制的一段裁判 Prompt。
全篇两千多字,读下来大约 8 分钟。不方便看屏幕就点右上角「···」→「听全文」,用的是我自己的声音。
评审会上,有人问了一句:这版 AI 比上版好,好在哪?
会议室安静了两秒。然后有人说:感觉回答更顺了。
这话要是放在传统软件上,你当场就能怼回去——回归用例 120 条,通过率从 88% 涨到 96%,报告里有。可换成 AI,你手里什么都没有。
三档评分:规则断言 → 相似度 → LLM 裁判先说结论
测 AI,难点从来不是"它答得对不对",是"你怎么证明它答得对不对"。
传统测试交付的是"通过 / 失败"两个状态;AI 测试交付的,是一个数字,和这个数字背后的标准。
所以这一篇不聊概念,就干一件事:把"AI 答得挺好"这句话,拆成可以写进验收报告的东西。
第一步:先把"什么算好答案"写下来
这一步跳过,后面全是空的。
做法朴素到有点反直觉:挑 20 个真实用户问题,给每个问题写一句"什么算好答案"。 写在 Excel 里就行,列头这五栏可以直接照抄:
编号 | 用户问题 | 什么算好答案 | 判定档位 | 阈值
注意第四、五栏——它们决定这个答案是"人工看"还是"机器判",是这篇后面所有内容的前提。
这 20 条不用精挑细选,从你手头的客服记录、工单、用户群提问里随手捞就行。
评测集不是数据集,是把"我觉得"变成"标准说"的第一张纸。
第二步:给每条答案选一档评分方式
传统断言是 assert(结果 == 期望)。AI 的输出是抽样出来的,同一个问题问两次答案不一样,等号两边永远对不上。
所以断言退场,评分上场。按成本和覆盖面,分三档:
第一档 · 规则断言。 只检查"形":格式对不对、有没有包含必现的关键词、有没有出现禁止词、长度在不在范围内。便宜、稳定、结果非黑即白。
大部分团队的真实收益,其实都来自这一档——"不能承诺赔款""必须带订单号""不能出现竞品名",全是规则。
第二档 · 相似度评分。 把答案和参考答案都转成向量,算余弦相似度,或者用 ROUGE / BLEU 这类老指标。它能判"意思像不像"。
坑也在这:同义改写会被扣分,换个说法意思完全一样,相似度可能只有 0.6。所以阈值不能拍脑袋。
第三档 · LLM 当裁判。 用一个模型给另一个模型的输出打分。这是唯一能判"语气是否推诿、有没有越权承诺、该不该转人工"的档位,也是三档里最贵、最不稳的一档。
规则断言保下限,相似度管意思,LLM 裁判管分寸——三档不是三选一,是三道筛子。
第三步:用 LLM 当裁判之前,先知道它有四个偏见
这一节是全篇最值钱的部分,因为大多数人栽在这儿还不知道为什么。
用大模型当裁判这件事,2023 年就被系统研究过。Zheng 等人那篇《Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena》(NeurIPS 2023)给出的结论是:GPT-4 当裁判,与人类偏好的一致率超过 80%,跟人和人之间的一致率差不多。 这个数字是它值得用的理由。
同一篇论文也把它的毛病列清楚了,其中四个最要命:
位置偏差——先出现的答案更容易赢。把 A、B 两个答案换个顺序再判一次,模型的判断可能整个翻转。
啰嗦偏差——更长、更啰嗦的答案更容易拿到高分,哪怕多出来的内容是废话。
自我偏好——裁判会偏向自己家模型写出来的答案。
推理题评分不靠谱——它明明自己会做这道数学题,看了别人的答案反而被带偏,判错。
针对这四条,对应的回避动作是:
- 交换位置跑两遍,两次都判同一个答案赢,才算真赢;
- 在评分标准里写死"长度不计分",或者干脆把输出截到相近长度再比;
- 别用被评模型自己当裁判,换一家;
- 遇到数学、逻辑这类题,让它先独立算出答案,再对照评分。
下面这段裁判 Prompt 可以直接改着用:
你是一名严格的答案评审。请依据【判定标准】给【待评答案】打分,1—5 分。
判定标准:{在这里写清什么算好、什么算坏、哪些内容绝对不能出现}
打分要求:① 长度与篇幅不计入评分;② 语气只作为参考,不因表达华丽而加分;③ 答案中若有判定标准未要求的具体事实(数字、条款、接口名),必须扣分;④ 先给出扣分理由,再给分数,最后输出一行 JSON:{"score": 分数, "reason": "理由"}
用户问题:{问题}
待评答案:{答案}
那个 JSON 是关键——裁判不吐结构化结果,你就没法自动化。
裁判给的分数不重要,重要的是你在多大程度上知道它为什么会给这个分数。
知道它为什么给这个分数,才算真的在测第四步:把一堆分数变成一个数字
到这一步,你已经有了 20 条用例和每条的分数。接下来只做两件事:
一是定阈值。 公开框架(比如 RAG 场景常用的 RAGAS)只给指标定义,不给阈值——阈值得你自己定。做法是:把改 Prompt 之前那一版跑出来的分数,锁定成地板,之后只许升不许降。
二是算通过率。 达到阈值的用例数 ÷ 总用例数。这个数就是你能写进报告的那句话:"评测集 20 条,通过率从 65% 提到 85%,其中幻觉类用例从 5/8 提到 8/8。"
如果你们 RAG 场景,还可以把幻觉单独量化。RAGAS 里那个叫"忠实度"的指标,算法其实很简单,不用工具也能手推:
忠实度 = 答案里有上下文支撑的陈述数 ÷ 答案里的总陈述数。
答案说了 4 件事,其中 3 件能在检索回来的资料里找到出处,忠实度就是 0.75。剩下的那件,就是幻觉。
能把幻觉算成一个百分比,你在评审会上的发言权就完全不一样了。
最后一步,把它挂进 CI——Prompt 一改就自动跑一遍。这部分我上一篇写过(见文末相关阅读),用的是 promptfoo,配置可以直接抄。
落地五件套(建议直接存)
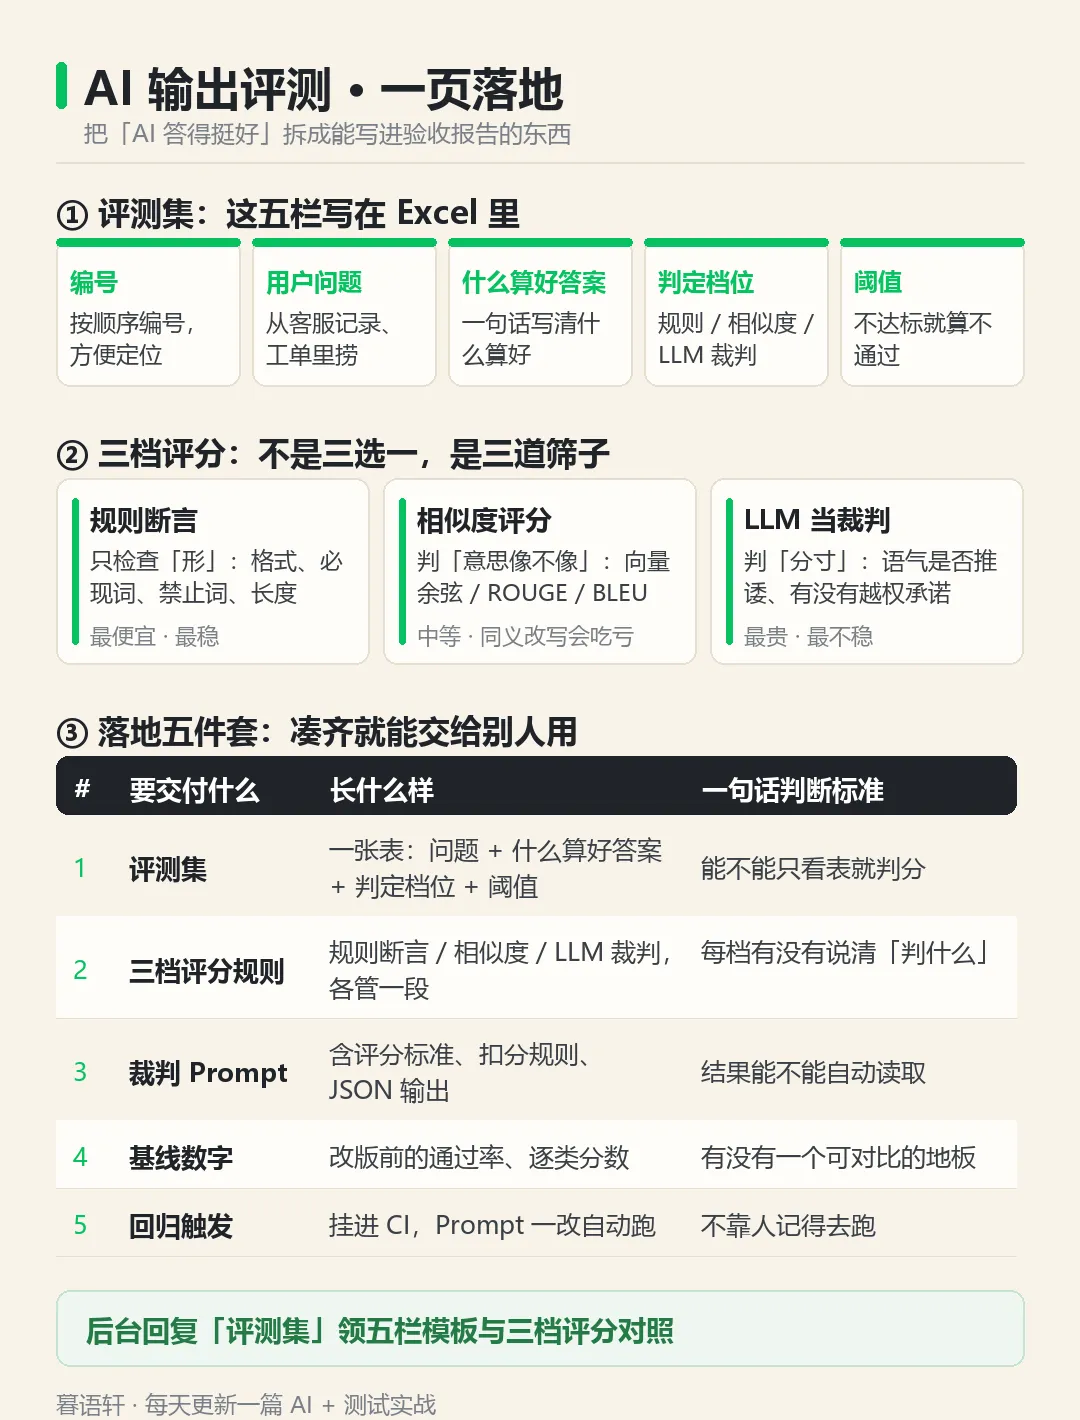
评测集五栏模板 + 落地五件套这五件凑齐,你就有一套能交给别人用的评测标准了。
今天就能做的一件事
打开 Excel,列头写那五栏,先从你业务里挑 5 个最常被问的问题,把"什么算好答案"填上。
不用想着一次做 20 条,5 条能跑通,后面就是复制粘贴。
你的第一套 AI 评测标准,起点不是工具,是那张写满"什么算好答案"的表。
最后
这是地图第 2 层的落地篇。上一篇《AI 不会报错,它只会安静地答错》讲"它会怎么坏",这一篇讲"你怎么证明它坏了",两篇配着看最完整。
这个号的文章现在都能听了——点右上角「···」→「听全文」,是我自己的声音。
评论区告诉我一件事:你们现在是靠人工看一眼,还是已经有评测集了?如果已经有点雏形,说说你们卡在哪一步,我下一篇按票数最多的那个坑写。
想要这张评测集的表格原版(含五栏列定义和三档评分对照),后台回复 评测集。
相关阅读:〈AI 不会报错,它只会安静地答错:6 类失败模式与拦截点〉|〈改一句 Prompt,3 个老用例悄悄挂了:30 分钟搭起你的第一个 AI 回归测试〉|〈AI 测试到底测什么?功能测试人转型的 4 层地图〉
数据来源:Zheng L. et al.《Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena》,NeurIPS 2023(GPT-4 裁判与人类偏好一致率 >80%,以及位置偏差、啰嗦偏差、自我偏好、推理评分能力受限等结论与缓解手段);RAGAS 开源评估框架的指标定义(忠实度=有上下文支撑的陈述数 ÷ 总陈述数)。文中阈值设定与 Prompt 为个人实践整理,非官方规范。
