做一个 AI 助手,演示时可能很顺。一旦交给别人用,问题就来了:同一个问题,昨天答对,今天答错;换了模型,费用降了,回答却变差;明明只是查个资料,怎么等了半天?
最后那句话看得见,中间发生了什么,却不好查。于是,你开始翻日志、改提示词,再凭感觉试几次。
今天介绍的开源项目 Langfuse,就是为这类问题准备的。它把 AI 的运行记录、效果评测和提示词管理放在一起,让你有依据地改进自己的 AI 应用。
它适合已经在做 AI 助手、知识问答或自动化工作流的人。你负责搭应用,它帮你看清应用到底运行得怎么样。
一次回答,能拆开来看
假设你做了一个公司资料助手,用户问:“出差打车怎么报销?”AI 回了一个过期标准。
问题可能出在三个地方:没搜到新制度;搜到了,却没放进提示词;资料没问题,模型理解错了。只盯着最终回答,很难分清该改哪里。
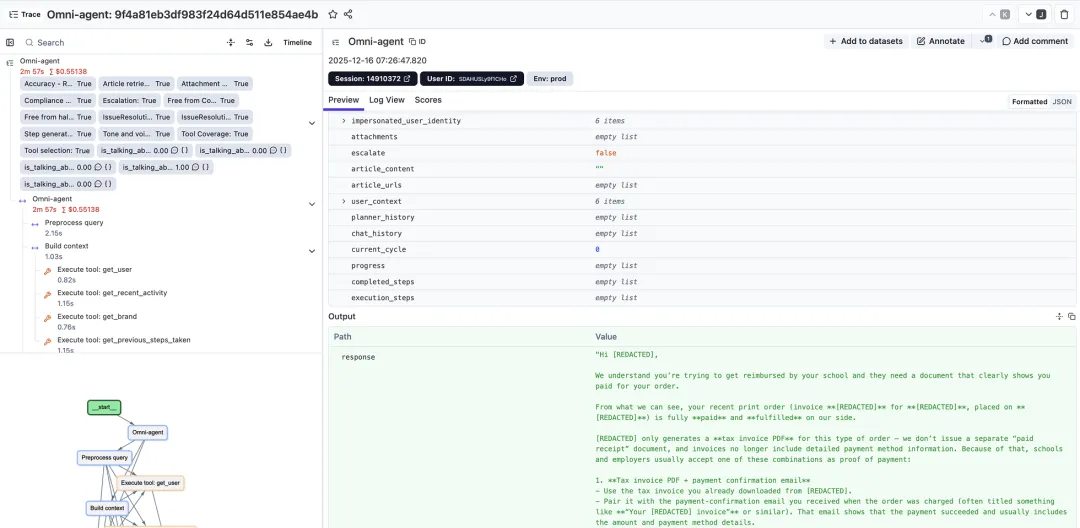
Langfuse 用 Trace(一次请求的执行记录),把模型调用、资料检索和工具执行串起来。接入并记录这些步骤后,你可以展开查看输入、输出、耗时,以及模型的用量和成本信息。
这样,答错先看资料有没有传对;变慢先看哪个步骤耗时;费用上涨先找高用量的调用。排查有了具体入口,修改也能落到具体环节。
▲ 官方发布的 Canva 案例截图:左侧是调用步骤,右侧是输入和输出
这一点在真实产品里尤其有用。官方介绍的 Magic Patterns 是一个 AI 设计工具,一次生成要经过多个处理环节。团队把用户问题关联到 Trace,收到反馈就能查看当时的执行过程,不必让用户反复描述、自己盲猜。
改好了没有,用同一套题验证
查出问题后,你修改提示词或换模型。下一步要回答的是:新版本到底有没有变好,会不会把原本答对的问题改坏?
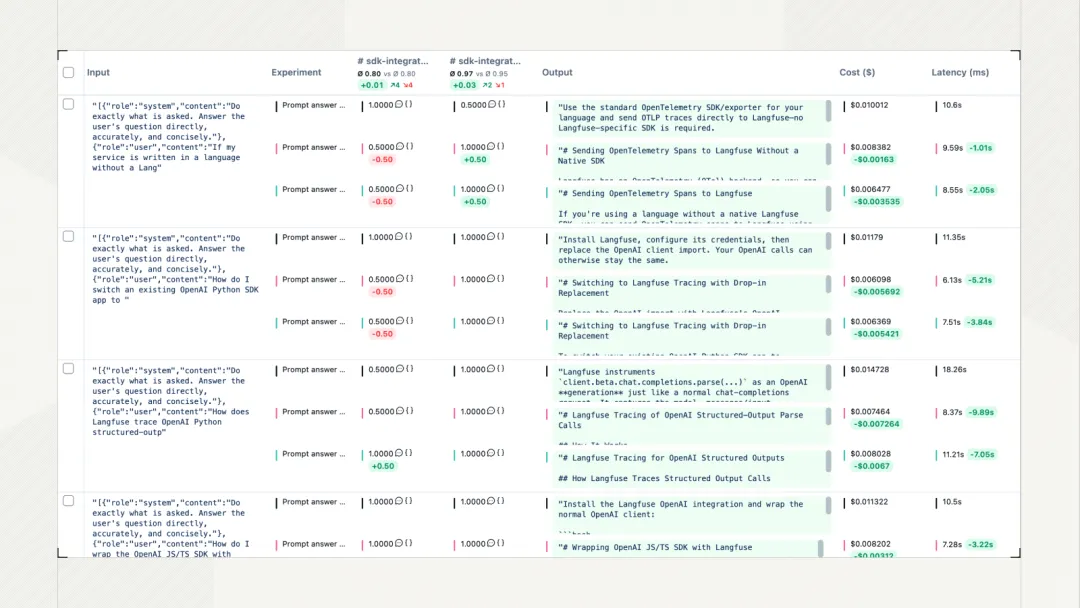
Langfuse 可以保存测试题库,运行实验,把不同版本的回答、评分、耗时和成本放在一起比较。也能从真实请求中挑出问题样本,加入题库,留给下一轮测试。
▲ 官方实验对比界面
这里有个实用做法:记录回答必须满足什么,而不是只存一段标准答案。
比如报销问题,合格回答应包含现行金额上限、票据要求和制度出处;资料不足时,应明确说无法确认。符合这些条件就有价值,没必要要求模型逐字背答案。
规则明确的项目,用代码检查;涉及语义和语气的项目,可以让另一个模型按标准打分,再用人工抽查校准。评分模型也会判断错,关键问题仍要逐题看。
官方发布的 Slite 案例很能说明价值:团队原来用表格人工跑题、评答案,后来把约 100 道题放进 Langfuse,按预期行为评测,实验频率从季度级提高到周级。这是该团队的案例结果,不是每个人接入后都会得到的提升。
提示词,也能管理版本和回退
提示词一多,很容易出现另一种混乱:文档里是一版,代码里是一版,线上到底用了哪版,没人说得清。
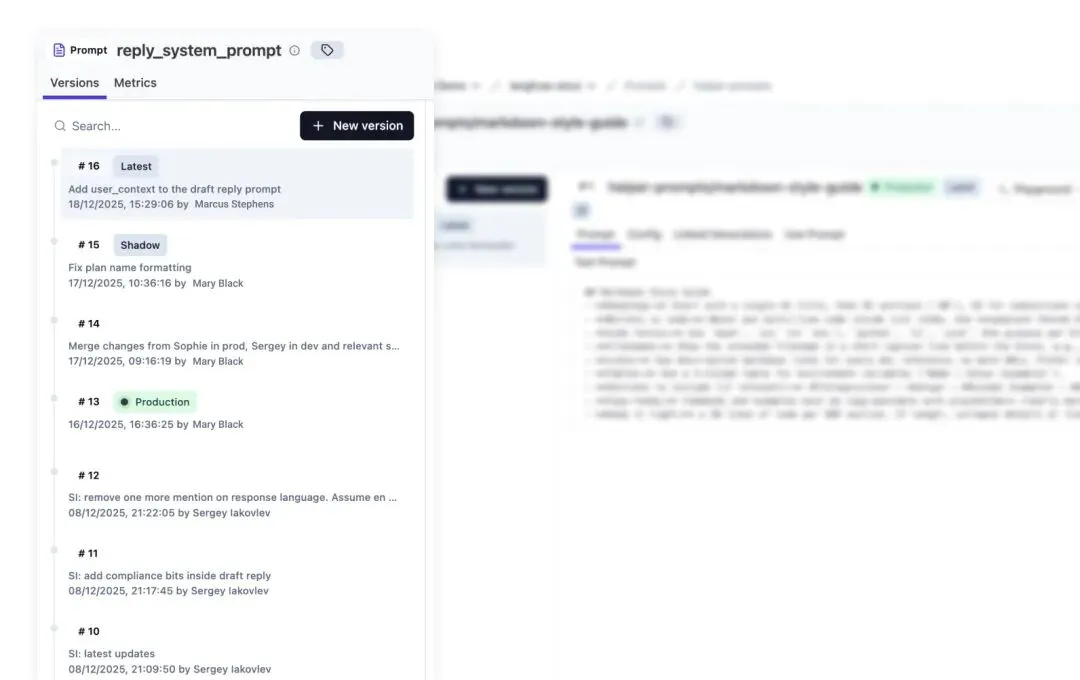
Langfuse 可以集中保存提示词,记录版本,并用标签指定应用应该读取哪一版。把提示词关联到运行记录后,也更容易追溯某次回答用了什么配置。
测试通过再切换生产版本;效果变差,就把标签切回已验证版本。前提是应用已经接入这套读取方式。
▲ 官方 Canva 案例中的提示词管理界面
Canva 的使用方式还有一个值得借鉴的地方:工程师负责接入和排查,产品、测试、内容及业务人员参与改提示词、标注和评测。官方案例中,日本市场的营销人员就设置了专门检查商务语气的评估器,让懂业务的人直接参与质量改进。
为什么值得单独用一个平台?
日志能记录调用,表格能整理题目,脚本也能跑评分。Langfuse 的吸引力,在于这些工作能够连起来:从真实问题找到执行记录,把样本加入题库,验证修改,再观察上线后的效果。
应用持续更新时,这套流程比临时试几道题更容易复用。代码开源、支持自部署,也让你多了一种自己管理运行数据的选择。
想试试,先把门槛说清楚
Langfuse 是管理和改进 AI 应用的工具。安装它,不会附送一个能替你完成业务的聊天模型;运行提示词实验或模型评分,需要配置相应的模型连接。
轻量体验可以先看官网的公开示例项目,再使用 Cloud 免费档。想观察自己的应用,需要通过 SDK 或已有集成上报数据;只记录模型调用,就看不到未接入的检索、工具步骤。
Cloud 免费档有用量和数据访问期限等限制;调用模型可能产生费用,自部署则需要承担服务器和维护成本。
第一次不必把所有功能接齐。先记录一条完整请求,再选十几个真实问题做测试。能查清一次答错的原因,能验证一次修改是否有效,就已经比“感觉这次好多了”往前走了一步。
项目入口:github.com/langfuse/langfuse。觉得有用,可以收藏起来,等自己的 AI 应用开始出现难查的问题时再试。