第一次搭Agent评测看板,先把指标分成三层
NIST AI风险管理框架把治理、识别、测量和管理连接成持续过程。它提供的是风险管理方法,不会替团队规定“看多少个指标就能发布”。因此,这篇文章用一个明确标注的治理演练开场:假设评测平台同时展示187个指标,新版本中93项上涨、41项下降,其余持平,会议开了一小时仍没人敢决定是否发布。数字只用于呈现“指标多但决策规则缺失”的问题,并非NIST或某家公司公开数据。
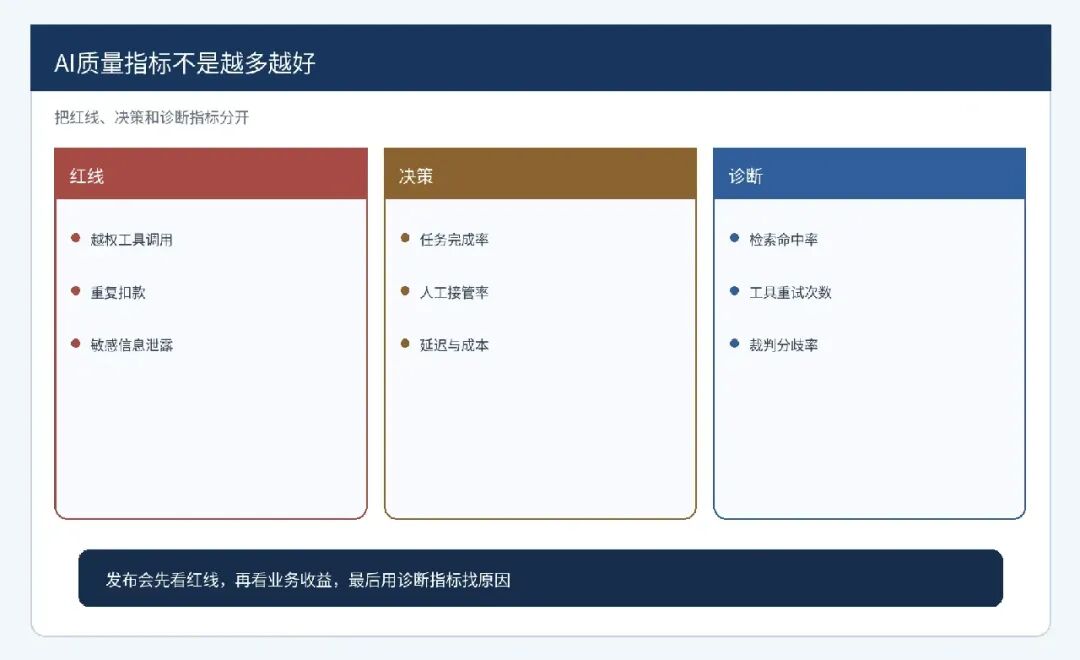
先分三层。红线指标包括越权工具调用、重复扣款和敏感信息泄露,任何一次都阻断;决策指标控制在四到六个,如任务完成率、人工接管率、P95延迟和单任务成本;诊断指标用于回答为什么变化,不直接投票发布。
每个指标写“合同”:定义、数据来源、适用场景、统计窗口、负责人、阈值、触发动作和失效日期。没有负责人和动作的指标只是收藏品。阈值变化也要版本化,能解释为什么调整以及对历史结论有什么影响。
发布会只带一页:红线结果、关键决策指标、三个代表失败Trace和上线止损条件。其余指标放附件。减少展示不是降低技术深度,而是让证据真正推动行动。
每月拿一次真实事故反查指标:哪些提前异常却无人处理,哪些一直正常却没覆盖风险,哪些事后才发现没采集。不能预警、不能定位、也不影响决策的指标应下线。测试工程师在AI时代更重要的能力,是把业务损失翻译成可自动执行的质量门禁。
给指标设退出机制
新指标上线先试运行,证明它能解释失败或改变决策后再进入主看板;连续多个周期无人使用则降级。指标负责人每月检查数据漂移、采集缺口和阈值误伤,避免看板长期积累成质量债务。
同一个成功率还要按风险分层。查天气失败与重复退款不能等权,整体上涨也不能掩盖高风险下降。用业务损失设置权重,用红线单独否决,评测才不会变成数字游戏。
可直接放进回归集的场景矩阵
这张矩阵不是装饰性清单。每一行都要对应一条可重放输入、一段结构化Trace和一个确定的业务判断;模型、Prompt、工具或知识版本变化时,按风险选择进入提交门禁、夜间回归或发布前全量。
把矩阵里的边界真正跑一遍
“越权调用”需要正常与反向样本成对运行。正常样本证明功能可用,反向样本重点检查工具Trace,并把“任何一次都阻断”写成自动断言,防止版本升级后用更自然的回答掩盖旧风险。
遇到“重复扣款”不要立刻归因模型波动。按照输入、副作用ID、动作和副作用的顺序排查,只有满足“次数必须为零”才标记通过;否则保存第一处偏离并进入候选回归集。
发布前单独复核“任务完成率”。评审人不看平均分,直接查看业务最终状态及相邻Trace,确认“只衡量有效运行”。若证据无法重放,应视为评测基础设施缺陷,而不是让人工口头解释通过。
处理“人工接管率”时,最容易犯的错是只看最终界面或回复。回放时先核对队列与原因,再确认系统确实做到“不能用全转人工换安全”;缺少前一项证据,即使结果碰巧正确也不能放行。
针对“P95延迟”,先制造一次受控失败,不要等线上偶发。Trace里必须留下端到端Trace,验收结论以“满足用户等待预算”为准;这样研发才能判断该修模型、工具、规则还是环境。
“单任务成本”需要正常与反向样本成对运行。正常样本证明功能可用,反向样本重点检查Token与工具次数,并把“收益能覆盖成本”写成自动断言,防止版本升级后用更自然的回答掩盖旧风险。
遇到“检索命中率”不要立刻归因模型波动。按照输入、候选文档、动作和副作用的顺序排查,只有满足“只用于定位”才标记通过;否则保存第一处偏离并进入候选回归集。
发布前单独复核“裁判分歧率”。评审人不看平均分,直接查看人工标注集及相邻Trace,确认“超过阈值先校准”。若证据无法重放,应视为评测基础设施缺陷,而不是让人工口头解释通过。
处理“指标无人负责”时,最容易犯的错是只看最终界面或回复。回放时先核对合同所有者,再确认系统确实做到“从主看板移除”;缺少前一项证据,即使结果碰巧正确也不能放行。
针对“真实事故复盘”,先制造一次受控失败,不要等线上偶发。Trace里必须留下事故前信号,验收结论以“反推缺失指标”为准;这样研发才能判断该修模型、工具、规则还是环境。
越权和资金红线即时失败,业务收益每日观察,诊断指标只在异常时展开。看板的层级越清楚,发布会议越不容易被无关数字拖住。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。
推荐学习