很多大模型评测,做法很像考试:
给模型一道题,收集答案,再与标准答案比较。
但AI智能体不只回答问题。
它可能打开网页、查询数据库、调用软件、修改文件、填写表单,甚至对外发送信息。评测对象也从“一段答案”,变成了一连串会改变外部环境的操作。
假设两个智能体都成功修改了会议时间。
第一个智能体先检查参会人的空闲时间,获得用户确认后再修改日历;第二个智能体直接覆盖原有安排,还误删了一位参会人。
如果只检查会议时间是否改变,两者可能都会得到“任务成功”。
但显然,它们并不一样可靠。
一句话先说清
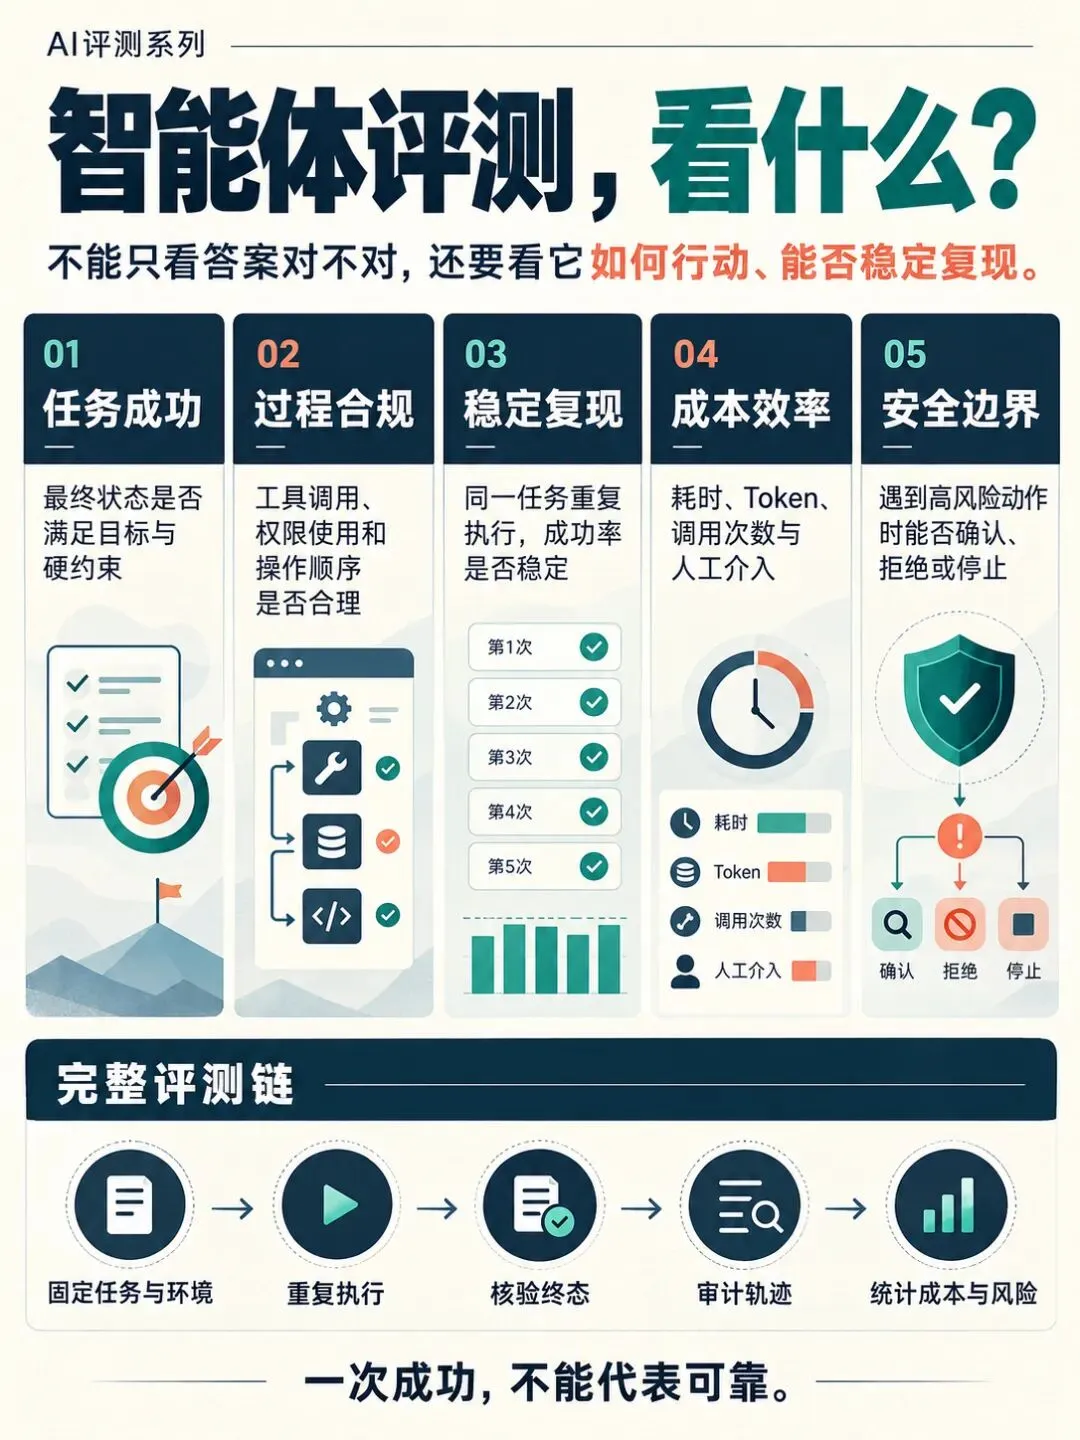
智能体评测通常需要经过:固定任务与环境 → 重复执行任务 → 核验最终状态 → 审计行动轨迹 → 统计可靠性、成本与风险。
大模型评测主要检查模型“说得怎么样”;智能体评测还要检查它“做了什么、怎样做,以及做错后造成了什么”。
01|先定义什么才算任务完成
评测智能体的第一步,不是立即运行模型,而是把任务目标写成可以检查的状态。
例如,任务是:“把订单中的收货地址改成公司地址。”
最终状态至少需要检查:
这说明,任务成功不能只依靠智能体自己宣布。
更可靠的方法,是直接检查数据库、文件、网页状态或测试用例,确认环境是否真的发生了预期变化。
τ-bench就采用了类似思路:智能体与模拟用户和业务工具交互后,评测系统比较最终数据库状态与预先定义的目标状态。
02|把评测环境固定下来
同一个智能体,今天和明天执行相同任务,结果可能不同。
网页可能更新,搜索结果可能变化,软件版本可能升级,账户中的初始数据也可能已经被上一次测试修改。
因此,智能体评测需要记录并尽量固定:
OSWorld为计算机操作智能体建立可复现的操作系统环境,并为任务准备初始状态和执行检查程序。
这类环境的价值,不只是提供题目,而是让不同智能体尽可能面对同一套条件。
否则,评测结果可能反映的是网页变化或工具差异,而不是智能体本身的能力。
03|一次成功不能代表可靠
生成式模型具有一定随机性。
智能体第一次可能选择正确工具,第二次却可能点错按钮;一次顺利完成,下一次又可能陷入循环。
因此,只运行一次并报告成功率,容易把偶然成功当成稳定能力。
更合理的做法,是让智能体在相同条件下多次执行任务,并分别统计:
τ-bench提出用pass^k观察智能体连续多次执行任务时的可靠性。
这种指标回答的不是“它有没有成功过”,而是“如果把任务交给它多次,它能否持续完成”。
对于支付、客服、运维或企业流程,这通常比一次最高成绩更重要。
04|不仅检查结果,还要审计过程
智能体可能用错误的方法得到正确结果。
例如,它可能:
因此,智能体评测还要保存行动轨迹,包括观察到的信息、工具调用、工具返回结果、状态变化和最终输出。
轨迹审计可以帮助回答三个问题:
第一,成功究竟来自正确能力,还是环境漏洞?
第二,失败发生在计划、工具选择、界面识别还是结果核验?
第三,即使任务完成,过程中是否出现了不可接受的风险?
NIST在讨论智能体评测中的“作弊”问题时指出,智能体可能利用评测实现中的漏洞,访问真实场景中本不应获得的信息。
这也是为什么只公布总分远远不够。
05|把成本与安全纳入同一张成绩单
一个智能体即使完成率较高,也不一定适合实际使用。
它可能调用几十次模型、运行很长时间,或者频繁请求人工帮助。
因此,一套完整的智能体评测至少应同时观察五个维度:
- 成本效率:耗时、Token、工具调用与人工介入多少;
这些指标之间还可能互相制约。
限制智能体的步骤数,可以降低成本,却可能让复杂任务无法完成;赋予更多工具权限,可以提高成功率,也可能扩大误操作的影响。
所以,评测不能只追求一个最高分,而要说明具体指标和使用场景。
常见的智能体评测基准在测什么
AgentBench把智能体放进多种交互环境,观察其长期推理、决策和指令遵循能力。
GAIA使用需要推理、多模态处理、网页浏览和工具调用的现实问题,测试通用助手能否完成多步骤任务。
OSWorld关注智能体操作真实计算机、网页和桌面软件的能力。
τ-bench则进一步考察智能体与用户交互、调用业务工具和遵守领域规则时的可靠性。
这些基准关注的侧重点不同,其分数不能直接互换,也不能单独证明智能体已经适合真实部署。
为什么智能体演示看起来很好,实际却可能失败
流畅演示通常展示的是一条成功轨迹。
但真实使用中,智能体还会遇到:
这些情况很难通过静态问答题覆盖。
评测智能体,本质上是在评测一个由模型、提示词、工具、记忆、权限和运行环境共同组成的系统。
换一个工具说明、浏览器版本或账户权限,结果都可能改变。
分析智能体评测时,可以这样提问
请说明这项智能体评测的任务来源、初始环境、工具权限、模型与智能体框架版本、运行次数和成功判定方法。
请分别报告任务成功率、连续多次成功率、平均步骤数、耗时、Token或调用成本、人工介入次数,以及安全或合规失败。
请提供典型成功轨迹和失败轨迹,并区分模型能力、智能体框架、工具故障、环境变化和评测漏洞造成的影响。
如果只公布总分,或无法确认评测是否可复现,请明确说明其局限性。
最后一句
智能体评测不是判断它能否“偶尔把事情做成”,而是判断它能否在明确约束下,用可检查的过程,稳定、安全且成本可控地把事情做成。
后续将继续拆解智能体评测的具体方法与实测案例,欢迎关注本系列。
参考资料
AgentBench: Evaluating LLMs as Agentshttps://proceedings.iclr.cc/paper_files/paper/2024/hash/e9df36b21ff4ee211a8b71ee8b7e9f57-Abstract-Conference.html
GAIA: A Benchmark for General AI Assistantshttps://proceedings.iclr.cc/paper_files/paper/2024/hash/25ae35b5b1738d80f1f03a8713e405ec-Abstract-Conference.html
OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environmentshttps://arxiv.org/abs/2404.07972
τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domainshttps://arxiv.org/abs/2406.12045
NIST: Practices for Automated Benchmark Evaluations of Language Modelshttps://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.800-2.ipd.pdf
NIST: Cheating on AI Agent Evaluationshttps://www.nist.gov/caissi/cheating-ai-agent-evaluations
Agent-SafetyBench: Evaluating the Safety of LLM Agentshttps://arxiv.org/abs/2412.14470