别再迷信 AI 排行榜:只评测你真正掌控的部分
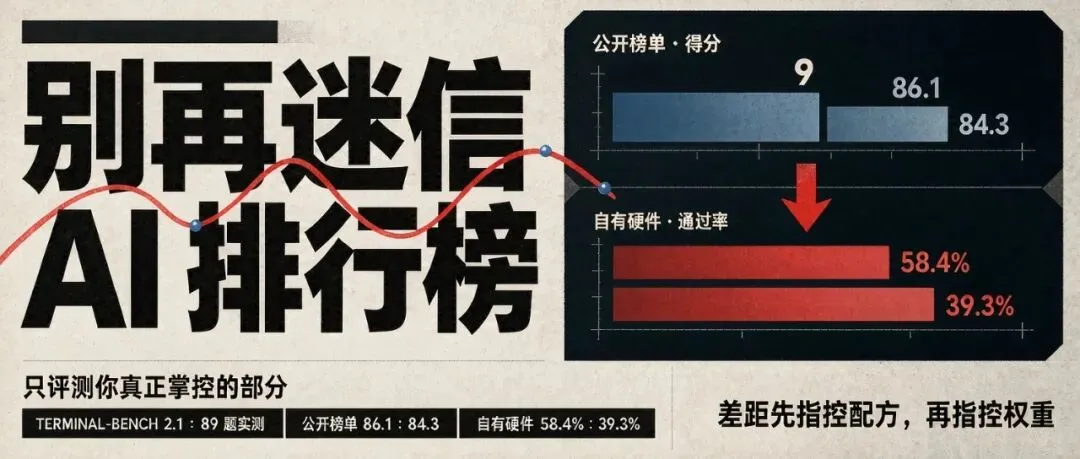
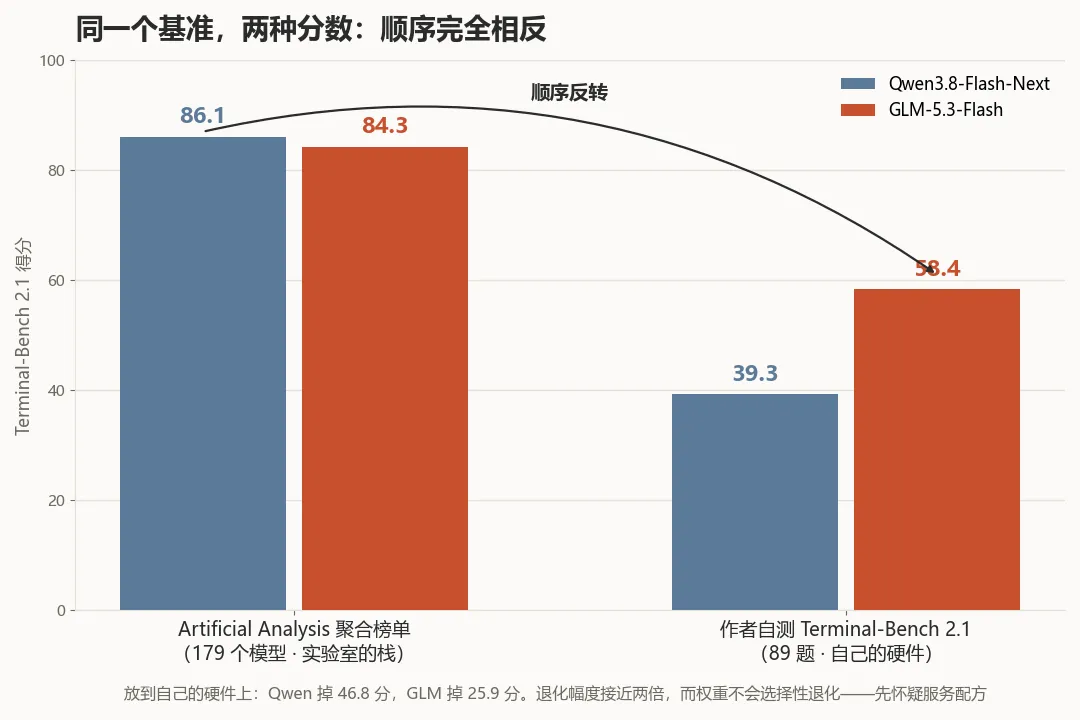
聚合榜单把 Qwen3.8-Flash-Next 排在 Terminal-Bench 2.1 的全球第九,86.1 分,这是 Artificial Analysis 测过的 179 个模型里的成绩。GLM-5.3-Flash 落后两分左右,大约 84.3。按这两个数字分配任务,Qwen 拿硬活,GLM 捡剩下的。
作者在自己硬件上跑了同一套 89 题基准,同一个开源 agent 框架 Harbor,同样的思考强度。GLM 赢了。89 题过 52 题,58.4%,Qwen 过 35 题,39.3%。差 19 个百分点,顺序和榜单完全相反。
没人测错。这才是最有意思的地方,作者跑了两次、踩了一个自己的坑,才搞明白为什么。
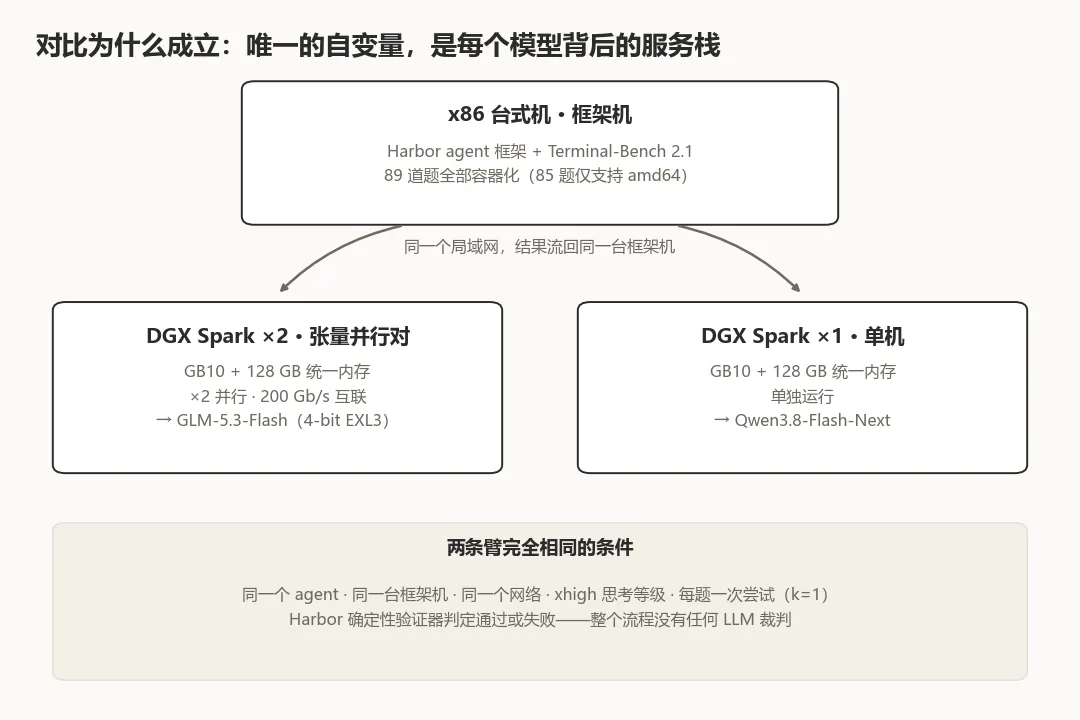
桌上是四台 NVIDIA DGX Spark,每台 GB10 加 128 GB 统一内存。两台组成张量并行对,跑 GLM-5.3-Flash,走 200 Gb/s 互联,这对机器就是日常写代码的 agent 主力。最新那台单独跑 Qwen3.8-Flash-Next。
作者先问过能不能三台一起服务一个模型,数学在插线之前就否定了:模型有 64 个注意力头,64 不能被 3 整除,张量并行要求头数在各 rank 间均分。所以拓扑就是一对大脑加一个单机,而正是这个单机让对比成立。
这里有个让对比合法的拓扑巧合。基准框架不需要和模型同机。Terminal-Bench 把任务打包成容器镜像,89 个里有 85 个只支持 amd64,要在 ARM 架构的 Spark 上跑就得模拟,时间数据全是垃圾。所以框架跑在作者的 x86 台式机上,两个模型都通过同一个局域网把结果流过去。同一个 agent,同一台框架机,同一个网络。唯一的自变量是每个模型背后的服务栈。
控制变量说清楚:任务容器里是 pi 0.85.1,两条臂都请求 xhigh 思考等级(GLM 那条线用 max 这个名字提供同一个上限),每题一次尝试,由 Harbor 的确定性验证器判定通过或失败。整个流程里没有任何 LLM 裁判。验证器要么找到它要的那个确切产物,要么找不到。
有个前提适用于下面每一个数字:k=1。每题一次尝试是有噪声的,作者会展示一个噪声是他自己造成的例子。撑起这个对比的是 89 题的分母和两条臂完全相同的条件,不是任何单独一行。
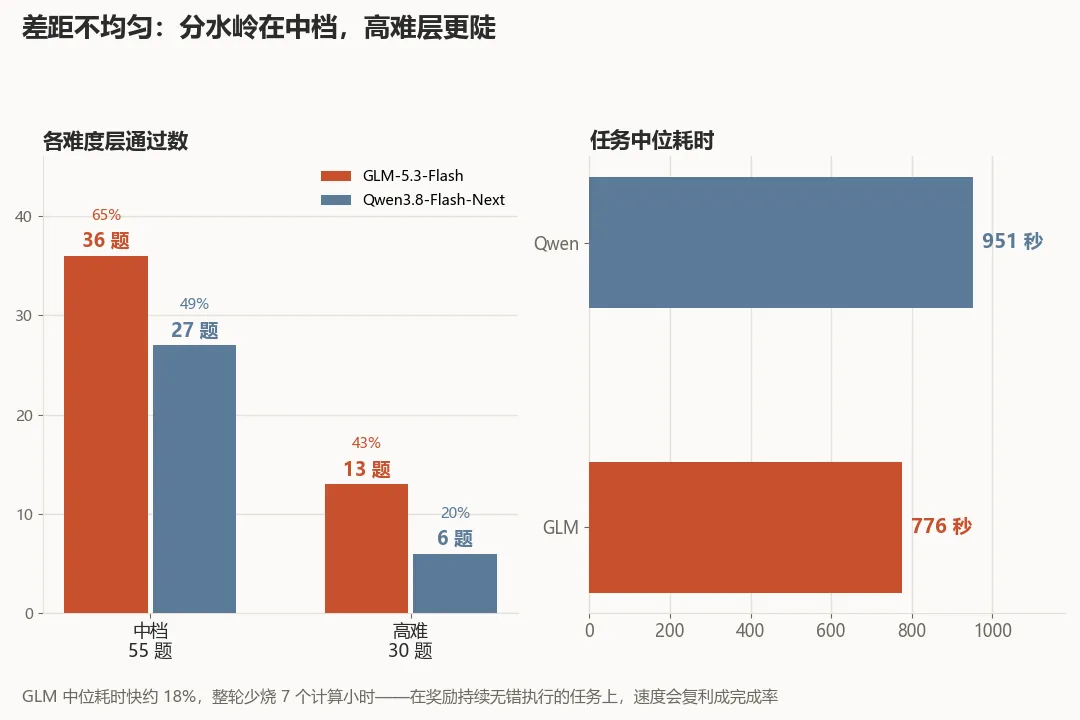
差距不均匀,这是第一条线索。GLM 在每个难度层都领先,但分水岭在中档:55 题过 36,对 55 题过 27。这些是照方抓药的任务,构建、配置、数据处理,更快的模型多清了 9 题。GLM 的任务中位耗时 776 秒,Qwen 是 951 秒,快约 18%,还少烧了 7 个计算小时。在奖励持续无错执行的任务上,速度会复利成完成率。
高难层更陡:30 题过 13,对 30 题过 6。后面会讲那里住着什么,因为那是整轮跑下来最有诊断价值的一片。
第一次完整跑出来的数字差点就被发布了,错的方式任何榜单都抓不到,因为 bug 是作者自己的。
runner 对每题强制了一个粗暴的 2400 秒硬上限。审计账本时发现,两条臂共 14 行在验证器跑完之前就被这个上限杀掉了,GLM 臂 4 行,Qwen 臂 10 行,另有 4 行返回成功但根本没有判定结果。18 行没有真实答案。验证器没跑完的任务不算失败,那是在测量作者的耐心。
关键的那条指令是:所有任务都按 Harbor 预期的方式干净运行。也就是说,agent 超时来自每个任务自己的定义,加上验证器超时,再加余量。没有个人上限。作者之前没意识到这些预算有多慷慨:大多数被截断的任务允许 3600 秒,其中一个细胞分割任务给 agent 7200 秒,再给验证器 7200 秒。那个上限相当于把一小时的考试在 40 分钟时切掉,然后判它不及格。
重跑让 GLM 赚回三题。compile-compcert 第一次在 2400 秒上限被砍,完整预算下 2283 秒完成构建并通过验证。install-windows-3.11 在 1862 秒通过。sam-cell-seg 磨了 5036 秒,84 分钟,通过;Qwen 在同一个任务上,两小时预算里大约 15 分钟就放弃了。GLM 四个上限受害者里三个在真实预算下翻盘。Qwen 翻盘两个,其余是在真实预算内按实力失败的,那是一种不同、也更正当的失败。
上面的最终数字是干净的那批。只要基准里有 agent 在环,预算就是模型分数的一部分。预算应该由任务定义决定,不是你愿意等多久。
把作者的数字和公开数字并排看两个差值。GLM 在聚合榜单上约 84%,在这套栈上 58.4%,掉了约 26 分。Qwen 是 86.1% 对 39.3%,掉了约 47 分。同一个基准,同一个框架,同样的思考等级,退化幅度接近两倍。
其中一部分差距是普遍的。实验室跑这些模型用的是全精度、自己的框架、自己的预算。作者在两台消费级价位的机器上跑 GLM 的 4-bit EXL3 量化,这有实打实的税。为了在自有硬件上跑 agent 付二十几分的税,说实话是乐意付的。GLM 的分数仍然高于聚合榜单在全部 179 个被测模型上算出的中位数 39.7%。这个基准上的大多数公开分数,一放到中位数旁边就不那么唬人了。
但不对称才是发现。两个模型在相同条件下掉的分数不一样,而权重不会选择性地退化。剩下最简单的解释是:在单台 Spark 上服务 Qwen 的配方,它的量化、它的 KV 池、它的投机解码配置,正在白白丢掉真实准确率,和模型本身无关。作者在视频模型上见过同样的剧情:同一份权重,只改推理配方,生成的动态先是崩坏,然后变得出色。同样的教训,不同的模态。目前的操作结论不是「Qwen 更差」,而是「这套 Qwen 路线表现不佳,而且还没证明是模型的问题」。
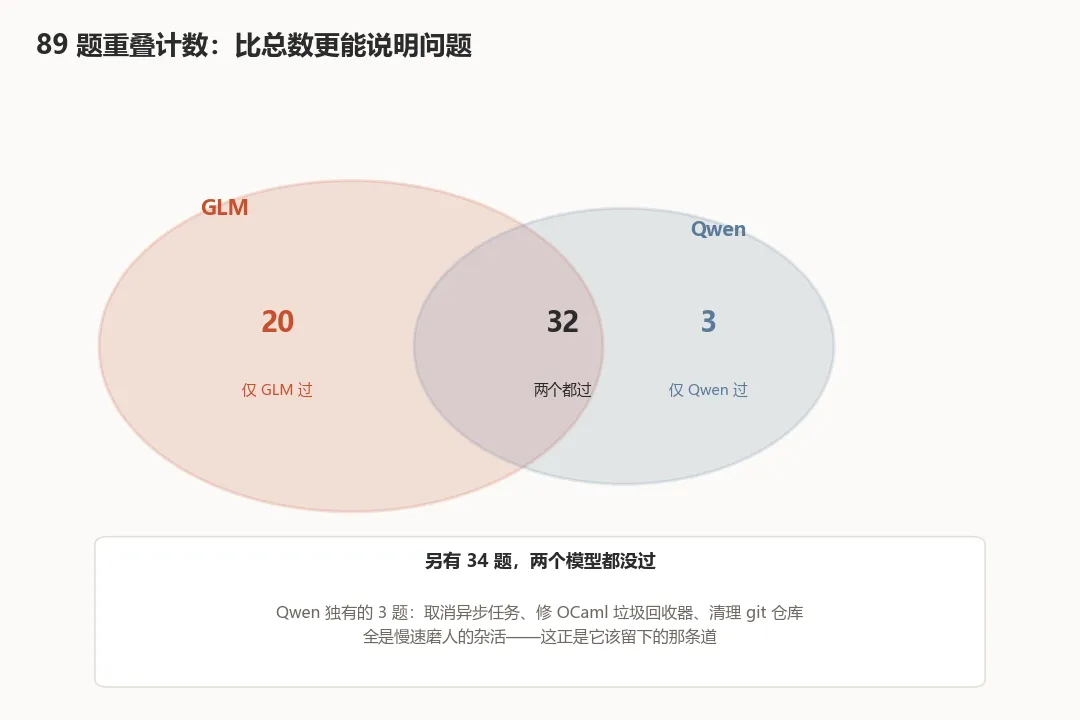
重叠计数比总数更能说明问题。32 题两个模型都过,34 题都挂,20 题只有 GLM 过,3 题只有 Qwen 过,而且那三题全是慢速磨人的杂活:取消异步任务、修一个 OCaml 垃圾回收器、清理一个 git 仓库。Qwen 唯一真正的优势是干无聊工作的耐力,这正是该把它留在的那条道。
GLM 那 20 个独占胜利是一份很具体的食谱:编译一个编译器、在 QEMU 下装 Windows 3.11、一个证明、一个差分密码分析、一个蛋白质组装、一个 Stan 里的贝叶斯 MCMC、路径追踪。已知流程,高速执行,在窗口内完成。
GLM 自己的失败也分得很干净,最大的一类有名字:没有食谱的发明。从零写一个压缩器。构建一个 MIPS 解释器,或者给 MIPS 编 DOOM。大约 9 个任务,形状都是「限时设计一个新东西并实现它」。破绽在耗时上:它 37 个失败里有 9 个结束在 940 到 960 秒之间,而预算是 900 秒。它一直干到钟响,手里还是没有正确的产物。努力不是它的问题,从想法到实现的跳跃才是。
最有诊断价值的模式是兄弟任务。GLM 过了 FEAL 差分密码分析,挂了 FEAL 线性密码分析。过了从 HTML 里拆出 JS 过滤器,挂了同一任务换框的版本。过了路径追踪,挂了反向路径追踪。它学会了技术,却无法把它弯折到变化过的框架里。它有的是食谱,不是灵活的理解,这是量化 flash 模型的经典特征,也正是前沿模型收钱去跨过的那堵墙。
还有一条值得细品:GLM 过了 llm-inference-batching-scheduler,一道关于优化推理批处理的任务。驱动作者集群的模型,在作者集群干的事上比对手更强。这个笑话不是作者设计的,是基准写的。
GLM 驱动 agent,没有余地。它每题更快,每个难度层都赢,它的失败是本地 flash 模型现在都还清不掉的那种。Qwen 保留批量编辑和并行杂活那条道,它的磨工耐力在那里才是相关技能。在把任何硬活交给 Qwen 路线之前,它的服务配方要先接受和栈里其他部件一样的调优,因为 47 分的差值先指控配方,再指控权重。如果要在两个公开分数只差几分的模型之间选,那就是掷硬币,直到有人在真正服务流量的那套栈上跑一遍。
这里没有任何一步需要拥有一台 Spark。框架是开源的,基准是公开的,它不在乎模型住在哪。如果生产流量要在两个接近的模型之间分流,用基准自带的框架对两个端点各跑一次。让每个任务自己定义的预算说了算,不要加个人上限。确认思考等级的控制真的生效了:GLM 那条臂实际提供的等级回来时挂的是另一个名字,作者是在 diff 了序列化后的 payload 之后才敢信这轮结果。然后看失败模式,不要只看总数,因为两个模型可能分数接近,失败形状却完全不同。如果某个模型与公开数字的差距明显大于另一个,那先指向你的服务配置,再指向模型。榜单把这两个模型都测对了,在别人的栈上。你的路由决定发生在服务你自己流量的那套栈上,所以对真实端点跑一遍这个套件,让那个数字来选。