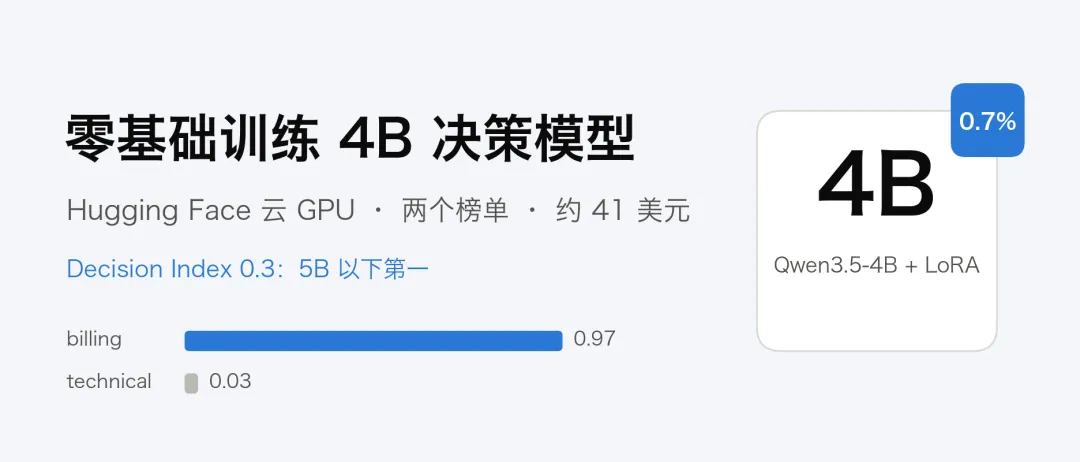
我之前没有训练过任何模型。从 2026 年 10 月 3 日开始,用了五天,我在 Hugging Face 的云 GPU 上训练出了一个 40 亿参数的模型,叫 ezjev,并提交到了两个公开榜单。
结果是:在 Decision Index 0.3 上,它在 111 个模型里排第 35,是 5B 以下所有模型中最好的。另一个榜单 JevBench 已经提交,还在免费队列里排队。
整个过程没有用自己的显卡,云上的费用一共大约 41 美元。
这篇写给和我一样没有模型经验的人:这个模型做什么、几个关键词是什么意思、怎么用 Hugging Face 的 GPU、一步步是怎么做的、两个榜单的成绩,以及每一笔钱花在哪。
这个模型做什么
ezjev 是一个“决策模型”。它不聊天,也不写文章,只做选择题。
你给它一段文字,比如一封客户邮件,再给它一个问题和几个选项,比如“该转给哪个部门:A 账单与退款,B 技术故障”。它不会回一段话,而是直接告诉你每个选项的概率。
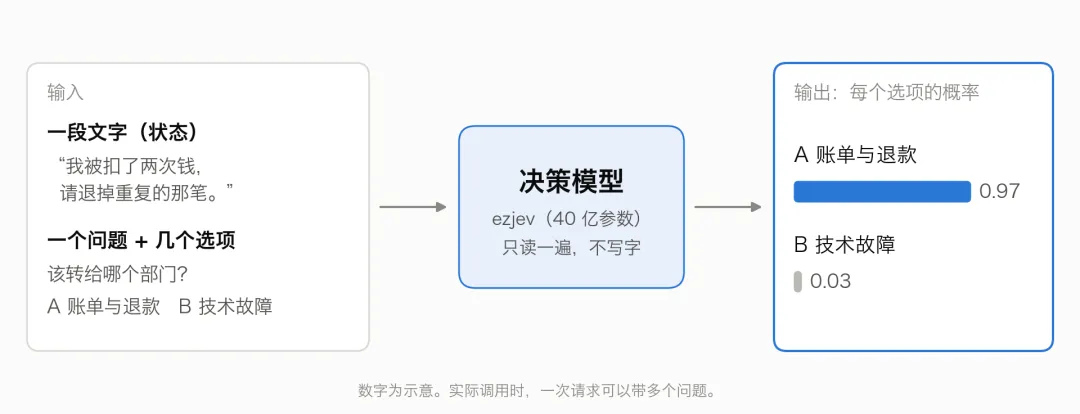
图 1:输入是一段文字加一个问题,输出是每个选项的概率。图中数字为示意。自制示意图。
这类模型适合放在程序里做大量的小判断:这封邮件是不是钓鱼邮件,这个请求该交给哪个工具,这段回答有没有编造内容。
因为不用生成文字,它判断一次只要几十毫秒。在一张 RTX PRO 6000 显卡上,ezjev 判断一次的中位时间是 34 毫秒。
这个思路来自一家叫 TypeSafe 的公司做的商业模型 Jev。社区里很多人在尝试做开源的替代品,ezjev 是其中之一,和 TypeSafe 没有关系。
先把几个词讲明白
后面会反复出现下面这些词,先用大白话解释一遍。
模型和参数。 可以把模型想成一个巨大的公式,公式里有很多可以调的数字,这些数字就叫参数。“4B”指大约 40 亿(4 billion)个参数。参数越多,模型通常越聪明,但也越慢、越占显存。
底座模型(base model)。 从零训练一个 40 亿参数的模型要花几百万美元,个人做不了。通常的做法是拿一个别人已经训练好的通用模型当起点。ezjev 的底座是阿里开源的 Qwen3.5-4B,授权是 Apache-2.0,允许免费使用和修改。
微调(fine-tuning)。 在底座模型的基础上,用自己准备的题目再训练一会儿,让它擅长一件具体的事。我们做的就是微调。
LoRA。 一种省钱的微调方法。它不改动底座模型原有的参数,而是在旁边挂上一些很小的“适配器”,只训练这些适配器。ezjev 只训练了 3246 万个参数,占全部参数的 0.71%。
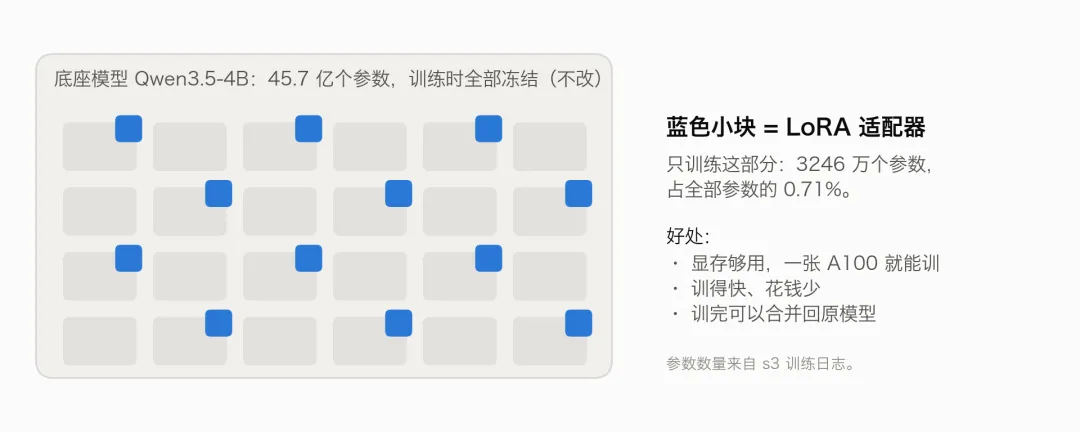
图 2:灰色是冻结不动的底座模型,蓝色小块是 LoRA 适配器。参数数量来自训练日志。自制示意图。
LoRA 的好处是显存够用、训得快、花钱少,训完还可以把适配器合并回原模型,变成一个完整的新模型。
训练集和评测集。 训练集是用来教模型的题;评测集是用来考模型的题。两者必须分开,就像不能拿期末考卷当练习册。
数据泄漏和去重。 如果评测集里的题不小心混进了训练集,模型考试时等于见过原题,分数会虚高,这叫数据泄漏。去重就是在训练前,把和评测集重复的训练题删掉。
榜单(leaderboard)和 benchmark。 benchmark 是一套标准考题,榜单是很多模型考同一套题之后的排行榜。
推理(inference)。 训练完之后,真正拿模型来回答问题,叫推理。
校准(calibration)。 模型说“我有 90% 把握”的那些题,如果实际上也对了 90% 左右,就叫校准得好。校准好的模型给出的概率可以直接拿来设阈值,比如“90% 以上自动处理,其余转人工”。
GPU 和显存。 训练和运行模型主要靠显卡(GPU)计算。显卡自带的内存叫显存,模型要整个放进显存才能跑,所以显存大小决定了能跑多大的模型。
没有显卡怎么办:用 Hugging Face Jobs
Hugging Face 是存放和分享模型、数据的网站,可以把它理解成模型界的 GitHub。它有一个服务叫 Jobs:你在自己电脑上写好脚本,用一条命令提交上去,它在云上找一台带 GPU 的机器帮你跑,跑完机器就释放。
按官方文档的说法,只要账户里有余额就能用,按实际使用的秒数计费。
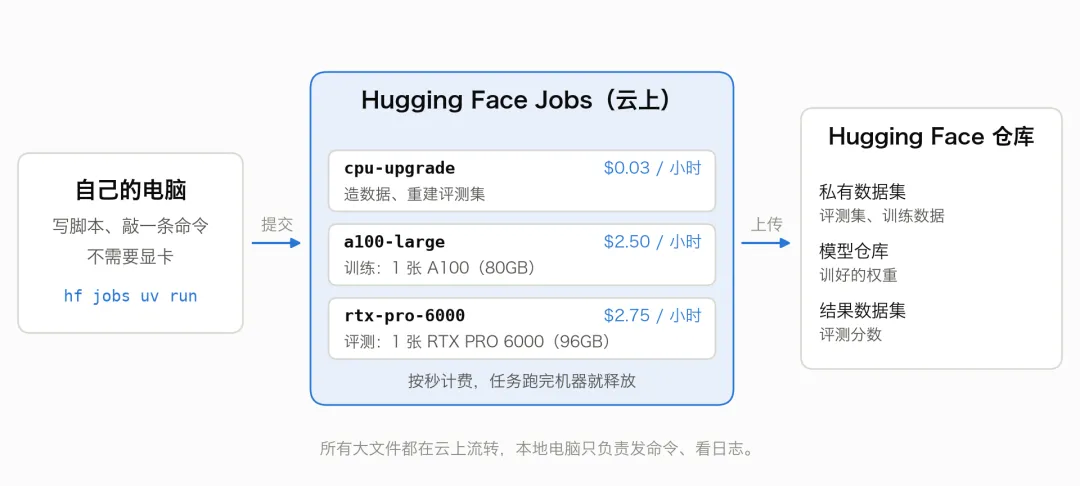
图 3:本地只负责提交命令和看日志,计算在云上进行,结果存回 Hugging Face 的仓库。价格来自 hf jobs hardware 命令的输出。自制示意图。
我们只用了三种机器:
- cpu-upgrade
- a100-large,一张 A100 显卡(80GB 显存),每小时 2.5 美元,用来训练。
- rtx-pro-6000,一张 RTX PRO 6000 显卡(96GB 显存),每小时 2.75 美元,用来评测。
使用方式很简单。在 Python 脚本开头写好需要哪些库,然后用 hf jobs uv run 提交。uv 是一个 Python 工具,会在云上自动把这些库装好。
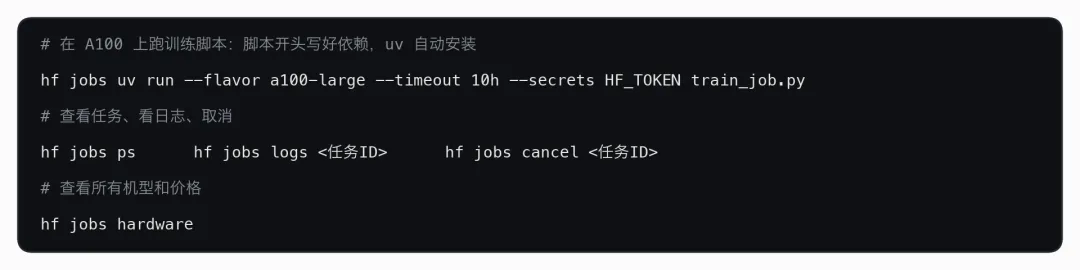
图 4:提交任务、看日志、取消任务、查价格的命令。自制。
有几个容易踩的坑:
默认 30 分钟超时。 不设超时,训练跑到一半会被自动停掉。训练要用 --timeout 设长一点,我们设的是 10 小时。
镜像里没有 CUDA 编译器。 推理工具 vLLM 默认会在启动时现场编译一些显卡程序,云上的环境缺编译器就会失败。换成不需要编译的实现就好,这不影响结果。
任务名不能带点号。 模型名里有“0.8b”,直接当任务名会报格式错误。
数据和结果都放在 Hugging Face 的仓库里:评测集和训练数据放在私有数据集仓库,训好的模型放在模型仓库。这样所有大文件都在云上流转,本地电脑只发命令、看日志,不需要下载几十 GB 的东西。
一步一步:从零到上榜
先说一句实话:代码不是我一行一行敲出来的。这个项目从第一天起就和 AI 编程助手(Claude Code)一起做:它写脚本、查文档、读报错,我负责定方向、看结果、做决定。对没有模型经验的人来说,这是能在五天里做完的主要原因。
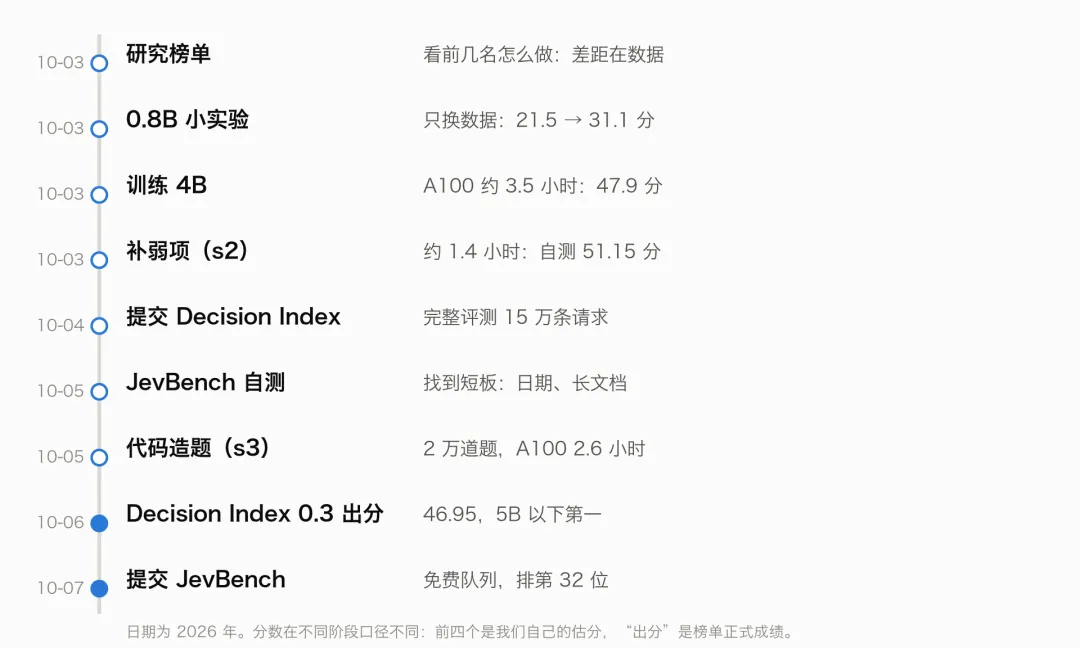
图 5:项目的主要节点。前几个分数是我们自己的估分,最后的“出分”是榜单正式成绩。自制。
第一步:先看懂榜单,再看别人怎么做
动手之前,我们先研究了 Decision Index 上排名靠前的几个 4B 模型,看它们公开的代码和说明。
结论有点出乎意料:大家用的底座模型差不多,LoRA 的设置也差不多。拉开差距的是训练数据,也就是有没有专门准备和榜单题型对得上的题。
第二步:先用小模型试错
4B 模型训一次要几个小时,几美元。为了先确认方向对不对,我们用 0.8B 的小模型做了一次对比:训练设置完全一样,只换训练数据。
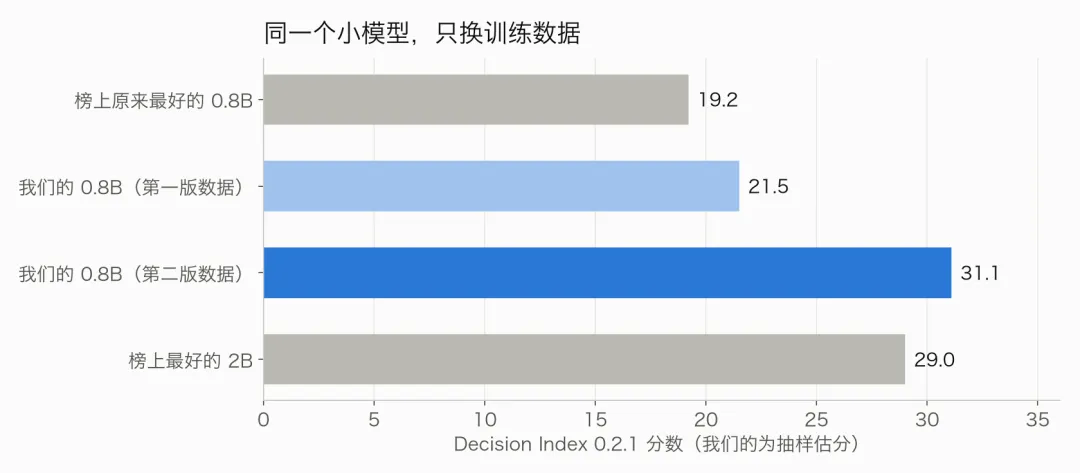
图 6:同样的 0.8B 模型、同样的训练设置,只换数据。我们的分数是每个 benchmark 抽 50 题的估分,榜上数据取自 2026-09-28 的 Decision Index 0.2.1。自制。
第一版数据是 27 个通用的公开数据集,估分 21.5;第二版按榜单的题型补齐了数据,估分 31.1,涨了 9.6 分,已经超过了当时榜上最好的 2B 模型。
这一步花了不到 6 美元,换来一个确定的结论:数据比别的都重要。
第三步:训练正式的 4B 模型
第二版数据大约 8.5 万条样本、10.6 万道题,全部来自各个公开数据集的训练部分。训练前和完整的评测集做了一遍去重,删掉了大约 5,400 条重复的样本。
用一张 A100 训练了 3 小时 26 分钟,抽样估分 47.9。
第四步:补弱项
估分里有几个 benchmark 是 0 分,其中一个是判断钓鱼邮件。原因很简单:训练数据里没有这类题。
于是我们补了钓鱼邮件和“证据是否支持某个说法”这两类数据,再加上几个弱项的数据,用更低的学习率又训了一轮,花了 1 小时 25 分钟。这一版叫 ezjev-4b-s2。
我们自己跑完了全部 150,759 道评测题,得分 51.15,然后提交给了榜单维护者。
第五步:第二个榜单,换一种思路
后来我们又报名了 JevBench。它的题更像真实业务:几千字的保单、合同,里面有修订条款和例外,还要算日期、时区、营业日。
先用公开题自测,发现模型在“日期与数字”这一类只对了 1/15,大多数错题选的都是出题人故意埋下的“表面答案”。
这类题的答案可以用程序算出来,所以我们写了一个生成器,用代码造了 2 万道同类型的题:保修期到哪天、第 14 个营业日是哪天、退款该退多少。每道题的正确答案由程序计算,错误选项则是常见的算错结果。训练没有用到任何 JevBench 的原题。
在 s2 的基础上又训了 2 小时 39 分钟,得到 ezjev-4b-s3。公开题自测从 181/231 提高到 187/231。
怎么用这个模型
模型的权重公开在 Hugging Face 上,大约 9.1GB。有一张 24GB 以上显存的 NVIDIA 显卡,三条命令就能跑起来。
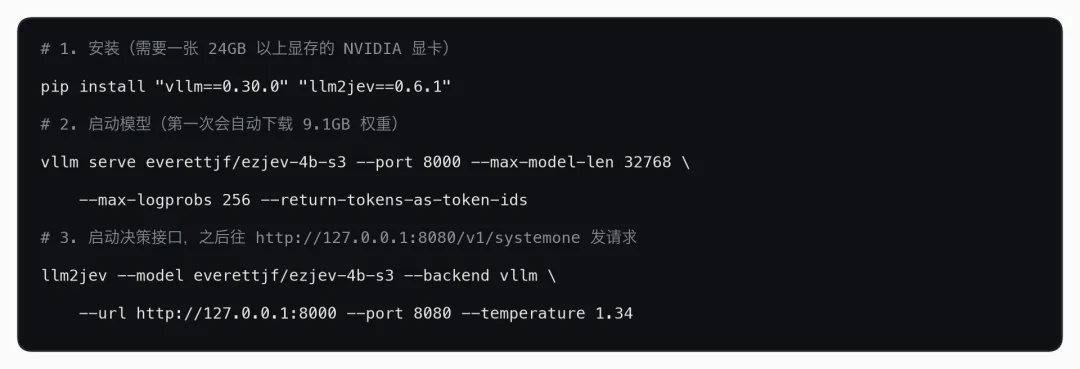
图 7:安装、启动模型、启动决策接口。vLLM 负责算概率,llm2jev 把它包装成 /v1/systemone 接口。自制。
启动后,你的程序往这个接口发一段文字和几个问题,就能拿到每个选项的概率。更详细的说明、常见报错和离线部署方法,放在项目主页上。
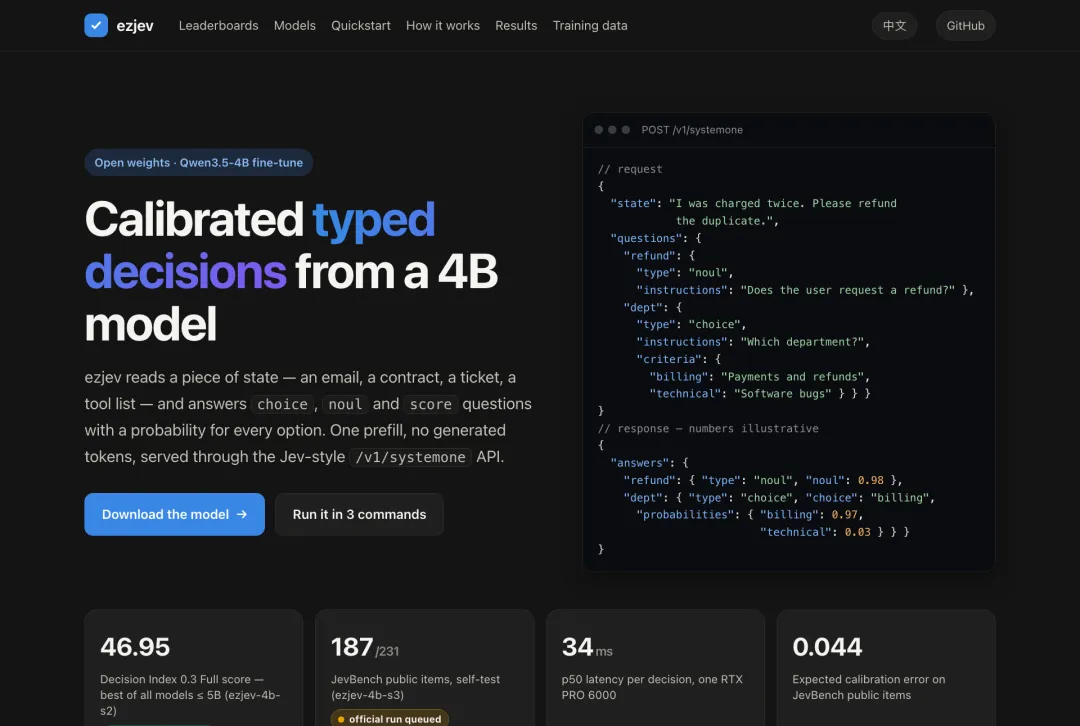
图 8:项目主页,包含模型介绍、下载、快速上手和榜单状态,支持中英文切换。实机截图。
两个榜单,成绩如何
Decision Index:111 个模型里第 35,5B 以下第一
Decision Index 是 Hugging Face 上的一个社区榜单,专门比较这类决策模型。它把 40 多个已有的学术考题改写成选择题的形式,覆盖知识推理、语言理解、检索分类、工具调用、人文判断五个方面。
10 月 6 日,它发布了 0.3 版,ezjev-4b-s2 正式上榜。
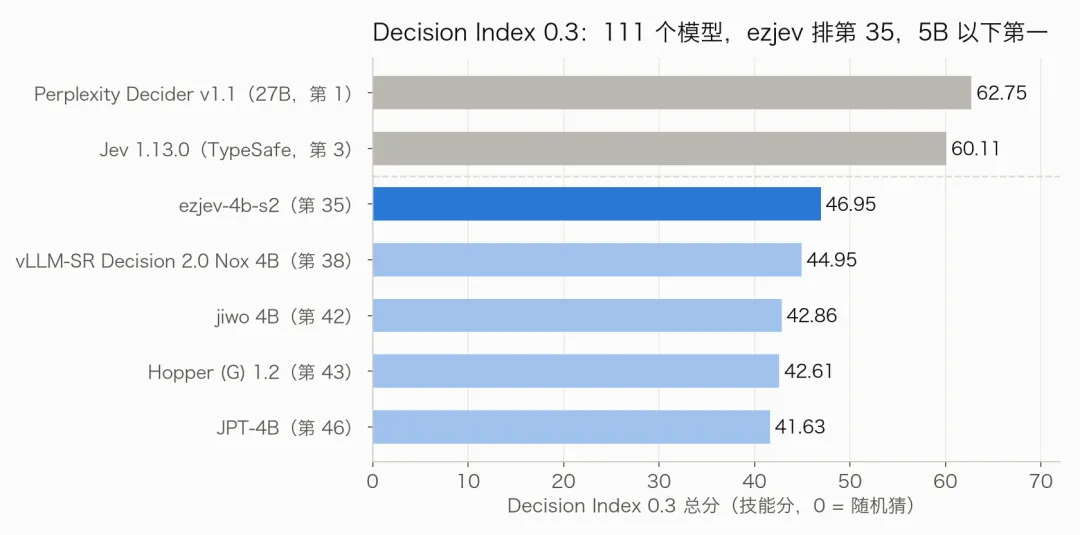
图 9:上面两行是整体排名头部,虚线下面是 5B 以下的前五名。分数为技能分,0 代表随机猜测的水平。数据来自榜单的 data/index.json(2026-10-06 生成)。自制。
ezjev 的总分是 46.95,在 111 个模型里排第 35。排在它前面的 34 个模型,参数都在 9B 以上。原来 4B 里最好的 JPT-4B 是 41.63。
但这个分数比我们自测的 51.15 低。原因是 0.3 版改了算分方法:总分里只有 20% 来自公开的考题,50% 来自同类技能的私有考题,30% 来自新领域的私有考题。私有考题从不公开,谁都没法拿来练习。
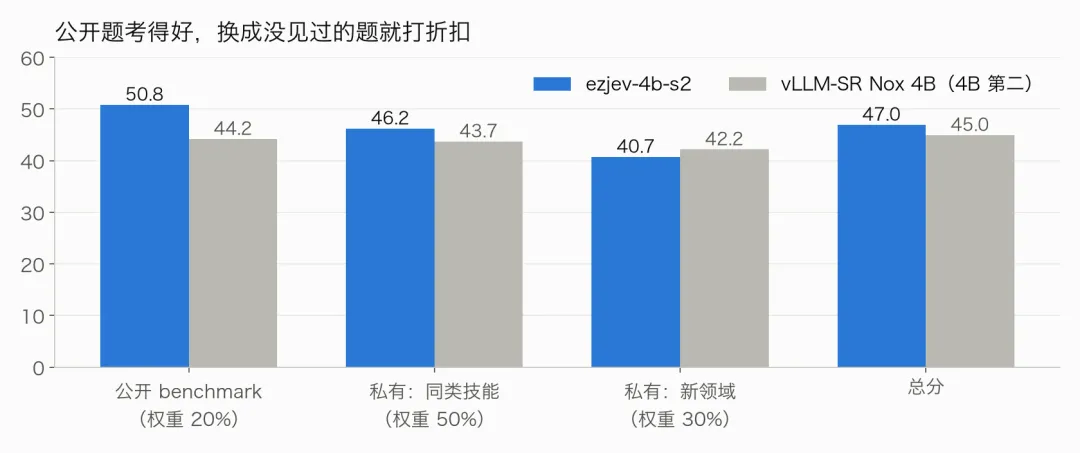
图 10:ezjev 与 4B 第二名在三部分上的得分。数据来自榜单(2026-10-06)。自制。
可以看到,ezjev 在公开题上是 50.8,到了没见过的新领域只有 40.7。4B 第二名的模型公开题比我们低 6.6 分,新领域反而比我们高 1.5 分。
这说明我们“按榜单题型补数据”的做法,有一部分只对这些公开题有效,换一批题就打了折扣。这是这次最大的教训。
JevBench:已提交,慢慢排队
JevBench 是一个人维护的业余项目。它的总分由四项组成,权重相同:准确率、校准、速度和成本。因为速度和成本也算分,小模型有机会和大模型拉近距离。截至 10 月 8 日,开源模型这一栏排第一的就是一个 4B 模型,排在后面的有 12B 和 31B 的模型。
它的题一半公开、一半封存。我们只能用公开的 231 道题自测,正式分数要由维护者在他们自己的 GPU 上跑,包括封存题。
10 月 7 日,我们通过它网站上的提交表单提交了 ezjev-4b-s3,提交后排在免费队列第 32 位。
网站也提供付费的“快速通道”,付款后 48 小时内出结果。我们没有选,决定在免费队列里慢慢等。结果出来后,维护者会发邮件通知。
一共花了多少钱
所有费用都是 Hugging Face Jobs 的按时计费,按每个任务的实际运行时长乘以单价计算。
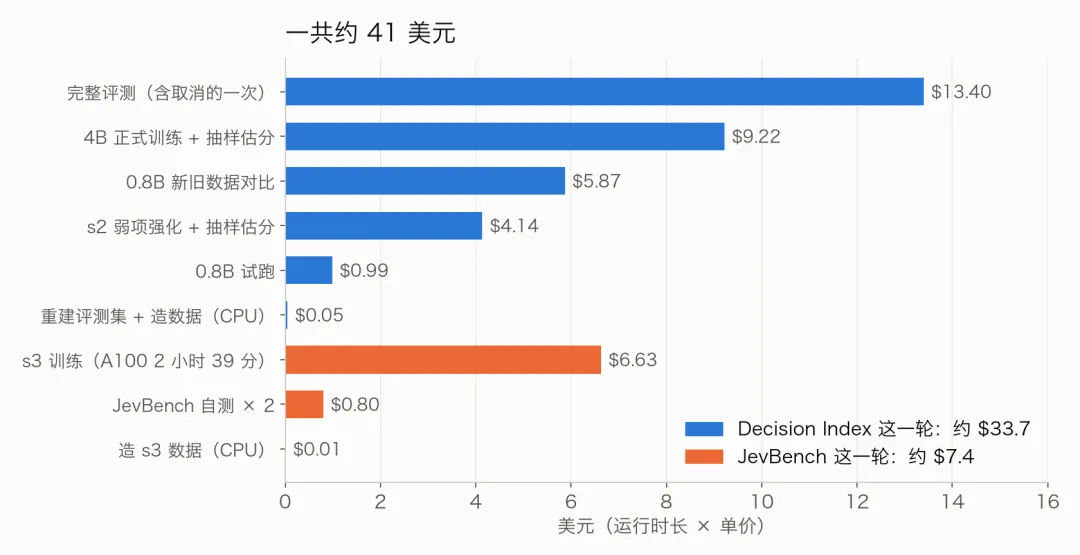
图 11:蓝色是 Decision Index 这一轮,橙色是 JevBench 这一轮。两个中途取消的任务没有记录运行时长,按此前统计的金额计入。自制。
Decision Index 这一轮约 33.7 美元,最大的一项是跑完 15 万道题的完整评测,13.4 美元。JevBench 这一轮约 7.4 美元,几乎都是 s3 的训练。两轮加起来约 41 美元。
如果想再省钱,有两点经验。
先用小模型验证方向。 0.8B 的对比实验花了不到 6 美元,避免了在 4B 上走弯路。
抽样估分只看趋势。 每个 benchmark 抽 50 题的估分,十几分钟就能跑完,适合比较两个版本谁好谁坏。但单个 benchmark 的分数波动很大,不要当真,最终还是要看完整评测或榜单成绩。
局限和还没解决的问题
没见过的题会掉分。 这是 Decision Index 0.3 暴露出的最大问题。下一步应该少针对具体题型补数据,多补“不依赖题目格式”的推理能力。
日期和数字推理仍然弱。 模型只看一遍就给答案,没有机会一步步算。用代码造题有帮助,但在 JevBench 的这类题上,只从 1/15 提高到 2/15。
现在两个榜单用的是两个版本。 Decision Index 用 s2,JevBench 用 s3。目标是以后用同一个模型参加两个榜单。
授权。 代码是 MIT 协议。模型权重的部分训练数据只允许非商业使用,例如 ANLI 是 CC BY-NC 4.0,商用前需要先核对。
相关链接
- 项目主页(介绍、下载、快速上手) : https://xnu.app/ezjev/
- 代码仓库 : https://github.com/everettjf/ezjev
- 模型 ezjev-4b-s3(推荐使用) : https://huggingface.co/everettjf/ezjev-4b-s3
- 模型 ezjev-4b-s2(Decision Index 上榜版本) : https://huggingface.co/everettjf/ezjev-4b-s2
- Jev Decision Index 榜单 : https://huggingface.co/spaces/multimodalart/jev-decision-index
- JevBench 榜单 : https://benchmarkheaven.com/jev-models
- JevBench 提交表单 : https://benchmarkheaven.com/submit
- Hugging Face Jobs 使用文档 : https://huggingface.co/docs/huggingface_hub/guides/jobs
- 底座模型 Qwen3.5-4B : https://huggingface.co/Qwen/Qwen3.5-4B
- 推理工具 llm2jev : https://github.com/tic-top/llm2jev
小结
没有模型经验,也能在几天内训练出一个能上榜的小模型。真正起作用的是三件事:用别人训练好的底座加 LoRA 微调,用 Hugging Face Jobs 按秒租用 GPU,以及花时间准备和题型对得上、又和评测集严格去重的训练数据。
我们在 Decision Index 0.3 上拿到了 5B 以下第一,也看到了只针对公开题补数据的局限。JevBench 的成绩还在排队,出来以后再更新。
参考来源
- Hugging Face Jobs 使用文档 : https://huggingface.co/docs/huggingface_hub/guides/jobs
- Jev Decision Index 榜单 : https://huggingface.co/spaces/multimodalart/jev-decision-index
- JevBench 提交页面 : https://benchmarkheaven.com/submit
- JevBench 代码仓库 : https://github.com/fstandhartinger/jevbench
- ezjev 代码仓库 : https://github.com/everettjf/ezjev
