写论文时,选模型最容易纠结的地方,是每一步都想用最贵的,又怕便宜一点的把文献理解错。整理六篇研究、写一段综述,真的有必要从头到尾都用顶级模型吗?
这次我把同一份研究材料分别交给GPT-6.1 Sol和Claude Opus5.5,让它们写综述,再交换初稿检查。两边都处理好了几个重要数字,互相检查后,也找到了值得修改的句子。还有一个缺口出在我整理的材料里,回到原文才补上。
下面把输入、实际反馈和修改过程放在一起。你可以跟着做完一段综述,也可以把这套方法用在自己的开题或讨论部分。本文说的Claude5.5,具体是这次在Cursor里选到的Claude Opus5.5。
一、便宜了多少,先把价格看明白
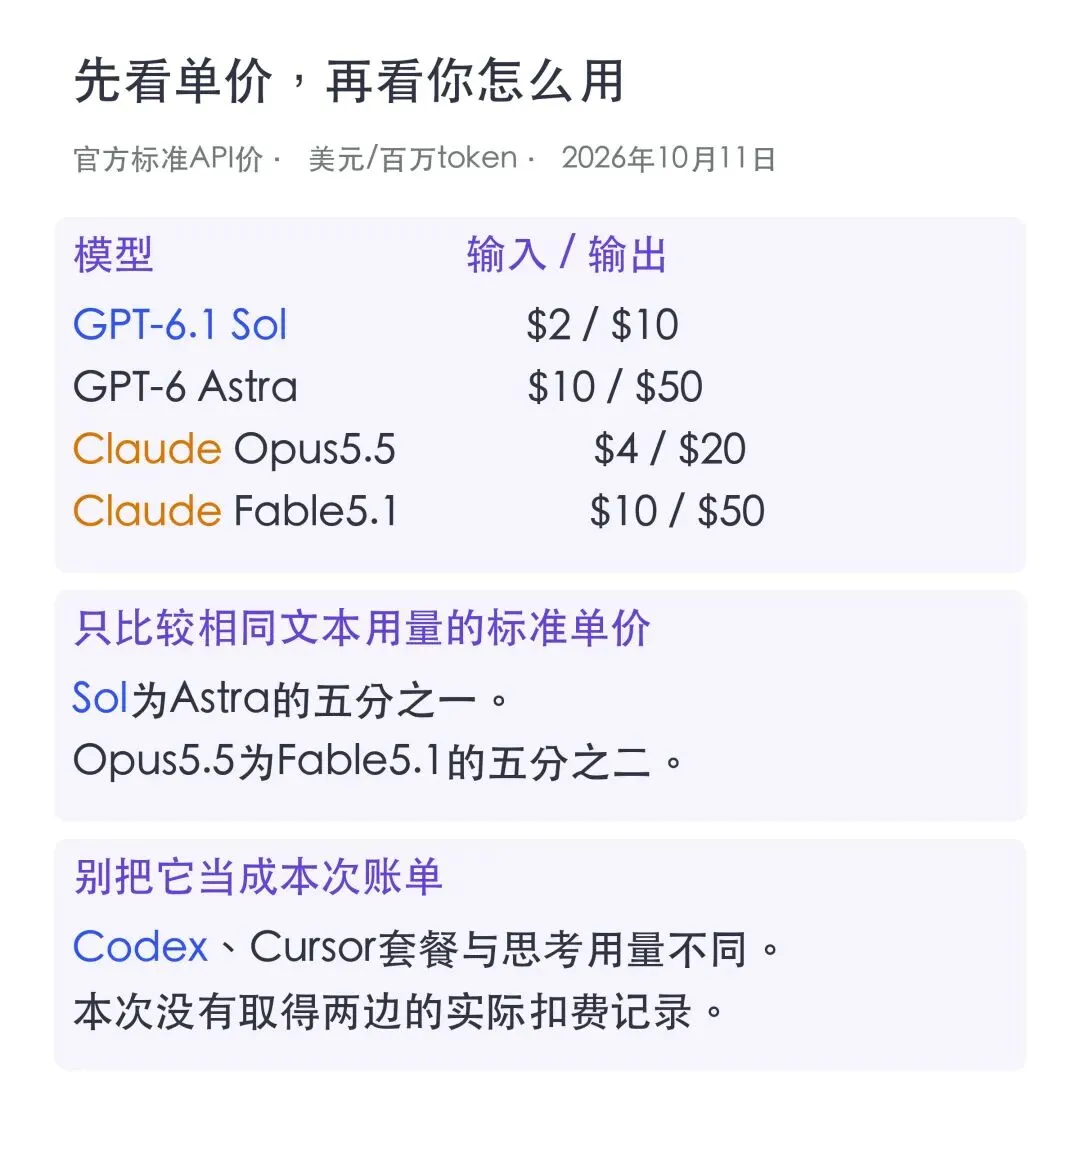
截至2026年10月11日,官方标准API价格如下。输入是你交给模型的材料,输出是模型生成的内容,token是平台计算文本用量的单位,不能直接当成汉字数。
官方标准API价格参考
按相同文本用量计算,GPT-6.1 Sol的这两项单价都是Astra的五分之一;Claude Opus5.5是Fable5.1的五分之二。这个差距,足够让人认真考虑日常任务用哪个模型。
但这张表不能当作本次实测的扣费账单。我用的是Codex桌面应用和Cursor,套餐、思考用量、缓存和平台计费都会影响实际成本。重复把整份材料贴给第二个模型,也会增加用量。便宜的模型反复跑十遍,未必比一次有针对性的检查划算。
至于能力,我不想先把它们划成“低一档”。官方产品介绍可以帮我们了解定位,能否写好眼前这一段,还得看实际回答。这篇没有测试Astra和Fable,因此不会给四款模型排学术写作名次。
二、给它们一份什么材料
这次练习的问题是,AI给学生写作反馈,能帮到什么程度,能否替代教师反馈。
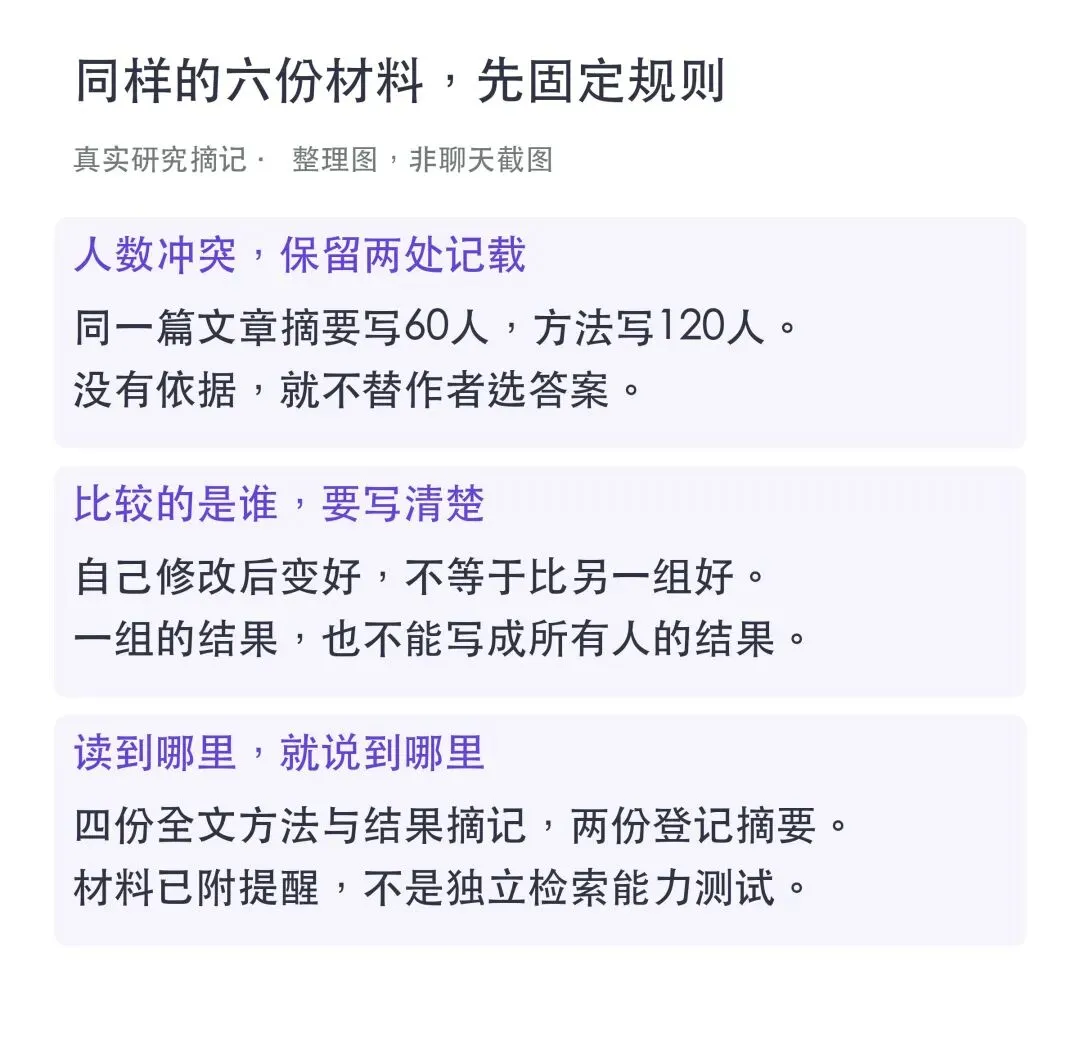
我整理了六项公开研究。其中四项核对了全文中的方法和结果,另两项只有官方登记的摘要。材料里已经写了容易误读的提醒,所以这次主要看模型能否按材料写、把几篇研究串起来,不算自主检索或独立精读六篇全文的测试。
举两条实际材料。Alnemrat等人的文章,摘要写60名学生,方法部分却写120人。这个矛盾暂时没解决,模型应当保留它。另一项研究中,AI加教师的一组比自己的初稿进步了,但这不代表它在每一项上都比单用AI的一组好。
本次材料中的三个判断点
操作很简单。在Codex里新建独立聊天,选择GPT-6.1 Sol;在Cursor里另建聊天,选择Claude Opus5.5。两边贴同样的材料,别把第一款模型的回答提前给第二款看。
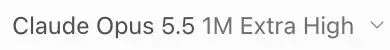
这次Sol使用xhigh,Claude使用Extra High。两个平台的设置含义不同,也没有测多次取平均,所以后面的用时只说明这一回等了多久。它们都只读我给的材料,没有联网找新论文。
Cursor实际使用的Claude档位
第一轮可以复制这段指令,再在后面贴自己的摘记。摘记至少写清研究对象、比较方式、结果和你实际读到的范围。
请只依据我提供的研究摘记,不联网,不补文献。先做一张表,列出每项研究的对象、比较方式、发现,以及写作时不能说过头的地方。再写900至1200字综述,按问题把研究放在一起讨论,不要逐篇罗列。给普通研究生阅读,保留作者年份引用。人数或结果矛盾要标出来。最后检查自己有没有扩大结论,给一段150至220字的结论。
我实际发送的长指令还固定了三个讨论问题,包括反馈质量、教师加入是否带来额外收益,以及英语课堂研究能否直接用于中文学位论文。你跟做时,换成自己需要回答的问题即可。
三、Sol先把问题分清楚了
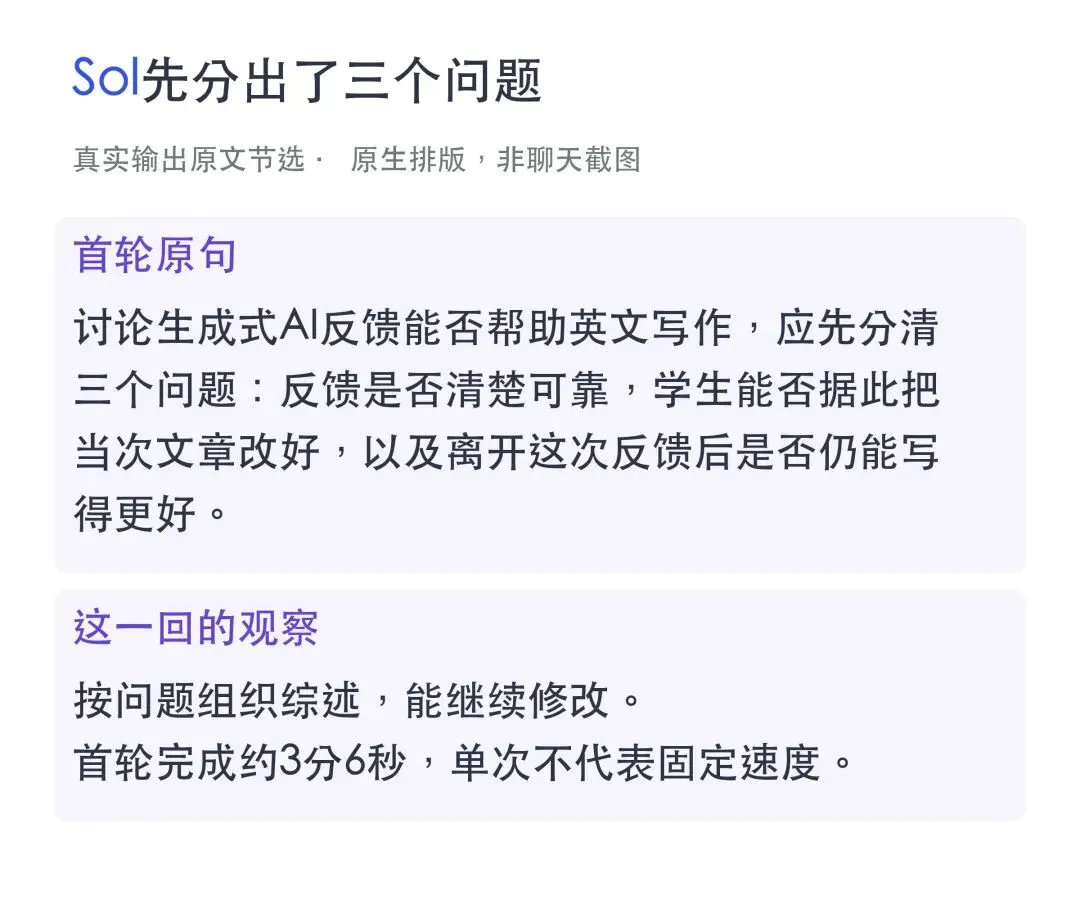
GPT-6.1 Sol首轮完成用时约3分6秒。它没有从第一篇研究开始挨个介绍,而是先区分了反馈是否可靠、当次文章能否改好、学生以后能否独立写得更好。
Sol首轮真实输出原文节选
这个开头有用。评价一份反馈写得清不清楚,和测学生成绩有没有提高,是两件事。放在综述里,也需要分别找证据。Sol后面把六项研究放到了对应的问题下,没有把200篇作文的反馈评价,写成200名学生写作进步。
人数矛盾也保留了。它写出摘要60人、方法120人,没有替作者挑一个数字。对于教师参与的好处,它同样保留了“比自己的初稿好”和“比另一组好”的区别。
因此,就这次材料整理和综述初稿而言,我会考虑先让Sol来做。它已经给出了可以继续修改的结构,没有必要仅因单价低,就把同一项整理工作立刻交给更贵的模型重做。
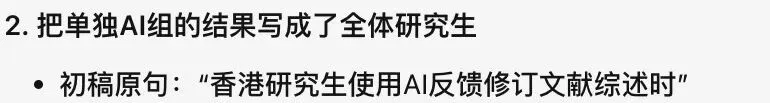
它也有需要收紧的地方。讲实验安排时用了泛指的“参与者”,讲单用AI组的结果时用了“香港研究生”,具体是哪一组不够清楚。后面Claude的检查,正好落在这些词上。
四、Claude解释得细,也需要检查
Claude首轮界面记录用时10分9秒。这一轮等待比Sol长,但平台和思考设置不同,单次记录不能当成固定速度排名。
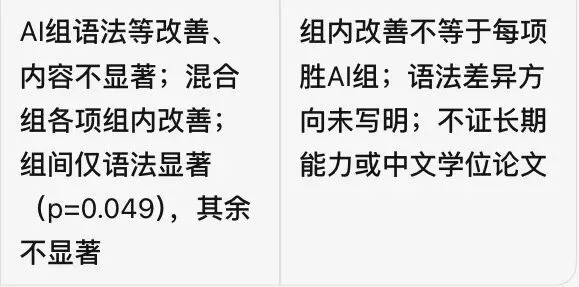
它的回答更愿意把细节展开。讲那项41人的研究时,它把两组的起点和终点都放了出来,再提醒读者考虑起点差异。它也明确说,材料没写出语法差异的方向,不能凭一个p值补出谁更好。
Claude没有补出未给出的方向
Claude自查时,还发现自己用“综合以上”开头,把一项研究的分项结果写得像六项研究的共同发现。它主动给了范围更小的替换句。这是它首轮自己发现的问题,不能算成后面另一款模型的功劳。
不过,它另有一句值得再看。它说整批材料“最多支持把AI当作修改语言细节的辅助”。这句话很谨慎,却收得过窄。材料还涉及文章组织的改善,以及包含培训和自评互评的教学安排,不能把这些都压成语言细节。
如果你正在理解一篇研究的限制,Claude这种细解释可以帮忙。若是把回答直接压成论文结论,仍要留意它有没有把谨慎写成过度保守。回答越长,越需要检查概括范围。
五、交换初稿,具体改了什么
第二轮,我把Claude的综述交给Sol,也把Sol的综述交给Claude。原材料随初稿一起提供。只让它们找具体句子,不接受一句“整体质量很好”作为检查结果。
请只按附后的材料检查这份初稿。最多指出三处问题,每处引用原句,说明哪项材料支持你的判断,再给替换句。把事实或结论范围的问题,与单纯表达建议分开。找不到错误就说没有,不要硬挑。尤其检查有没有把一组的结果写成全体,把差异不显著写成效果相同。最后给一段180至220字的替换结论。
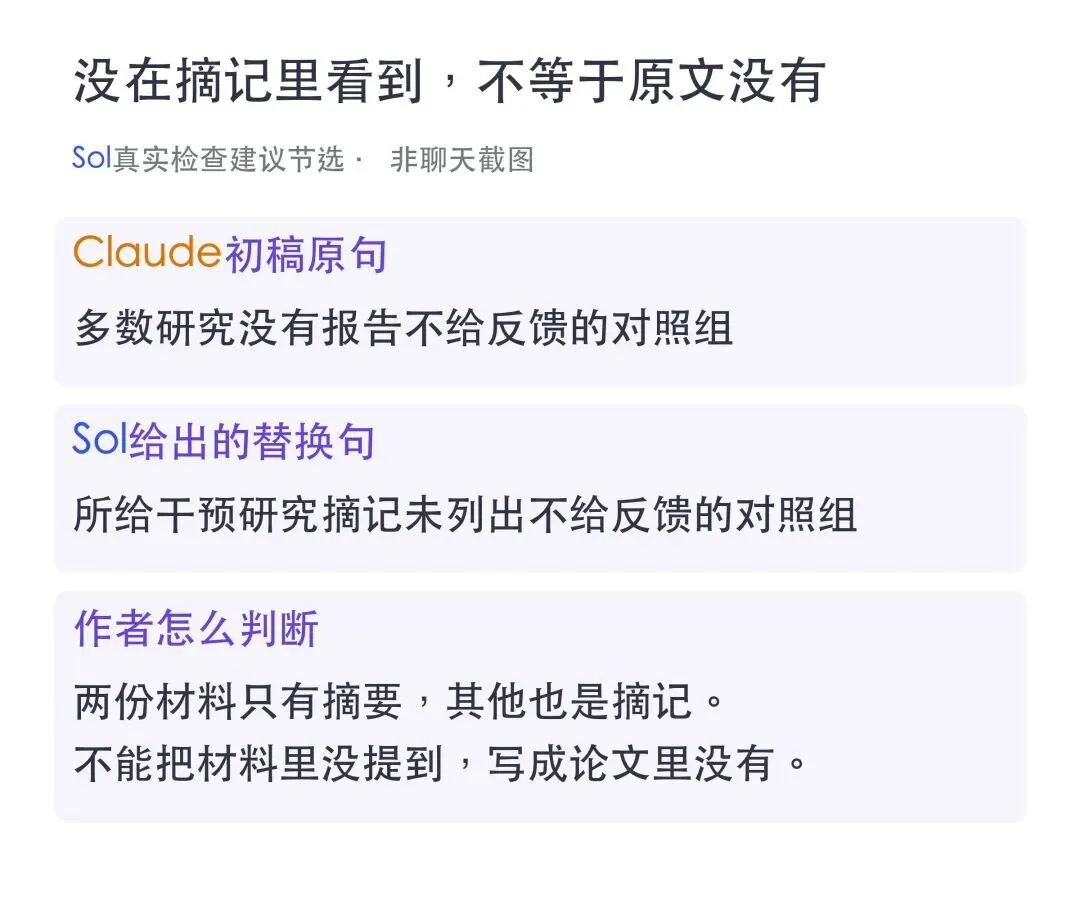
Sol找到了Claude的另一个问题。原句是“多数研究没有报告不给反馈的对照组”。我们手里有两份摘要,也只有部分全文摘记;没在摘记里看到,不能直接说原文没有报告。它建议改为“所给干预研究摘记未列出不给反馈的对照组”。
Sol交叉检查的真实修改建议
Claude则追问Sol用了哪些主语。“参与者接受了培训”,容易让人以为两组都接受了同样培训;材料明确写的是实验组。它建议直接写“实验组”,再分别交代两组人数。
另一个提醒也很具体。语法等方面改善、内容改善不显著,属于单用ChatGPT反馈的30人。写“香港研究生”太宽,换成“香港某大学单用ChatGPT反馈的30名研究生”,读者就不容易把它当成77人的共同结果。
Claude追问结果属于哪一组
这两处不需要第三款昂贵模型来裁决,拿原材料对照就能判断。对我来说,第二个模型的价值,体现在它有没有让句子更准确。如果它只是换了一套同义词,或者多写了几句赞美,我会停下,不继续追加检查。
六、有些缺口,应该回到论文里
Claude检查Sol时,还指出它写了“英文作业”,但我们给的Ding研究摘记没明确写作业语言。这条提醒不能简单算成Sol答错,因为回到全文,课程确实是学术英语写作。
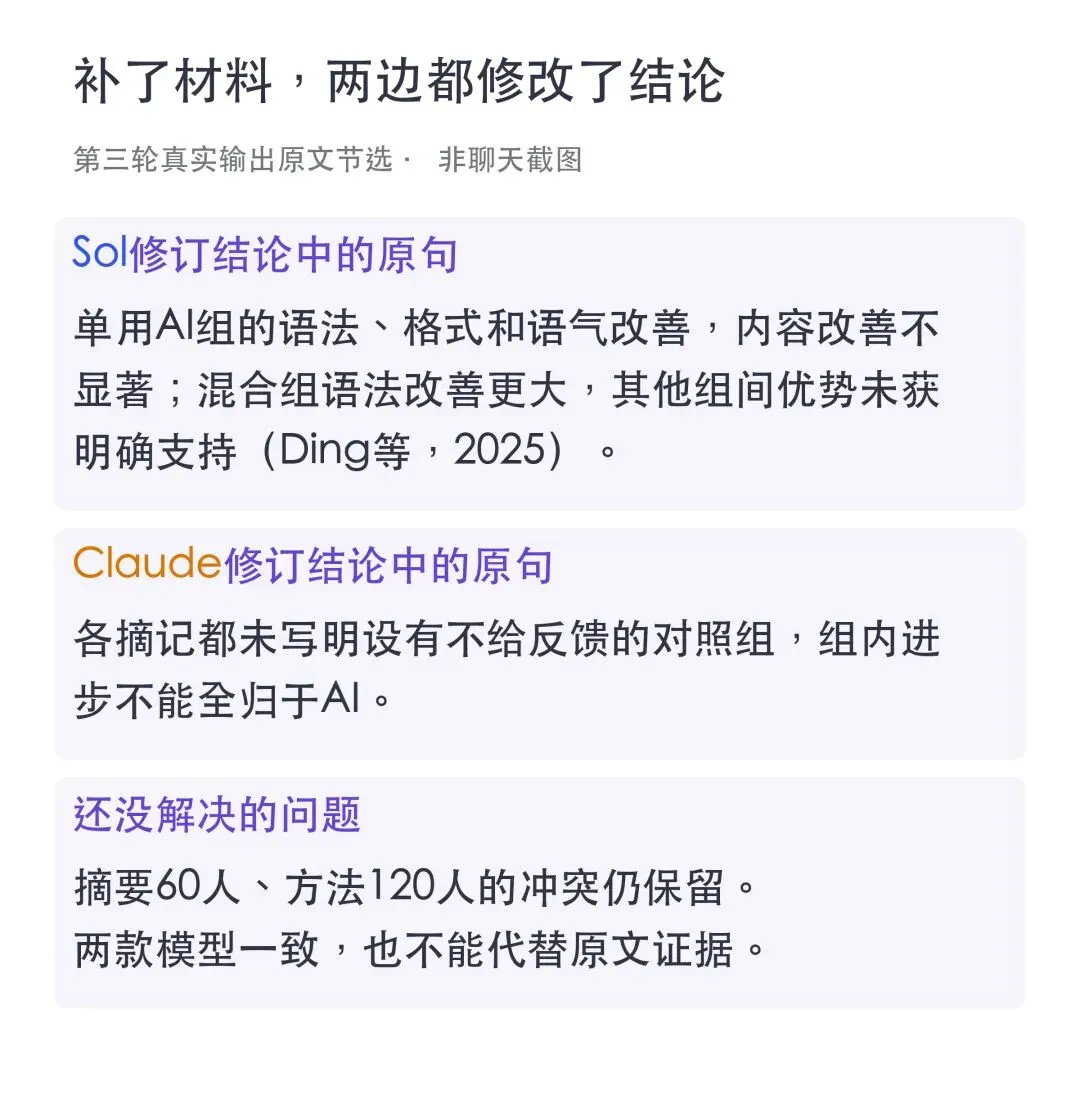
同一篇全文还明确写出,混合反馈组的语法改善更大。我最初只摘了差异显著和p值,漏了这个方向。问题出在输入材料不完整。Claude首轮说“方向未写明”,是对当前材料的准确提醒。
我把查到的语言和方向同时补给两款模型,让它们回到自己的初稿修订。这个过程也提醒我,模型意见要带着依据读,不能看到它说“实质性错误”,就把所有意见照单全收。
修订后,两边都补上了“混合组语法改善更大”,也都保留了人数冲突。Sol接受了把“参与者”改为“实验组”的建议。Claude则接受自己概括过窄,但没有直接照抄另一款模型的替换句,而是保留“可能帮助部分修改”的写法。这样的检查才值得继续,意见需要说明理由,作者也要判断是否采纳。
补充原文后两款模型的实际修订
现在回到你自己的首轮初稿。对检查意见分别说明接受、部分接受或不接受,并给出材料理由。结合我补充的原文信息,只修改结论,不重写全文。保留作者年份引用,不替原文的人数矛盾补答案。最后列出仍须回查的两件事。
人数冲突依然不能靠两个模型投票解决。摘要60人、方法120人,到底哪处需要更正,仍要查原文版本、更正记录,必要时联系作者。再加一个模型,可能得到第三种猜测,不能凭空增加证据。
七、实际写论文,我会这样搭配
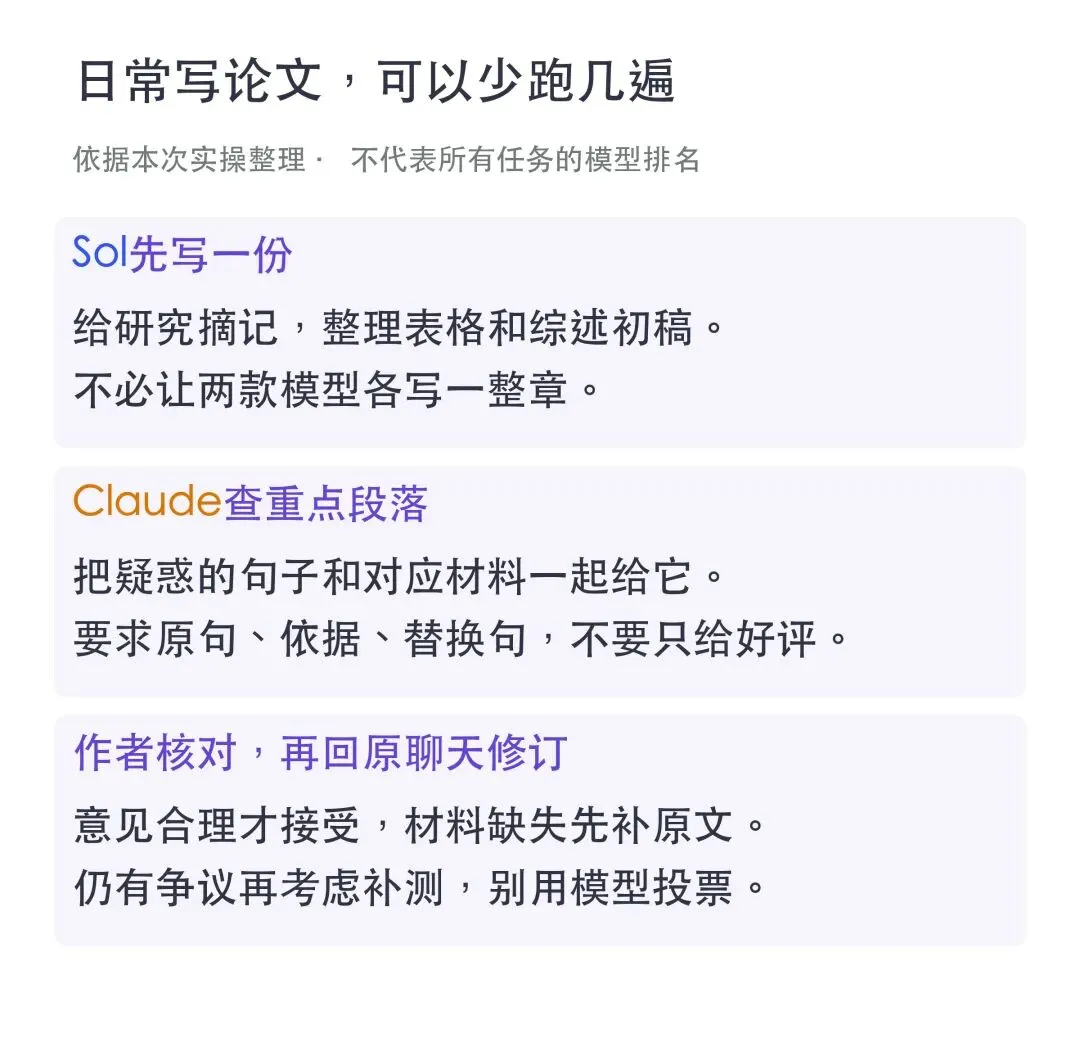
这次测试后,我更愿意先用Sol整理研究表和综述初稿,再把自己拿不准的结论段交给Claude检查。Claude适合在这次任务中追问结果属于哪一组,Sol也能检查Claude有没有把摘记缺失写成原文缺失。两边都能写,也都值得被检查,分工可以按你手里的结果调整。
日常使用时,不必像对比测试这样让两边各写一篇。先拿到一份初稿,把最重要的两三段及对应材料交给第二个模型,要求引用原句、给依据。确认有价值的意见后,再回到原来的模型修改,少让它们重复处理已经明确的部分。
把模型用在需要它的那一步
什么时候考虑Astra或Fable?当材料已经补齐,两款模型仍对复杂分析给出相反解释,你又能把争议缩成一个明确问题时,可以加做一次对照。但这里没有实测它们,不能保证升级就会答对。涉及核心统计判断或研究设计,最后仍需要你或熟悉该领域的人核对。
如果已经用AIWritePaper做了选题、大纲或基础稿,也可以从最拿不准的一段开始。把那一段和实际用到的研究材料交给模型,检查引用能否支持句子,再修改。不要把模型之间达成一致,当作论文事实已经可靠。
这次得到的是一份综述练习和几处有依据的修改,并不是完成一篇论文。对要写自己论文的人,我建议先拿一段试试。看模型能否说明这句话来自哪项研究、适用于谁,再决定是否扩大到整章。