在社交平台上常能看到 64G 统一内存 Mac 跑本地模型的测速截图,有的标着上百 tok/s [1][7]。
选本地模型,不能只看一张短提示词的生成测速图。
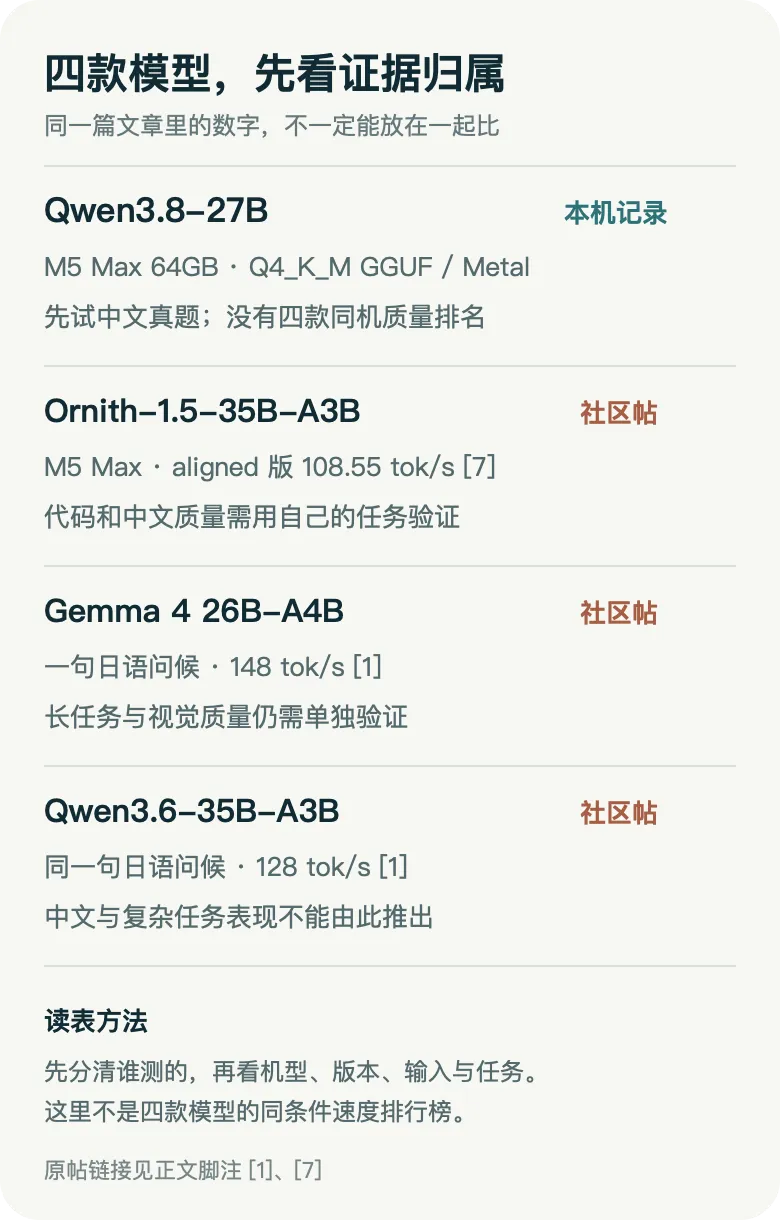
这里先明确数据归属:四款常见候选模型中,只有 Qwen3.8-27B 在本机有具体运行记录;其余三款模型的速度与表现均来自社区公开测试帖,两类数据不能当作同机同条件的横向对比。
64GB 统一内存为本地部署提供了基础,但要想选得合适,先得理清两笔账:一笔是内存账,一笔是读入与生成的时间账。
先算内存账:除了权重,还要留给缓存、运行时与系统
评估硬件时,容易只看磁盘上的模型权重体积,觉得 64GB 内存减去二三十吉字节的模型文件,剩下的空间怎么都够用。
实际运行时,除了模型权重本身,内存还要留给上下文缓存(KV Cache)、推理运行时以及操作系统与显示。具体占用取决于模型架构、上下文长度以及量化参数设置。
一旦选用的模型规格超出机器承受能力,体验会受到直接影响。社区中曾有用户在 M5 Max 64GB 上尝试运行 120GB GGUF 模型(CPU offload 设为 0,上下文 4096),中途卡住并调整设置后,实测生成速度只有约 7.8 tok/s [18][19]。原帖并没有系统的虚拟内存换页(Swap)测试数据,但这个例子反映出:当模型规模严重超出物理内存时,速度会受到明显制约。
也有人关心把模型放在高速外接移动固态硬盘里能否省内存。外接盘主要用来存放模型文件,解决内置硬盘空间不足的问题。我们并没有做过同机外接盘与内置盘在首次加载耗时和生成速度上的对比。需要注意的是,生成过程能否顺畅,取决于权重当前在统一内存中的驻留与卸载状态、可用内存空间以及推理后端;外接盘并不能替机器省下推理所需的运行内存。
读入与写回答,是两笔完全不同的时间账
看网上的跑分,大家习惯只盯住一个指标:“每秒生成多少个 token”(Generation Speed)。但在实际使用中,时间消耗往往分为两个阶段。
在本机(Apple M5 Max 64GB,基于 llama.cpp / Metal 后端,测试 Qwen3.8-27B Q4_K_M GGUF)记录的具体数据中:
在 512 输入 / 128 输出的短合成基准测试中,生成速度约为 26.25 tok/s。
在 128K 上下文容量的真实连续会话中,当历史记录累积到约 6.1 万 token 时,8 次已完成请求的加权平均生成速度约为 32.38 tok/s。需要说明的是,这组会话在运行中有累计约 97%–98% 的前缀缓存命中,且任务类型与短合成基准完全不同,两者不能当作同条件性能对照。
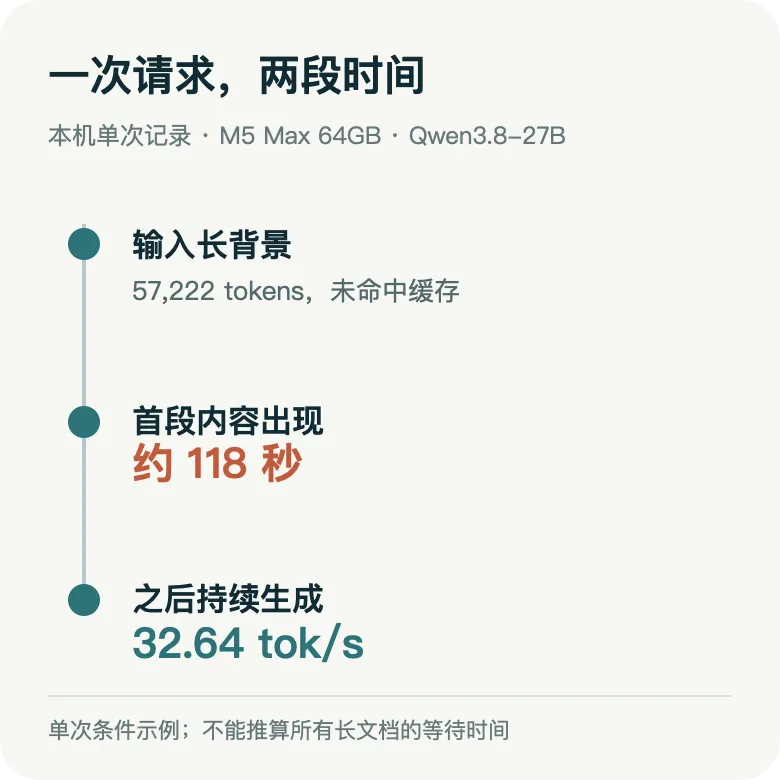
而在一次特定的长背景请求中,输入了 57,222 token 未缓存材料,机器等待了约 118 秒才返回第一段内容;首段内容出来之后,生成速度约为 32.64 tok/s。
这只是一次特定测试的记录,不能推导出所有长文档在任何配置下都必须等两分钟。但它说明了一个基本机制:读入材料(提示词预填充 Prompt Processing)和逐字吐出回答是两笔账。输入材料很长且未命中缓存时,预填充需要消耗大量计算与内存带宽,首段等待时间会明显拉长;只有在输入处理完毕或大部分前缀已缓存时,生成速度才成为主要体验指标。
关于上下文长度对生成吞吐的影响,社区用户曾有记录:在 M4 Max 64GB 上跑同一套模型时,4K 上下文生成速度为 112.1 tok/s,拉到 16K 时降至 98 tok/s [14]。这展示了生成阶段吞吐随上下文长度的变化,但并不能用来解释本机未缓存长背景下 118 秒预填充等待的具体机制。
四款候选模型怎么看:稠密与 MoE 按任务选择
目前 64G Mac 用户讨论较多的有四款模型:Qwen3.8-27B、Ornith、Gemma 4 26B-A4B 以及 Qwen3.6-35B-A3B。
需要先说明架构区别:混合专家模型(MoE)在推理时虽然每 token 只激活部分参数,但模型的总参数仍影响权重占用,因此内存需求不能只按激活参数量来估算。
1. Qwen3.8-27B:稠密架构,本机已跑通的尝试候选
作为 27B 稠密模型,每次推理调用完整参数。它是目前本机有具体运行记录的模型,适合作为中文处理与长文本整理的优先尝试候选。
本机在特定配置和任务下记录过其运行数据,但具体回答质量仍需要读者用自己的实际业务题去检查。多模态方面,官方支持图像输入,但本机目前只测过颜色、形状和数量等基础视觉识别,复杂图表与深度多模态能力仍需使用者结合实际场景自行抽检。
2. Ornith:MoE 架构,社区测试速度较快
Ornith 采用混合专家结构,推理时仅激活部分参数。
社区中有用户在 M5 Max 上测得 Ornith aligned 版本达到 108.55 tok/s [7];另一位用户在 LM Studio 下使用 q5_k_m 配置测得速度由 87 降至 77 tok/s [8]。这两组数据测试环境不同,不可合并为统一区间。
同时,多位社区用户反馈该模型在输出日语时出现过不稳定现象 [32][33]。虽然这不能推导其中文表现如何,但提醒我们在选择这类模型时,不能只看测速数字,必须单独检查目标语言的成文质量。
3. Gemma 4 26B-A4B 与 Qwen3.6-35B-A3B:看清短测试条件
社区帖曾记录 Gemma 4 26B-A4B 达到 148 tok/s,Qwen3.6-35B-A3B 达到 128 tok/s [1]。
需要注意的是,该帖测试输入仅为一句极短的日常问候(“こんにちは”)。这条短提示词记录不能代表长上下文或复杂任务下的实际表现 [1]。
此外,Google 官方模型卡标明 Gemma 4 26B-A4B 原生支持接收图像输入。社区也有测试尝试让不同模型构建待办 App [29],但该测试中各模型获得的提示词与环境指令并不完全一致,无法由此得出“稠密模型必然稳定、MoE 模型必然粗糙”的结论。
澄清两个常见的技术误读
在本地模型讨论中,有两个观点流传较广,需要根据实测条件予以修正。
误读一:“投机解码在 Mac 上没用,对中文更是负优化。”
社区也有旧配置开启多 Token 预测(MTP)后变慢的报告 [24][25],但不能一概而论。
我们在本机对 Qwen3.8-27B 进行过对比测试:
在 200K 容量的代码短提示词测试中,关闭 MTP 时生成速度为 24.45 tok/s;开启 MTP 后为 55.05 tok/s(两次输出均为 478 tokens,但不能据此断定答案质量相同)。
在中文短提示词测试中,关闭与开启 MTP 的速度分别为 24.72 与 37.62 tok/s;但两次输出长度分别为 767 与 725 tokens,文本内容并不相同,不能视作相同质量下的净提速。
社区中另有 DFlash2 投机解码的加速个例 [22],这可以作为投机解码可行性的条件性参考。实测说明 MTP 在特定代码和短文本配置下确实能带来收益,但不可将其视为全场景通用的提速开关。
误读二:“MoE 模型千万别用 8-bit 量化。”
社区帖曾指出,在特定版本和硬件环境下,SwitchGLU 算子的 8-bit 实现存在精度探针异常 [26]。
这属于底层算子在特定随机权重探针下的发现,并非针对所有 MoE 完整模型的定论。用户不必对 8-bit 量化一概否定,建议关注相关运行工具的版本更新与修复,并用自己的目标任务进行实际验证。
实际复测的四步建议
刚接触本地模型的用户,可以先从 LM Studio 或 Ollama 的模型目录中选适配版本起步;如果后续需要精细管理上下文窗口大小、KV Cache 占用,或者调试特定后端与投机解码,可以转向 llama.cpp 命令行或原生 MLX。
针对 64GB 统一内存 Mac,建议按以下四步复测:
准备任务真题:拿出平时真正要跑的长文档、代码需求或业务问答,不用网上的简短跑分模板。
记录量化、后端与上下文:明确记录使用的推理后端(llama.cpp / MLX 等)、模型量化规格以及设定的上下文窗口大小。
观察内存余量:权重、上下文缓存、推理运行时和系统都要留空间;运行时再看内存压力与换页。
分别记录三项表现:分别用未缓存的长输入和日常提示词跑测试,记录首段内容等待时间、后续生成速度,以及最终回答的逻辑与成文质量。
最后需要说明的是,本地运行大模型的隐私优势,前提是所用工具确实处于离线状态,且未启用联网检索或第三方云端扩展。明确自己的任务需求并合理预留资源,才能让这台 64G Mac 真正发挥作用。
引用社区原帖
[1] @hi_lite202006 原帖https://x.com/hi_lite202006/status/2103390483687034921
[7] @sherman_on_x 原帖https://x.com/sherman_on_x/status/2091498308170858931
[8] @everes 原帖https://x.com/everes/status/2091395696922710204
[14] @TeksEdge 原帖https://x.com/TeksEdge/status/2092041767617192212
[18] @miya_mos365 原帖https://x.com/miya_mos365/status/2107046489965084969
[19] @miya_mos365 原帖https://x.com/miya_mos365/status/2107046109122269316
[22] @moomoo_dad 原帖https://x.com/moomoo_dad/status/2090367635007672832
[24] @yume_arasaki 原帖https://x.com/yume_arasaki/status/2088764220817162492
[25] @yume_arasaki 原帖https://x.com/yume_arasaki/status/2089065776351441193
[26] @miktam 原帖https://x.com/miktam/status/2107170517241458727
[29] @Chris_Wozniczek 原帖https://x.com/Chris_Wozniczek/status/2094584043085914325
[32] @Fuchi_JPN2 原帖https://x.com/Fuchi_JPN2/status/2090124003847688280
[33] @k12u 原帖https://x.com/k12u/status/2099659060165620133
官方模型资料
Qwen3.8-27B 官方资料https://github.com/AlibabaCloud-Official/Qwen3.8-27B/blob/main/README.md
Gemma 4 26B-A4B 官方模型卡https://huggingface.co/google/gemma-4-26B-A4B/blob/main/README.md
本机测试环境说明
测试硬件:Apple M5 Max,64GB 统一内存
存储介质:模型权重存放于外接移动固态硬盘
推理后端:llama.cpp(启用 Metal 加速)
测试模型:Qwen3.8-27B-GGUF(量化规格:Q4_K_M)
实测数据记录:
短合成基准(512 输入 / 128 输出):约 26.25 tok/s
128K 窗口长会话(约 6.1 万 token 历史,累计前缀缓存命中约 97%–98%):8 次完成请求加权平均生成速度约 32.38 tok/s
57,222 token 未缓存长背景单次请求:首段内容返回耗时约 118 秒,后续生成速度约 32.64 tok/s
代码短提示词 MTP 对比(200K 容量,输出 478 tokens):关闭 24.45 tok/s,开启 55.05 tok/s
中文短提示词 MTP 对比:关闭 24.72 tok/s(输出 767 tokens),开启 37.62 tok/s(输出 725 tokens)