近年来,深度学习在拉曼光谱分析中的应用越来越广泛。从卷积神经网络(CNN)到 Transformer,再到针对拉曼光谱特点专门设计的网络架构,研究人员已经提出了大量分类模型。
这些模型在各自的论文中往往取得了不错的成绩,有些甚至显著优于传统机器学习方法。
但是,这里存在一个容易被忽视的问题:
不同论文使用的数据集、训练方法、评价指标和对照模型并不相同。即便每篇论文都报告了较高的准确率,我们也很难直接判断这些深度学习模型究竟谁表现更好。
2026 年,普渡大学的 Adithya Sineesh 和 Akshita Ramya Kamsali 在《Digital Discovery》发表了一项研究:
Benchmarking deep learning models for Raman spectroscopy across open-source datasets
中文可译为:
基于开源数据集的拉曼光谱深度学习模型基准评测
这篇论文没有提出新的深度学习网络,而是选择五种已经发表的拉曼深度学习模型、两种传统机器学习方法,以及三个公开拉曼光谱数据集,在统一的实验框架下进行了系统比较。
研究发现,在作者采用的统一训练条件下,SANet 和 Deep CNN 总体表现较好,而大型 Transformer 并没有体现出明显优势。此外,模型性能还受到数据条件、分类任务和标签定义等因素的影响。
这项研究的价值,不在于证明某一种算法绝对优于其他算法,而在于为拉曼光谱分类建立一个更加透明、可重复的比较基准。
下面按照科研论文第一遍阅读的思路,系统梳理这篇论文的研究背景、核心问题、研究设计、主要结果与论证逻辑。
一、论文基本信息
1.1 论文信息
- 英文标题:Benchmarking deep learning models for Raman spectroscopy across open-source datasets
- 中文标题:基于开源数据集的拉曼光谱深度学习模型基准评测
- 作者:Adithya Sineesh、Akshita Ramya Kamsali
- 作者单位:Purdue University(普渡大学)
- 研究领域:拉曼光谱、机器学习、深度学习、化学计量学
1.2 什么是 Benchmarking?
Benchmarking 通常翻译为“基准评测”或“基准比较”。
它的基本思想是:
让不同模型在共同的评价框架下接受测试,使模型之间的性能差异具有可比较性。
假设有五个研究团队,分别提出五种拉曼分类模型。
第一篇论文使用矿物数据,准确率为 98%。
第二篇论文使用细菌数据,准确率为 95%。
第三篇论文使用药物数据,准确率为 99%。
能否直接得出第三个模型最好?
显然不能。
因为它们面对的任务不同,数据集不同,训练与测试条件也不同。
即便都在同一个数据集上测试,如果数据划分方式、预处理方法和超参数调整策略不同,最终结果也未必具有直接可比性。
基准评测就是尽可能统一这些条件,让不同模型接受相对公平的比较。
1.3 一句话概括论文
作者通过统一评测五种已有拉曼深度学习模型和两种传统机器学习方法,分析不同模型在三个公开数据集及不同测试条件下的分类表现,为拉曼光谱模型比较提供可重复的参考基准。
二、摘要逐层解读
论文的摘要主要讨论六个问题:
研究背景、已有困难、研究目标、研究方法、主要结果和研究定位。
2.1 研究背景:深度学习已经成为拉曼分类的重要方法
作者首先指出,越来越多研究报告深度学习在拉曼光谱分类中优于传统化学计量学方法。
传统方法包括:
近年来,研究人员又提出了大量深度学习架构,包括:
这些研究推动了拉曼光谱自动识别的发展。
但是,模型越来越多,并不意味着我们已经清楚哪种模型更有效。
2.2 已有困难:不同深度学习模型之间缺少系统比较
作者指出,已有研究经常采用以下比较方式。
第一种是将新模型与传统机器学习方法比较。
例如,提出一个新的 CNN,然后证明它比 SVM、随机森林表现更好。
第二种是将新模型与通用图像分类网络比较。
例如,把 ResNet、AlexNet、VGG 等网络调整成能够处理一维光谱的形式,然后进行实验。
这些比较本身具有价值,但不能充分回答另一个问题:
一个新提出的拉曼深度学习模型,与其他已经发表的拉曼专用深度学习模型相比,究竟表现如何?
因为许多研究没有直接比较这些已有专用模型,所以很难建立清晰的模型性能参考体系。
此外,不同研究采用不同数据、不同训练条件,也进一步增加了横向比较的困难。
2.3 研究目标:建立统一的拉曼分类基准
作者希望构建一套相对统一的评测框架,将多个已经发表的拉曼深度学习模型放在相同规则下进行比较。
这项研究包括:
同时,作者希望这些数据集能够覆盖不同的评价场景,包括常规分类、微调和数据分布变化条件下的测试。
2.4 研究方法:统一训练、调参与性能评价
作者选择了三个不同应用领域的公开数据集:
- Bacteria-ID:细菌和酵母分离株拉曼光谱数据集。
然后对选定模型进行统一训练和超参数搜索,并通过分类准确率与宏平均 F1 分数进行评价。
其中:
准确率(Accuracy)
衡量全部测试光谱中,模型正确分类的比例。
宏平均 F1(Macro-F1)
先分别计算每个类别的 F1 分数,再求算术平均值,用于反映模型在不同类别上的整体分类表现。
二者结合,有助于避免仅凭总体准确率评价模型。
2.5 摘要报告了哪些主要结果?
需要注意,摘要并没有详细列出具体模型的准确率,也没有完整给出模型排名。
摘要主要强调的是基准研究的动机、方法及评价范围。
具体性能结果主要出现在正文第六部分。
因此,不能将正文中的全部数值和模型排名都当作摘要直接报告的结果。
2.6 研究定位:监督学习分类,而不是完整化学结构解析
作者明确说明,本研究主要关注监督式拉曼光谱分类。
也就是说,模型接收一条拉曼光谱,将其分配到事先定义的类别。
例如:
作者没有将复杂混合物成分解析、完整分子结构鉴定或混合物浓度定量作为统一评测任务。
原因是三个公开数据集主要具有分类标签,而缺少完成其他任务所需的统一标注。
2.7 摘要的完整逻辑
可以用一段话概括:
过去,许多研究提出了新的拉曼深度学习模型,并且经常报告优于传统机器学习的分类效果。但是,这些研究采用的数据、比较对象和实验条件不同,导致不同深度学习模型之间难以直接比较。因此,作者选择五种已有的拉曼深度学习架构、两种传统机器学习方法和三个公开数据集,通过统一的训练与评价框架开展基准比较。研究的主要目标不是设计新网络,而是建立可靠、可重复的分类性能参考体系。
三、引言与文献综述完整解读
这篇论文的引言和文献综述共同构成研究动机。
作者并没有一开始就直接讨论模型排名,而是从拉曼光谱的应用价值出发,逐步说明已有研究的不足,最后引出基准评测的必要性。
3.1 第一层:拉曼光谱为什么具有重要应用价值?
拉曼光谱是一种非破坏性分析技术。
它通过检测光与物质发生非弹性散射后的频率变化,获得分子振动相关的信息。
不同物质的分子组成、化学键及结构可能不同,因此可以产生具有识别价值的拉曼光谱特征。
拉曼光谱已经应用于多个领域,例如:
作者首先介绍这些应用,是为了说明自动化拉曼识别具有实际研究意义。
然而,拉曼光谱虽然能够提供分子振动信息,实际测量结果却不总是理想的。
因此,作者接着讨论实际测量面临的困难。
3.2 第二层:真实拉曼光谱为什么难以自动分类?
作者主要指出三个问题。
第一,拉曼信号可能较弱,容易受到干扰
拉曼散射本身是相对较弱的物理过程。
实际测量得到的光谱可能包含:
这些干扰可能影响甚至掩盖原本用于区分类别的特征。
第二,不同物质的拉曼峰可能发生重叠
拉曼光谱分类并不是简单地检查某个位置有没有峰。
不同物质可能在相近位置出现特征峰,混合物中还可能存在多个组分的信号叠加。
这会增加分类难度。
第三,不同采集系统可能产生不同的数据分布
即便研究相同类型的物质,不同测量系统、仪器配置和实验条件也可能改变记录到的光谱。
这种变化可能造成分布偏移(Distribution Shift)。
通俗来说:
模型在训练时见到的光谱,与实际测试时见到的光谱,在统计特征上发生了变化。
当这种差异比较明显时,模型原来在测试集上获得的良好成绩,不一定能够维持。
作者讨论这些问题,是为了说明:
拉曼光谱分类不仅需要较高的分类准确率,还需要认识不同数据条件下的模型行为。
3.3 第三层:传统化学计量学已经做了哪些工作?
在深度学习广泛应用之前,拉曼光谱分类已经有较长的研究历史。
例如:
PCA + 最近邻分类
有研究通过 PCA 对拉曼光谱进行降维,再利用最近邻分类器区分不同葡萄球菌菌株。
其中一项研究使用 277 条光谱,对 16 种菌株进行分类。
PCA + ANN 或 LDA
也有研究通过 PCA 提取特征,再使用人工神经网络或线性判别分析完成食品类别识别。
论文举出的一个例子仅包含 93 条鱼子酱光谱。
SVM 分类
支持向量机已经被用于药物产品和配方的分类。
这些研究说明,传统机器学习方法并非无效。
相反,在相对有限的数据条件下,它们已经能够完成多种拉曼分类任务。
那么,为什么还需要深度学习?
原因之一是研究人员希望通过深度神经网络直接从光谱中学习特征,减少对人工特征设计的依赖,并提高对复杂光谱模式的建模能力。
因此,后来出现了大量 CNN、Transformer 和其他深度学习方法。
3.4 第四层:部分深度学习研究的真实测试数据规模较小
作者随后开始讨论已有深度学习研究的评价局限。
其中一个问题是,部分模型只在有限的实验数据上进行了测试。
例如:
- 一项人和动物血液分类研究使用了 109 条测试光谱。
- 一项溃疡性结肠炎研究涉及 42 名患者和 227 条光谱。
- 一项氯化溶剂识别研究仅使用 58 条真实测试光谱。
- 一项海洋病原菌分类研究报告了 100% 准确率,但真实测试集只有 60 条光谱。
- RaMixNet 相关研究在真实混合物上的测试仅包含 6 个实验测量的混合物。
作者列举这些工作,不是为了证明它们的研究一定错误。
而是说明:
在有限的真实测试数据上取得较高准确率,并不能直接证明模型在更加广泛的实际测量条件下也具有同样表现。
这里需要注意样品数量与光谱数量的区别。
例如,227 条光谱来自 42 名患者,不能理解成 227 名独立患者。
同理,多次测量同一样品得到的光谱,也不能直接等同于相同数量的独立样品。
3.5 第五层:大量使用合成数据是否能够解决问题?
由于真实拉曼光谱获取成本较高,一些研究开始使用合成数据扩充训练集。
作者介绍了几类研究。
第一类:使用生成模型合成光谱
例如,有研究利用扩散生成模型,构建了包含 10,000 条合成光谱和 594 条实验光谱的数据集,用于二维材料分类。
第二类:从少量真实光谱扩增大量合成数据
有研究从五种材料的五条真实参考光谱出发,通过数据增强生成约 40,000 条合成训练光谱。
但其测试数据也由相同五条参考光谱扩增得到。
这里就产生了一个值得注意的问题:
虽然训练数据与测试数据不是同一条数字记录,但是二者可能共享相同的原始光谱来源。
在这种条件下,较高的测试准确率不能直接代表对全新真实样品的泛化效果。
第三类:使用合成光谱进行混合物识别
例如 DeepCID,利用真实纯物质光谱及其增强结果训练模型,再进行材料存在性识别。
作者认为,合成数据可以缓解真实数据不足的问题。
但是,合成测试数据也存在评价范围有限的问题。
合成数据能够帮助训练,并不意味着合成数据上的测试结果可以完全替代真实实验验证。
3.6 第六层:真正的研究空白开始出现
前面作者主要讨论数据方面的问题。
接下来,论文转向另一个更加核心的问题:
许多拉曼深度学习模型缺少与其他已发表拉曼专用模型的直接比较。
作者指出,一些研究虽然提出了新的网络结构,但主要采用以下对照:
例如,将一个新模型与 SVM 比较,证明新模型准确率更高。
这可以说明该模型优于所选 SVM 基线。
但不能自动说明该模型优于 RamanNet、SANet 或其他已经发表的拉曼分类网络。
同样,将一个新模型与经过简单调整的 AlexNet、ResNet 或 VGG 比较,也不能充分代表它在所有拉曼专用模型中的相对位置。
作者通过回顾微生物识别、材料分类、食品检测、癌症检测以及混合物分析中的大量研究,说明这种情况并不少见。
这就产生了一个现实问题:
一个模型在自己的论文中报告了非常好的结果,但它究竟是不是当前已有方法中更有效的选择?
如果没有共同数据和一致的评价规则,很难回答。
3.7 第七层:之前真的没有人做过模型基准比较吗?
作者没有声称自己是第一个开展拉曼模型比较的人。
实际上,论文明确讨论了几项已经存在的基准研究。
RamanNet
RamanNet 曾在多个公开数据集上进行评测,包括矿物、细菌及医学相关数据。
但是,作者指出,部分比较在每个数据集上只涉及有限数量的其他模型。
SANet
SANet 曾在 Bacteria-ID 数据集上测试,并与传统机器学习方法及相关基线模型比较。
但这种比较尚未覆盖更加广泛的拉曼专用深度学习架构。
WPGA
有研究将一维拉曼光谱转换为二维表示,再利用 ResNet 进行分类,并与多个已发表模型比较。
但该方法的官方代码没有公开,论文与补充材料中的架构信息也不足以支持完全准确的网络复现。
Lange 等人的研究
有研究构建了包含八种代谢物的混合物数据集,并比较 11 种模型。
但其中只有一种模型原本是专门为拉曼分类任务提出的。
这些工作表明,拉曼模型基准评测并不是完全空白。
不过,作者认为:
同时比较多个已经发表的拉曼专用深度学习分类器,并且覆盖多个公开拉曼数据集的研究,仍然比较有限。
这正是本文选择的切入点。
3.8 引言最终如何引出研究方案?
把整篇引言和文献综述串起来,可以得到下面这条逻辑:
拉曼光谱具有广泛应用价值
↓
真实光谱存在干扰、峰重叠、数据不足和测量差异
↓
传统机器学习和深度学习被大量用于自动分类
↓
研究人员提出了越来越多的新网络
↓
部分研究测试规模有限,或过度依赖合成数据
↓
不同论文使用不同对照和评价程序
↓
已有拉曼专用模型之间缺少足够系统的直接比较
↓
需要建立共同、可重复的模型评价框架
↓
本文选择五种深度学习模型和两个传统方法,在三个开放数据集上进行统一基准评测
由此可以看出,这篇论文的研究起点不是某一种新算法,而是对现有拉曼分类研究评价方式的反思。
四、作者的核心研究问题
4.1 核心问题
在统一、可重复的训练和评价条件下,已经发表的拉曼专用深度学习分类模型在不同公开数据集上究竟表现如何?它们相对传统机器学习方法是否具有一致的优势?
这个问题是全文的中心。
4.2 子问题一:不同深度学习模型谁表现更好?
目前已经存在 Deep CNN、RamanNet、SANet、Transformer、RamanFormer 等模型。
它们的结构不同,复杂度不同,原始研究中的数据和任务也不同。
因此,作者希望在共同框架下直接比较它们的分类效果。
4.3 子问题二:模型表现是否会受到数据条件影响?
作者选择的数据集不仅涉及不同应用领域,还具有不同的评价条件。
例如:
MLROD 包含粉尘覆盖和不同岩石测试条件。
Bacteria-ID 提供参考数据、微调数据和测试数据。
API 主要提供同源随机划分下的分类任务。
作者希望通过这些不同条件,观察模型表现是否稳定。
4.4 子问题三:深度学习是否总比传统机器学习更好?
由于近年来许多论文都报告深度学习优于传统机器学习,因此作者也关注这一结论在不同数据集下是否成立。
具体而言:
当数据规模、任务难度和训练测试分布发生变化时,传统方法是否仍然具有竞争力?
4.5 科学问题还是技术问题?
这篇论文的研究问题主要属于方法评测与技术比较问题。
它不是以揭示某种材料的微观反应机理为主要目标,也不是以提出新型光谱仪或新神经网络为主要创新。
作者真正研究的是:
已有分类方法在共同实验约束下的性能差异,以及这些差异与评价条件之间的关系。
五、快速认识实验对象与研究方法
5.1 五种深度学习模型
作者选择了五种已有的拉曼深度学习模型。
这五种网络并不是由本文作者重新发明的。
作者主要根据已有论文和代码重新实现或复用相关结构,使它们能够在共同评测框架下比较。
其中,SANet 使用了原作者提供的官方 PyTorch 实现。
其他深度学习模型主要根据原论文及相关代码重新实现。
需要特别指出,RamanFormer 最初用于混合物分析,本文将其适配为分类任务,使用交叉熵损失替代原研究中的 L1 损失。
5.2 模型规模是否相同?
不同模型的规模差异很大。
论文 Table 1 给出了在输入光谱长度为 1024、输出类别为 15 时的模型复杂度。
可以看到,Transformer 的参数规模和计算量都明显大于其他模型。
不过,参数量较大并不意味着分类效果一定更好。
同样,参数较少也不意味着模型一定运行得更快,因为实际运行时间还与硬件利用率、网络操作和具体实现有关。
作者通过这些信息,帮助读者认识不同架构的复杂度差异。
5.3 两种传统机器学习方法
作者还选择了:
Random Forest(随机森林)
通过多棵决策树组合完成分类。
Support Vector Classifier(支持向量分类器,SVC)
基于支持向量机方法构建分类边界。
此外,还有两个简单基线:
随机分类器:从可选类别中随机选择标签。
多数类分类器:将测试样本统一预测为训练数据中出现次数最多的类别。
这些简单基线主要用于说明模型是否明显优于非常基础的预测策略。
5.4 第一个数据集:MLROD
MLROD 的全称为 Machine Learning Raman Open Dataset。
它最初面向火星环境相关的材料识别研究。
数据中包括:
矿物类别包括石英、长石、云母、方解石、石膏等。
数据集还提供了不同岩石及粉尘覆盖条件下的测试光谱。
测试条件包括:
这里的粉尘来自玄武岩粉尘,用于模拟火星相关环境中的覆盖干扰。
数据集采用 532 nm 激发波长的 Horiba LabRAM HR Evolution 光谱仪采集。
数据量
论文正文介绍数据集时给出了 89,121 条标注光谱,以及 39,720 条岩石测试光谱。
不过,作者在脚注中说明:
实际从官方网站下载的训练数据包含 90,341 条光谱。
此外,部分测试样本的标签无法对应训练数据中的类别,作者将其排除。
因此,本文实际采用:
这些数字是光谱数量,不能直接理解为独立物理样品数量。
5.5 第二个数据集:Bacteria-ID
Bacteria-ID 用于微生物拉曼光谱识别。
数据涉及 30 种细菌及酵母分离株。
它支持两个分类任务:
第一,判断光谱所属的微生物分离株。
第二,根据数据集定义的标签判断经验性抗生素治疗类别,共八类。
数据集包括三个部分:
参考集
每个分离株 2,000 条光谱。
30 个分离株共 60,000 条光谱。
微调集
每个分离株 100 条光谱,共 3,000 条。
测试集
每个分离株 100 条光谱,共 3,000 条。
作者将参考集和微调集进一步划分为训练与验证部分。
论文 Figure 1 显示:
参考集:
微调集:
最终测试集:
这个数据集的一个重要特点是,微调集和测试集包含相同类型的光学系统效率退化条件。
因此,作者在深度学习模型训练中采用先参考集训练、再微调的流程。
需要注意,微生物分离株类别与抗生素治疗类别是两个不同任务,不能将二者的准确率直接理解成相同难度下的模型表现。
5.6 第三个数据集:API
API 指 Active Pharmaceutical Ingredients,即药物活性成分。
该数据集包含:
光谱由 Raman Rxn2 分析仪采集,激发波长为 785 nm。
不同于前两个数据集,API 不提供预先固定的训练集和测试集。
因此,本文作者自行进行随机划分。
具体为:
其中,每个原始类别抽取 22 条光谱用于测试。
这个数据集还有一个特殊情况:
两个不同标签实际上对应同一种化合物。
即:
二者是 4-甲基-2-戊酮和甲基异丁基酮,属于同一化学物质的不同命名。
因此作者设计了两种评价方式:
32 类评价
严格按照数据集原来的 32 个标签计算准确率。
31 类评价
在计算评价指标时,将两个化学同义标签合并。
值得注意的是,作者仍然按照 32 类训练所有模型。
31 类评价是训练完成之后的标签合并评价,并不是重新训练一个 31 类分类网络。
5.7 三个数据集之间的主要区别
作者选择这三个数据集,并不是要证明它们难度完全一样。
相反,这些数据集在应用领域、样本规模、采集方式和评价条件上存在差异。
这种差异是作者观察不同模型表现的重要基础。
5.8 作者采用怎样的统一训练规则?
对于深度学习模型,作者主要采用以下程序。
第一步:进行光谱强度缩放。
第二步:采用相同的优化器框架。
第三步:分别为每个模型和任务搜索超参数。
第四步:利用验证集选择模型和超参数。
第五步:使用选定的配置进行五次独立最终评测。
第六步:报告平均准确率、平均宏 F1 及标准差。
超参数搜索主要包括:
批大小:
学习率:
也就是说,每个深度学习模型在每个数据任务上,都搜索九种批大小与学习率的组合。
深度学习模型采用统一的最大训练轮数和提前停止规则。
在各数据集任务中,最大训练轮数为 40,验证准确率连续 10 个训练轮次没有提高时触发提前停止。
Bacteria-ID 微调阶段使用的学习率为预训练阶段的十分之一。
这里要特别注意:
统一训练规则不等于所有模型都经过了最充分的个性化优化。
作者自己也承认,一些架构,特别是 Transformer,可能需要不同的学习率调度、权重衰减、Dropout 或更长训练周期,才能发挥更好的效果。
因此,这项研究比较的是各模型在本文共同约束下的表现,而不是所有模型在任何可能训练条件下的理论最优表现。
六、快速浏览全部正文图表
本文正文共有四张 Figure 和六张 Table。
第一遍阅读不需要逐个分析所有数据点,重点是理解每张图表在论文中的作用。
6.1 图表总览
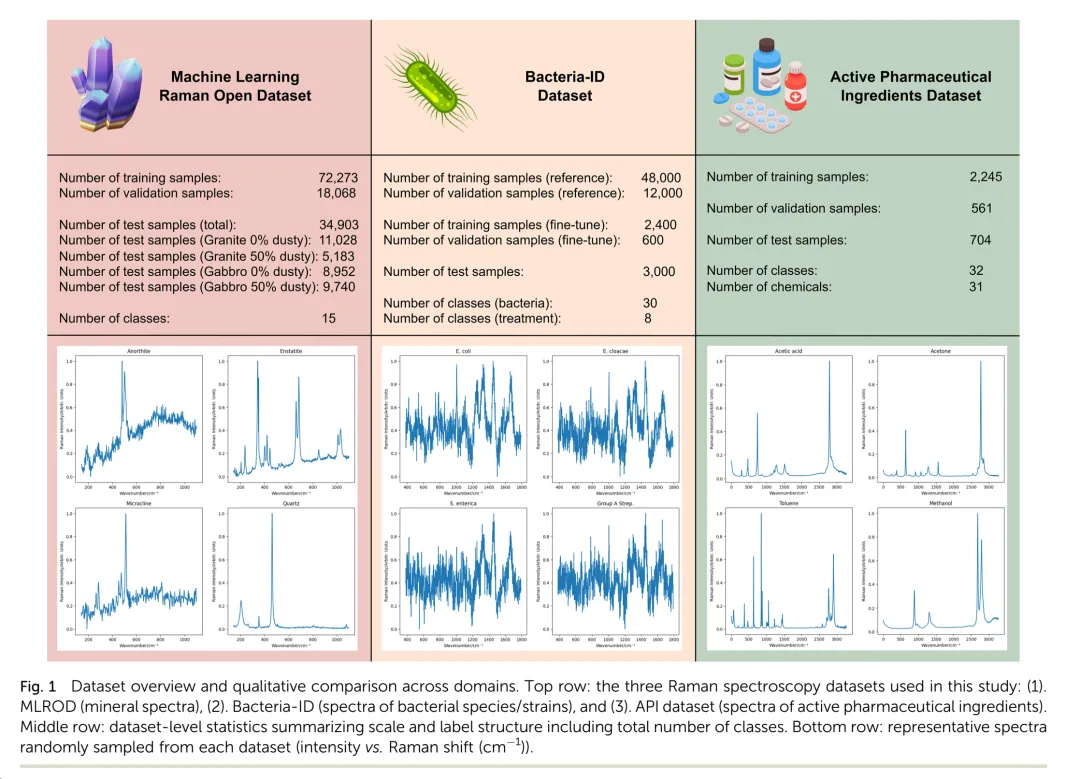
6.2 Figure 1:三个数据集构成整个评测的基础
Figure 1 的作用,是让读者认识本文究竟在哪些数据上进行比较。
图中包括三个数据集:
同时展示了训练、验证和测试数据规模,以及代表性的拉曼光谱。
作者希望通过 Figure 1 说明:
本研究不是依赖单一数据集得出模型排名,而是使用不同领域、不同数据条件的数据进行比较。
不过,三个数据集并不是完全等价的测试环境。
因此,不能把不同数据集上的准确率简单当成同一种难度的考试成绩。
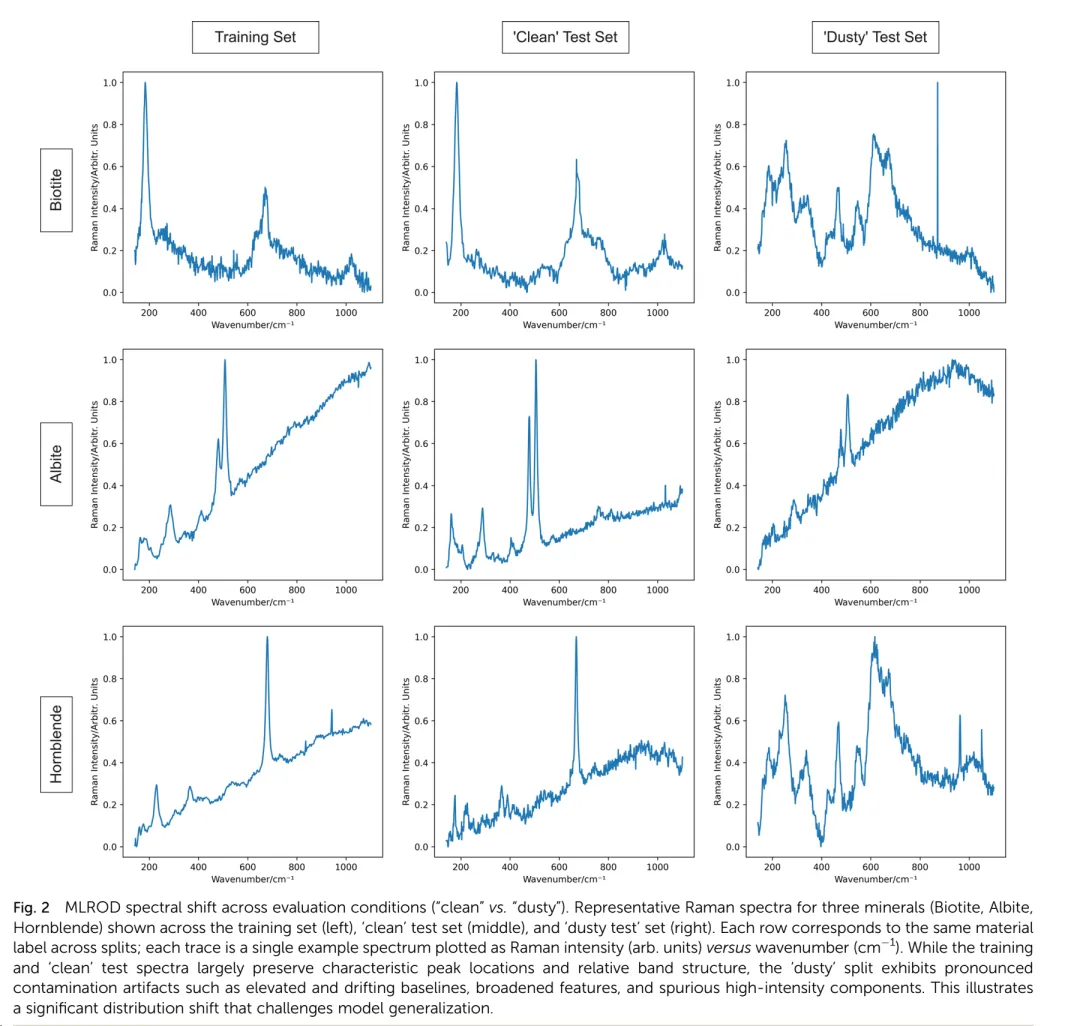
6.3 Figure 2:MLROD 中的数据条件变化
Figure 2 展示了三种矿物:
每种矿物分别展示:
通过图像可以观察到,不同条件下的光谱形状存在差异。
作者指出,粉尘测试光谱表现出更明显的背景变化、谱带展宽和其他干扰成分。
这张图的主要作用是:
在报告模型性能之前,先让读者直观看到训练和测试数据条件确实存在差异。
不过,图中每条曲线只是对应条件下的代表性光谱。
它们主要提供定性展示,不能仅凭几条代表曲线推断全部样本的统计分布。
此外,训练与测试数据在样品形态和采集条件方面也存在差别。
因此,不能把所有谱形变化都简单归因于粉尘。
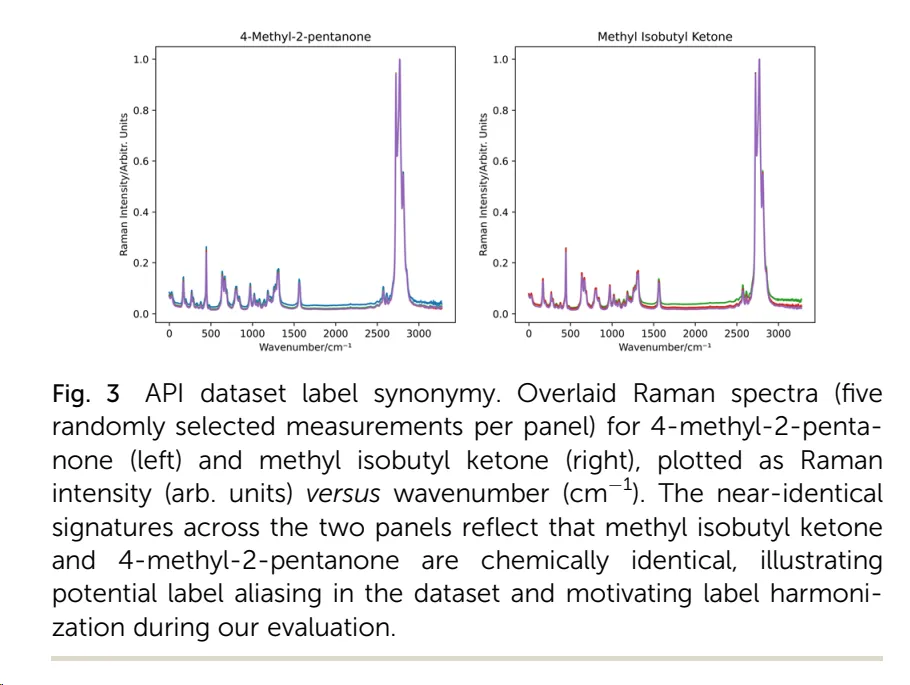
6.4 Figure 3:同一种化合物为什么有两个类别?
Figure 3 对比了 API 数据集中的两个标签:
4-甲基-2-戊酮和甲基异丁基酮。
二者化学身份相同,拉曼光谱也高度相似。
但原始数据集将它们标记为不同类别。
这就可能造成一个问题:
模型识别出了正确的化学物质,却没有预测出数据集指定的名称。
按照严格的 32 类标签评价,这仍然会被算作分类错误。
因此作者设置了 31 类化学身份评价。
这张图的作用,是说明为什么除了原始 32 类准确率,还需要报告合并同义标签之后的结果。
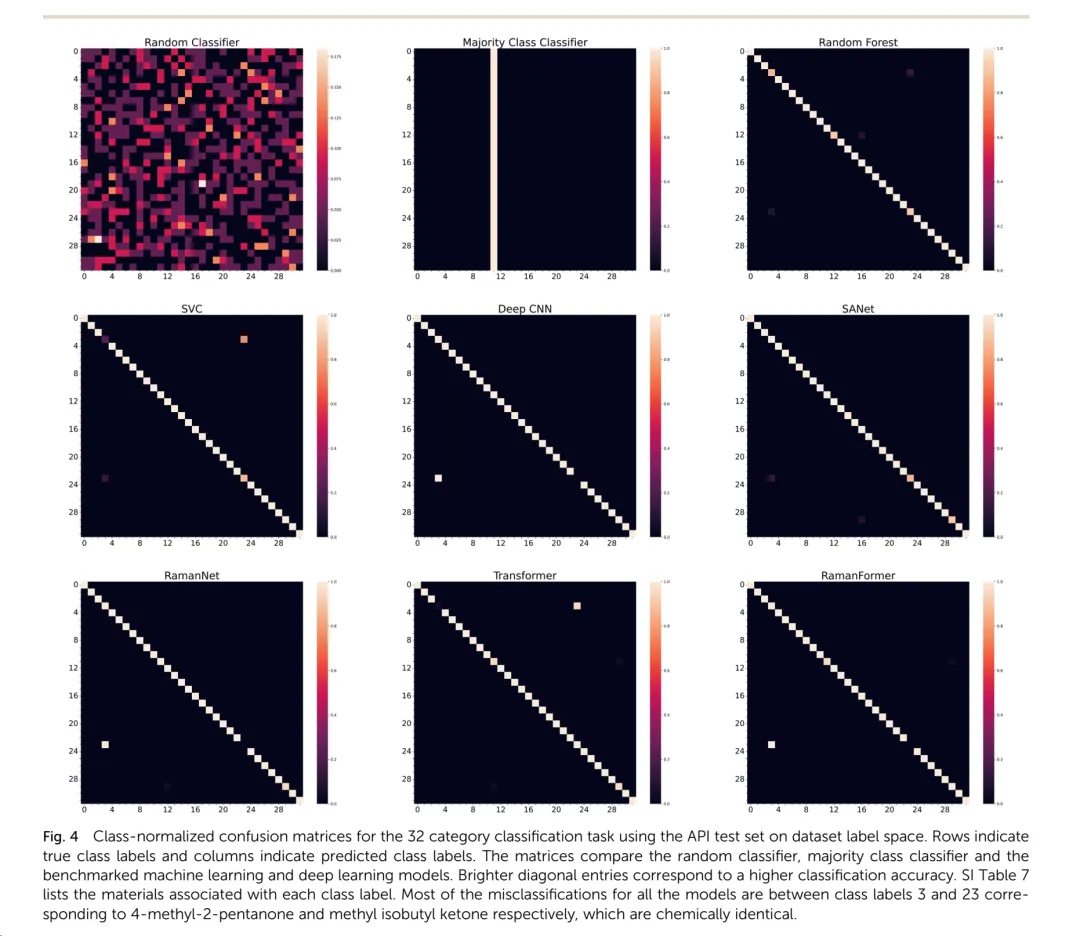
6.5 Figure 4:分类错误究竟集中在哪里?
Figure 4 是 API 32 类分类的混淆矩阵。
混淆矩阵用于表示真实类别与预测类别之间的对应关系。
在理想情况下,预测结果主要集中在对角线上。
如果某一类别经常被预测成另一个类别,混淆矩阵中对应的非对角位置就会出现较明显的数值。
作者发现,多个模型的分类错误主要集中在前面提到的两个化学同义标签之间。
这进一步支持了 Figure 3 所提出的问题:
部分模型错误可能与标签定义有关,而不一定代表模型无法区分化学物质。
6.6 Table 3:MLROD 分类准确率
MLROD 是本文观察不同测试条件影响的主要数据集。
下面列出五种深度学习模型的总体准确率。
传统机器学习模型为:
从总体准确率看,SANet 略高于其他深度学习模型。
但模型之间的表现并不是在所有测试子集上完全一致。
例如,Deep CNN 在部分干净测试条件下表现非常好,而 SANet 在一些粉尘条件下具有更好的准确率。
因此,“总体最优”需要明确对应哪个评价指标与哪个数据集。
6.7 Table 4:为什么还需要宏平均 F1?
如果一个数据集存在类别不平衡,模型可能主要依靠频繁出现的类别获得较高准确率。
宏平均 F1 则让每个类别在最终平均指标中占据相同权重。
在 MLROD 上,五种深度学习模型的总体宏平均 F1 为:
这里就能看出:
SANet 的总体准确率最高,但 Deep CNN 的总体宏平均 F1 更高。
这说明模型排名会受到评价指标影响。
第一遍只需要认识到这种差异,不必立即分析每个类别对应的混淆矩阵。
6.8 Table 5:Bacteria-ID 的两个任务
Bacteria-ID 包含两个不同分类任务。
五种深度学习模型的测试准确率如下。
可以看到:
分离株分类准确率大约为 83%–86%。
治疗类别分类准确率大约为 96%–97%。
两个任务的准确率不同,说明在该数据集及标签定义下,两项任务具有不同的分类难度。
但是不能据此把治疗类别分类结果等同于真实临床疗效预测能力。
6.9 Table 6:API 的原始标签与化学身份评价
API 数据集的结果非常有代表性。
可以看到,合并两个化学同义标签后,所有模型的评价结果都得到改善。
其中 SVC 和 Deep CNN 在 31 类评价下达到了 100% 准确率。
这并不是说这些模型已经掌握了所有药物化合物的识别规律。
只能说明,在本文 API 测试集及化学身份评价规则下,它们获得了这样的结果。
6.10 全部图表构成怎样的论证关系?
Figure 1:
告诉读者采用哪些数据集。
↓
Table 1、Table 2:
说明比较哪些模型,以及采用什么训练规则。
↓
Figure 2:
说明 MLROD 训练与测试条件之间的光谱差异。
↓
Table 3、Table 4:
报告不同模型在矿物数据及粉尘条件下的分类表现。
↓
Table 5:
报告不同模型在微生物数据集两项任务上的表现。
↓
Figure 3:
提出 API 数据存在化学同义标签的问题。
↓
Table 6、Figure 4:
说明不同模型的分类结果,以及标签同义对评价的影响。
↓
Discussion、Conclusions:
综合分析模型架构、数据条件、传统方法与深度学习之间的性能差异。
这就是本文主要图表之间的承接关系。
七、结论完整解读
论文的 Discussion 和 Conclusions 对研究结果进行了系统总结。
这里需要区分三个层次:
A. 作者实际报告的结果。
B. 作者对结果的解释。
C. 根据现有证据能够作出的有限判断。
7.1 第一项结论:CNN 模型在本次基准评测中总体表现较强
A. 作者报告的事实
在三个数据集的统一评测中,SANet 和 Deep CNN 总体表现较好。
相比之下,本文测试的大型 Transformer 模型没有获得最好的总体结果。
例如在 MLROD 中:
在 Bacteria-ID 的 30 类分离株分类中:
这些结果表明,在本文训练和测试框架下,较大的 Transformer 并未体现出稳定领先优势。
B. 作者的解释
作者认为,模型规模和专门面向拉曼数据设计的架构特点,都可能影响分类表现。
例如,RamanFormer 的参数量远小于大型 Transformer,但在部分评测中表现更好。
这提示模型的结构适应性可能比单纯增加参数量更加重要。
C. 可以得出的有限判断
本文不能证明 Transformer 从根本上不适合拉曼光谱。
因为作者没有穷尽不同模型的全部训练设置。
特别是 Transformer,可能需要更长的训练周期或专门调整的优化策略。
因此,正确的理解应该是:
在作者采用的统一训练规则与选定数据集下,CNN 类模型整体表现更有竞争力,而大型 Transformer 未能展示出明显优势。
7.2 第二项结论:不同数据条件下的模型表现可能差异很大
A. 作者报告的事实
在 MLROD 中,粉尘覆盖条件下各模型的分类准确率普遍明显下降。
例如 SANet:
辉长岩 0% 粉尘条件:
97.21%。
辉长岩 50% 粉尘条件:
48.87%。
二者相差 48.34 个百分点。
Deep CNN 也表现出类似现象。
辉长岩 0% 粉尘条件:
97.77%。
辉长岩 50% 粉尘条件:
42.26%。
B. 作者的解释
作者将这种性能下降与粉尘干扰、采集条件变化以及数据分布偏移联系起来。
这些因素使测试数据与训练数据之间出现差异,进而增加分类困难。
C. 可以得出的有限判断
这些结果直接表明,模型性能对 MLROD 的不同测试条件具有明显敏感性。
不过,这些条件之间并不是仅有一个因素发生变化的理想控制实验。
因此,不能仅凭这组结果定量分离出粉尘、材料形态和其他采集差异各自贡献了多少性能下降。
同时,这些结果也不能直接代表所有拉曼应用中的分布偏移情况。
7.3 第三项结论:深度学习在 Bacteria-ID 上整体具有优势
A. 作者报告的事实
在 Bacteria-ID 的两个分类任务中,深度学习模型总体优于本文比较的传统机器学习方法。
例如,在 30 类分离株分类任务上:
在八类治疗类别分类任务上:
B. 作者的解释
作者认为,深度学习模型可能更加有效地学习这些复杂数据中的分类特征。
C. 可以得出的有限判断
在这一数据集的规定任务和训练程序下,深度学习确实具有较好的分类表现。
但是,不能直接据此认定所有微生物拉曼分类任务中,深度学习都必然优于传统方法。
7.4 第四项结论:传统机器学习仍然具有竞争力
A. 作者报告的事实
API 数据集上,传统机器学习方法取得了很高的分类准确率。
例如:
随机森林在原始 32 类任务中达到 98.66%。
SVC 在 31 类化学身份评价中达到 100%。
这说明,即使不使用复杂深度网络,也可以在本文 API 测试集上取得接近满分的分类结果。
B. 作者的解释
作者认为,在样本规模较小、训练测试数据来自相同分布,而且分类任务相对容易的情况下,简单机器学习方法仍然可能具有很强的竞争力。
C. 可以得出的有限判断
不能将深度学习的优势视为不受数据条件影响的固定规律。
但是,也不能反过来认为传统机器学习在所有小数据集上都必然优于深度学习。
本文能够支持的是:不同任务和评价条件下,模型之间的相对优势可能发生变化。
7.5 第五项结论:标签定义本身也会影响模型评价
A. 作者报告的事实
API 中两个原始标签实际上指向同一种化合物。
在原始 32 类评价下,多个模型会把这两个标签相互混淆。
当评价时合并为 31 类化学身份后,模型准确率普遍提高。
B. 作者的解释
作者认为,原始任务中的不少错误来自化学同义标签之间的混淆。
这些错误并不必然代表模型没有学习到具有化学识别意义的信息。
C. 可以得出的有限判断
这项结果表明,分类评价不仅取决于模型预测能力,还受到标签体系的影响。
不过,标签合并后准确率较高,并不能进一步证明模型内部一定学习到了完整、可解释的化学机制。
7.6 作者认为自己的主要创新是什么?
作者并没有提出新的 CNN 或 Transformer 网络。
也没有发明新的拉曼光谱仪器或新的光谱测量机制。
这篇论文的主要贡献在于:
将多种已经发表的拉曼专用深度学习模型放入相对统一的评价框架,并在多个公开数据集上建立可复现的性能参考。
具体包括三个方面。
第一,提供模型之间的直接比较。
第二,覆盖不同领域和不同评价条件。
第三,公开实现代码及相关评测资源,支持研究复现与进一步比较。
因此,这项研究的创新更偏向基准体系、系统比较与可重复评价,而不是新算法结构。
7.7 作者承认了哪些限制?
论文明确提到几个重要限制。
第一,比较的模型数量有限
只选择了五个拉曼专用深度学习模型和两个传统机器学习方法。
因此,不能认为作者已经覆盖全部拉曼分类算法。
第二,研究任务限定为监督式多类别分类
没有统一评测混合物定量、完整结构解析等其他任务。
第三,预处理程序较为简化
作者希望减少复杂预处理策略对模型比较的影响。
因此,没有系统比较各种基线校正、荧光去除、散射校正和去噪方法。
第四,统一训练规则未必对全部模型最优
尤其是 Transformer,可能对训练轮数、优化器配置、学习率调度和正则化参数比较敏感。
因此,本研究无法证明这些模型在其他优化条件下仍保持相同排名。
第五,数据集覆盖范围有限
三个公开数据集虽然具有不同特点,但仍无法覆盖全部实际拉曼测量场景。
八、研究逻辑总图
整篇论文可以概括为以下逻辑:
研究背景
拉曼光谱具有广泛应用价值,机器学习和深度学习已经成为重要分析工具。
↓
现实困难
真实光谱存在噪声、峰重叠、数据不足和采集条件差异。
↓
已有解决方案
传统化学计量学、CNN、Transformer 和拉曼专用网络已经取得大量研究成果。
↓
现有研究不足
部分研究真实测试数据规模有限。
部分研究依赖合成测试数据。
大量新模型只与传统方法或通用网络进行比较。
不同论文之间难以直接比较性能。
↓
核心研究空白
缺少覆盖多个公开数据集、多个已发表拉曼专用分类网络的统一基准比较。
↓
本文研究方法
选择五种深度学习模型:
Deep CNN、RamanNet、SANet、Transformer、RamanFormer。
选择两种传统机器学习模型:
Random Forest、SVC。
选择三个公开数据集:
MLROD、Bacteria-ID、API。
采用统一训练、调参与评价框架。
↓
主要实验结果
MLROD:
各模型在粉尘和不同测试条件下的表现明显不同。
Bacteria-ID:
五种深度学习模型整体优于两种传统机器学习方法。
API:
传统机器学习也能够取得很高准确率。
化学同义标签对评价结果有明显影响。
↓
主要结论
模型性能与架构、任务、测试条件及标签定义有关。
在本文统一训练框架下,SANet 和 Deep CNN 总体较强。
大型 Transformer 未表现出稳定领先优势。
传统机器学习在部分任务中仍有竞争力。
↓
本文主要贡献
建立透明、可重复的公开拉曼分类基准,为后续研究提供模型性能参考。
九、第一遍必须掌握的核心术语
9.1 Raman Spectroscopy:拉曼光谱
拉曼光谱是一种利用非弹性光散射获取物质分子振动相关信息的分析技术。
不同物质具有不同的化学组成和结构,因此可能表现出不同的拉曼特征。
在本文中,拉曼光谱是全部分类模型的输入数据。
9.2 Benchmarking:基准评测
基准评测是指在共同的数据与评价规则下,对多个已有方法进行系统比较。
在本文中,作者主要通过统一训练程序和多个公开数据集比较模型性能。
这是整篇论文最重要的方法概念。
9.3 Supervised Learning:监督学习
监督学习是利用带有已知标签的数据训练模型。
例如,一条光谱已知属于石英,模型通过学习光谱与标签之间的对应关系,完成后续分类。
本文主要采用监督式多类别分类任务。
9.4 CNN:卷积神经网络
CNN 的英文全称是 Convolutional Neural Network。
它通过卷积操作从输入中提取局部特征。
对于拉曼光谱而言,一维卷积可以学习局部谱形和峰相关模式。
本文中的 Deep CNN 和 SANet 都属于以卷积操作为核心的模型。
9.5 Transformer:基于自注意力机制的神经网络架构
Transformer 通过注意力机制建立输入序列不同位置之间的联系。
在拉曼光谱中,可以先把一维光谱划分为多个片段,再利用注意力机制学习片段之间的关系。
本文比较了一个较大型的 ViT 风格 Transformer 和经过光谱任务适配的 RamanFormer。
9.6 Distribution Shift:分布偏移
分布偏移是指训练数据与测试数据的统计特征存在差异。
例如,模型在某种测量条件下学习到的光谱规律,可能无法完全适用于另一种测量条件。
本文通过 MLROD 等数据集观察了不同数据条件下的性能变化。
需要注意,分布偏移是对数据差异的描述,并不自动说明所有性能变化的具体物理原因。
9.7 Fine-tuning:微调
微调是在已有模型参数基础上,利用新的相关数据进一步训练。
在本文 Bacteria-ID 数据集上,深度学习模型先利用参考集训练,再使用微调集调整模型,最终在测试集上评价。
9.8 Accuracy:分类准确率
准确率表示正确分类样本数占全部测试样本数的比例。
其计算公式为:
Accuracy = 正确预测数量 / 测试样本总数量
例如,100 条光谱中有 90 条分类正确,则准确率为 90%。
准确率直观、易懂,但在类别分布不均衡时,需要结合其他指标分析。
9.9 Macro-F1:宏平均 F1 分数
F1 综合考虑精确率和召回率。
宏平均 F1 则先分别计算各类别的 F1,再进行不加权平均。
其主要特点是每个类别具有相同的平均权重。
因此,当某些类别数量很少时,Macro-F1 能够帮助我们注意到这些类别上的分类表现。
本文同时报告准确率和 Macro-F1,以避免只关注总体正确率。
9.10 Label Aliasing:标签同义问题
标签同义是指不同名称实际上对应同一个对象。
在 API 数据集中,4-甲基-2-戊酮与甲基异丁基酮是同一种化合物的不同名称。
由于原始数据集将二者视为不同标签,所以模型即使识别出正确化学身份,也可能被原始标签体系计为错误。
本文通过 32 类和 31 类两种评价方式展示了这一问题。
十、最终总结
10.1 这篇论文为什么值得做?
因为拉曼光谱领域已经出现大量深度学习模型,但不同研究采用不同数据和评价条件,模型之间缺少足够清晰的直接比较。
建立统一的公开基准,有助于了解已有方法在共同条件下的实际表现。
它不一定直接产生新的分类算法,却能够为后续算法研究提供共同参照。
10.2 前人工作有什么不足?
作者主要指出三个方面。
第一,部分研究的真实测试数据规模有限。
第二,一些研究大量使用合成数据,但合成测试数据不能完全替代新的真实样品验证。
第三,许多新模型主要与传统机器学习或通用网络比较,缺少与其他拉曼专用深度学习模型的系统对照。
其中,第三个问题最直接地构成本文的研究切入点。
10.3 作者具体做了什么?
作者选择:
五种深度学习模型:
两种传统机器学习方法:
三个公开数据集:
通过统一训练、调参及评价程序,比较这些模型在不同数据任务上的分类表现。
同时,作者针对 MLROD 的粉尘条件和 API 的化学同义标签问题进行了相应分析。
10.4 作者发现了什么?
第一,CNN 类模型在本文统一评测中总体表现较强,SANet 和 Deep CNN 是较有竞争力的模型。
第二,大型 Transformer 并没有因为参数量更大就获得最优分类表现。
第三,MLROD 中的粉尘与不同采集条件对应明显的模型性能变化。
第四,深度学习在 Bacteria-ID 中整体优于所选传统机器学习方法。
第五,在 API 这样训练与测试分布较接近的任务中,传统机器学习仍然可以获得很高准确率。
第六,分类评价中的标签定义可能显著影响模型的准确率。
10.5 作者认为自己的主要贡献是什么?
作者希望建立一套透明、统一、可重复的拉曼光谱分类基准。
其核心贡献是系统比较已有模型,而不是提出新的深度学习结构。
通过在多个公开数据集上报告结果,为研究人员认识不同算法的性能特点提供参考。
十一、用一段话复述整篇论文
这篇论文主要研究已有拉曼光谱深度学习分类模型之间应该如何开展公平、可重复的比较。过去,研究人员已经提出大量 CNN、Transformer 等模型,并且经常报告优于传统机器学习的方法,但不同论文使用的数据集、训练程序和对照对象不一致,导致不同模型之间难以直接比较。为解决这一问题,作者选择五种已有拉曼深度学习架构、两种传统机器学习方法,并在矿物、微生物和药物活性成分三个公开数据集上开展统一评测。结果表明,在本研究的共同训练约束下,SANet 和 Deep CNN 总体表现较强,而大型 Transformer 没有体现出明显优势;不同模型在粉尘、采集条件变化以及不同分类任务中的表现存在差异;传统机器学习在部分同源数据任务中依然可以取得很高准确率。此外,作者还通过 API 数据说明,化学同义标签可能影响分类评价。整篇论文最终强调,建立透明、可复现的公开评测基准,有助于更加客观地比较不同拉曼分类方法。
十二、文章的核心认识
读完这篇论文,需要明确三个层次。
第一,这是一篇基准评测论文,不是一篇新网络架构论文。
作者的贡献是组织已有模型、选择公开数据和构建统一比较框架。
第二,模型的性能比较必须结合具体任务和评价条件。
一种模型在某个数据集上领先,不代表它在所有任务上都具有同样优势。
第三,基准评测结果具有明确的适用范围。
本文能够说明选定模型在三个公开数据集和指定训练程序下的表现,但不能证明某一种架构在所有拉曼应用场景中都是最优选择。
从科研论文阅读的角度,这篇文章最值得学习的地方,不仅是最终的模型排名,更是作者如何发现已有研究中缺少统一比较的问题,并围绕这个问题组织数据、选择模型、设计评价程序,最终形成一套系统性的研究结果。
这篇论文的核心价值,可以概括为:通过统一的实验基准,让已有拉曼分类模型之间的性能比较更加清晰、透明和可重复。