具身策略评测完全指南:四维坐标、三道门禁与数据闭环与模型迭代
- 更新时间 2026-10-11 22:49:27
写给工程师的具身智能算法指南 · 07专题:策略评测方法论 · 主角:
lerobot-eval/lerobot-rollout/ 三件套统计工具
到这里,六个流派的算法已经全部拆完。回头看,我们花了大量篇幅在损失函数上:flow matching 怎么算、VQ 码本怎么学、Qwen 的 cross-entropy 怎么配平。但有一件事始终悬着没回答——
你的 loss 降到 0.03,机器人就真的会干活了吗?
前六篇解决"怎么训",这一篇解决"训完了怎么客观评测训练的策略及如何迭代优化你的策略"。它是一套具身算法数据闭环的方法论。拆成四件事就够了:
1. 评什么:一个策略能被客观评测的四个维度; 2. 会怎么被骗:每个维度各自的陷阱; 3. 怎么落地:训练 → 仿真 → 真机,三阶段门禁逐步逼近真相; 4. 怎么变强:把失败数据收回来、补进去、重训——最后再补上各派的专属探针。
四维坐标、四类陷阱、三阶段门禁、一个回流重训环——这一篇的全部。
目录
• 一、评测框架:四个维度与四类陷阱 • 1.1 分布:演示分布与策略分布 • 1.2 环境:数据集、仿真与真机 • 1.3 指标:过程量、结果量与鲁棒量 • 1.4 口径:点估计、区间、显著性与重复训练 • 1.5 四维交叉:一次评测的完整坐标 • 1.6 四类陷阱总表:陷阱、表现与解药 • 二、三阶段门禁与源码落地 • 2.1 三阶段门禁总表 • 2.2 评测成熟度阶梯:L1 到 L7 • 2.3 阶段 A/B 参数:held-out 与 EvalConfig • 2.4 阶段 C 统计:Wilson 区间与 Fisher 检验 • 2.5 三处静默失效 • 三、回流环:从失败数据到策略提升 • 3.1 五种采集策略:职责与代价 • 3.2 DAgger 与 HIL-SERL 的分野 • 3.3 重训环:合并、续训与收敛判据 • 四、分派评估与选型 • 4.1 探针清单:病灶与源码落点 • 4.2 探针与成功率的分工 • 4.3 三条路径对照表 • 4.4 选型决策树 • 五、思考题与下一篇预告 • 5.1 思考题(7 道) • 5.2 下一篇预告
一、评测框架:四个维度与四类陷阱
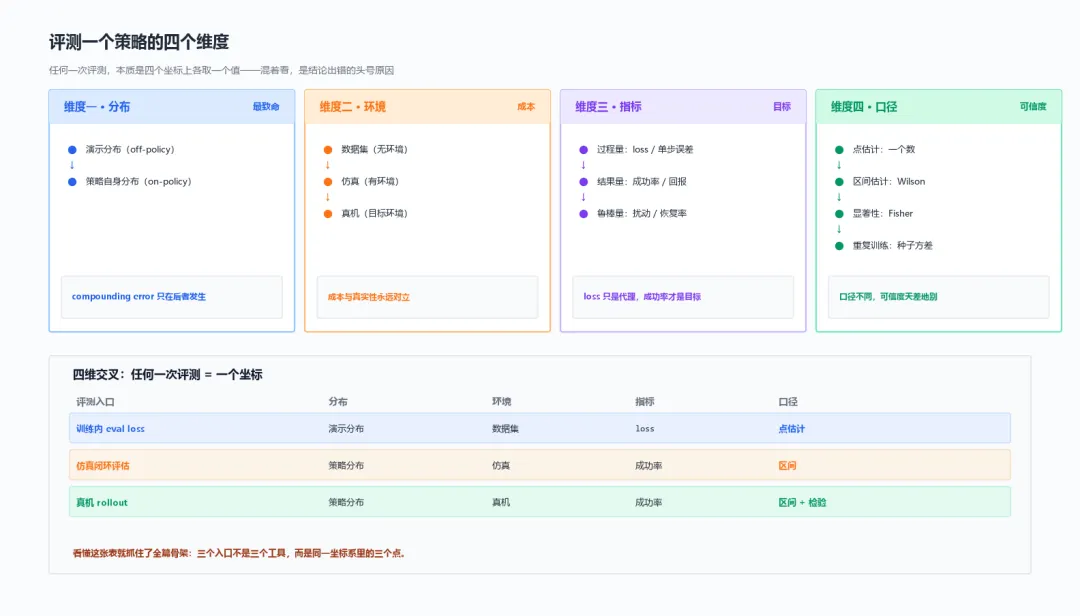
任何一次评测,本质是四个维度上的定量评估;然而每个维度,都有它对应的缺陷。
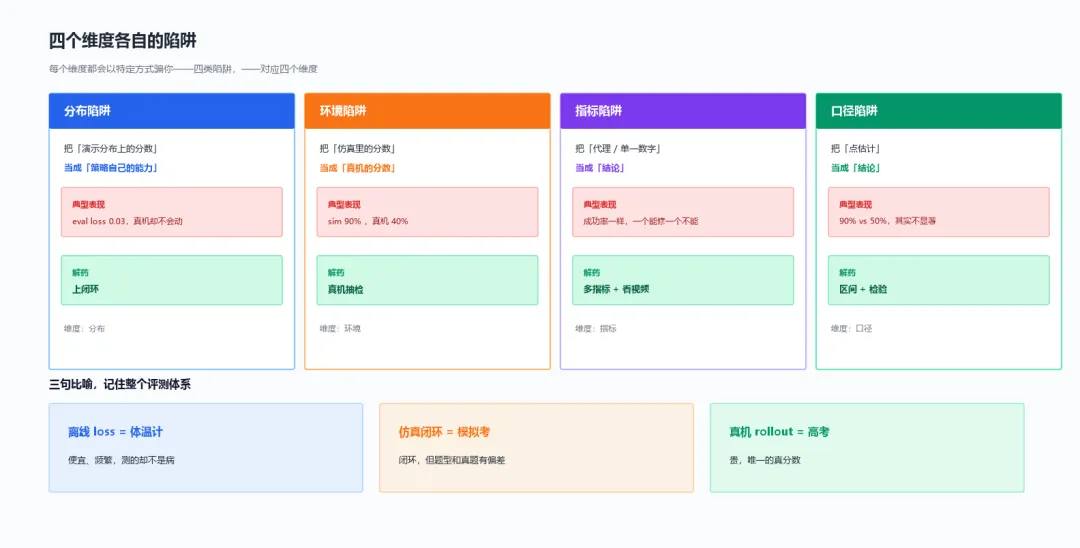
四类陷阱与四维一一对应,下面是该维度对应的陷阱全局概览图:
1.1 分布:演示分布与策略分布
同一个策略,可以在两种状态上被测试:
• 演示分布(off-policy):状态是演示者走出来的。离线 loss 全在这里。 • 策略自身分布(on-policy):状态是策略自己走出来的。真机 rollout 在这里。
这是四个维度里最致命的一个,因为 compounding error(累积误差,从第 02 篇起反复出现的母题)只在第二种里发生。策略在演示分布上每步只错一点点,但闭环里"这一步错出的状态,会成为下一步的输入"——它没见过,于是错得更多。
两个分布之间的差距,就是离线指标与真机指标脱钩的全部原因。
分布陷阱:离线 loss 只在演示自己走过的状态上算误差——那些状态永远不会因为你的动作而偏移。它衡量的是"给定演示分布,你预测得多准";而真机成功率问的是"在你自己累积出的分布上,你还站得住吗"——两者没有单调关系。三个天然盲区:状态分布盲区(held-out 帧仍是演示者的状态,策略跑偏后到的地方一个都没有)、多模态盲区(第 03 篇的敌人:动作真的多模态时,MSE 类 loss 会奖励"取平均",而平均值往往是两边都不沾的无效动作,loss 甚至更低)、闭环盲区(它算单步,闭环是几十步的复合)。
一句话:离线 loss 是体温计——便宜、频繁,但是无法真实评估在真机上性能,是一个好的策略的必要不充分条件。
1.2 环境:数据集、仿真与真机
• 数据集(无环境):只能算单步,看不见闭环。 • 仿真(有环境):闭环、便宜、可复现,但动力学 / 感知与真机有 gap。 • 真机(目标环境):唯一的目标环境,但慢、贵、不可复现。
环境维度决定成本和真实性,二者永远对立。
环境陷阱:仿真给了闭环,代价是它和真机不是同一个世界。三类 gap 逐级加深——感知 gap(没有相机噪声、光照变化、运动模糊)、动力学 gap(没有关节回差、摩擦、柔性形变、延迟)、标定 gap(夹爪没标定好、相机外参有偏,这一条仿真里根本没有对应物)。经验上,LIBERO / MetaWorld 里 90% 的成功率,搬到 SO-101 真机上常常只剩 40% 上下(经验基准,需复测)。
一句话:仿真闭环是模拟考——闭环,但题型和真题有偏差。
1.3 指标:过程量、结果量与鲁棒量
• 过程量:单步动作误差、loss。便宜、高频,但只是代理指标。 • 结果量:任务成功率、累计回报。这就是目标本身。 • 鲁棒量:扰动下的成功率、失败后的恢复率。最难测,却决定它能不能上产线。
指标陷阱:代理不是目标。①用 loss 代替成功率——分布陷阱与指标陷阱的叠加,优化代理不等于优化目标;②成功率不告诉你失败类型——同样是 60%,可能是"5 种失败各 8%",也可能是"同一种失败 40%",后者才是能修的(这正是 LeRobot 默认渲染 10 个视频的原因);③缺少鲁棒量——干净环境 100%、一遇扰动就崩的策略,和 85% 但很稳的策略,只看成功率会选错。
一句话:真机 rollout 是高考——贵、唯一的真分数,而且让你亲眼看到它是怎么失败的。
1.4 口径:点估计、区间、显著性与重复训练
• 点估计:一个数("成功率 90%")。 • 区间估计:给这个数配一个不确定性范围(Wilson)。 • 显著性检验:回答"两个策略到底谁更好"(Fisher)。 • 重复训练:测种子间方差——区间管不着的那部分。
同一组数据,口径不同,结论的可信度天差地别。
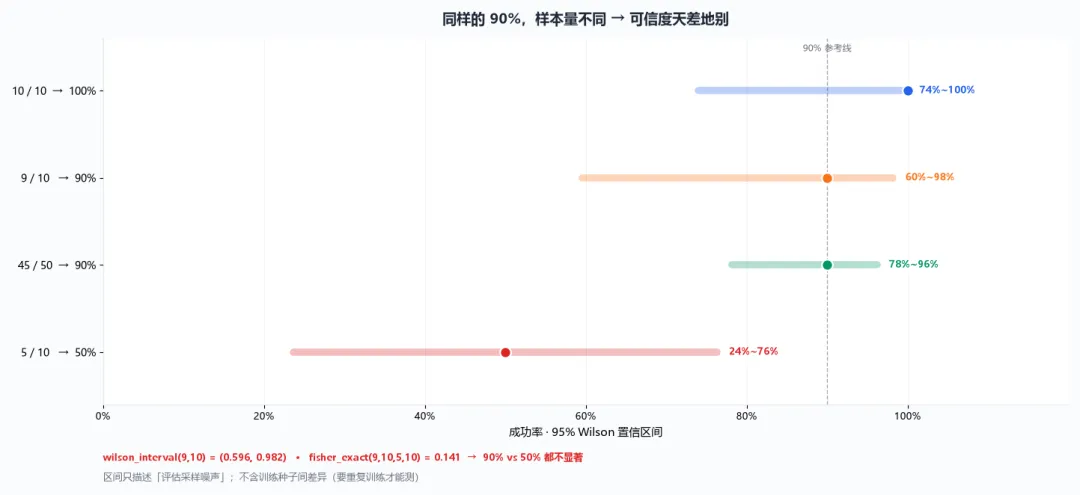
口径陷阱:成功率是二项分布的比例估计,而机器人评估的样本量小得可怜。三重不确定性叠加——采样噪声(跑 10 个回合的 90%,真实水平可能是 60% 也可能是 98%,第 2.4 节量化)、非独立(若 50 个回合用同一组固定初始条件,回合之间不独立,区间会偏窄,真实不确定性比报的大)、训练方差(同一个配置训 3 遍,成功率可能差 15 个点——这部分 Wilson 区间完全管不着,只能重复训练去测)。
1.5 四维交叉:一次评测的完整坐标
把四个维度各取一个值,就是一次评测的完整坐标。LeRobot 里的三个入口,恰好是三个不同的坐标:
| 目标指标 |
看懂这张表,就抓住了这一篇的骨架:三个入口不是"三个工具",而是同一个坐标系里的三个点。后面所有内容,都只是在这张表上填空。
1.6 四类陷阱总表:陷阱、表现与解药
二、三阶段门禁与源码落地
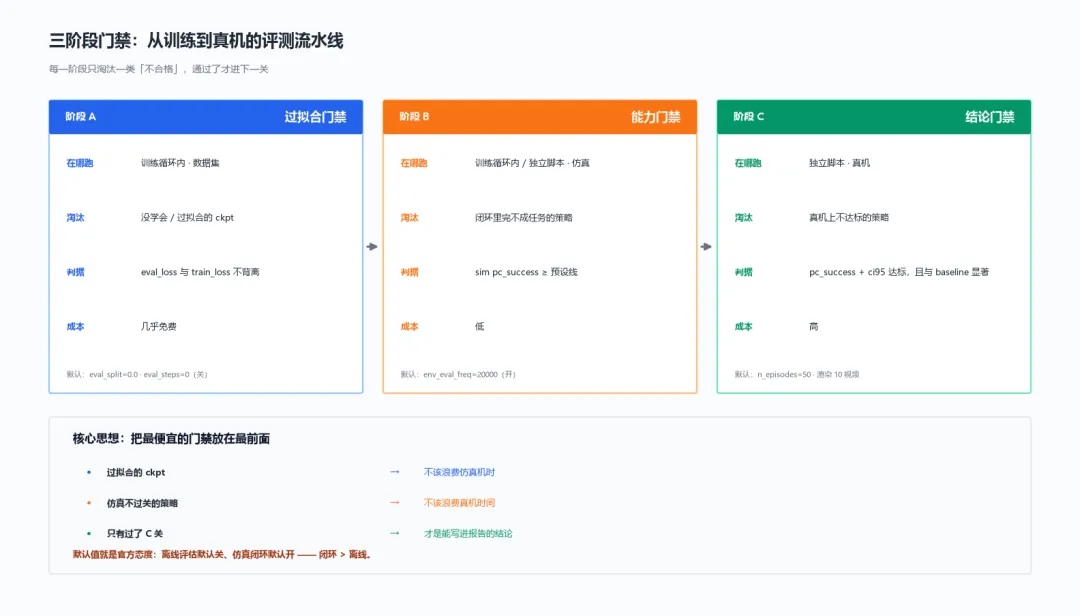
评测不是选一个最好的方式,而是一道流水线:每关只淘汰一类"不合格",通过了才进下一关——因为真机太贵,仿真又不够真。
2.1 三阶段门禁总表
pc_success ≥ 预设线 | |||||
pc_success + ci95 达标,且与 baseline 显著 |
核心思想:把最便宜的门禁放最前面——过拟合的 checkpoint 不该浪费仿真机时,仿真不过关的策略不该浪费真机时间。
三关的开关,官方已经给了答案(默认值就是表态):
阶段 A eval_split=0.0 · eval_steps=0 默认【关】—— 离线评估只做防呆,别指望它阶段 B env_eval_freq=20000 默认【开】—— 闭环 > 离线,这是官方的态度阶段 C 手动跑 lerobot-eval(n_episodes=50) 结论,按版本跑,不按天跑阶段 C 的报告只要三行,缺一不可:pc_success、pc_success_ci95、与 baseline 的 Fisher p 值。
两个硬约束:阶段 B 不支持分片训练(rank-0-only rollout 会死锁)、也不解决 sim gap;阶段 A 不支持 streaming 数据集。过了 B 只说明"仿真里能用",过了 C 才是"真机能用"。
2.2 评测成熟度阶梯:L1 到 L7
同一套流水线,工程上可以一级一级往上爬。多数人的问题不是"没评估",而是"停在太低的一级还以为是终点":
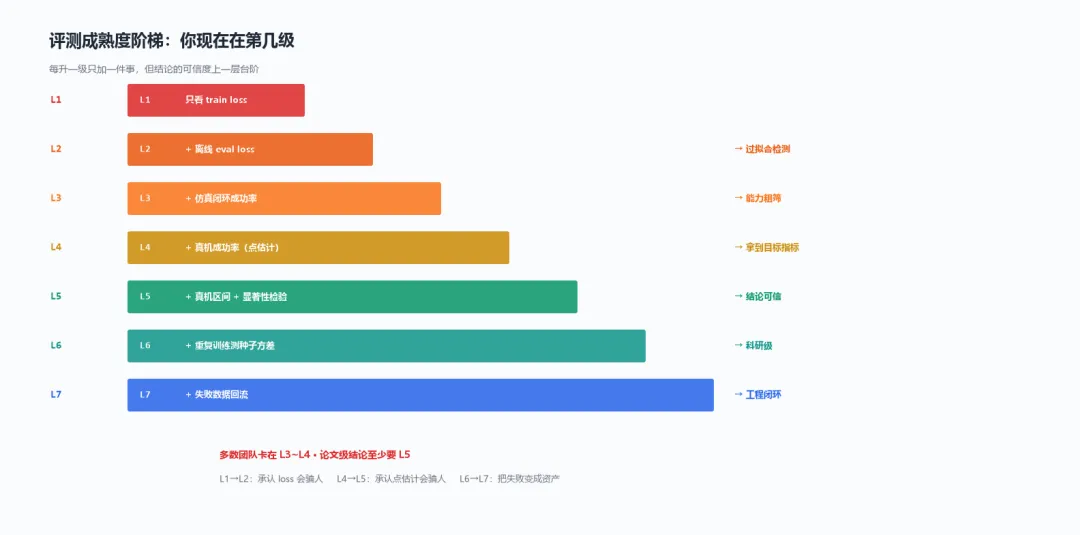
多数团队卡在 L3~L4,论文级结论至少要 L5。
本节前半给了流水线,后半把它落进源码——同样只给三样东西:三阶段的参数落点、统计三件套、三处静默坑。
2.3 阶段 A/B 参数:held-out 与 EvalConfig
阶段 A 的 held-out 按 task 分层、取每个 task 末尾ceil(n × split) 个 episode(datasets/factory.py:198);两个约束写死在校验里——eval_steps>0 必须配 eval_split>0(configs/train.py:318),且 eval_split 不支持 streaming(configs/default.py:62)。第一条是为了不让你在训练数据上算出虚低的 eval loss。
阶段 B 用 EvalConfig(configs/default.py:108):n_episodes=50、batch_size=0(自动 min(0.7×CPU核数, n_episodes, 64))、use_async_envs=True。最省事的 lerobot-eval --env.type=pusht --policy.path=...,已经按"跑满 CPU、并行几十个环境"来评估。
2.4 阶段 C 统计:Wilson 区间与 Fisher 检验
三件工具全在 utils/eval_stats.py:
• Wilson 区间 wilson_interval(9,10) = (0.596, 0.982)——9/10 你会说"90%",但真值落在 60%~98%,和 60% 还是 98% 区分不了。样本量说明一切:10 回合区间宽 38 点,50 回合收窄到 18 点(这也是n_episodes默认 50 而非 10 的原因)。用 Wilson 不用 Wald,是因为后者在 0%/100% 附近会给出越界上下限,而机器人评估恰恰常落在两端。• Fisher 精确检验 fisher_exact(9,10,5,10) = 0.141——90% 对 50%,p = 0.141,不显著。看起来差一倍的策略,10 个回合下统计上分不出来。• 边界:区间只覆盖评估采样噪声(哪些 episode 被抽到),不覆盖训练种子间差异——那要重复训练去测。
2.5 三处静默失效
真机评估里有三处不报错、但结论会错的地方:
1. 成功率恒为 0 → 先查环境。 success的唯一来源是info["is_success"];环境不给这个键,LeRobot 静默判该回合失败,而不是报错。2. 尾部回合被丢弃。 n_episodes=50、batch_size=8→ 实际跑 56 个,多出 6 个在指标里被切掉。"跑 50 个"其实是"至少 50 个";想让浪费最小,batch_size取整除 50 的值(10 / 25 / 50)。3. done掩码决定谁被统计。done累积(首个 True 之后全 True),用argmax取首次结束位置生成掩码;终止帧必须保留——success只在终止帧可能为 True。
成功率是一个数字,视频是"为什么"——
lerobot-eval默认渲染 10 个回合的视频,别关。
三、回流环:从失败数据到策略提升
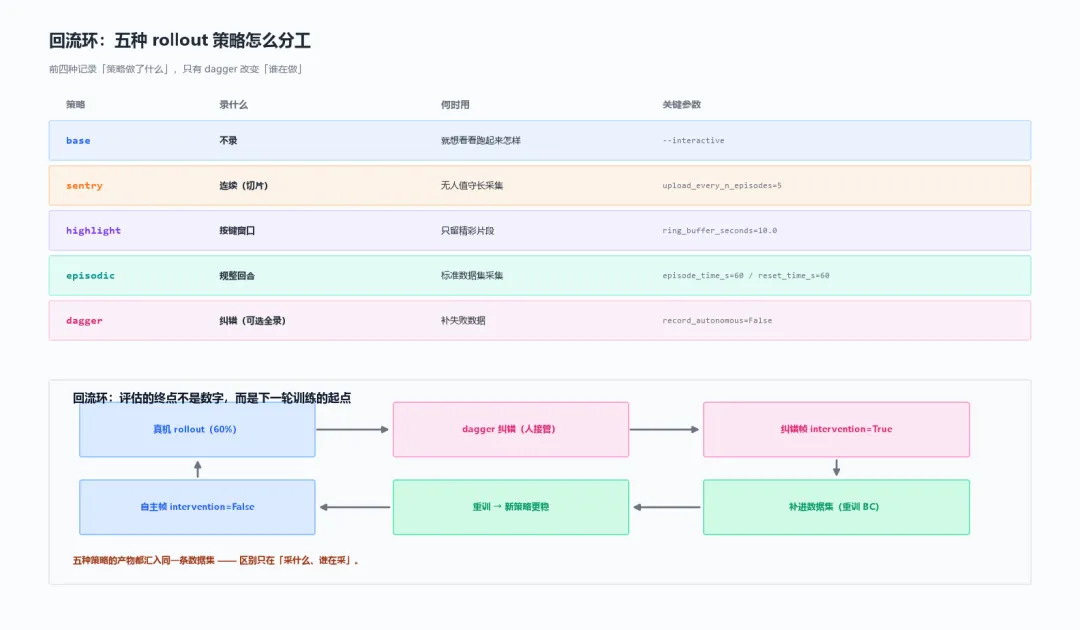
量出"真机只有 60%"之后,方法论的闭环是把失败的那一段收回来、补进数据集、重训。
3.1 五种采集策略:职责与代价
base | --interactive | ||
sentry | upload_every_n_episodes=5 | ||
highlight | ring_buffer_seconds=10.0 | ||
episodic | episode_time_s=60reset_time_s=60 | ||
dagger | 补失败数据 | record_autonomous=False |
前四种录的是"策略做了什么",只有 dagger 改变谁在做。两个坑:sentry 的策略状态跨回合保持、机器人回合间不复位(录的是连续切片,别当独立回合);highlight 有 10 秒延迟窗口(等太久再按,精彩片段已滚出去)。
3.2 DAgger 与 HIL-SERL 的分野
模仿学习的数据集里只有成功轨迹,策略从没见过"搞砸之后怎么救"。DAgger 的三态机让策略自主跑、人按键接管:
AUTONOMOUS --space--> PAUSED --tab--> CORRECTING ^ | | +--------space----------+ <------tab-------+关键在一列intervention(自主帧 False、纠错帧 True)——这是纠错数据能被"区别对待"(只学纠错段 / 学完整恢复过程)的唯一凭据。代价是 requires_teleop=True、必须有人盯着,且用 rename_map 会让"平滑交接"静默失效。
它和 HIL-SERL 都"人在回路",但世界观相反:DAgger 相信"人给的动作是对的,照着学"(BC,数据直接进数据集);HIL-SERL 相信"人给的高奖励轨迹是对的,动作靠自己试更优"(SAC,纠错段进离线 buffer)。两者共用的工程事实——只有人介入的转移才值得额外保存——正是第 06 篇的同一思想。
3.3 重训环:合并、续训与收敛判据
收回来只是原料。原料变成能力要靠一道工序——重训——而这道工序几乎每个开关都埋着默认坑。整条环是:
评估 → rollout 收集 → 补失败数据 → 合并 → 重训 → 再评估——每转一圈,数据集和策略同时变强。
intervention=True 的纠错段 | ||
lerobot-edit-dataset --operation.type=mergeMultiLeRobotDataset | ||
--policy.path=<ckpt>--resume(续训) | ||
--peft(LORA, r=16)/ 分阶段解冻 | evo1 两阶段 | |
fisher_exact |
补什么:dagger 录下的每一帧都带 intervention 列——只有 True 的纠错帧是新知识,自主帧是策略早就会的,混多了反而稀释信号。若跑 RA-BC,sample_weighting(configs/train.py:179)还能按奖励给低质量样本降权。
怎么合:两种方式——物理合并与逻辑合并
物理合并用 lerobot-edit-dataset --new_repo_id=... --operation.type=merge --operation.repo_ids "['原数据集','新dagger数据集']"(datasets/aggregate.py)——注意 merge 认的是 --new_repo_id / --new_root,传 --repo_id / --root 会被忽略并报错;concatenate_videos 控制是否重新拼接(重编码有代价)。
逻辑联合直接用 MultiLeRobotDataset(datasets/multi_dataset.py:34),训练时吃多个数据集,不落盘。
从哪开始:按改动大小选三档——同一任务补几百帧 → warm-start(--policy.path=上一版ckpt,小 lr 接着练);换任务 / 换本体 → 从头或 PEFT(LORA,r=16,target_modules 只训适配器,configs/default.py:197);只是接着没跑完的 → 续训(--resume=true --config_path=<ckpt>/train_config.json)。
一个静默坑:
--resume=true时默认吃 checkpoint 里保存的配置(configs/train.py:121)——你改的配置文件不会生效,必须显式用命令行--*覆盖。想换数据集却只改了 yaml 的人,会以为"重训了",其实在旧数据上原地打转。
何时停:收敛判据不在 loss,而在阶段 C——重训后回真机,与上一版做 fisher_exact,p 不显著就还没赢。经验上 DAgger 迭代 2~4 轮收敛;若几轮都不动,多半不是数据问题(是表征容量、奖励或 sim gap)。
四、分派评估与选型
前三节是全派通用的骨架。但成功率是结果、不是诊断——每一派还有自己的专属病灶,能在真机之前更早报警。这一节先给六派的专属探针,再把三条评估路径拉平对照,最后给选型决策树。
4.1 探针清单:病灶与源码落点
n_action_steps | |||
pi0_fast | |||
recon_loss | |||
estimate_value | |||
sarmtopreward / robometer |
4.2 探针与成功率的分工
这些探针比成功率更便宜、更早,但它们只做一件事:在烧真机时间之前告诉你"哪里不对"。要配对着读——比如 B 派的"解码失败率 = 0",如果实际是环境没给 is_success 造成的,那和成功率恒 0 是同一个静默坑(第 2.5 节)。
一句话:成功率回答"行不行";专属探针回答"为什么不行、还有多久会不行"。
前面是"各派怎么诊断",本节最后收口:"三条评估路径怎么选"。
4.3 三条路径对照表
--eval_steps--dataset.eval_split | --env_eval_freqlerobot-eval | lerobot-evallerobot-rollout | |
| 关 | 开 | ||
4.4 选型决策树
你要什么?├─ 防呆:确认没白学 → 阶段 A:eval_split=0.1 + eval_steps=2000├─ 粗筛:仿真里能不能完成 → 阶段 B:env_eval_freq(训练中)或 lerobot-eval(独立)└─ 结论:真机到底行不行 → 阶段 C:lerobot-eval --eval.n_episodes=50 ├─ 报数:pc_success + pc_success_ci95(成对,缺一不可) ├─ 比较:fisher_exact(两个策略谁更好) └─ 想补数据 → 真机阶段同时跑 lerobot-rollout ├─ 无人值守长采集 → sentry ├─ 只留关键片段 → highlight ├─ 规整数据集 → episodic └─ 补失败数据 → dagger(要遥操作 + 有人盯) └─ 取 intervention=True 的纠错段 → 合并 + 重训(第 3.3 节)一句话:默认的默认,就是官方的态度——离线评估默认关、仿真闭环默认开、真机评估默认渲染 10 个视频。照着这个默认走,你已经比"只看 train loss"的人诚实得多。
五、思考题与下一篇预告
5.1 思考题(7 道)
第 1 题(维度识别):有人说"我的策略 eval loss 只有 0.03,肯定没问题"。请指出他混淆了哪个维度,并说明这一结论在四个维度上各处于什么取值。
第 2 题(口径对比):你跑了 20 个回合,成功 18 个,报出"90% 成功率"。同事说"跟上次那个 16/20(80%)的差不多嘛"。请用源码里的工具说明两者能否分出高下,并给出应写进报告的三行数字。
第 3 题(阶段 A):数据集有 3 个任务、每个 10 个 episode。--dataset.eval_split=0.1 时每个任务留出几个、训练用几个?换成 0.15 呢?若数据集是 --dataset.streaming=true,会发生什么?
第 4 题(阶段 C 的静默坑):你设 --eval.n_episodes=50 --eval.batch_size=8。请算实际跑多少回合、多少被丢弃,并给出一个浪费最小的 batch_size。另外:成功率恒为 0 时,你应该先怀疑什么?
第 5 题(回流选型):新任务的策略在真机上大约每 5 次失败 1 次,失败时都是同一个姿势卡住。你有人能操作遥操作臂、但只能盯 1 小时。在五种 rollout 策略里选哪个?列出必须设的配置项。
第 6 题(重训环):你补录了 30 个 DAgger 纠错回合,想接着上一版继续训。请指出两个"看起来生效、其实没生效"的做法,并给出正确命令。
第 7 题(分派探针):VLA 真机成功率 60%,但把指令从"把方块放进盒子"换成"把方块放进杯子",动作完全一样。请说明这说明什么,并给出一个比成功率更早暴露它的探针。
5.2 下一篇预告
第 08 篇《30 Hz 的战争:推理延迟与 RTC》——把散落在前面各篇里的"推理代价"收成一笔总账:
• 33 ms 的物理约束从哪来,为什么 chunk 是它唯一的解药; • --inference.type=sync与rtc差在哪,execution_horizon=10、max_guidance_weight=10.0在干什么;• 各派的去噪步数拉成一张表:VQ-BeT 自回归 256 步、DiT 的 100 步积分、VLA 的 4~50 步、TD-MPC 的每步一轮搜索; • 异步推理服务器怎么让策略和机器人解耦。
这是全系列"延迟预算"母题的收官篇——所有算法最终都要在 30 Hz 面前低头。
