大模型应用落地越来越多,但怎么判断AI智能体到底好不好用,一直是难题。人工评测耗时长、主观偏差大,版本迭代后性能退化也很难发现。
这个皋陶大模型评测平台,专为Dify智能体等AI系统打造,自动化完成批量测试、多维度打分、可视化报表,让大模型评估告别人工盲测。
源代码:https://www.gitcc.com/wkentaro/ai-llm-plat
1、行业分析🔍
2026年各类LLM应用、AI智能体进入规模化落地阶段,Dify这类低代码智能体平台被大量企业使用。但大模型评测环节普遍短板突出:人工逐条问答评测成本极高,打分标准因人而异,新版本上线后容易出现隐性能力下滑,缺少统一、可复现的自动化评测工具。市面上通用评测工具大多门槛高,缺少面向Dify智能体的配套方案。企业、AI开发者急需轻量化、可私有化部署的评测平台,自动完成批量测试、标准化打分与版本对比,降低大模型应用的质量管控门槛。
2、系统功能📊
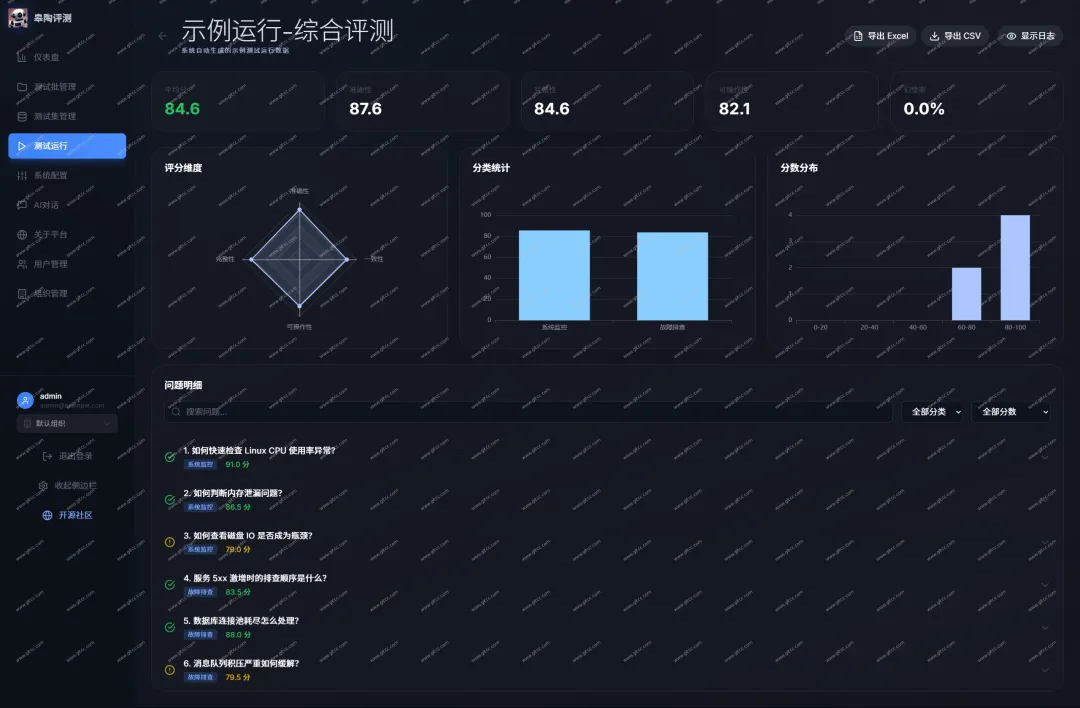
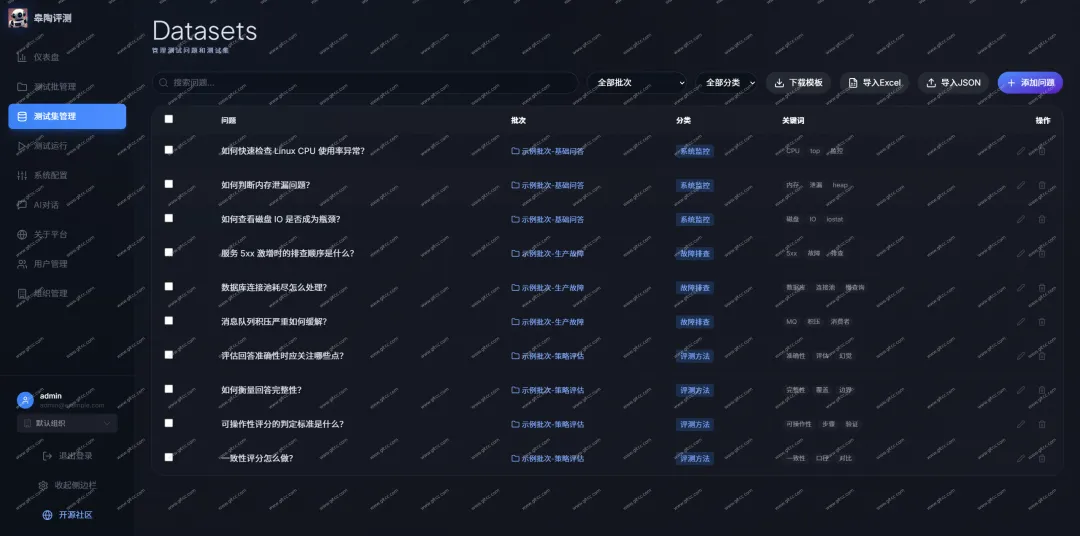
皋陶平台是专业大模型能力评测解决方案,核心模块完整覆盖评测全流程:✅ 测试集管理:支持JSON批量导入测试问题,增删改查、分类管理,自带测试集模板。✅ 自动测试引擎:100问自动化测试,调用Dify API获取AI回答,管理测试批次、实时追踪进度。✅ AI评分模块:基于通义千问LLM Judge,采用四维评分体系:准确性40%、完整性30%、可操作性20%、一致性10%,自动生成评分。✅ 可视化报告:雷达图、柱状图、分数分布图,可查看单条问题详细评分与优化建议。✅ 版本对比:多版测试结果横向对比,追踪性能变化趋势,可视化版本差异。
核心解决四大痛点:评测效率低、评分主观、结果难分析、版本性能难以追踪,自动化测试可将评测效率提升90%以上。
3、AI时代的趋势🤖
AI行业正在从“快速搭建应用”转向AI应用质量工程化。早期大家聚焦快速搭建智能体,现在行业重心转向可量化、可回归的质量管控。单纯看大模型基础参数远远不够,需要针对业务场景做专项评测。LLM Judge自动打分、自动化回归测试、版本性能比对,正在成为AI开发的标配流程。皋陶平台正是顺应这个趋势,把大模型评测做成标准化流水线,每次迭代都能自动核验AI能力是否退化。
4、技术架构⚙️
项目采用前后端分离架构,支持Docker容器化一键部署。
- • 前端:React18 + Vite5 + Tailwind CSS,ECharts实现各类评测数据可视化。
- • 后端:Python3.11 + FastAPI,搭配Uvicorn、SQLAlchemy、Pydantic。
- • 数据库:内置SQLite嵌入式数据库,开箱即用。
- • 部署方案:Docker & Docker Compose、Nginx。整套技术栈轻量化,不需要复杂中间件,开发者本地或服务器都能快速拉起环境,二次开发门槛低。
5、细分落地💡
- • 运维智能体评估:对Dify搭建的运维智能体,使用标准100问测试集做自动化评测,评估准确性、实用性,输出报告指导迭代。
- • LLM应用质量监控:上线后定期执行回归测试,监控版本更新带来的能力变化,发现性能下滑及时预警。
- • 竞品对比分析:使用同一套测试集,批量评测多款大模型/智能体,保证对比公平,输出横向分析报告。
- • AI研发团队:作为内部质量工具,每次智能体版本发布前自动跑评测,减少人工评审工作量。
6、案例说明📝
某企业基于Dify搭建内部运维智能体,每次版本更新都需要测试人员人工逐条提问评估,一轮评测要2天,打分标准因人而异。接入皋陶评测平台之后,导入运维100问测试集,一键启动自动化测试,一轮评测缩短至几十分钟,效率提升超90%。依靠LLM Judge四维标准自动打分,生成雷达图报告,并且可以直接对比新旧版本,快速定位更新后AI回答准确性下降的问题。
7、市场推广📢
目标人群:Dify使用者、AI应用研发团队、大模型产品经理、AI测试工程师、LLM开源爱好者。推广思路:在开源社区放出源码与Docker一键部署教程,提供演示环境;重点突出适配Dify智能体、轻量化部署、LLM Judge四维评分、版本对比等差异化亮点;输出评测实战教程,分享智能体版本回归测试落地案例,吸引AI开发者试用、二次开发。
8、行业价值🏆
皋陶填补了轻量级大模型应用自动化评测工具的缺口。它把原本高成本、主观化的大模型人工质检,变成标准化自动化流程。帮助企业量化智能体能力,规避版本迭代带来的AI能力退化,也为AI产品团队提供统一、可复现的评估基准,推动LLM应用质量工程化落地。
皋陶大模型评测平台,面向Dify智能体提供自动化批量测试、LLM四维打分、可视化报表与版本对比,轻量化容器部署,实现大模型应用标准化质检。
源代码:https://www.gitcc.com/wkentaro/ai-llm-plat
你在开发Dify智能体时,是否遇到过版本更新后AI能力下滑的问题?
欢迎聊聊你的大模型评测踩坑经验~