当模型越来越多,选哪个反而成了一门学问。
你有没有过这种时刻——
想找个 AI 帮忙,却被一堆名字绕晕:GPT、Claude、Gemini、Kimi、DeepSeek、GLM、Qwen、MiMo……它们到底谁更聪明?谁只是名气大?
最近,第三方 AI 模型排行榜 AIHOT 更新到了最新一期:35 项统一考试、7 家独立评测机构、30 个热门模型同台竞技。
结果有点出乎意料:综合第一,不是如日中天的 GPT。
这篇文章不讲天书,用大白话把榜单拆给你看——谁是全科状元、谁是偏科天才、谁便宜又好用,以及学生、上班族、程序员等不同身份的你,到底该怎么选。
01 先花 1 分钟,搞懂这张榜怎么看
要看懂排名,先得明白这张榜的“规矩”。它和厂商自己发的宣传稿,完全是两回事。
| |
|---|
| 不看厂商自卖自夸,全部由独立机构用同一套题,给每个模型考一遍 |
| 50 分是参照组平均水平,每 15 分约一个档次;分数不是正确率,而是相对段位 |
| 编程 40%、科研 20%、专业办公 20%、知识问答 15%、真人盲选 5% |
| |
| |
特别值得注意的是:编程权重高达 40%,是所有维度里最高的。这说明在行业眼里,能不能真的把活干出来,比知道多少更重要。
02 综合榜:三家争霸,第一名差一点就易主
先看最受关注的综合榜,前 10 名如下:
这张表有三个看点:
第一,Anthropic 是这一期的最大赢家。前五名里,它一家占了三席,Claude 这条产品线整体发挥非常稳。
第二,第一名的位置并不稳。前三名评分是 73.9、73.5、72.2,第一名和第二名只差 0.4 分。这意味着只要下一场考试谁多对一道题,王座就可能换人。
第三,国产模型已经追到了第二梯队。名次最高的是 Kimi K3,第 13 名(63.2);小米 MiMo Pro 第 15 名(62.9);GLM-5.3 第 17 名(62.4)。它们和头部还有大约 10 分的差距,但已经实实在在站在了同一条赛道上。
03 编程榜:Claude 的“祖传手艺”
编程是综合榜里权重最高的维度,我们先看它。前五名:
前两名被 Claude 包揽,前五里 Claude 占了三席。
写代码、做软件、修 bug、把一整套程序搭起来跑通,这件事上 Claude 像个手艺稳定的老师傅:不只是能写出几行代码,而是能把一个完整的软件做出来。
国产编程的第一名,是小米 MiMo Pro,排第 11 名(64.0);GLM-5.3 紧随其后,第 12 名(63.3)。对国产模型来说,编程恰恰是它们冲得最靠前的一项。
04 科研榜:GPT-6 Astra 的“最强大脑”
再看科研维度,前五名:
综合榜上只排第 5 的 GPT-6 Astra,在科研榜直接登顶,77.6 也是本期所有单项里的最高分之一。
研究级的数学、物理、逻辑、复杂推理,是它的主场。这就好比班里那个竞赛大神:平时综合排名不算最靠前,但一遇到真正的难题,全场就他一个人解得出来。
国产这边,Kimi K3 排第 17 名(62.8)。
05 专业办公榜:唯一的“断层第一”
专业办公维度,前五名:
这是五个榜单里最夸张的一个:Gemini 4 Argon 76.4,领先第二名足足 5.1 分。要知道其他榜单的名次差距,往往只有零点几分。5 分,就是“断层级”的领先。
写报告、做方案、跑业务流程、金融法律分析、数据分析这类“职业交付件”,它目前是独一档。
但这里要泼一盆冷水:Gemini 4 Argon 是 9 月 30 日才上线的新模型,评测只覆盖了大约 75%,价格也还没核验。换句话说,它的“考试科目还没考完”,这个第一还需要更多成绩来坐实。
国产模型在这一项咬得很紧:小米 MiMo Pro 第 13(65.2)、Kimi K3 第 15(63.8)、Qwen Max 第 16(63.4)。
06 知识问答:学霸贴身肉搏,也有人意外翻车
知识问答维度,前五名:
前两名 GPT-6 Astra 和 Claude Fable 5.1 只差 0.2 分,几乎是贴身肉搏。事实准不准、长文懂不懂、能不能识破问题里埋的“坑”,它们最稳。
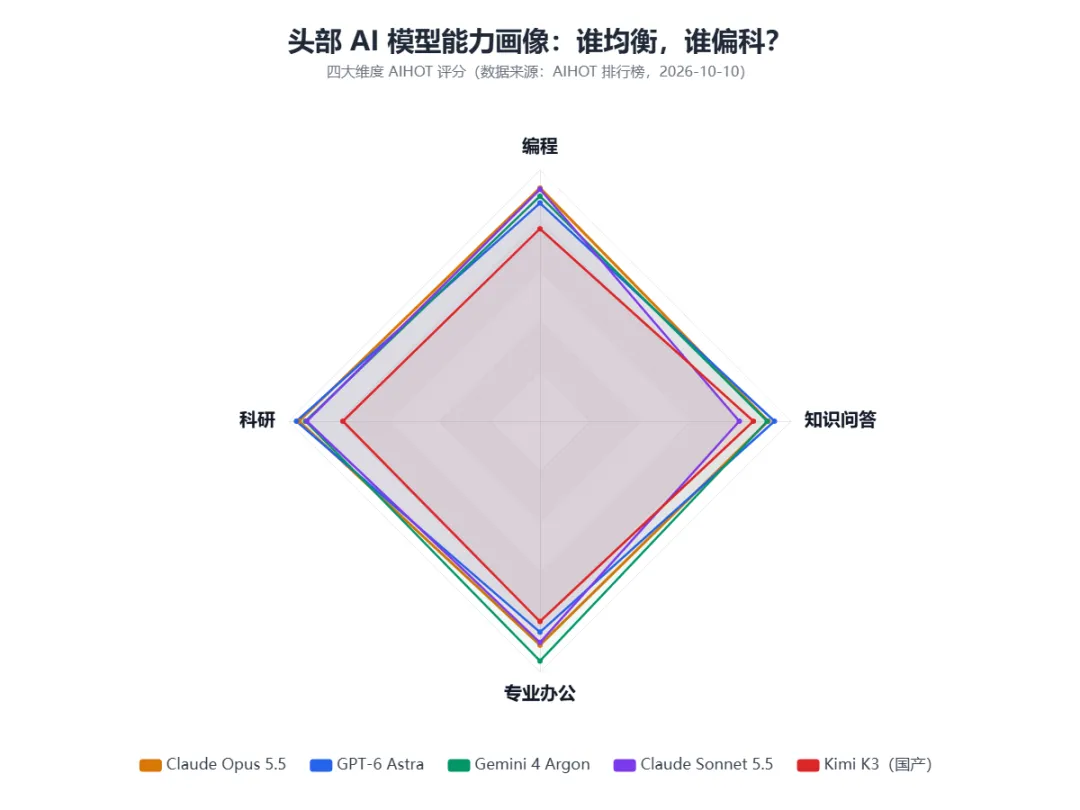
最有意思的是“偏科现场”:编程榜排第二的 Claude Sonnet 5.5,在知识问答榜上直接掉到了第 15 名。这说明没有模型能在所有科目上通吃——哪怕是学霸,也有自己的软肋。
国产这边,Kimi K3 排第 10(68.0),这是它五个维度里最靠前的名次。
把头部模型的四项评分画在一张雷达图上,谁面积大、谁在某个角凸出来或凹进去,一眼看清。
07 给模型“排个座次”:它们像班里的谁
把冷冰冰的型号翻译成人设,一下子就好记了:
| | |
|---|
| | 综合、编程双第一,几乎不偏科,交给他最放心,唯一缺点是贵 |
| | 科研、知识问答双第一,越难越来劲,但编程、办公不是最顶,价格第一档 |
| | 专业办公断层第一、综合第二,但考试还没考完、学费未知,需要再观察 |
| | 综合第 4、编程第 2,价格只有旗舰一半,可惜知识问答意外拉胯 |
| | 9 月底刚上线,科研第 3、综合第 7,价格还不贵 |
| | 五个维度最均衡的国产选手,知识问答冲进前 10,而且开源 |
| | |
| | 开源、便宜、覆盖全,日常活和大批量任务的性价比之选 |
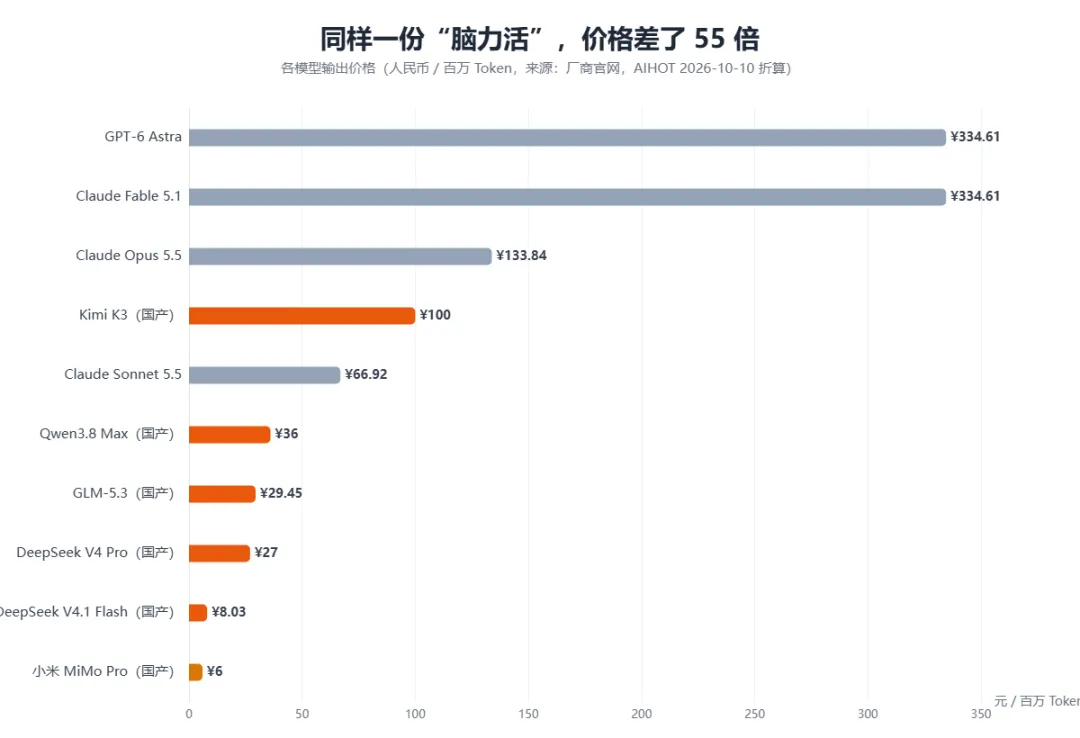
分数差 10 分,价格却可能差几十倍,这笔账值得算清楚。
这张图说明了什么?
最贵的 GPT-6 Astra、Claude Fable 5.1,输出价格是每百万 Token 334.61 元;小米 MiMo Pro 只要 6 元,相差约 55 倍;DeepSeek Flash 输出 8.03 元、输入大约 2 元。
说句大白话:同样一份脑力活,有人收头等舱的价钱,有人收公交的价钱,而它们的分数差距,其实只有十来分。
08 不同身份的你,重点该看哪张榜
别盯着综合第一不放,先找到自己那一行:
| | |
|---|
| | |
| | 性价比选 Sonnet,或国产 MiMo / GLM / Qwen |
| | 复杂系统活上 Opus,日常写代码用 Sonnet / Flash,盯紧 API 成本 |
| | |
| | 难题用 Astra、交付看 Gemini,但专业内容必须人工复核 |
| | |
09 一套不踩坑的选型方法
最后,给你一套可以直接用的判断框架,一共六条:
- 先问“我主要让它干嘛”,再选模型——很多时候,偏科生比全科生更适合你。
- 看“评测覆盖度”:低于 80% 的成绩,先打个问号,比如 Gemini Argon。
- 日常粗活用便宜模型,硬仗再租旗舰——就像平时坐公交,急事才打车。
- 学会搭配:便宜模型干 80% 的活,贵模型只做关键把关。
- 分数差 5 分以内,日常体验的差距,远小于价格的差距。
- 榜单每个月都在变,选型别一锤定音,给自己留个“备胎”。
写在最后
其实这张榜最想告诉我们的,从来不是“谁是天下第一”。
模型没有绝对的赢家,只有适不适合你手头那件事。
对普通人来说,真正拉开差距的,也许不是用了哪个模型,而是你能不能把自己的问题问清楚、把 AI 用进真实的工作和学习里。
工具会一直更新,但“会提问、会判断”这件事,短期内还替代不了。
几点说明
AIHOT 评分是相对刻度,不是正确率,70 分不等于 70% 的题都能做对;榜单考的是标准化题目,真实场景可能有差异,重要的事最好自己再试一遍;模型也会“一本正经地出错”,涉及钱、健康、法律等关键决定,务必人工核实;本文数据截至 2026 年 10 月 10 日,模型迭代很快,排名随时可能变化。