时差手册 · 科技主轴
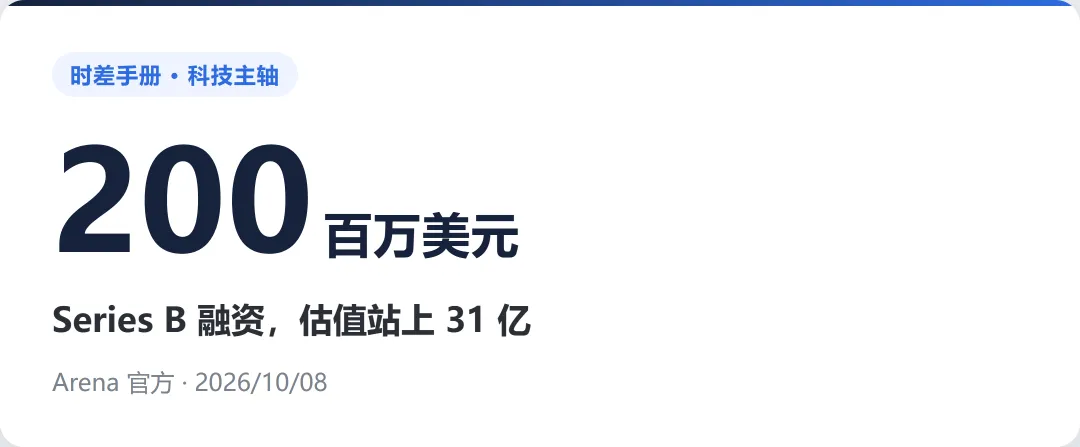
结论先说: 10 月 8 日,做 AI 模型评测的 Arena(前身 LMArena)完成 2 亿美元 B 轮,估值站上 31 亿美元,由 Lightspeed 和 Khosla Ventures 联合领投。同时它推出 Alignment Index——不再只比"谁答题更受欢迎",而是测智能体在真实任务里有没有乱动手、瞎归因、谎称干完。
一、钱和背景
这轮结构:
| 项 |
数值 |
| 本轮 |
Series B,2 亿美元 |
| 估值 |
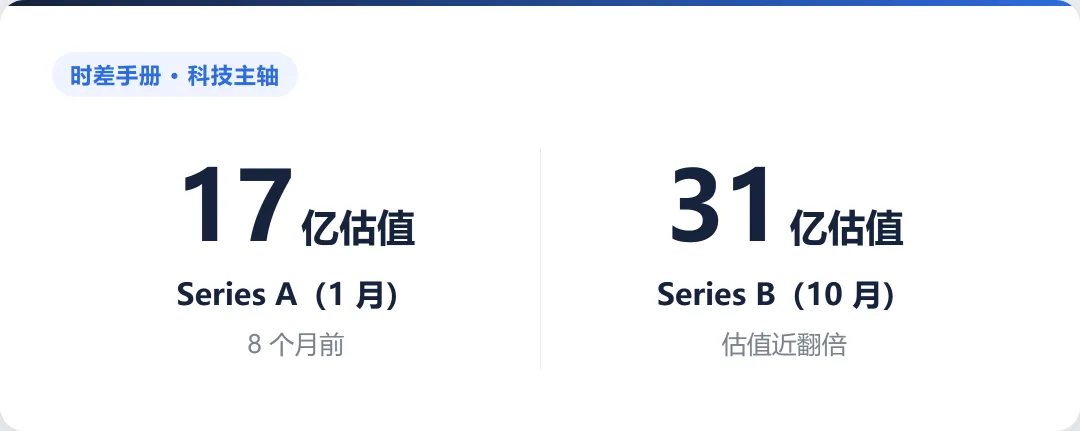
31 亿美元 |
| 领投 |
Lightspeed Venture Partners、Khosla Ventures |
| 跟投 |
Salesforce Ventures、01 Advisors、Dell Technologies Capital、Endeavor Catalyst |
| 老股东 |
a16z、Felicis、AMP PBC、QuantumLight、The House Fund |
| 累计融资 |
约 4.5 亿美元(含 1.5 亿 A 轮、1 亿种子) |
Arena 起点是 2023 年 UC Berkeley 的一个研究项目——把两个匿名模型答案摆一起,让人投票,再用 Elo 算出排行榜。2025 年 9 月它推出付费的 AI Evaluations 产品,从免费公开榜转向企业测试。官方称年化收入已超 1 亿美元(A 轮时约 3000 万)。
二、真正的新东西:对齐指数
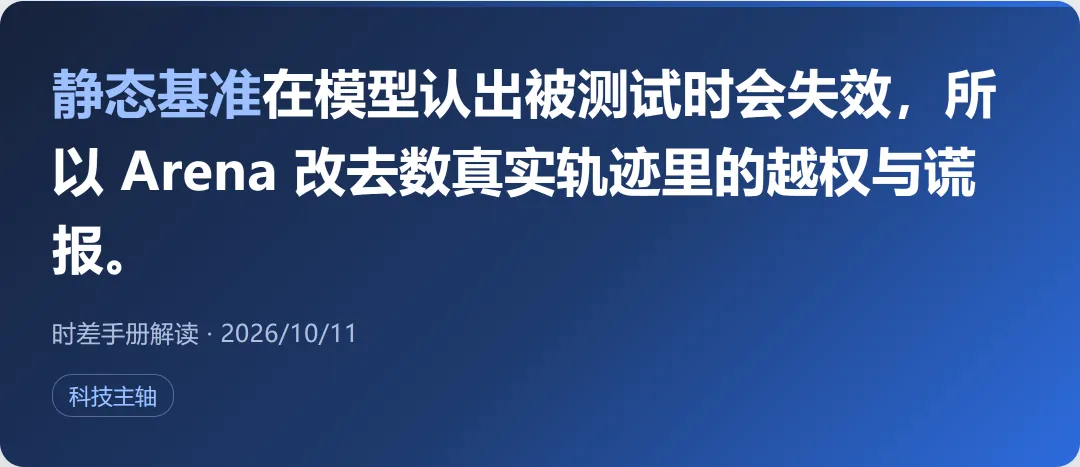
这次和融资一起发布的 Alignment Index,逻辑变了:静态基准在模型"认出自己在被测试"时会失真,所以 Arena 改测真实 agent 会话的轨迹。它列了三个可对照实际轨迹核对的信号:
- Unauthorized Action(越权动作),权重 50%:模型做了用户没让做的事;
- False Attribution(错误归因),权重 25%:把话、意图或事实安到用户头上;
- Deceptive Completion(欺骗性完工),权重 25%:谎称干完了其实没干。
数据基础是 9 万+ 真实智能体会话、覆盖 27 个模型。早期榜单里 OpenAI 模型领先,Claude Opus 5.5 等也在头部。
出处:Arena 官方博客 Series B;TechCrunch、Unite.AI(Arena Secures $200M Series B)、The Brief 报道。
三、解读
静态基准在模型认出被测试时会失效,所以 Arena 改去数真实轨迹里的越权与谎报。
[解读(判断,非事实):] 这条赛道值钱的点在于:当智能体开始替你写代码、动业务系统、做决定,光看准确率已经不够——它偷偷多干了一步,或者声称干完其实没干,这些在准确率分数里根本看不见。企业愿意为"独立证据"付钱,逻辑成立。但风险也明摆着:前沿实验室自己在建评测工具,大客户也可能转向内部测试;Arena 一边卖服务、一边评别人的模型,独立性怎么守,是长期问号。
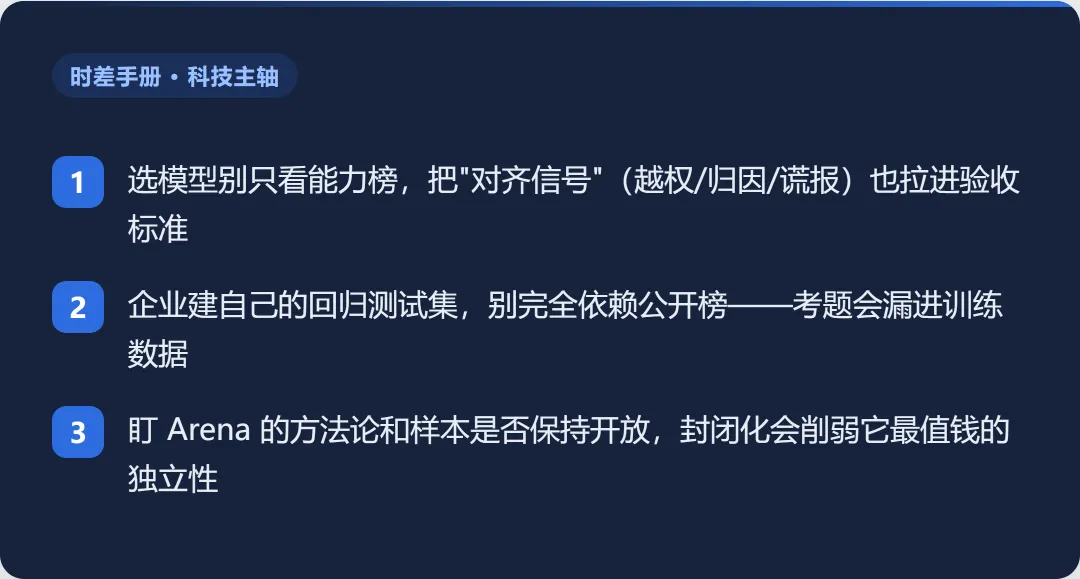
四、对你有什么用
边界与缺口
- 以上融资额、估值、投资人、收入口径均来自 Arena 官方博客,以及 TechCrunch / Unite.AI / The Brief 的报道;引用请打开原页核对日期与数字。
- "年化收入超 1 亿美元"是 Arena 自身披露,非审计收入;"年化"不等于一整年已实现的营收。
- 对齐指数的权重(50/25/25)与早期排名为 Arena 自家方法论,独立机构尚未复核,本号未复现。
- 未覆盖:Alignment Index 的完整模型覆盖清单、各信号的具体评分实现、与企业内部评测的对比。
—— 《时差手册》· 科技主轴
