导读:今年 1 月 Anthropic 发了评估长文《Demystifying Evals for AI Agents》,方法论讲得很全。但读完方法论和搭建平台之间隔着一批工程决策:数据模型怎么定、判分器怎么组织、报表报什么、沙箱怎么隔离。这篇把长文当设计依据,按「底座→判分→运行→报表→边界→上线」六个模块给出九个落地方案,每节末尾附一张实操卡。想上手试平台,文末有入口。 📖 本篇目录 01 读完论文,离搭建平台还差什么 02 底座|数据模型:八个术语直接变表结构 03 判分|判分器引擎:三类做成插件 04 判分|判分红线:评结果,不评路径 05 判分|任务质量门禁:参考解法是体检 06 运行|套件双轨制:能力和回归分开建 07 运行|沙箱隔离:每次尝试从干净环境开始 08 报表|pass@k 与 pass^k 都要摆出来 09 报表|能看轨迹,才敢信分数 10 边界|平台只是防线之一 11 上线|冷启动:九步路线图当脚本 01 读完论文,离搭建评测平台还差什么
Anthropic 这篇长文易读,难点在读完后无从下手。评估要有任务、判分器、套件,它讲了;可这些概念落到数据库里是哪几张表,它没讲。LLM 裁判要与人工校准,它讲了;可校准流程嵌进平台的哪个环节,它没讲。方法论和平台之间,隔着的是一批必须自己做的决策。
我这段时间搭了一套 Agent 评测平台,把这篇论文当设计依据用了全程。踩过的坑和做过的取舍,都能在原文里找到对应的条款。这篇把答案拆成六个模块:每个决策先说平台要回答的问题,再说原文的依据,最后说我怎么落。
02 底座|数据模型:八个术语直接变表结构
平台的第一个问题是:一次评测在数据库里长什么样。原文的八个术语其实就是答案,照抄就行。
任务(task)和尝试(trial)必须分成两张表。任务定义输入和成功标准,尝试是任务的一次执行。这一步最容易被省略,省略的代价是报表只剩单次结果,波动全被吞掉。判分器(grader)挂任务、产出得分,一个任务挂多个判分器。轨迹(transcript)全量落库,工具调用、推理过程、中间结果一条不丢,出了问题要回看过程,靠的就是这份全量。
八个词里最该单独建字段的是结局(outcome):尝试结束时环境中的最终状态。订机票智能体嘴上说「已订好」,真正的结局是 SQL 库里有没有那条记录。我把结局做成独立于答复文本的结构化字段,判分器优先读结局,轨迹只负责解释它。这个字段决定了平台判的是现实,还是模型的口头汇报。
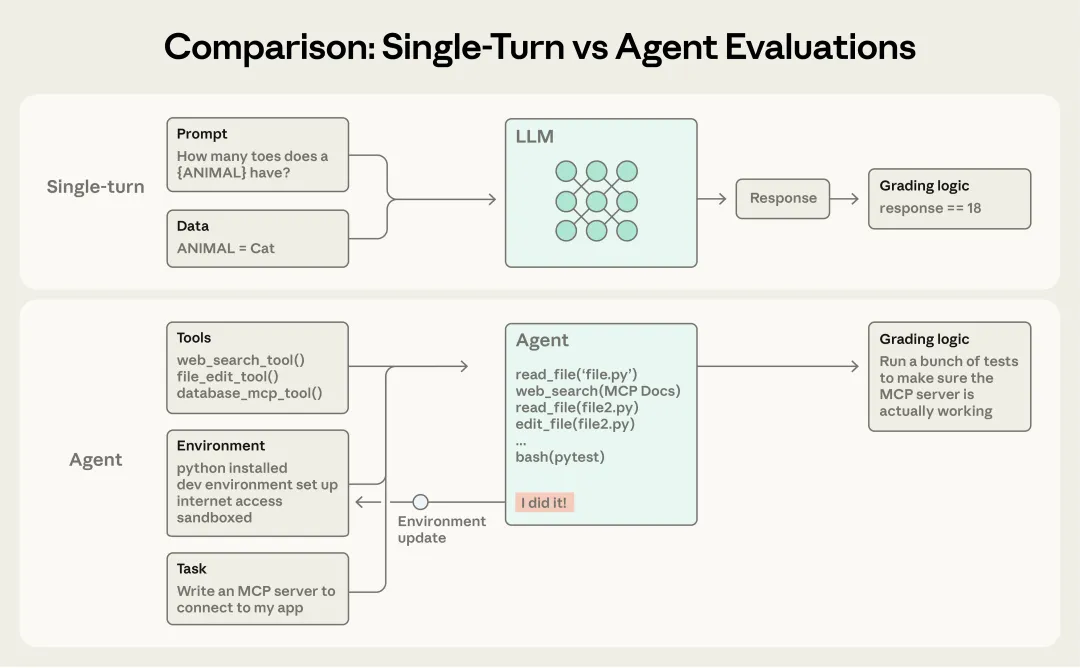
▲ 单轮评估与智能体评估的对比:智能体评估多了环境和工具
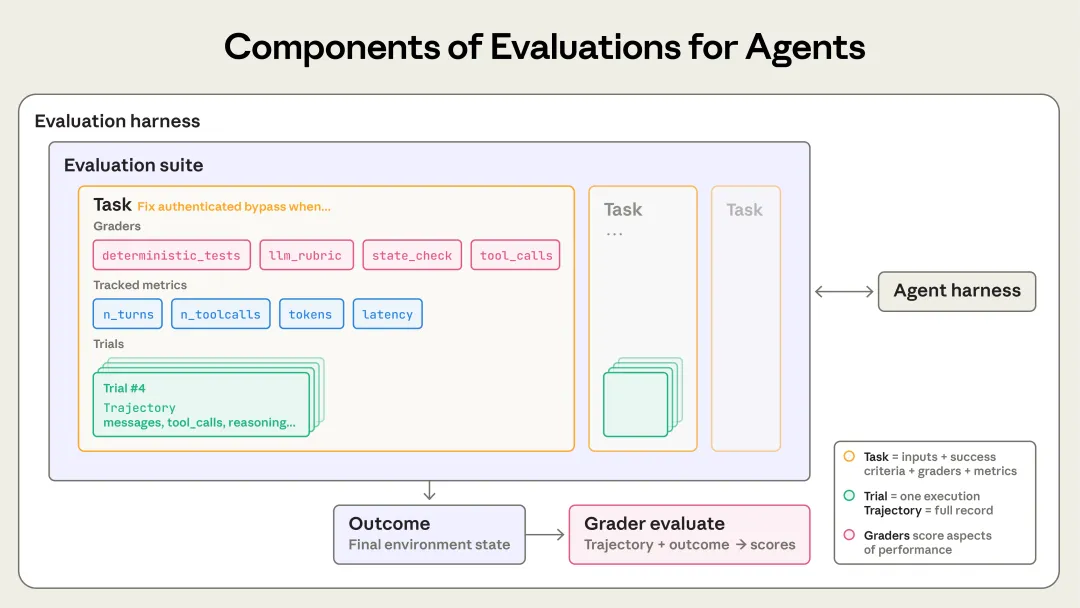
▲ 评估的完整组成:判分器拿轨迹加结局算分
实操卡|数据模型我的第一件事是把八个术语写成三张表,字段如下: | | |
|---|
| task_id、任务描述、environment_id、grader_ids、reference_solution | |
| agent_version、sandbox_id、起止时间、outcome_json、transcript_uri | |
| verdict(pass/fail)、evidence(如订座记录 ID)、final_state(终态快照) | |
| | |
03 判分|判分器引擎:三类做成插件
原文把判分器分三类:代码判分器快、便宜、可复现,但只认标准答案;模型判分器灵活、能评主观维度,但不确定、需要校准;人工判分器是黄金标准,但贵且慢。落到平台上的决策是:把三类做成统一的插件接口,按任务挂载,而不是在代码里写死某种评法。
有两个细节值得单独说。一是 LLM 裁判要留退路:原文明确建议给它「信息不足时返回 Unknown」的出口,否则裁判会对没把握的题硬编一个分数。二是合成方式要可配置:加权达标、全部必须通过、混合式,原文给了三种,不同任务性质选不同的。平台把合成策略做成任务级配置,判分器只管打分,怎么合成它说了不算。
实操卡|判分器引擎我把三类判分器收进同一个插件接口,再加了四条平台级约束: | | |
|---|
| grade(trial) 返回 pass / fail / unknown | |
| 温度 0、强制 JSON 输出、允许返回 unknown | |
| | |
| all_pass / weighted / hybrid 三选一 | |
04 判分|判分红线:评结果,不评路径
原文里我最认同的一句话是:给智能体产出的结果判分,而不是给它走的路径判分。检查智能体是否严格按特定步骤执行,会产出过于脆弱的测试,智能体经常找到评估设计者没预料到的合理路径。τ²-bench 那道订机票题就是活例子:Opus 4.5 绕开原始路径,给用户找到了更好的方案,按评估的原始写法却「不及格」。
原文还用两个翻车案例说明「分数低先怀疑评估」。Opus 4.5 在 CORE-Bench 上最初只得 42%,排查发现是评分方的 bug:刻板的判分把「96.12」判错,因为预期答案写着「96.124991...」。修复评分、换用限制更少的框架后,得分跳到 95%,模型一行代码没改。METR 的「时间跨度」基准里,任务要求把分数优化到某个阈值,判分却要求超过该阈值,守指令的模型被罚分。这两件事决定了平台的两条红线:判分器默认评结局、允许部分得分(多环节任务按完成度给分),并且内置对判分器本身的回归测试,评估自己也要被测。
实操卡|判分红线我给判分器画了三条红线,写进代码而不是文档:05 判分|任务质量门禁:参考解法是体检
判分红线画完,平台还要对「任务本身」做质量控制。原文步骤 2 给了硬标准:好的任务,两位领域专家独立评估会得出相同的通过或失败结论;判分器检查的一切,都应当能从任务描述中明确推出。
原文还有一个实用的判据:对前沿模型,多次尝试后通过率仍是 0%(0% pass@100),多半说明任务本身坏了,该回头查任务描述和判分器。平台把这个判据做成了自动告警。另一个照抄的设计是参考解法(reference solution):每个任务配一份已知能通过全部判分器的标准解法,既证明任务可解,也验证判分器配置正确。它本质上是平台的体检机制,任务入库时跑一遍参考解法,判分器坏了当场暴露。步骤 3 的双向平衡同样值得搬进平台:既测「该做的做没做」,也测「不该做的做没做」,Anthropic 做网页搜索评估时在漏触发与过触发之间打磨了很多轮,单侧的任务集只会养出单侧优化的智能体。
实操卡|任务质量门禁每个任务入库前,我的平台强制过四道检:06 运行|套件双轨制:能力和回归分开建
原文对评估套件的两分法,直接决定了平台的套件模型。能力评估(quality eval)专挑智能体搞不定的任务,通过率初期就该很低,它给团队一座值得爬的山。回归评估(regression eval)的通过率应该接近 100%,它是防倒退的保护网,分数一滑就说明哪里坏了。
很多平台的坑是把两类任务混在一个套件里,结果回归任务拉低能力分、能力任务污染回归基线,两边都失真。我的落法是套件建两个类型字段,报表分开统计。原文还给了第三个设计:通过率已经很高的能力任务可以「毕业」进回归套件,从衡量「能不能做到」变成衡量「还能不能稳定做到」。我把毕业做成一条显式的套件流转通道,而不是靠人工搬数据。
实操卡|套件双轨我把套件建成两套池子加一条通道,红线各不相同:07 运行|沙箱隔离:每次尝试从干净环境开始
这是我在平台上付出过真实代价的一个决策。原文在路线图步骤 4 里讲得很直白:每次尝试都应当从干净环境隔离启动,运行之间残留的共享状态会造成「因为基础设施抖动、而非智能体水平」的关联性失败。
原文还给了一个更隐蔽的案例:Anthropic 在内部评估中观察到,Claude 会去读之前尝试留下的 git 历史,从而获得不当优势。残留状态不只是冤枉智能体,还会虚高分数。所以平台侧的落法只有一条:每次尝试独立沙箱、文件系统和缓存全部重置,多任务并发也不共享工作区。这条做晚了,前面跑出的所有分数都要打折重看。
实操卡|沙箱隔离这是我交过学费的一块,现在每次尝试都按这张表跑: | |
|---|
| |
| |
| |
| 超时 10 分钟 / 生成 4096 token / 单条输出 64K 字符,触发即打标 |
08 报表|pass@k 与 pass^k 都要摆出来
智能体每次运行都有波动,只报一个平均通过率,等于把最重要的信息藏起来了。原文给了两个互补指标:pass@k 是 k 次里至少成一次的概率,射门次数越多越容易进球;pass^k 是 k 次全成的概率,门槛陡峭得多。单次成功率 75% 的智能体,跑 3 次全过只剩 (0.75)³ ≈ 42%。
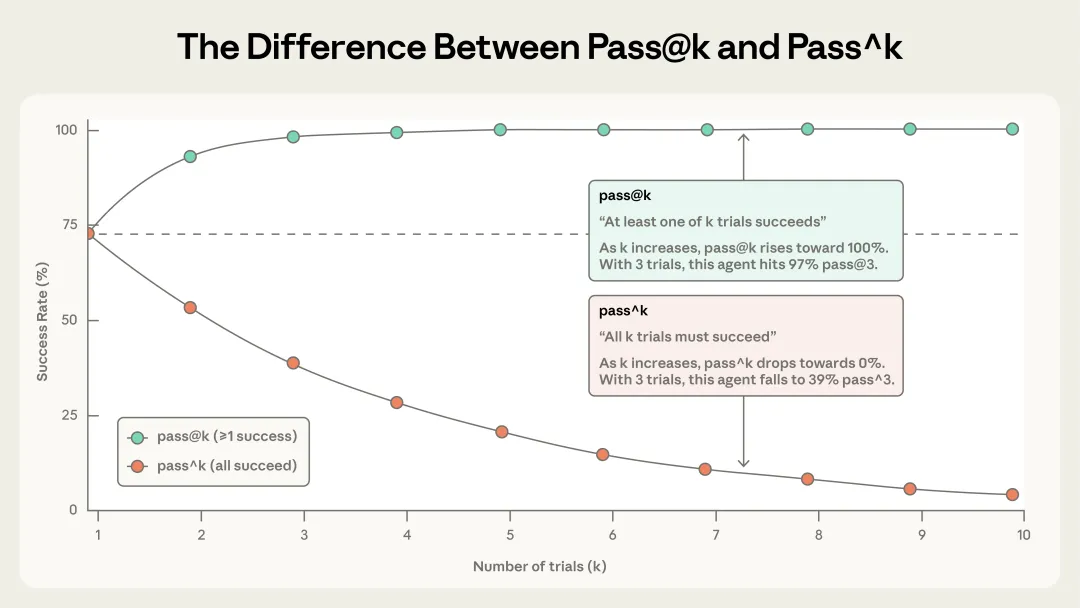
▲ k 增大时 pass@k 与 pass^k 走向分化:一个趋近 100%,一个跌向 0%
落到平台上,我把两个指标都做进了报表:工具型场景看 pass@k,成一次就可用;面向用户的场景看 pass^k,每次都得可靠。同一个智能体,这两个数字可能讲出完全相反的故事。平台只负责把两个都摆出来,挑哪个当主指标,看你的场景。
实操卡|双指标报表我的报表固定三列,能力与回归套件分开聚合:09 报表|能看轨迹,才敢信分数
原文经验法则的原话是:在有人深入评估细节、读过若干轨迹之前,不要把评估分数当作字面结论。这句话决定了平台的一个优先级排序:能看轨迹,才敢信分数。轨迹查看器是日常主界面,不是附属功能。失败应当「看起来公平」,能清楚看出智能体错在哪;分数不再上涨时,你要能确信那是水平问题,不是评估的问题。
配套的还有饱和监控。原文步骤 7 指出,100% 通过的评估只能追踪退化,无法提供改进信号;SWE-bench Verified 今年初还是 30%,前沿模型已逼近饱和区。代码评审公司 Qodo 起初对 Opus 4.5 不感冒,因为他们的一次性编码评估捕捉不到模型在更长任务上的收益,换了评估框架后进步的图景才清晰。平台因此加了饱和告警:通过率逼近上限的套件,会提示该扩难度了。
实操卡|轨迹查看器我把轨迹做成一等功能,具体做了三件事: | |
|---|
| 完整消息流、工具调用入参出参、每步耗时与 token 数 |
| 超时 / 判分失败 / 裁判 unknown 三类,先看分布再下钻个案 |
| 每个新版本读 10 条(5 成功 5 失败),这条纪律最早发现问题 |
10 边界|平台只是防线之一
最后一条决策是认清平台的边界。原文把自动化评估放回更大的图景:它能在数千个任务上运行、不影响真实用户,但只是理解智能体性能的方式之一,完整防线还包括生产监控、A/B 测试、用户反馈、人工轨迹评审和系统性人类研究。
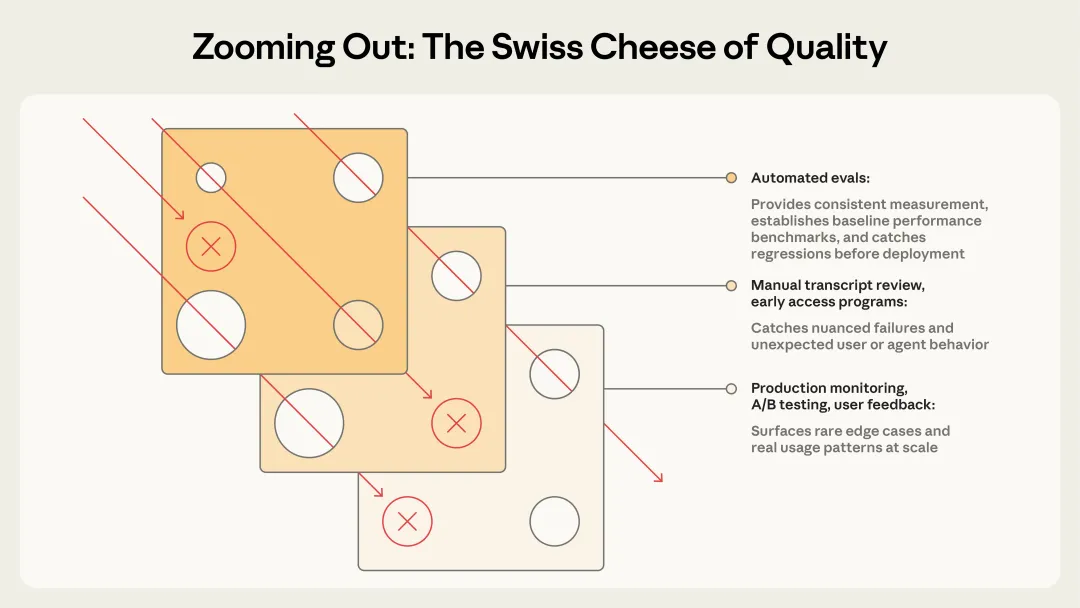
▲ 质量防线的瑞士奶酪模型:没有哪一层能单独拦住所有问题
原文给的分工很明确:自动化评估守住上线前和 CI/CD,是第一道防线;上线后交给生产监控检测分布漂移;流量充足后用 A/B 验证重大改动;系统性人类研究留给校准 LLM 裁判这类场景。落到平台上,我做的是暴露标准接口:评估结果推送 CI 门禁、失败轨迹导出给人工评审、判分数据回流给 LLM 裁判校准。平台不去抢别的防线的活,把自己的那一层奶酪做扎实。
实操卡|平台边界我给平台留了三个对外接口,别条防线的活不抢:11 上线|冷启动:九步路线图当脚本
平台搭好后第一个问题是:评测任务从哪来。原文的九步路线图(0 到 8)可以直接当冷启动脚本用:尽早开始,20 到 50 个从真实故障提炼的任务就是绝佳起点;从手工测试和工单队列里转化用例;写无歧义任务配参考解法;建双向平衡的任务集;再进入框架、判分器、读轨迹、监控饱和、长期维护的循环。
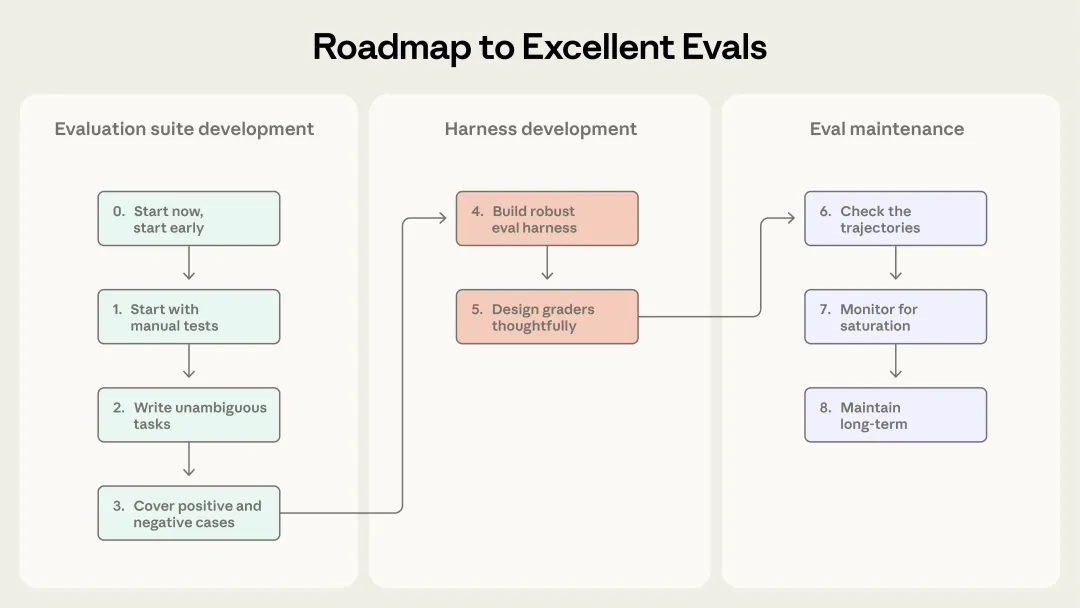
▲ 评估建设路线图:三个阶段,九个节点
六个模块铺完,回到原文那句贯穿始终的判断:评估的价值会复利增长,前提是把它当核心组件,而不是事后补丁。平台也一样。如果你也在搭,我的建议是从最小的一步开始:挑一个真实故障,把它写成第一个带参考解法的任务。
实操卡|冷启动两周计划我的冷启动是按两周排的,照做就能跑起来: | | |
|---|
| 从工单和手工测试记录里挑 20 个真实故障,写成任务并配参考解法 | |
| | |
| 回归凑满 10 个任务接 CI 门禁;50 个任务前维持 all_pass | |
试用入口:想亲手给自己的 Agent 跑一轮评测?关注「银翼 AI 评测室」,私信「评测」,我拉你进试用名单,附一份冷启动任务模板。 参考资料 1. Demystifying Evals for AI Agents, Anthropic Engineering, 2026-01-09