线上问诊与购药,是 AI Agent 走向日常应用的一个具体场景。用户带着症状和用药需求而来,模型需要通过对话了解情况,再给出合适的药品推荐。
这首先涉及一个判断:下一步该做什么?信息不足时继续追问,信息充分时给出推荐,遇到用户的问题时及时回应。如何让同一个模型掌握这些能力,是这次问诊 Agent 训练实践的起点。
整个实践经历了模型研发、部署审核和最终上线,期间迭代评测了近百个模型版本,选择近十个部署,最终才有一个能成功上线。 评测贯穿其中:训练指标与日志、测试结果与具体案例、业务专家的审核和上线后的用户反馈,共同支撑着模型迭代。
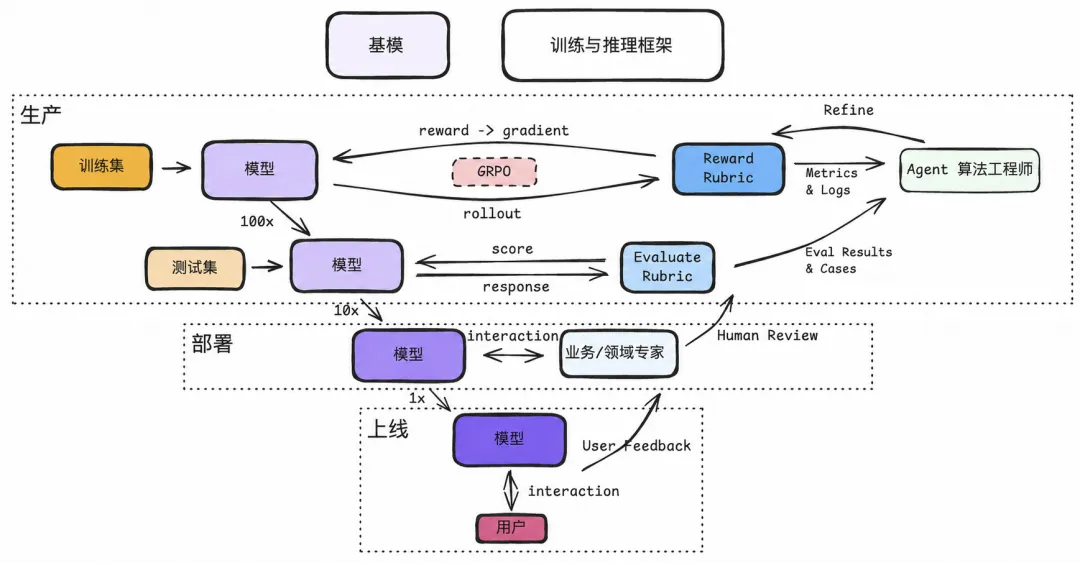
评测贯穿模型研发、部署与上线。
从 Workflow 到 Agent
上一版本的问诊 AI 于 2025 年上线,通过工作流(Workflow)将不同环节的模型串联起来:先由问诊模型与用户对话,达到一定轮次、收集到足够的信息后,再由药品推荐模型接手。
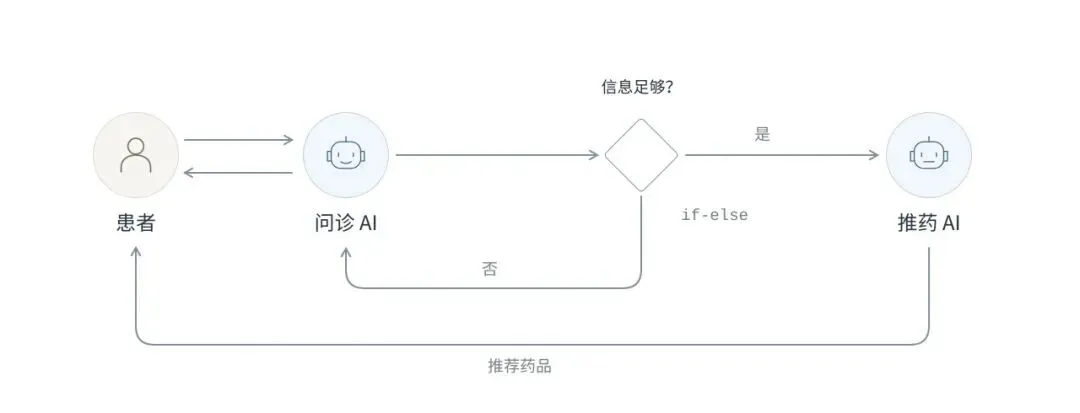
问诊与药品推荐由不同模型承担,通过固定流程衔接。
从固定流程的 Workflow 转向自主判断的 Agent,就是把外部预设的流程判断交给模型,让同一个模型根据对话信息决定下一步动作。
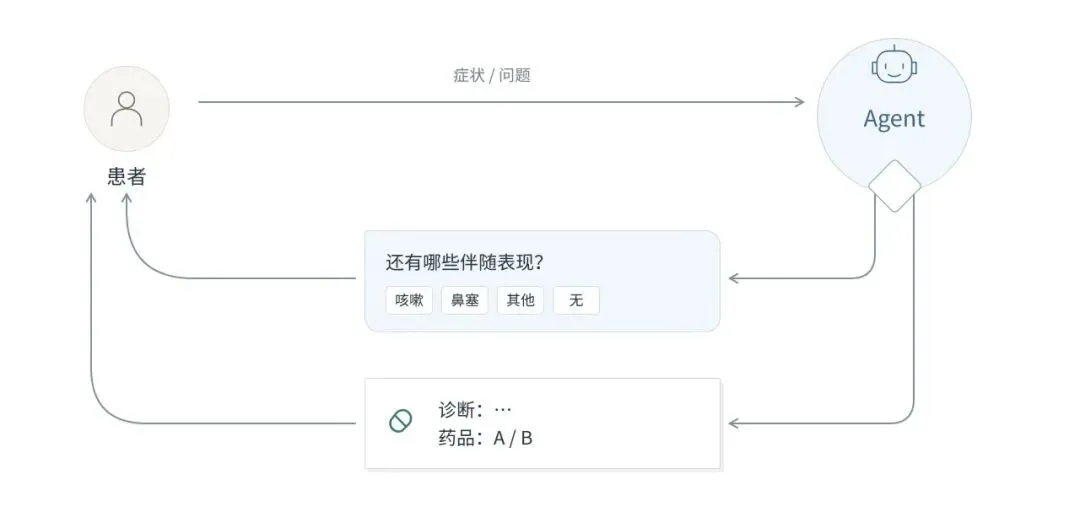
单一模型根据对话信息选择问诊或药品推荐动作。
这种改造的价值,在对话偏离预设流程时尤其明显。比如,推荐药品后,用户又补充或纠正了症状;如果工作流没有预留相应分支,就可能无法妥善处理。换成 Agent 后,问诊和药品推荐由同一个模型承担,就可以根据新信息重新判断,继续追问或调整推荐。
后续如果要扩展能力,Agent 也更容易接入新的行为。例如,希望增加对“危险信号”的应急处理:一旦发现这类信号,就停止常规问诊与药品推荐,建议用户直接就医。为此,工作流可能需要增加判断模型和流程分支;采用 Agent 时,可以构造相应数据,把这种能力“焊”进模型。在接口保持一致的前提下,业务侧能够通过替换模型接入新能力,一些细微调整也可以通过改变提示词来实现目的。
用单步 RL 训练问诊 Agent
训练的基础是大量真实的线上医患购药对话。有了这些记录,能不能直接让模型模仿医生的回复?
此前尝试过用原始真实医生回复做监督微调(SFT),效果并不理想。问题在于,真实医生的表达与问诊 Agent 的预期行为并不总是一致:有时过于口语化,有时会临时补充解释,偏离当前应该继续问询或推荐药品的节点。这些回复有其对话背景,却未必适合作为模型每一步的监督目标。
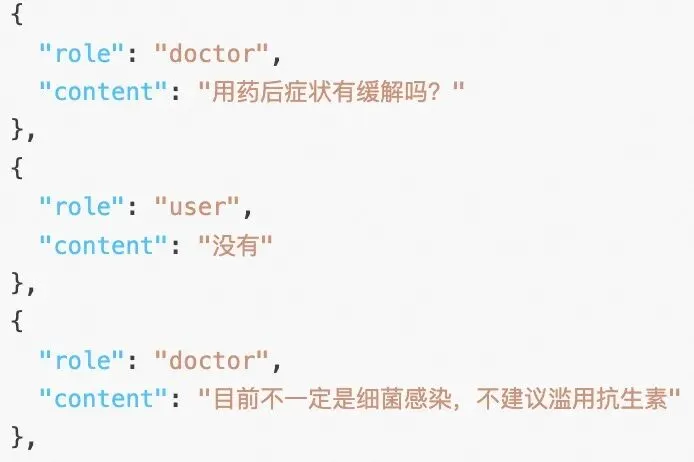
医生最后一条回复主动补充用药解释,与 Agent 此时应采取的下一步动作不一致。
另一条路线是 Agentic RL,让模型在多轮交互中学习完整的问诊策略。但问诊面对的是人,要构造一个稳定、真实的病人模拟器作为训练环境,本身就很复杂;多轮交互也会增加训练和调试成本。
结合已有数据与训练条件,这次采用了单步强化学习(RL):将完整对话切片,以上文作为输入,只对模型接下来的一次回复采样、打分和训练。采用的 GRPO 算法,会针对同一输入生成多条回复,再根据组内的相对得分更新模型。
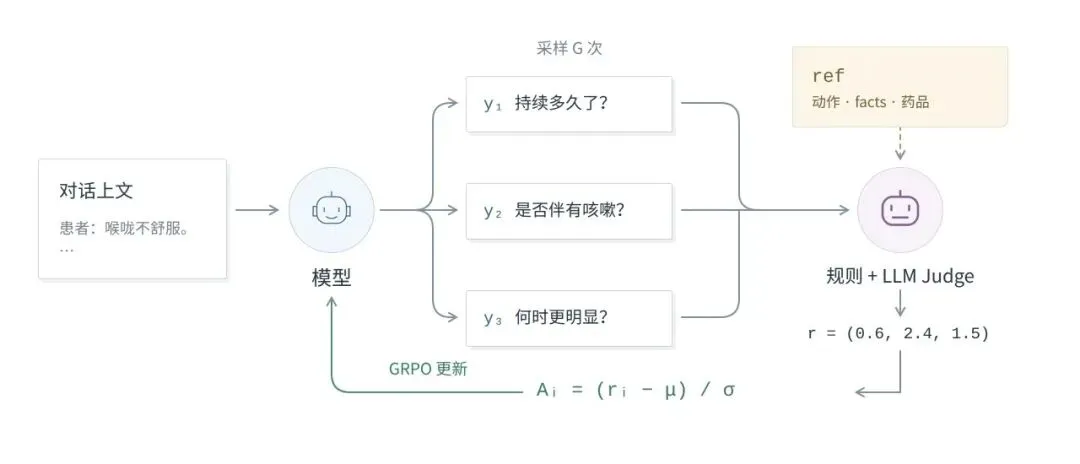
单步 GRPO 对同一输入采样多条回复,根据组内相对得分更新模型。
这条路线不要求每一步都有可以直接模仿的“标准答案”。结合完整对话,仍然可以判断当前这一步对于Agent来说,是适合继续问诊、推荐药品,还是回答用户的问题;医生最终推荐的药品和患者披露的症状,也能帮助建立内容参考。所以接下来的关键是把这些信息转化为可靠的标签和评分准则,判断什么样的回复更好。
构建数据集中的动作与内容标注
数据集相当于模型的“口粮”。训练集的标注决定奖励信号是否准确,评测集的标注则决定分数是否可信,两者都需要忠实于对话,又不能照搬原始医生回复。
数据构建从清理对话开始,将其规范为一问一答的形式,再为每个切片标注期望模型执行的动作:继续问询(query)、推荐药品(recmd),或调用检索工具(search)回答用户的问题。检索又分为健康知识检索(search health)和药品知识检索(search drug),共四类动作。
做动作识别时,将截至当前用户发言的上文、当前医生回复及后续对话一起提供给标注模型,综合判断这个节点应该执行什么动作。
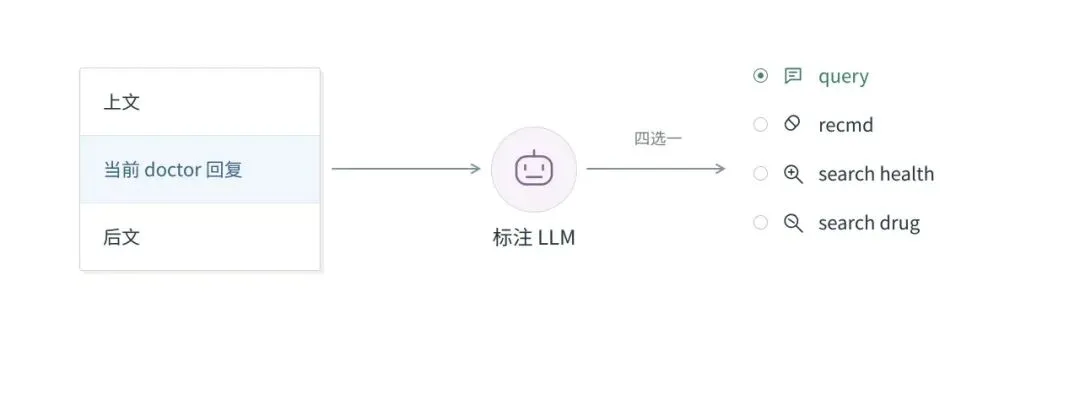
标注模型结合对话上下文与当前医生回复,识别四类动作。
动作识别之外,还要标注具体动作的内容参考。问询动作需要明确下一步应获取哪些患者事实(facts),例如症状表现或用药史;药品推荐动作则需要明确可推荐的药品范围。
患者事实比较简单,由大模型从完整对话中提取,作为问询内容是否“击中”关键要点的评分参考。
药品参考不能只取对话中出现的一两个药品,因为同一种病症可能有多个等效选择。直接让大模型生成等效药列表不够准确,逐条交给专家标注又成本太高,因此采用了折中的办法:由专家维护一份疾病、症状与等效药的映射字典,大模型负责信息提取和名称标准化,就可以通过映射来得到每一条数据的专家标注等效药列表。
具体来说,先从部分对话中提取疾病和症状,整理成标准名称列表,交由专家建立映射;构建数据集时,再提取每条对话的诊断和症状,标准化后查字典,得到对应的等效药列表。
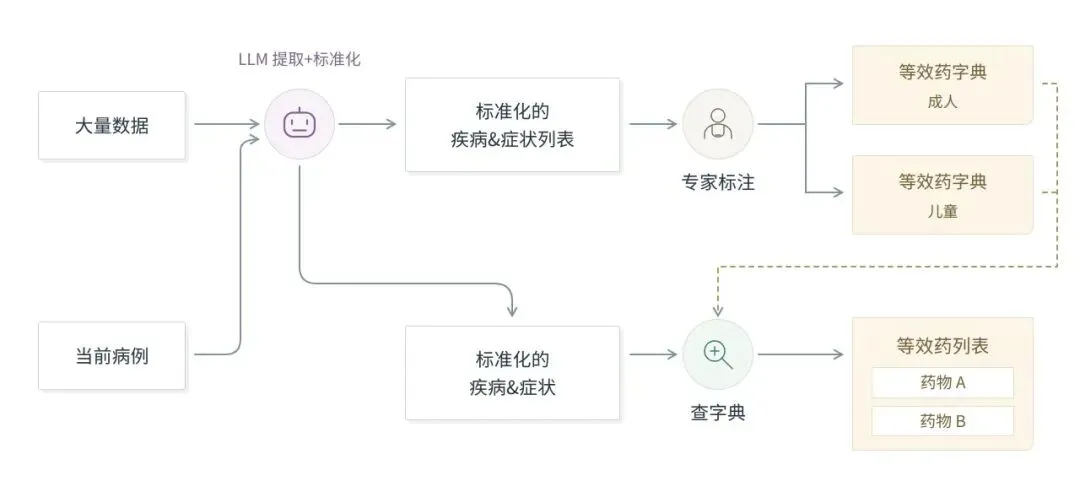
通过标准化疾病与症状,匹配专家标注的等效药列表。
这些工作最终串成了清理、规范化、信息提取、切片与过滤、动作识别和标签构建的流程,用于生成训练集与评测集。
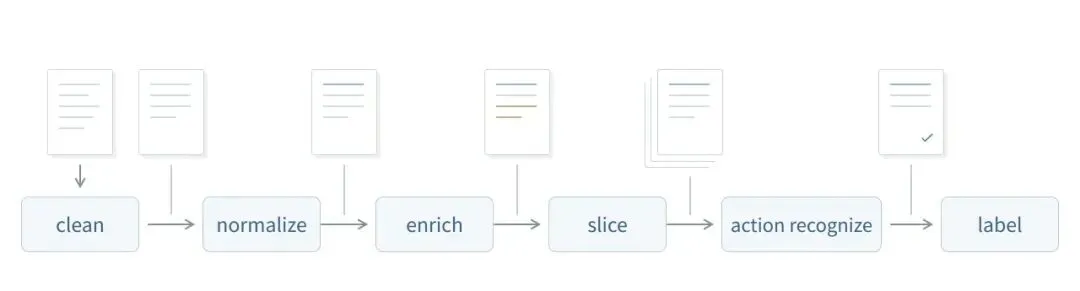
对话经过清理、规范化、信息提取、切片与过滤、动作识别和标签构建。
设计奖励与大模型评分
有了参考标签,就可以据此设计奖励。评分结合规则与大模型评审(LLM Judge):规则负责判断动作和输出格式,大模型依据评分准则(Reward Rubric)评价内容。动作分起到门控作用:动作选错时总奖励为零,动作正确时,再计入格式和内容得分。这套评分机制同时用于训练与评测。
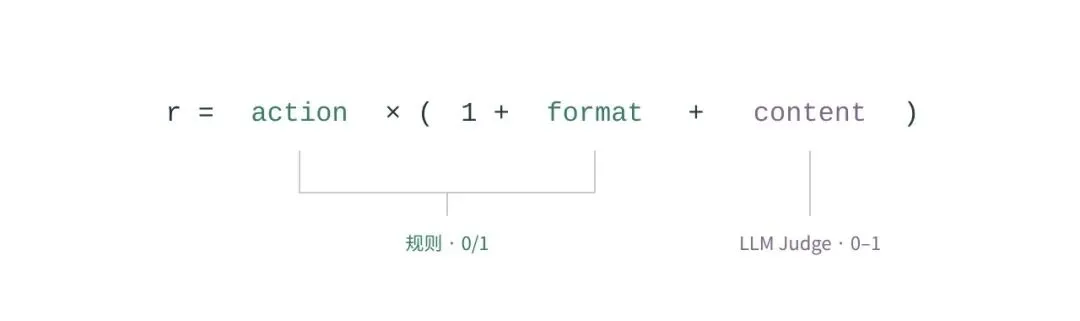
动作与格式由规则评分,回复内容由大模型评审。
评分准则主要关注问询与药品推荐这两个动作:
问询要问得有效,也不能重复。问题与选项需要对应参考的患者事实,帮助获取真实记录中可获得的信息;患者已经在上文明确回答过的内容,则不应再次询问。
药品推荐既要推对药,也要诊断合理。评分不仅检查药品是否落在参考的等效药列表内,也评价诊断,避免训练目标只剩下“推对药”。儿童问诊需要额外考察儿童用药;用户明确要求某种药品或更换推荐时,也要检查模型是否遵循相应指令。
初步训练与评测
训练基模最终选择了 Qwen3.6-27B,主要考虑成本、训练效率与任务表现。早期尝试的 MoE 模型没有表现出明显优势,训练却更困难;后续与 Qwen3.8-27B 的比较,也没有观察到后者在问诊任务上的明显优势。
评测考察六项指标:问询动作准确率与内容分、药品推荐动作准确率与药物分,以及健康知识和药品知识检索准确率,分别观察模型是否选对动作,以及回复内容是否符合参考。
经过 GRPO 训练后,模型的表现看起来很不错:在初版评测集上,问诊 Agent 的六项指标均超过基模和 Qwen3.8-Max。
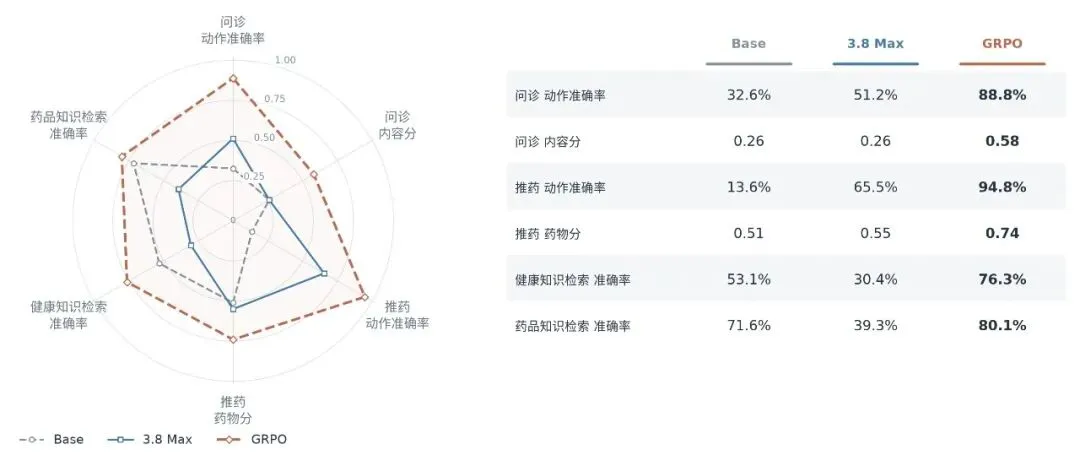
初版评测集上,GRPO 训练后的问诊 Agent 六项指标均高于对照模型。
这个模型真的很好吗?
但部署之后,业务专家的审核给出了不同的反馈。模型在问诊上仍然存在明显问题:往往问了两三轮就结束,问题宽泛、模式单一,还没充分了解用户的具体情况,就开始推荐药品。
为什么分数不错,问诊却没有达到预期?需要回到具体案例,看看“账面”上的提升究竟来自哪里。
仔细检查后,问题集中在六个方面:问询模式重复、推荐药品过于集中、一轮回复同时输出多个动作、检索动作标注错误、表达啰嗦,以及问诊选项质量较差。
其中,问询模式重复最直观。模型反复使用“症状持续多少天了”“有什么其他不适”等固定问题,缺少对具体病情的深入了解。
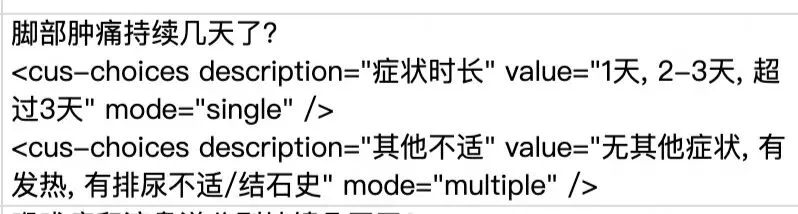
模型使用症状时长与其他不适等常见问询模式。
药品推荐也十分集中,蒲地蓝消炎颗粒等药品频繁出现。
药品推荐示例中出现蒲地蓝消炎颗粒。
有时,模型还会在同一轮回复中先推荐药品,再继续询问用药史,使问诊与推荐的边界变得模糊。
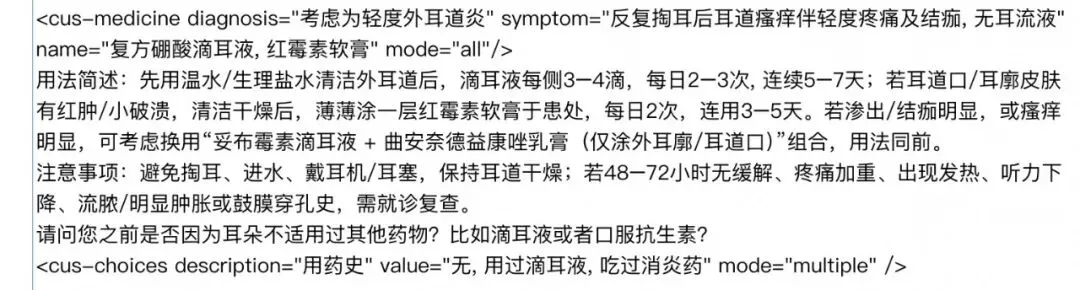
模型在同一轮回复中推荐药品并继续问询。
问题反复出现,便很难只归因于偶然失误。模型是否在利用评分机制的漏洞获取高分,也就是发生了奖励投机(reward hacking)?数据标注本身也有偏差:用户当前没有提问,样本却被标注为检索动作。套话过多、选项与问题不对应,则进一步影响了交互体验。
重新检查与调整数据集
先看重复问询。统计数据中的高频患者事实后发现,它们往往是一些信息量不高的内容。模型只要反复问少数常见问题,就容易命中参考信息、获得奖励,逐渐形成固定模式。
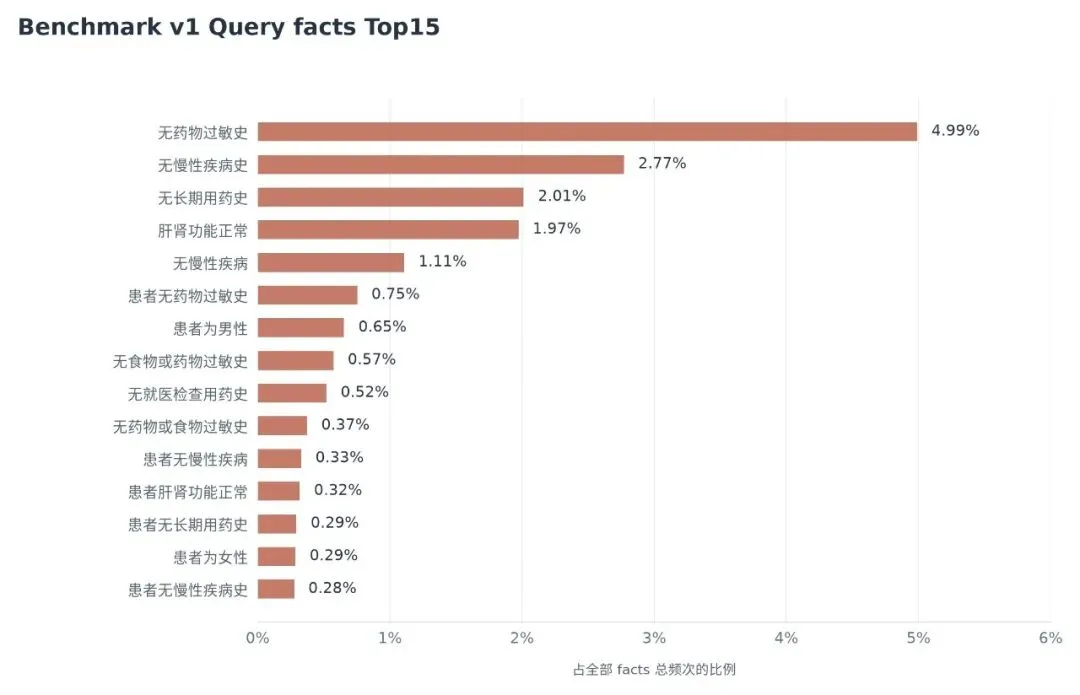
初版数据中的高频患者事实集中在少数常见信息上。
再看这些事实是从哪里提取的,就发现了另一个漏洞。此前提取范围是完整对话,其中包含患者已经在切片上文披露的信息,虽然已经通过评分准则让LLM Judge 来兜底,但仍有判断错漏。
于是,事实提取范围改为当前医生提问及后续对话,减少已知信息进入问询参考的机会。
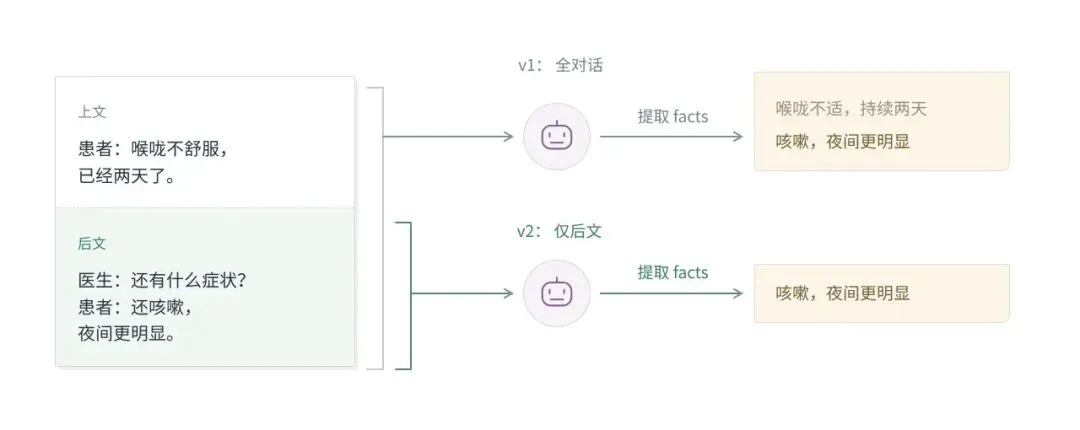
患者事实的提取范围由完整对话改为当前医生提问及后续对话。
同时剔除高频、信息量不足的事实。但剔除之后,又发现不少样本剩下的事实太少,模型难以获得有效的奖励信号,因此还需要过滤参考事实过少的样本。调整后,出现频次最高的十五条事实合计仅占总出现次数的 2.57%,参考信息不再高度集中于少数模式。
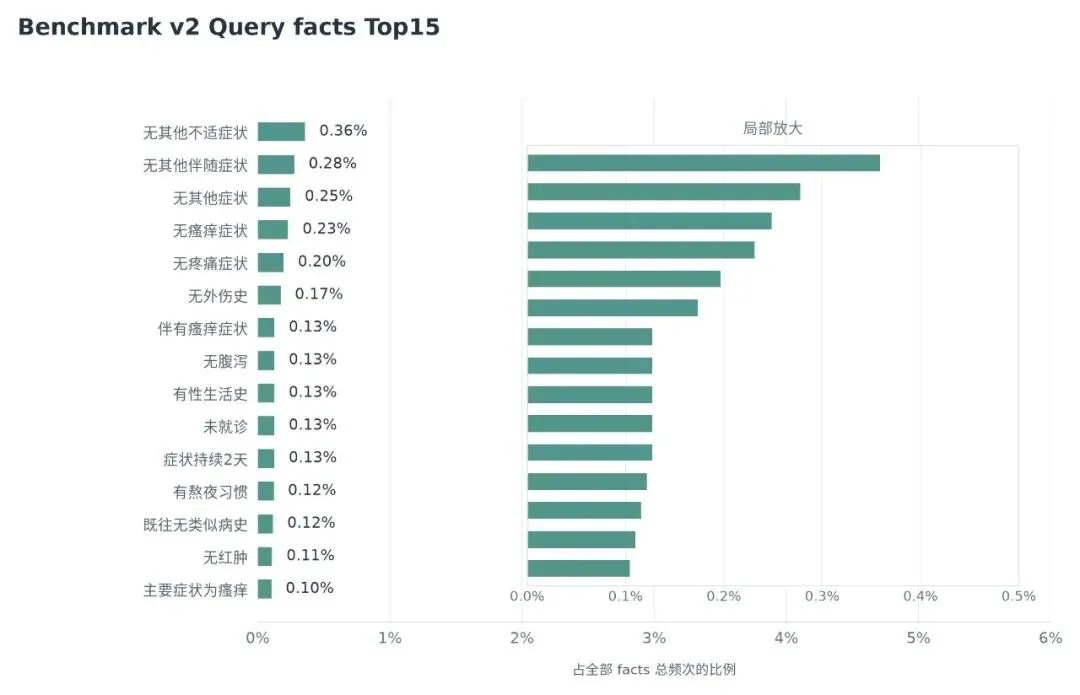
调整后数据中出现频次最高的十五条患者事实。
药品过于集中,也与数据分布有关。原始线上病例大量集中在少数疾病类别上,参考药品随之集中,模型可能仅凭常见疾病来推荐药品就拿到较高分数。调整疾病配比后,药品参考也随之覆盖了更多类别。
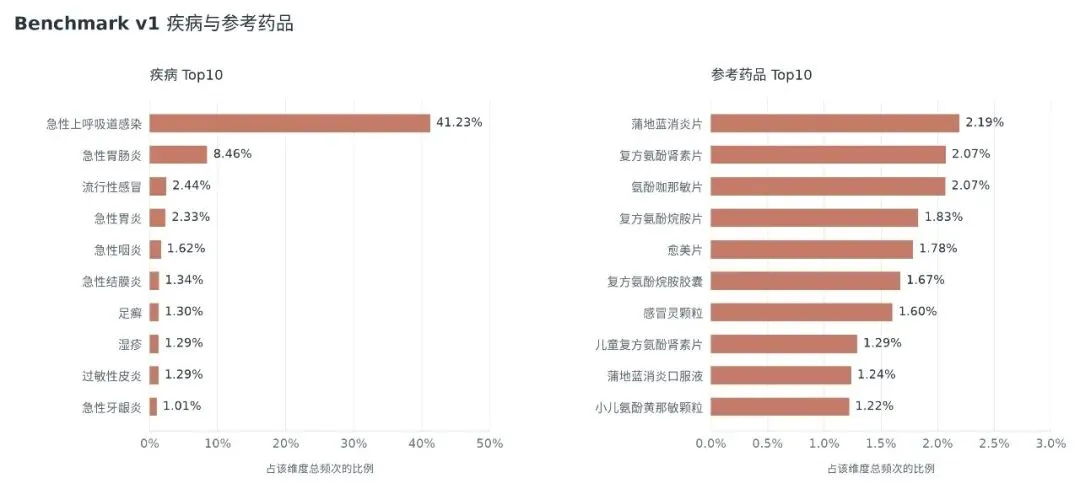
调整前,疾病与参考药品集中于少数类别。
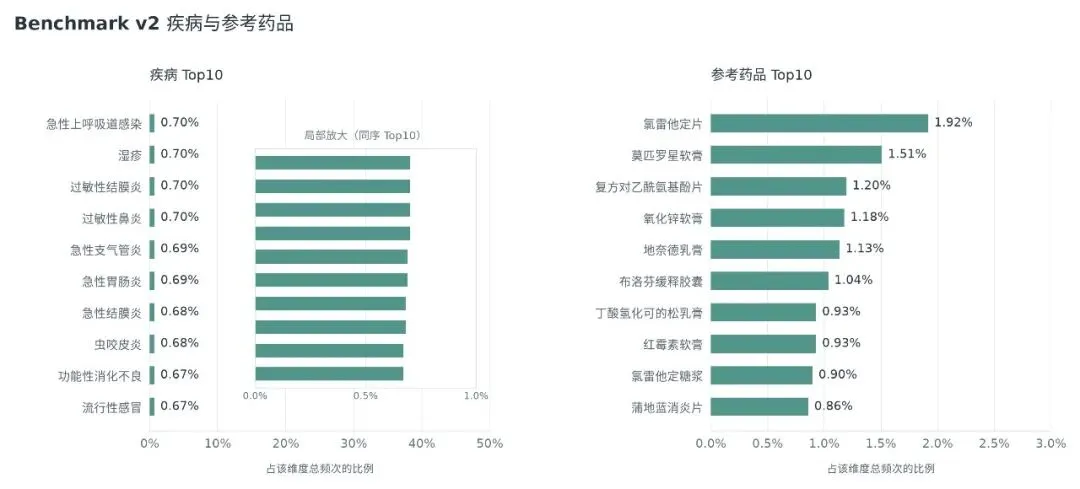
调整后,疾病与参考药品的分布更均衡。
检索动作标注错误,又是怎么产生的?回查发现,当前医生回复对识别药品推荐节点有帮助,但回复质量参差不齐,额外提供的内容也容易干扰动作判断。标注要回答的,毕竟是当前应该做什么。
动作识别因此重新调整:先用规则根据真实医生回复是否在推荐药品,来筛选出药品推荐样本,其余样本只依据切片上文判断,不再提供当前医生回复和后续对话。
检索动作也有了更严格的条件:只有上一句用户提出了健康或药品问题,而且当前上下文足以回答,才标注为检索。
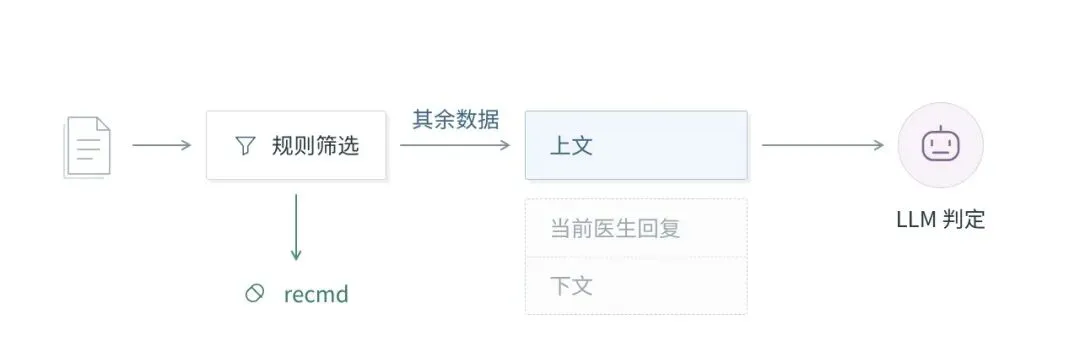
先用规则筛选药品推荐样本,再仅依据上文识别其余动作。
还有一个直接影响体验的问题:为什么模型问了两三轮,就急着推荐药品?检查样本的轮次分布后发现,原始药品推荐数据主要集中在第 3 至第 5 轮,较早推荐的倾向已经体现在数据里。
为增加充分问诊的训练样本,药品推荐数据的轮次分布调整为更多集中在第 7 轮附近,同时过滤前两轮的检索样本,让问诊前期更侧重收集信息。
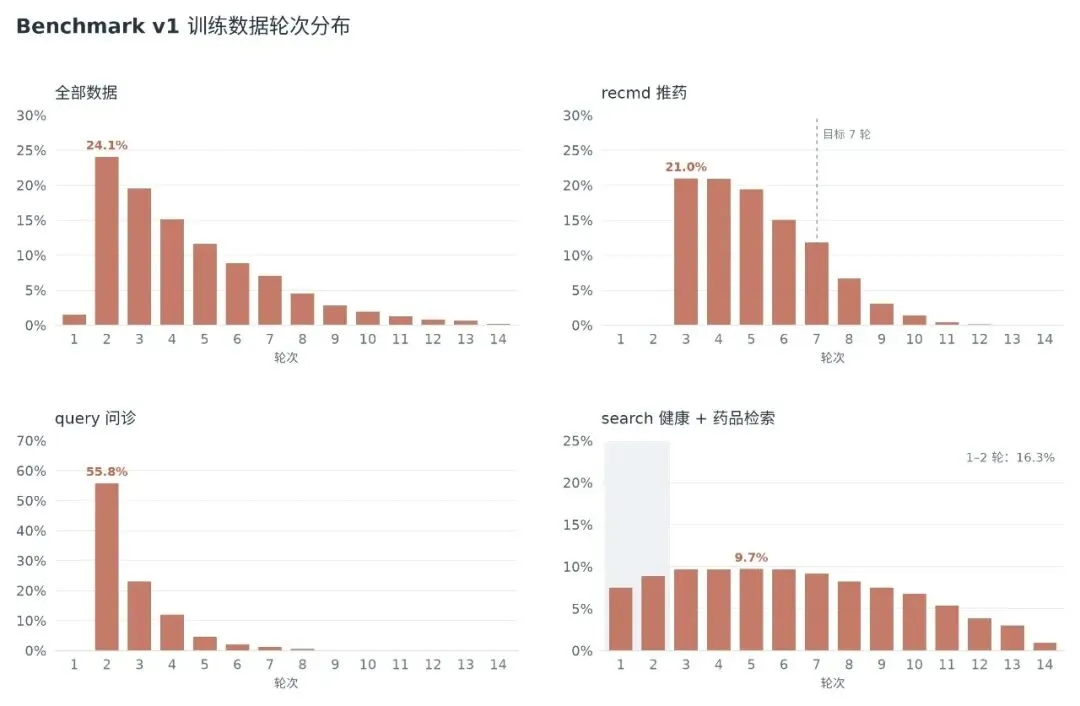
调整前,药品推荐样本集中在较早的对话轮次。
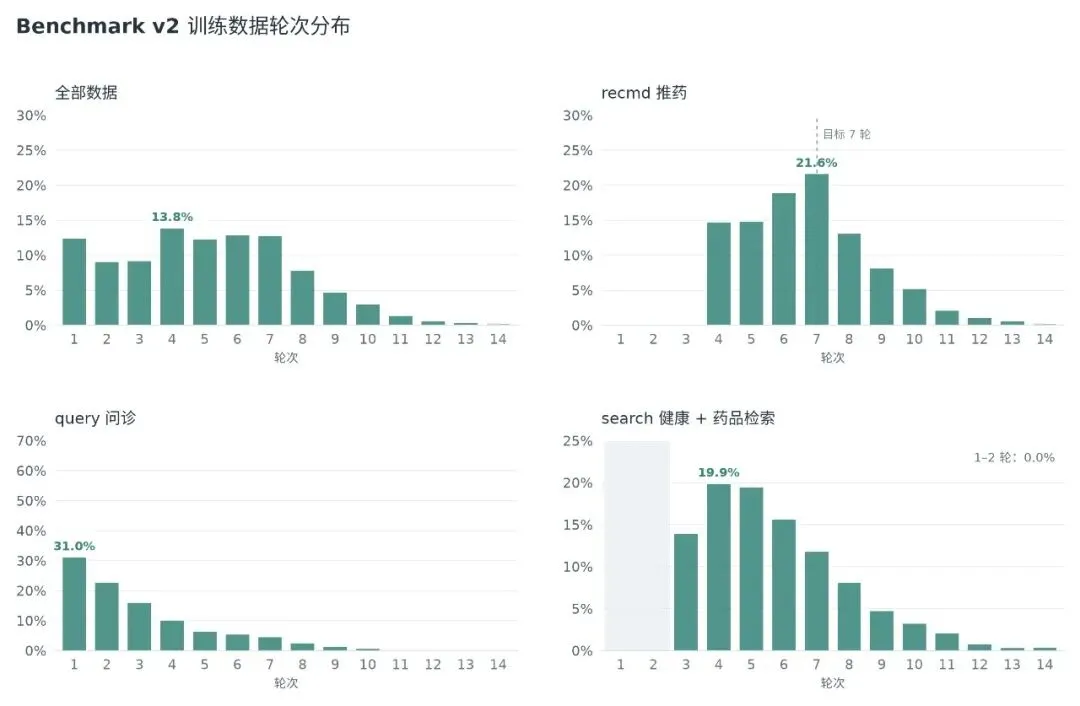
调整后,药品推荐样本更多集中在较后的对话轮次。
改进评分规则与训练机制
只调整数据还不够。模型在同一轮回复里既问诊又推荐药品,说明动作与格式的约束不够严格;选项质量差、表达啰嗦,也说明评分还没有充分体现交互要求。
动作混用首先通过硬规则约束:一次回复识别出多个动作,直接判零分。问询的输出形式也明确下来,每次恰好提出两个问题,每个问题提供 4 至 6 个选项,作为这一业务场景中的交互规范。
满足数量要求之后,还要看选项是否可用。大模型评分需要检查选项与问题是否对应、是否覆盖常见回答,以及是否提供“无”“未测”“不确定”等必要的兜底项,避免用户找不到合适的回答。
语言表达则通过得分上限约束。带有“根据您的情况……”等套话开场白,或使用不必要的编号列表时,即使内容命中了参考,也不能拿到高分。这样,评分才会同时关注回复内容和用户实际看到的表达。
训练机制也做了调整,加入提示机制(Hint),为 GRPO 提供更明显的组内相对学习信号。采样时,随机为组内一半回复提供参考信息:问询样本提示患者事实,药品推荐样本提示诊断与等效药;另一半不加提示。有提示与无提示的采样共同参与评分,以拉开组内回复的奖励差距。更新模型时,再移除输入中的提示,使用原始上文与采样回复训练。
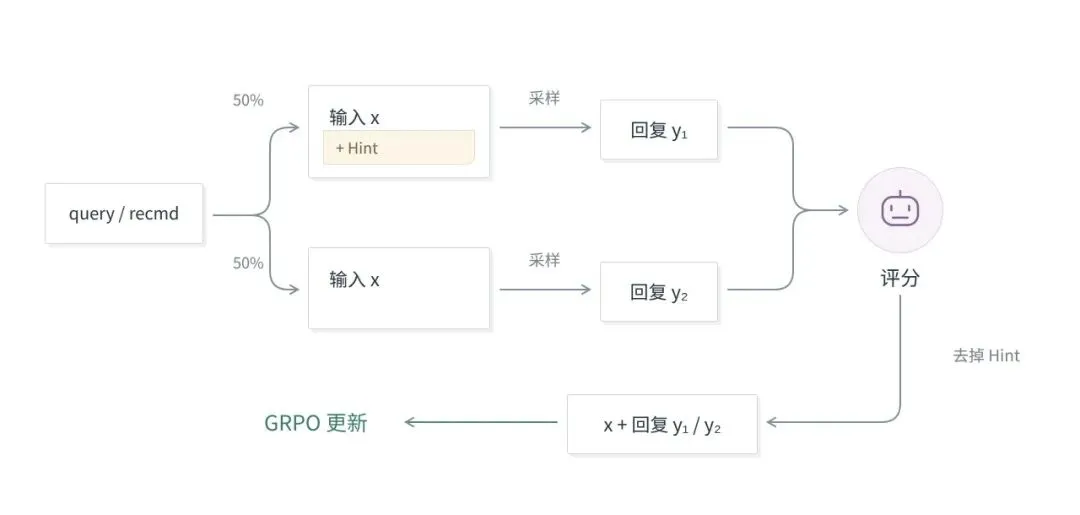
采样时为组内一半回复加入提示,训练时移除提示。
再次评测与输出对比
完成这些调整后,重新构建评测集并训练模型。在调整后的评测集上,加入提示机制的问诊 Agent 六项指标仍优于基模和 Qwen3.8-Max。
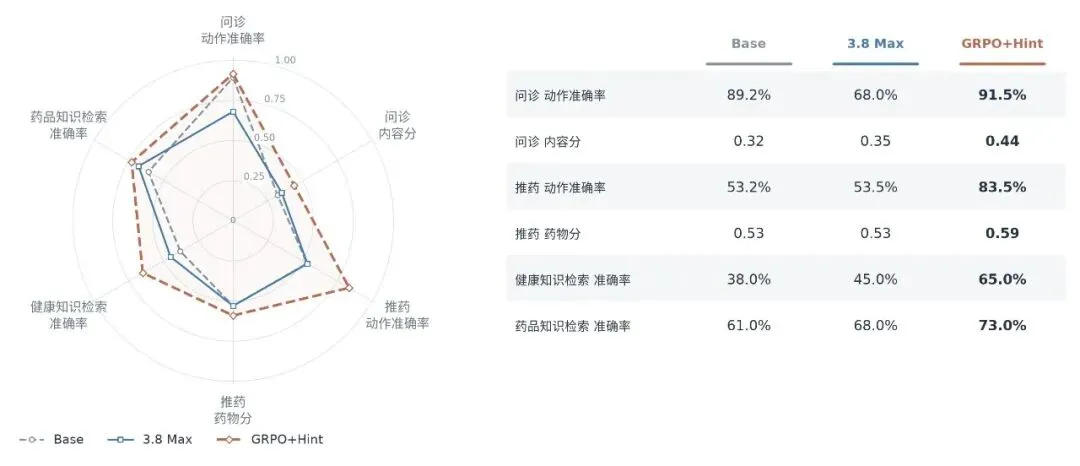
调整后的评测集上,问诊 Agent 的六项指标仍优于对照模型。
这次的变化也体现在具体回复中。问诊能够持续更多轮次,问题更有针对性,选项与问题的对应也更加清晰。例如,面对头皮瘙痒伴头屑,优化后的回复会进一步了解症状表现与头皮出油情况。
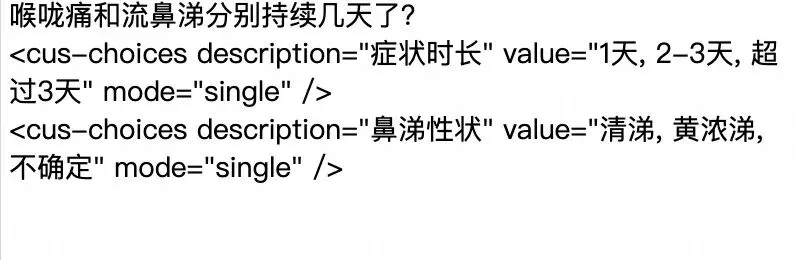
优化前的问诊回复。
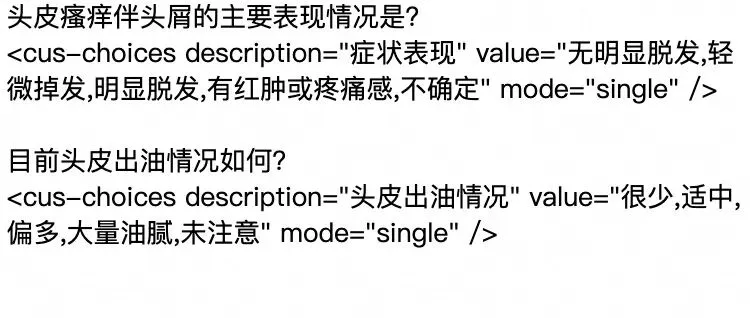
优化后的问诊回复更关注具体症状与头皮出油情况。
药品推荐的覆盖面也有所扩大,整体表达更简洁。这些对话中的变化,与业务审核关注的问题有了更直接的对应。
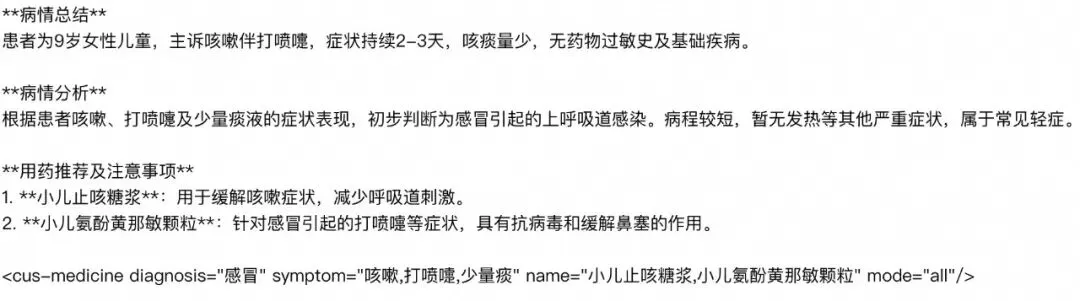
优化前的药品推荐回复。
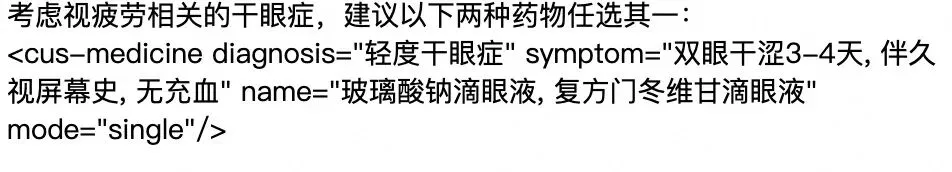
优化后的药品推荐回复。
为什么 SFT 又有效了?
单步 RL 的训练日志中,保存了大量模型采样回复(rollout)。如果筛选其中的高分回复,再用来做 SFT,效果会怎样?这相当于一种自蒸馏训练。
结果意外地好。此前效果不佳的 SFT,这次又支棱起来了:在同一评测集上,药品推荐与检索指标甚至超过了 GRPO 模型。不过,问询动作准确率和内容分略有回落,提升并没有覆盖所有能力。
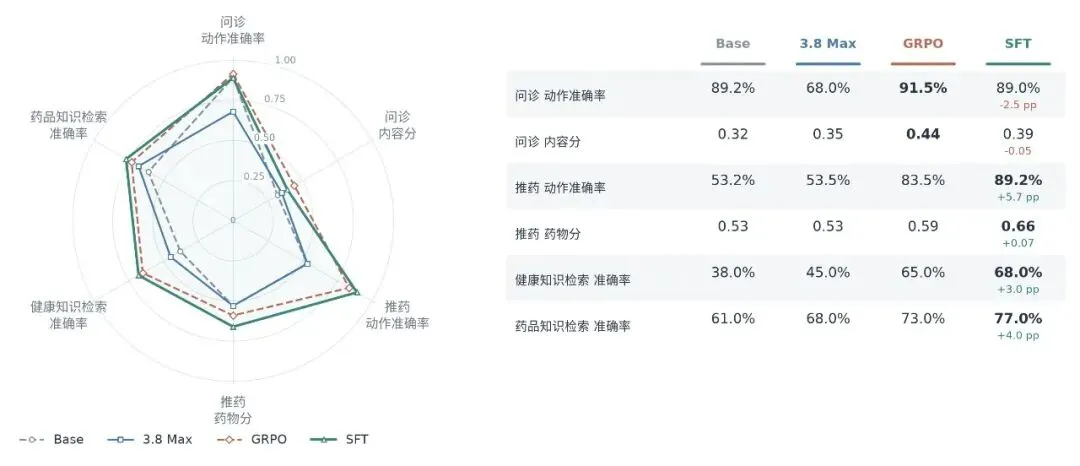
高分采样回复用于 SFT 后,药品推荐与检索指标进一步提升。
更重要的是训练成本明显降低。SFT 使用 8 张 H20,训练约 5 个多小时;此前 GRPO 需要使用 32 张 H20,训练约 8 个小时。
随后继续优化监督数据:用大模型润色高分回复,再让 GRPO 模型对未参与此前训练的新对话采样,扩大数据量。药品推荐能力进一步提升,但其他指标改善有限,问询内容分也没有同步提高。
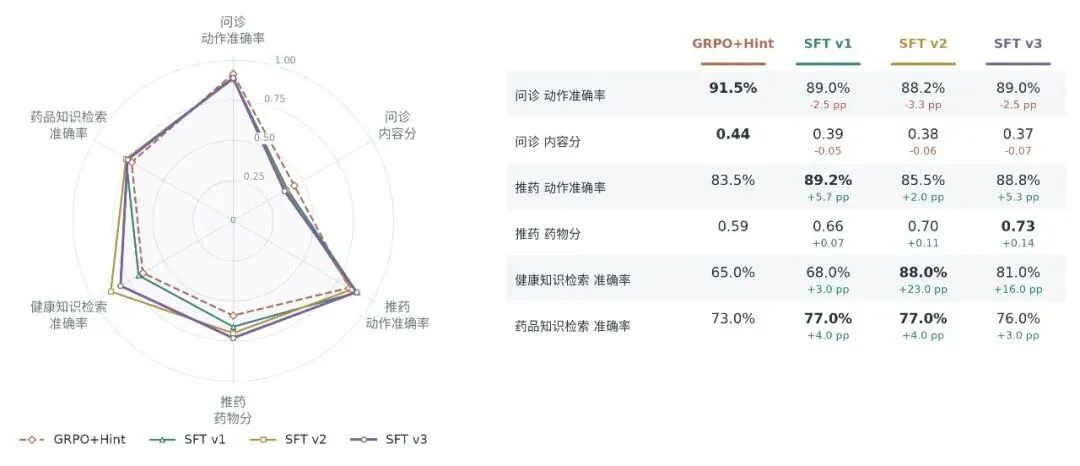
筛选、润色与扩充监督数据后,SFT 模型的药品推荐能力继续提升。
为什么这次 SFT 能成功?关键在于监督目标变合理了。最初直接模仿原始医生回复,数据中的错位和表达问题也会被学进去;经过动作重标、参考信息调整和评分改进,再从多次采样中筛选高分回复,也就是拒绝采样(rejection sampling),得到的监督数据更接近期望行为。
探索单步 RL 的过程,也在一步步提高数据质量。数据可靠之后,SFT 重新变得可行,成为更有性价比的选择。
对 Agentic RL 的尝试与再思考
SFT 的效果得到验证后,也有必要回头看看 Agentic RL。单步训练评价的是下一次回复,而 Agentic RL 让模型与环境多轮交互,再为完整轨迹打分,因而有机会学习跨越多个回合的策略。
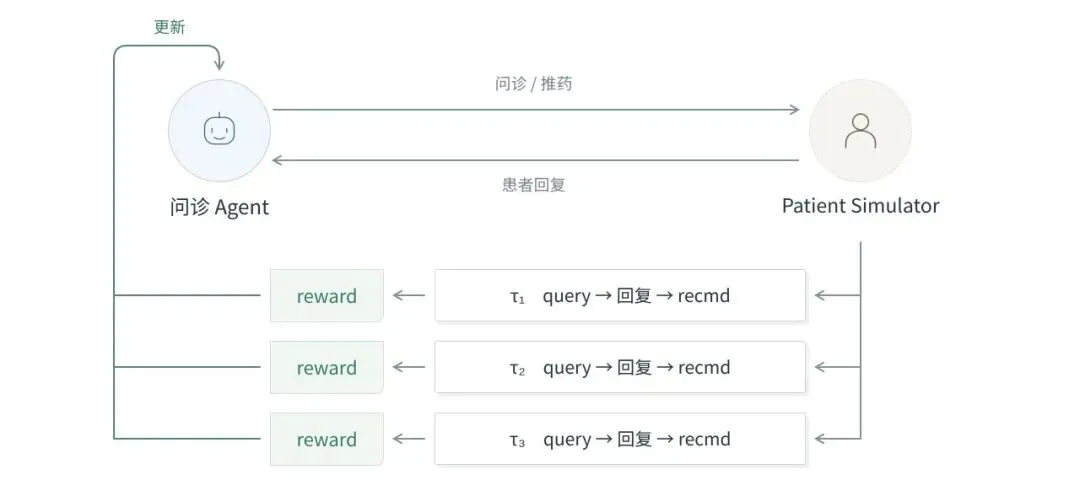
Agentic RL 通过病人模拟器开展多轮交互训练。
初步实验将问询过程质量与最终药品推荐结果共同纳入奖励:过程部分评价问题的格式与内容,结果部分依据参考诊断和等效药列表评分,再将整段交互的奖励用于更新各步回复。这样既关注最终推荐,也保留对问诊过程的约束。
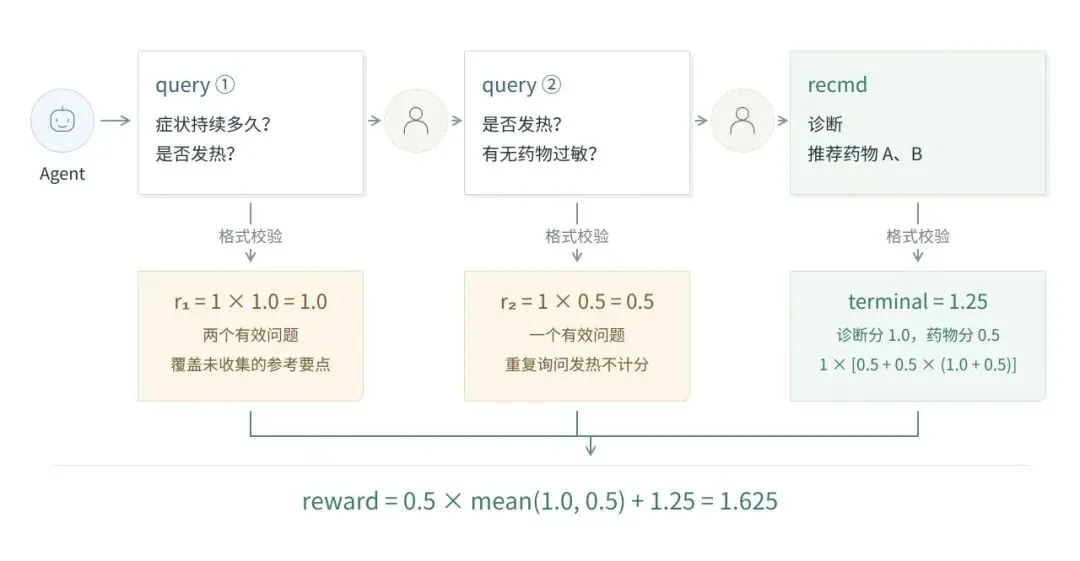
轨迹奖励结合问询过程得分与最终药品推荐得分。
实验使用约 5,000 条对话训练 Qwen3.5-4B,并在同一评测集上与其基模比较。问询和药品推荐的动作准确率有所提升,药物分也有改善,但提升幅度相较于SFT要小很多。
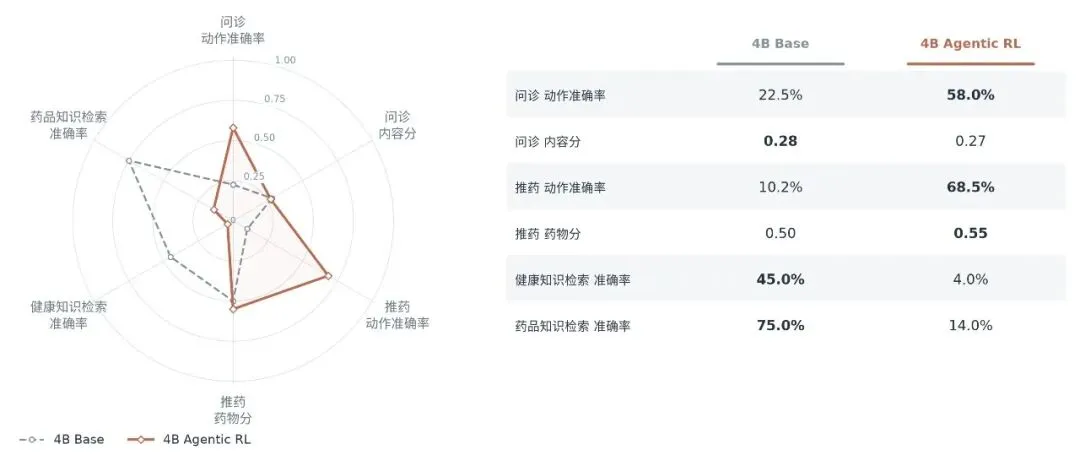
Agentic RL 改善了部分问诊指标,但提升幅度娇小。
Agentic RL 在编程场景中很有吸引力。能否修复错误、通过测试,往往提供了明确的成功信号,而达成目标的路径很多,未必有现成轨迹可以模仿;计算机环境也更容易执行和验证模型的动作。
问诊的条件有所不同。交互对象是人,患者模拟器难以充分反映真实患者的回应;已有大量医患对话可以提供参考轨迹,而在限定的购药场景中,动作空间、疾病范围和提问方式也相对集中。
再考虑训练效率,单步 RL 与 SFT 目前仍是这个业务场景中的优先选择。Agentic RL 是否值得进一步投入,关键在于能否构建一个可信的交互环境:让模拟病人拥有足够的病例信息,合理地披露症状与回应提问,真正支撑多轮策略学习,并带来超出已有训练方式的收益。
上线后的持续学习
上线后的持续学习也值得探索。回流的失败案例可以用于更新数据配比、标注质量、评分准则和推理提示词;进一步,还可以让 AI 参与归因分析并提出改进方案,由算法工程师监督与审批。这是接下来递归自我改进(Recursive Self-Improvement,RSI)的一种探索方向。
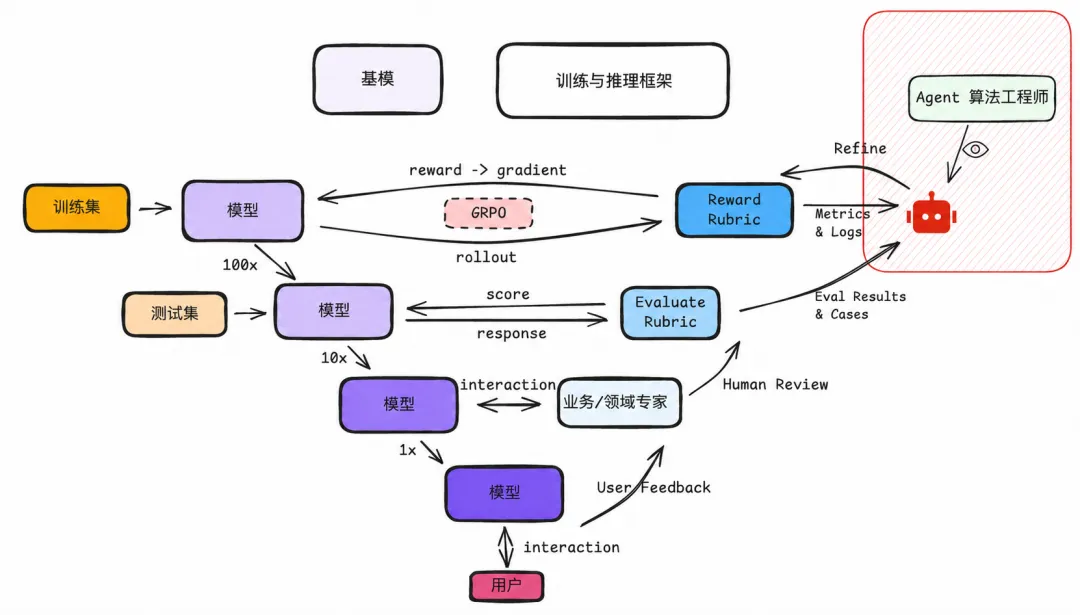
AI 提出优化方案,算法工程师负责监督与审批。
反思与收获
这次实践中,评测的价值不仅是比较分数,更是发现训练目标与真实体验之间的偏差。一个模型能否落地,需要同时经得起指标和具体对话的检验。
SFT 重新变得有效,也说明算法选择离不开数据质量。动作标注、参考信息和评分准则逐步完善后,高分回复才成为更可靠的监督数据,训练方法的价值也随之发生了变化。
