你的 agent 在自家脚本上跑出 85 分,换到客户那边同样的模型同样的题,分数掉了十几个点——你敢说是模型变差了,还是只是换了套评测脚本?
厂商系统卡里写的「安全评测通过」,用的到底是他自己的 harness 还是你能复现的那一套?
团队花三周手搓了一个评测脚本,下次换模型又要改一遍,分数还经不起别人复查——这笔工程账到底值不值?
无
读完你能做到:用 Inspect 在三天内搭起一条可复用、可审计、跨模型可比的 agent 评测流水线,从写第一个 Task 到在 Web 界面里复盘每一次工具调用。
四要素卡
| |
|---|
| 算法 / 评测团队要为一个会调工具、跑多轮、需要隔离执行代码的 agent 建立可复现评测;真实采用方是 Anthropic、OpenAI、Google DeepMind、Meta、美国 AISI、METR、Apollo Research |
| 团队能用 Python;需要 Docker 跑沙箱(执行不可信代码);模型走 OpenAI 兼容或本地 vLLM 端点;把可复现与审计看得比零代码体验更重 |
| 把一次评测拆成 Dataset / Solver / Model / Scorer 四个可复用 Python 模块,用 docker 沙箱隔离工具执行,一次运行产出一个含分数、轨迹、成本的 .eval 日志 |
| 前沿实验室与多家 AISI 已弃自研 harness 转用;METR 用其跑 228 任务时长评测并进入《国际 AI 安全报告 2026》;代价是无 GPU、靠 API 计费,完整 agentic 基准单次数百到数千美元 |
一、这项技术要解决什么
agent 评测长期卡在两件事上。一是不可复现:每家实验室手搓一套 harness,题不一样、判分不一样、采样不一样,出来的分数根本没法放一起比。二是不可审计:评测过程是个黑盒,分数掉了你查不出是模型退步、题太难,还是脚本悄悄改了判分口径。
更现实的是重复造轮子。Apollo Research 公开讲过,他们自研的评测框架里那些「安全沙箱、可解释性工具」之类的能力,自己从头搭得花数月;试了三个月 Inspect 之后直接把自研框架弃了。另一边,纯单轮正确性的榜单(lm-eval-harness 那类)覆盖不了 agent 最要命的多轮决策和工具调用,而 LLM-judge 又容易把任务难度本身混进分数。
Inspect 是英国 AI 安全研究院(UK AISI)2024 年开源(MIT 许可,当前 0.3.278)的评测框架,到 2026 年已经成了前沿实验室事实上的标准。它的核心主张很朴素:把「评什么 / 怎么问 / 问谁 / 怎么判」拆成四个最小原语,每个都是普通 Python 模块,能像 NumPy 函数一样被发布和复用;一次运行只产出一个日志,分数、轨迹、成本全在里面。
读者画像是算法工程师、评测负责人和应用开发者。采用方不用猜——Anthropic 的 Claude 4.5 系统卡、OpenAI 的安全报告、Google DeepMind 的 Gemini 能力评测,跑的都是同一套 Inspect Python;英国 AISI 自己拿它做前沿模型部署前的测试。
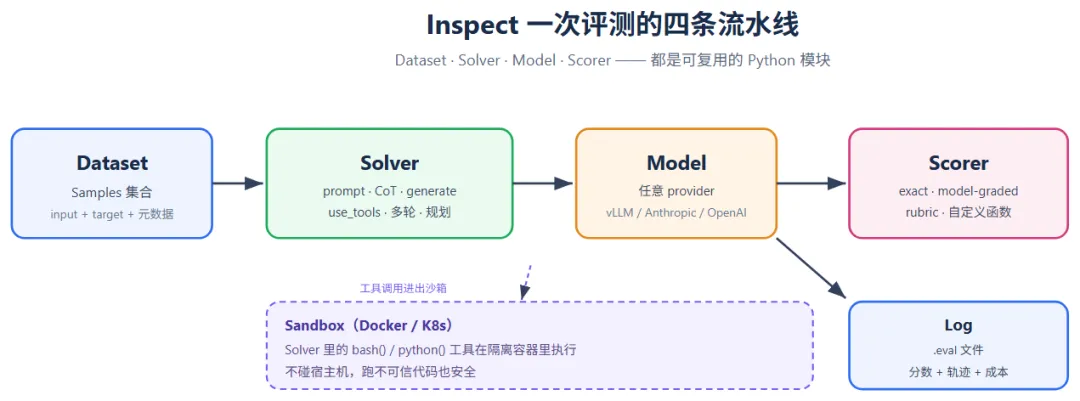
四个原语在代码里长这样,串起来就是一条流水线:Dataset 喂样本,Solver 决定怎么问并调用工具,Model 是被测对象,Scorer 判分,工具执行全程关在 docker 沙箱里,最后落成一个 .eval 日志。
图是横着排的四块加两块辅助:Dataset 装的是 input + target + 元数据;Solver 管 prompt、思维链、generate、use_tools、多轮和规划;Model 是任意一个 provider,换模型只改一处;Scorer 是 exact / model-graded / rubric / 自定义函数。虚线框是 Sandbox,Solver 里的 bash() 和 python() 工具就在这里面跑,碰不到宿主机;右边 Log 把分数、轨迹和成本一并收进 .eval 文件。
二、实现路径与步骤(照着走完)
步骤 1 · 环境与启动
目标:装好 inspect-ai 并保证沙箱能跑。
pip install -U inspect-aidocker --version # 需要 Docker Desktop 在运行python -c "import inspect_ai; print(inspect_ai.__version__)"# 0.3.278
验证:版本打印成功,且 docker run hello-world 能跑通。这一步零 GPU,安装耗时 1–2 分钟。
步骤 2 · 最小可运行 agentic 评测
目标:一个会调 python 工具、在沙箱里算数、被精确打分的 agent 评测。
把下面内容存成 inspect_agent_eval.py:
from inspect_ai import Task, taskfrom inspect_ai.dataset import Samplefrom inspect_ai.scorer importmatchfrom inspect_ai.solver import generate, use_toolsfrom inspect_ai.tool import bash, python@taskdefdata_agent_eval():return Task( dataset=[ Sample(input=("请用 python 工具算出 1 到 10 的和(即 55),""把思考过程写在工具调用里,最后用文字说出结果 55。" ), target="55", ) ], solver=[use_tools([bash(), python()]), generate()], scorer=match(numeric=True), sandbox="docker", )
三个关键参数:use_tools([bash(), python()]) 决定 agent 能调哪些工具;sandbox="docker" 把工具执行关进容器;match(numeric=True) 从最终输出里抽数字判分。target="55" 是确定性答案,没有 LLM 当裁判,判分零漂移。
步骤 3 · 跑起来并复盘轨迹
inspect eval inspect_agent_eval.py --model openai/gpt-4o-miniinspect view # 浏览器打开,逐任务看工具调用顺序与模型回读
验证:终端打印每题分数和 token 成本;在 view 里能看到 agent 调了 python、返回了 55。开发期用 --limit 5 切片,几分到几美元就能跑通。
步骤 4 · 跨模型只改一个参数
inspect eval inspect_agent_eval.py --model anthropic/claude-...inspect eval inspect_agent_eval.py --model vllm/local-qwen-72b
只有 --model 在变,harness 一字未动——这正是分数可比的前提。provider 抽象把 Anthropic、OpenAI、vLLM、Ollama、Bedrock 全收进同一个接口。
步骤 5 · 上量到真实 agentic 基准
直接复用 Inspect Evals 仓库里 200+ 个预置基准(coding / agentic / reasoning / 多模态),或把自己的业务任务写成 Sample 加一个自定义 Scorer(读沙箱里的文件、查数据库、比对 API 返回都行)。建议先用 --limit 50 冒烟,再全量;多轮或长任务加 --epochs K 估方差。
关键超参表
| | | |
|---|
--model | | | |
--limit N | | | |
--epochs K | | | |
sandbox | | | |
scorer | | | 精确匹配零成本;model-graded 贵,只在自由文本用 |
--max-connections | | | |
常见报错与规避
sandbox="docker" 直接报错:Docker Desktop 没起,先 docker run hello-world 验证。- 429 / 限流:调小
--max-connections,调大 --max-retries,或在 model_args 里设 rate_limit。 - model-graded scorer 账单爆炸:自由文本才用 LLM 判分,结构化输出一律用 exact / match。
- Windows 下 bash 工具路径错:工具里用正斜杠或
pathlib,别写死 C:\。 - provider 鉴权失败:API key 放进仓库已有的
.env。
跑起来要花多少
最小闭环不需要 GPU,API 费几分到几美元(看模型单价和题量)。完整 agentic 基准可以参考 Terminal-Bench 实测:单次 5 trials 跑分 2,059(2.1 版),4.0 版带 8 小时超时更贵。时间上最小样例不到 1 分钟,全量基准数小时到一天。
三、为什么这样做有效
四个原语本质是纯函数式组合。Dataset 决定评什么(确定性输入加目标),Solver 决定怎么问(prompt / 工具 / 多轮),Model 是被测对象,Scorer 决定怎么判。它们之间没有隐藏状态,组合逻辑就是 Python 本身——所以同一份代码、同一批输入、同一个模型版本,跑出来就是同一组分数是可复现的。
那方差从哪来?唯一随机源是模型采样(temperature 大于 0)和 API 自身的非确定性。消除方式就是 --epochs K 加重采样,再报 mean 加减置信区间。这一步把「能力」和「脚本差异」彻底拆开:harness 不变时,分数变化只能来自模型。
模型无关性的工程意义比它看上去更大。provider 抽象让同一份 eval 一键换 --model,使各家分数站在同一把尺下比——这也解释了为什么厂商自己披露的分数和第三方跑出来的常常差出十几个点:差的往往不是模型,是 effort(采样次数、是否多轮、是否用了私有 harness)。
docker 沙箱是一条安全边界。agentic 评测要执行模型生成的代码,一旦不隔离,一个恶意 payload 就能打穿宿主机;关进容器后,bash / python 工具随便跑都不怕。
判分上有个务实的取舍:exact / match 零成本且客观,但只覆盖结构化输出;model-graded 能判自由文本,却把任务难度混进分数还加成本。业内的组合是「二值完成度 + 抽样轨迹 + 连续效率指标」,自由文本才上 LLM judge,重大变更才上人工回归闸门。单独看任何一根轴都会骗你。
for sample in dataset: state = solver.init(sample.input) # prompt + tools + 多轮 while not done: action = model(state) # 任意 provider state = sandbox.exec(action) # docker 隔离执行 score = scorer(state.output, sample.target)log.append(score, trajectory, cost) # 一次运行一个 .eval
四、效果验证与适用边界
| | | | | |
|---|
| | | | Anthropic / OpenAI / DeepMind / Meta / 美国 AISI / METR / Apollo 全采用 | |
| | | | | |
| | | | 228 任务跨前沿模型,入选《国际 AI 安全报告 2026》 | |
| | | | | |
| | | | | |
业务收益单列:第一,省掉从零手搓 harness 的数周乃至数月工程,Apollo 那句「这些能力我们自己得花数月才能建出来」就是账本。第二,跨模型可比——同一 eval 改 --model 即比,消除 harness 差异导致的不可比。第三,审计可追溯,一次运行一个 .eval,prompt / response / score / trajectory / 成本全在,满足合规和回归闸门。第四,有实测背书,METR 拿它跑 228 任务时长评测进了官方报告,英国 AISI 拿它做部署前测试。
决策清单:
- 成立条件:团队能用 Python 写 eval;要评的是多轮 / 工具 / 沙箱型 agent;把可复现和审计看得重。
- 退化或失效:纯单轮正确性榜单用 lm-eval-harness 更轻;不愿写代码选 Promptfoo 或 OpenAI Evals;无 Docker 的受限 CI 跑不了沙箱。
- 换业务 / 任务要重验:scorer 是否对齐你真实判分口径;数据集是否代表真实分布;model-graded 的 judge 跟你的 rubric 是否一致。
- 已知局限:Python-first 有学习曲线;Docker 依赖;model-graded 引入成本与潜在偏见;社区 eval 需逐条验证(pragma 提示 community evals need per-eval validation)。
- 合规风险:评测样本含敏感业务数据时,注意 sandbox 隔离与日志脱敏。
复现清单
① 上手三步走:pip install -U inspect-ai 加启动 Docker → 写最小 Task(use_tools + generate + match + sandbox="docker")→ inspect eval --model <provider/model> 后 inspect view 复盘轨迹。
② 踩坑记录:Docker 没起导致 sandbox 失败;429 限流调小 --max-connections;model-graded 成本高只在自由文本用;Windows 路径用正斜杠。
③ 实用评分卡:可复现性 ★★★★★(同代码同分)、上手成本 ★★★☆(Python 门槛)、算力门槛 ★★(无 GPU 靠 API)、效果可信度 ★★★★(前沿实验室背书加日志可审)、许可友好度 ★★★★★(MIT)。
④ 关键链接:github.com/UKGovernmentBEIS/inspect_ai、inspect.ai-safety-institute.org.uk、Inspect Evals 仓库、AISI Engineering Playbook(2026 新发)。
今日反问
既然同一份 eval 只改一个 --model 就能跨厂商跑,为什么厂商自己披露的分数和第三方跑出来的还常常会差出十几个点?