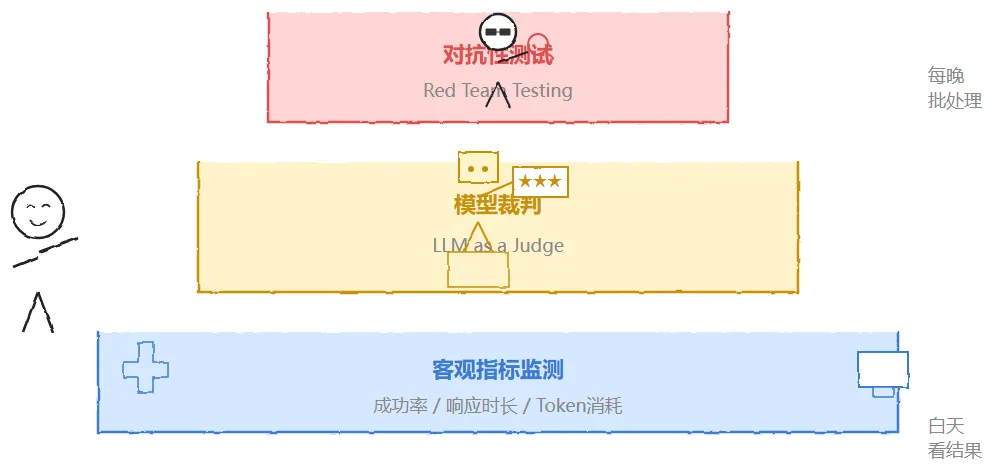
前段时间有个粉丝去面Agent方向岗位,三面的时候聊到了线上评测体系。面试官问了一个看起来很直接的问题:"你们Agent上线之后怎么做质量监控的?"他说搭了一套三层评测流水线,底层靠代码跑客观指标,中间用模型当裁判给线上对话打分,顶层有对抗性测试做版本准入。
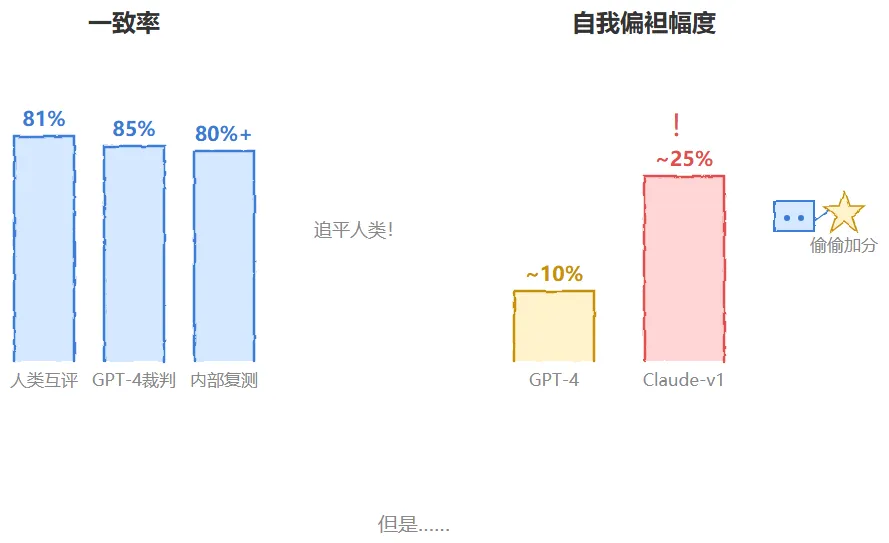
面试官听完点了点头,追问:"第二层用模型给模型打分——你不怕裁判自己吹自己吗?"他愣了一下,说应该不会吧毕竟自己内部测过一致率有0.8以上,和论文里的数据差不多。面试官笑了笑,问:"那篇论文有没有提过,GPT-4当裁判的时候,给自己生成的答案多打了多少分?"他挠了挠头,说这个他没太注意。面试官没有继续追问,但他回来复盘的时候发现,这个偏差问题比他想象中严重得多——GPT-4自我偏袒的幅度将近10%,Claude-v1更夸张,接近25%。
今天就把这个事情说清楚。不光是"模型裁判会不会吹自己"这一个问题,整个三层评测体系是怎么搭的、每一层解决什么问题、每一层有什么坑,一次性讲明白。
1. 自动化评测体系的背景与目标
Agent一旦跑到线上去,最麻烦的事情是什么呢?其实不是说它会不会出错,而是没有人知道它到底什么时候开始变差。
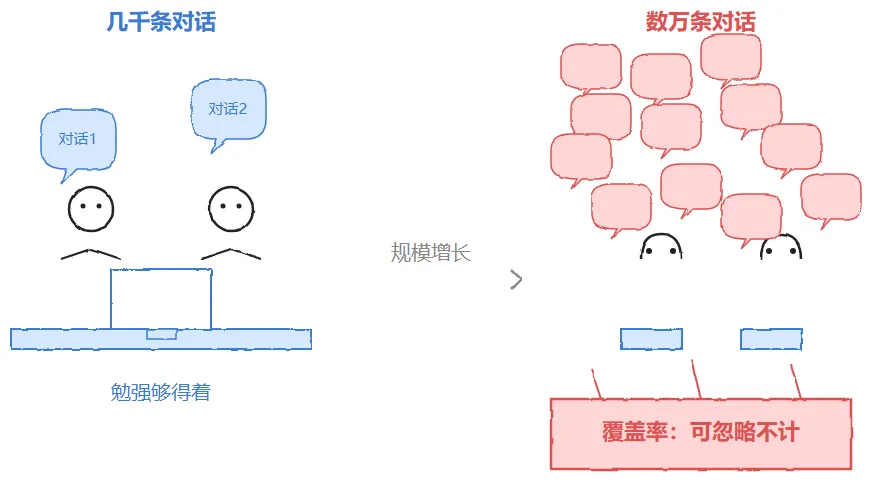
靠人工抽检来兜底?说白了那就是一笔算不过来的账嘛。
你想想看,哪怕每天只产生几千条对话,安排几个人盯着去看,也顶多就是摸到个皮毛。等到真的上了数万条那个规模,人力覆盖率会直接跌到可以忽略不计的程度,这个不是夸张。
还有一个更麻烦的事情,就是主观性的问题。同一段对话,两个评估员给出完全相反的判断,这种事在实践当中并不少见,真的。
所以说没有在"要不要自动化"这件事上面纠结太久。可以直接搭一套三层的评测流水线出来,每晚跑批处理,白天去看结果。
这个思路和业内常见的 LLM Evaluation + Observability 体系比较接近。实际工程中,Agent上线后的评测通常会覆盖运行状态监控、质量评估以及发布前回归测试三个方向。底层是什么?底层是能力基准测试,就是像MMLU、HumanEval这类跑分的东西。中间那一层,是应用级指标框架,针对RAG或者Agent场景去做专项打分。上层就是生产环境的持续监控了。
这里的三层设计,基本上对应的是中层和上层这两层。因为Agent已经在线上跑了嘛,其实更关心的是"它有没有变差",而不是"模型本身到底强不强"。
2. 第一层:客观指标监测
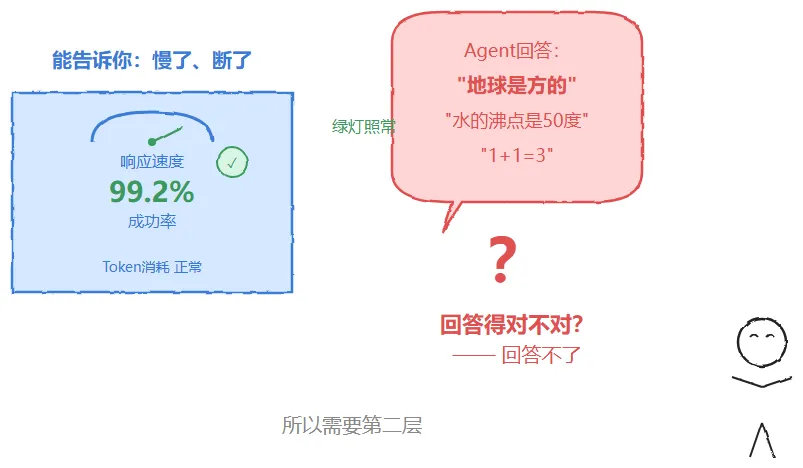
第一层呢,不涉及任何的模型的推理,纯粹就是靠代码逻辑去跑统计
接口调用成功率、平均响应时长、单轮Token消耗、流程完成率——这些数字本身没有语义理解的门槛。异常了就是异常了嘛,用不着去"判断"什么。
阈值一旦被触破,报警立刻就打过来了。不需要等谁在早上翻日志才发现问题,那是很被动的。
如果拿行业里面的分层来对照的话,这一层其实更接近APM的延伸。APM是什么?就是应用性能监控。类似Datadog LLM Observability或者New Relic那种做法,把AI信号和CPU、内存、网络这些指标放在一起去看。
区别在于什么?区别在于没有引入完整的APM平台,是把这部分做成了轻量级的自建脚本。好处嘛,就是灵活,成本也低。代价,就是缺少现成的可视化面板和告警联动,这块目前还是手工去拼的。
还有一个容易被忽略的坑是什么?就是纯代码指标只能告诉你"哪里慢了、哪里断了",但是它回答不了"回复得到底对不对"。
这也是为什么必须要有第二层的原因。
3. 第二层:模型作为裁判
这一层呢,引入了一个叫做"LLM as a Judge"的思路。就是用一个能力更强的模型去给线上的真实对话打分。打分的维度包括什么?包括是不是答非所问、有没有重复啰嗦、是不是在编造事实,等等等等。
这个方法不是随便说的。2023年的时候,Zheng他们那帮人在一篇论文里面就系统验证过了。那篇论文叫做《Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena》。
他们用GPT-4来做裁判嘛,在受控评测和众包评测两种场景下面,和人类专家评分的一致率都超过了80%。有些设置下甚至达到了85%,已经追平了人类评估员彼此之间的一致率了。人类互评的一致率大概是81%左右。
不过,这里有个原文没提但是值得警惕的点。LLM裁判存在几种系统性的偏差。比如说,它更偏爱位置靠前的答案,更偏爱啰嗦的回答,甚至会偏爱和自己"同源"的模型输出。上面提到的那篇论文里面就发现了,这个LLM Judge 存在 self-enhancement bias,即裁判模型可能倾向给同源模型更高评分,不同模型之间偏差幅度可能达到几个百分点甚至更高,具体取决于任务和实验设置。这就是那位粉丝在阿里二面被追问的问题——"你不怕裁判自己吹自己?"——背后的真相。一致率0.8以上确实不错,但如果你的裁判模型和被评测的模型是同一家的,这个分数就要打个折扣去看。
所以说"一致率0.8以上"不等于"完全可用"。更准确的说法是什么?是"在做好偏差校准的前提下,可以作为人工评估的一个高性价比替代"。这一点在部署裁判模型的时候,最好留一道人工抽检的口子。
放到更大的生态里面去看,现在市面上专门做这类评测的工具已经不少了。像开源的RAGAS,它是专注RAG场景的忠实度和相关性打分的。DeepEval走的是pytest风格的单元测试路线。Langfuse、LangSmith、Braintrust这些,则更偏生产环境的全链路追踪和评分看板。
目前可以采用是自研裁判逻辑加上自建看板。如果团队规模更大、需要多人协作标注和历史趋势对比的话,直接上Braintrust或者Langfuse这类现成的平台,可能比自己去维护一套裁判prompt要更省心一些。
4. 第三层:对抗性测试
第三层做的事情,有点像安全领域的"红队测试"。只不过红队对着的是漏洞,这里对着的是Agent容易翻车的那些场景。
题库里面收录的都是什么?都是历史上真实导致过错误的案例。比如说意图含糊不清的提问,还有需要多步推理才能给出正确答案的复杂请求。
新版本上线之前,先拿这套题库跑一遍。低于基准线就直接拦截,不给发布窗口。
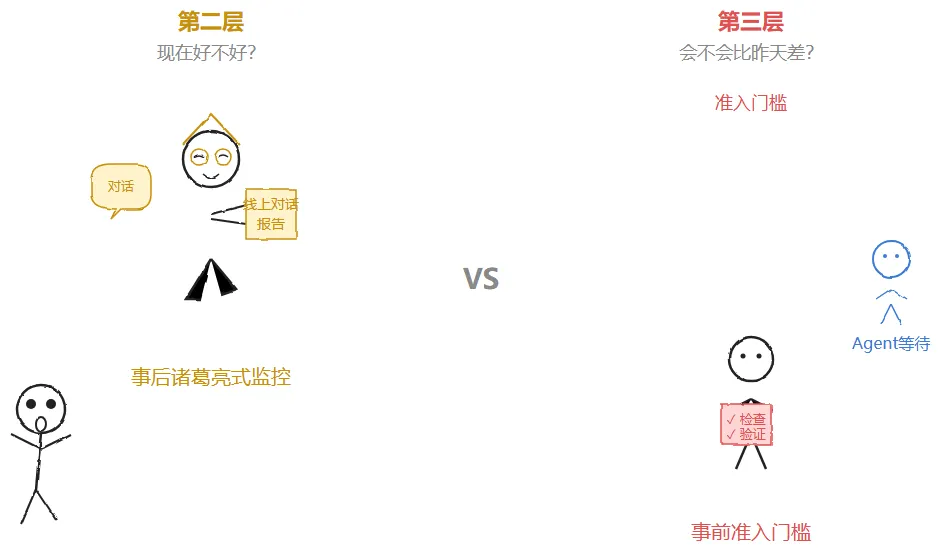
这一层和第二层的分工其实是很清楚的。第二层评的是什么?是"线上真实流量的整体质量",属于事后诸葛亮式的监控。第三层评的是什么?是"新版本有没有在已知的坑上重蹈覆辙",属于事前的准入门槛。
换句话说,第二层管的是"现在好不好",第三层管的是"会不会比昨天差"。
这类基于历史案例构建的对抗题库有一个天然的短板。它只能拦住那些"见过的坑",对全新出现的失败模式是无能为力的。面试官当时追问的"你的对抗题库只能拦住见过的坑——新坑怎么办?"问的就是这个问题。
业内的一些做法是什么?是把对抗题库和自动化的Prompt变异测试结合起来。比如说用Promptfoo这类工具去做矩阵化的Prompt对比,主动生成一些题库里面没有的边缘案例,作为题库的补充而不是替代。
5. 每日健康报告与体系成效
三层流程跑完之后,系统会自动拼出一份健康度报告出来。每天早上打开看一眼,昨晚线上有没有异常就一目了然了。
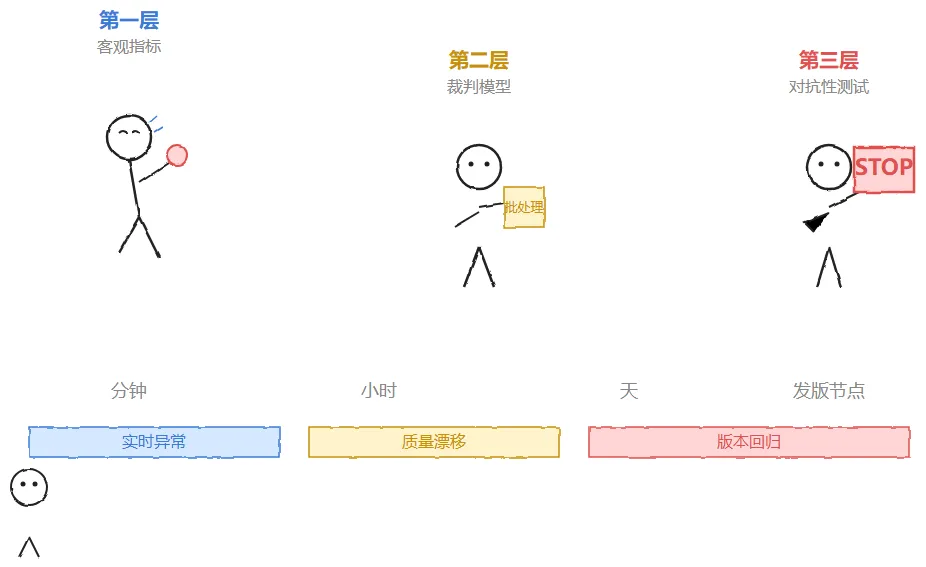
比较有意思的是什么?如果按照三层各自的报警贡献拆开来看的话,第一层的客观指标类报警响应是最快的,基本是分钟级。第二层的裁判模型报警滞后到批处理周期,是小时甚至天级的。第三层的拦截只发生在发版节点,频率是最低的,但一票否决权是最大的。
三者叠加起来,基本覆盖了"实时异常、质量漂移、版本回归"这三种不同时间尺度的风险。
来说一下我自己的判断。这套三层结构的性价比,对中小团队是相当友好的。不需要一上来就去采购商业化的观测平台。但是一旦Agent接入的业务线变多了、需要多团队协作标注和追溯的时候,现成的开源或者商业方案在协作效率上面的优势会逐渐反超自建脚本的灵活性。到那个阶段再去迁移的话,会更合适一些。
你有搭过类似的评测体系吗?评论区聊聊,看看大家都是怎么做的。如果你也在纠结"模型裁判到底靠不靠谱"这个问题,今天这篇应该能帮你把一些疑虑解开。