导读Agent 的工具路由、信息筛选和过程检查,可以交给专门的决策模型。先用现成模型建立业务基线,满足要求就直接使用;需要自行适配时,再比较冻结通用大模型、通过 AnyJev 消偏校准,或微调轻量底座、训练专用决策模型。本文结合公开实现与实验,解释分工,以及判断质量、数据和部署条件怎样影响选择。
本文 3449 字,阅读约 9 分钟|先明确分工,再检查答案与概率 → 路线一 → 路线二 → 怎么选 → 把决策接入工作流,才能验证选型 → 想动手,可以从 Jev Cookbook 开始
先明确分工,再检查答案与概率
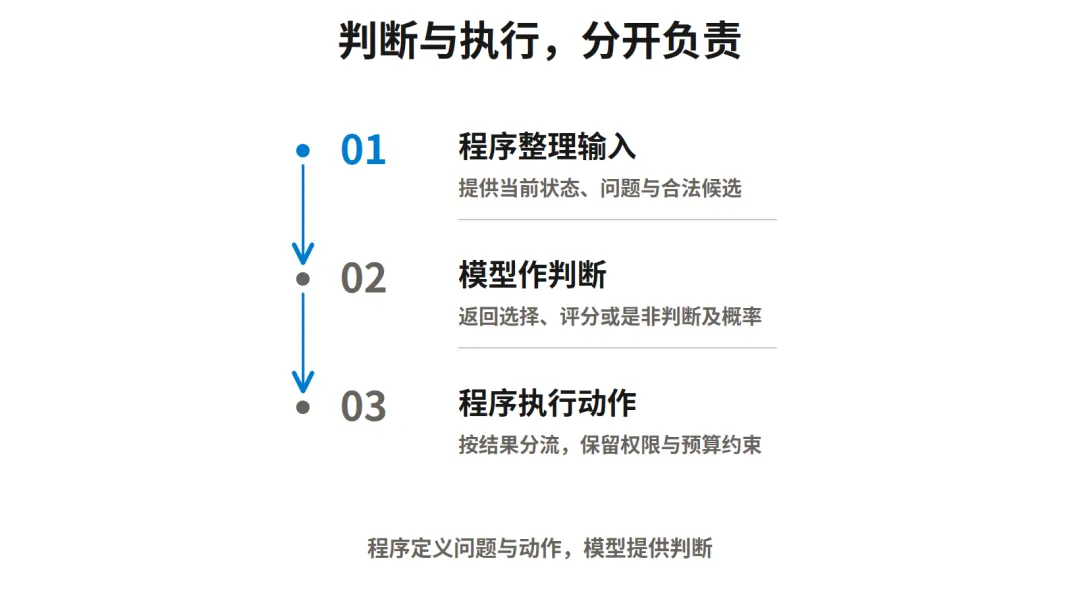
一条工单该交给账务还是技术?Agent 是否需要调用数据库?当前操作应继续执行还是转交人工?这些问题都有明确的候选答案,程序需要的是一个可用的判断。
Jev 是 TypeSafe 的结构化决策模型,提供选择、评分和是非判断接口。程序把状态与问题交给它,再根据返回值分流或执行动作;写代码、组织复杂方案等开放任务仍由生成模型承担。
它接替的是一部分语义判断,原来做判断的可能是 LLM,也可能是规则。例如,日志相关性原由 LLM 判断,或工单按关键词分流,都可以考虑改用决策模型。精确去重、数值计算和权限检查继续由代码处理,是否值得替换要看实际收益。
接入决策模型,可以先从现成模型开始。用真实工单测试 Jev 等模型的分流质量、概率可靠性和服务成本,满足要求就直接使用。有特有规则或本地部署需求时,再评估适配的投入。
本文比较两种自行适配实现:AnyJev 调整通用大语言模型的决策分数;AgentJev 更新轻量底座和决策头。下文实验没有与原版 Jev 做同条件对照,不能据此评价现成决策模型的优劣。
先看 AnyJev 所处理的问题。给通用大语言模型列出候选,把它们映射为 A、B、C 等单个 token(模型处理文本的基本单元),直接读取答案位置的分数。Logits 是归一化之前的分数;经过 Softmax 转换,才得到候选答案的概率分布。这个过程省去了逐 token 生成答案和解析文本的步骤,但仍要计算输入上下文。
直接读分数也有问题。模型可能偏爱某个标签,或者偏爱列表中的某个位置。同一问题只换一下选项顺序,答案就可能变。
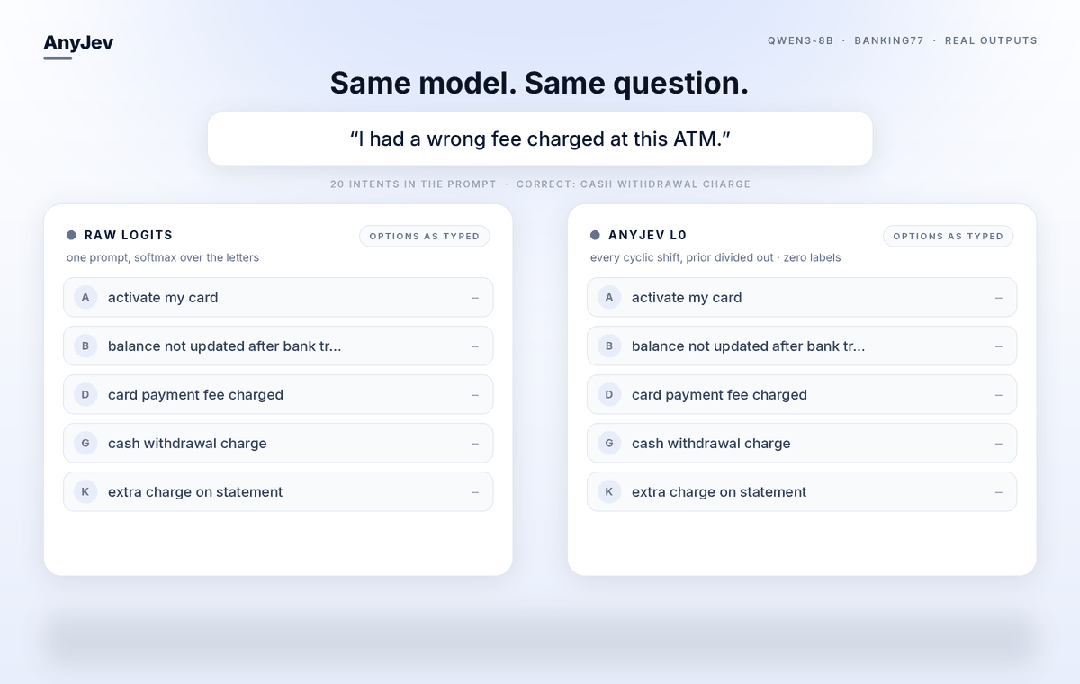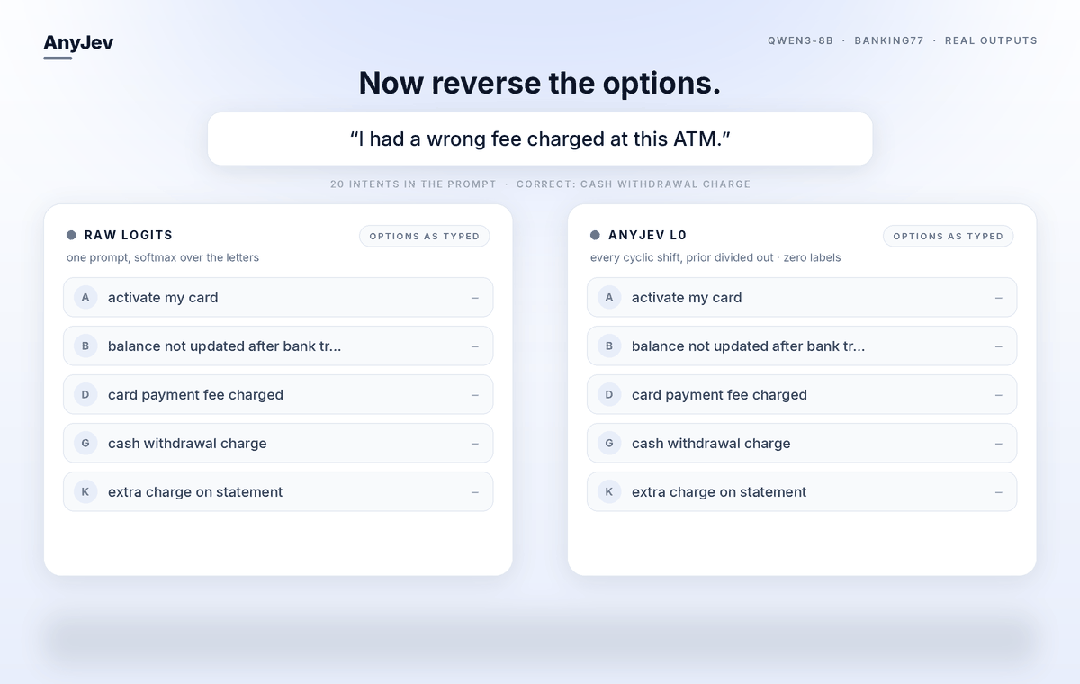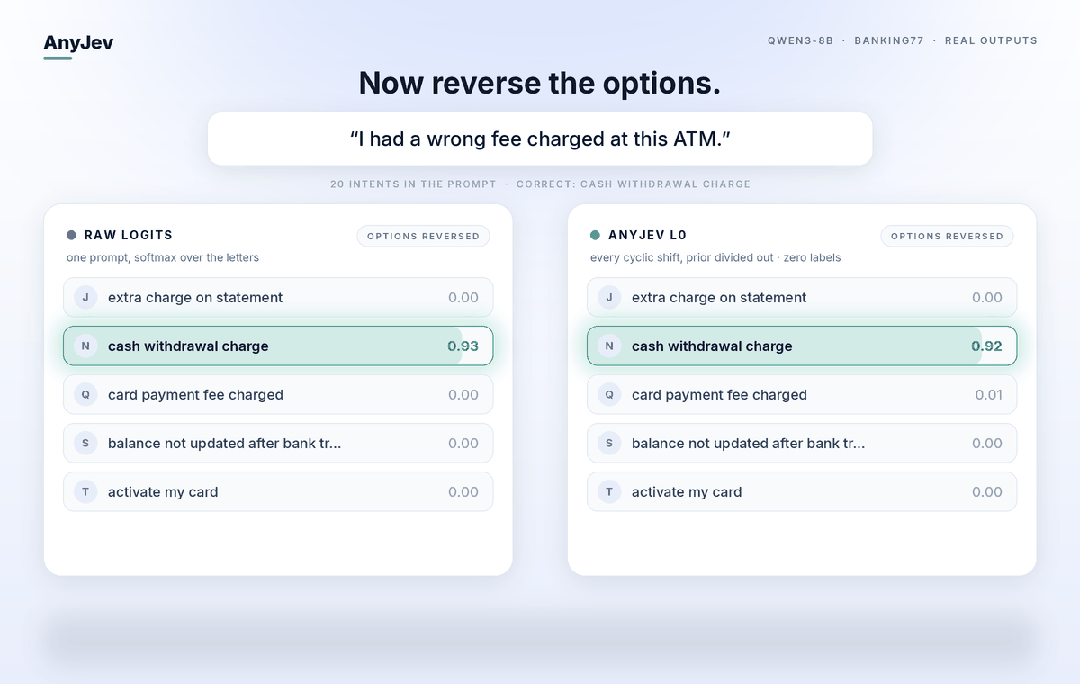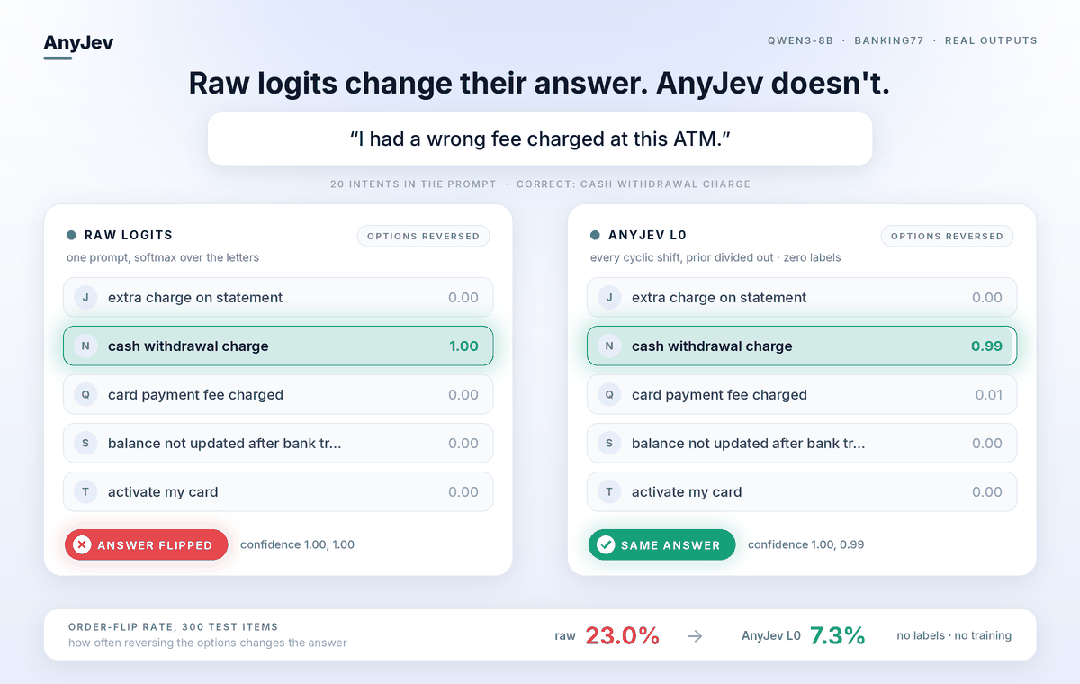 图片说明:同一条 ATM 费用工单,左侧直接读取分数的答案随选项顺序变化,右侧 AnyJev L0 在该案例中保持一致。图片来源:AnyJev v0.2.0 项目仓库
另一层问题是概率质量。返回 0.9,并不自动说明类似请求中有九成判断正确。概率校准要检查的,正是预测把握与实际表现是否匹配;置信度门控则据此决定哪些请求自动处理、哪些交给人工或更强的模型。
因此,选型至少要分清三件事:选项是否稳定、判断是否准确、概率是否适合设阈值。输出格式固定,也不能保证语义正确。
路线一:冻结底座,用 AnyJev 调整决策分数
AnyJev 由诺基亚研究人员与腾讯混元等参与者开发,官方仓库是 nokia-applied-research/AnyJev。它利用现有模型的特征和输出,不更新底座权重。
本文采用 v0.2.0 的 L0/L1/L2 方案。项目在 2026 年 10 月 6 日发布的 v0.3.0 已移除 L1/L2 接口,加入自蒸馏模型 Tacit。下文以旧版方法比较冻结底座与全参数微调,复现时应固定到 v0.2.0。
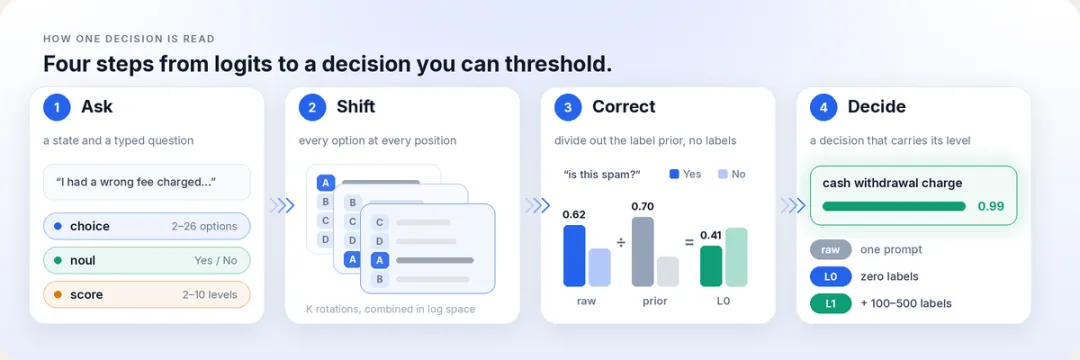 图片说明:类型化提问、轮转选项、消除标签先验,再返回决策;图中展示的是旧版 raw、L0 与 L1 路径。图片来源:AnyJev v0.2.0 项目仓库
L0:用多轮读取降低选项偏置
面对 K 个候选,L0 让选项循环移位,使每个候选都在各个位置出现一次。每轮读取后,把分数对应回原来的候选,在对数空间合并,并结合无标签输入估计的标签先验作修正。
可以把它理解为:让每个选项都经历相同的位置条件,再比较汇总结果。在位置影响能近似写成附加分数时,这种平均能抵消位置因素;真实模型中的选项相互影响仍可能留下残余偏置。
v0.2.0 公布的 Qwen3-8B 实验中,BANKING77 的 20 分类子任务使用 300 条测试输入,选项倒序导致答案翻转的比例从 23.0% 降到 7.3%。消偏有效,但仍有残余顺序影响。
零标签不代表零开销。完整 L0 对 K 个选项需要 K 次输入前向计算;共享前缀缓存和提前停止可以减少耗时,仍要按候选数、上下文长度和服务后端实测。
L1:校准概率,帮助设定放行阈值
L1 在 L0 的基础上,用每个问题约 100—500 条标注样本拟合温度参数。温度缩放调整概率分布的集中程度:过于自信时,把分布适当摊开。
单个正温度参数不会改变选项排序。温度校准主要改善概率,不能让选错的答案变成选对。消偏带来的准确率变化,应与温度缩放的校准收益分别评估。
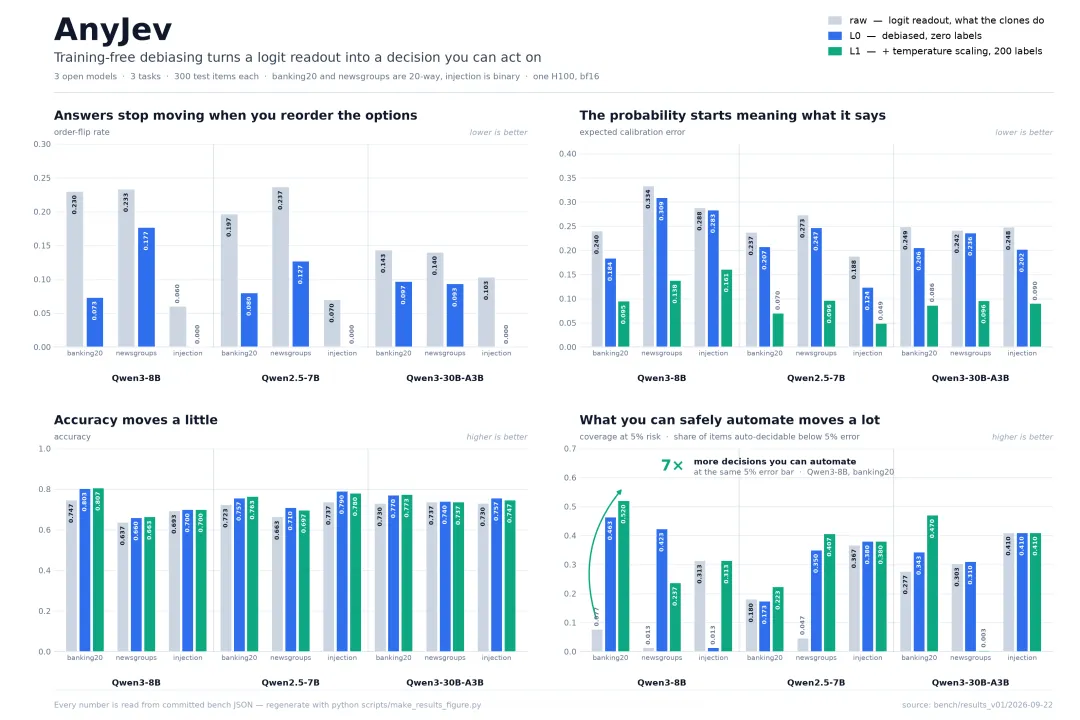 图片说明:左上比较顺序翻转率,右上比较校准误差,右下比较错误率不超过 5% 时可自动处理的测试样本比例。读图重点是 Qwen3-8B 的 banking20 三列。图片来源:AnyJev v0.2.0 项目仓库
在上述实验中,预期校准误差(ECE,用来衡量预测把握与实际正确率的偏差)从原始读取的 0.240 降至 L1 的 0.095。错误率不超过 5% 时,可自动处理的测试样本比例从 7.7% 提高到 52.0%;其中 L0 已达到 46.3%。
这是该小样本评测中的覆盖率结果,体现了门控价值。真实业务仍需用独立数据验证阈值,并监测输入分布变化,不能直接把 52.0% 当作生产流量的放行保证。
L2:在中间层拟合专用打分头
L2 换了一条输出路径:读取模型中间层的隐藏状态,也就是模型计算出的内部特征,再为每个问题拟合一个线性打分头。底座冻结,新增打分头通过直接求解方程得到参数,即闭式求解,无需对底座做梯度更新。
因此,“免微调”准确地说是不微调底座,并非完全没有学习过程。L2 每个问题需要约 100—300 条标签,打分头也不能直接搬到另一个问题或模型上。
在 typed-decisions 的 2000 道保留测试题上,v0.2.0 的 Qwen3-4B 使用 36 层中的前 24 层,准确率为 78.6%;Qwen3-8B 同样停在前 24 层,项目测得的批处理耗时约为完整单次前向的 0.68 倍,即耗时减少约 32%。这是 H100 NVL、指定输入长度和批大小下的结果。
L2 对每个状态与问题组合只需一个 prompt(输入提示),但需要后端提供中间特征。该版本支持 Transformers 和 vLLM 的嵌入服务;普通聊天接口只返回文本时,无法直接接入。
路线二:微调轻量底座,训练专用决策模型
业务里的特殊术语、规则或状态关系,可能需要通过训练改变模型提取的特征。团队能持续准备数据、维护模型服务时,可以沿 AgentJev 路线训练专用模型;这里更新的是选定的轻量底座及决策头。
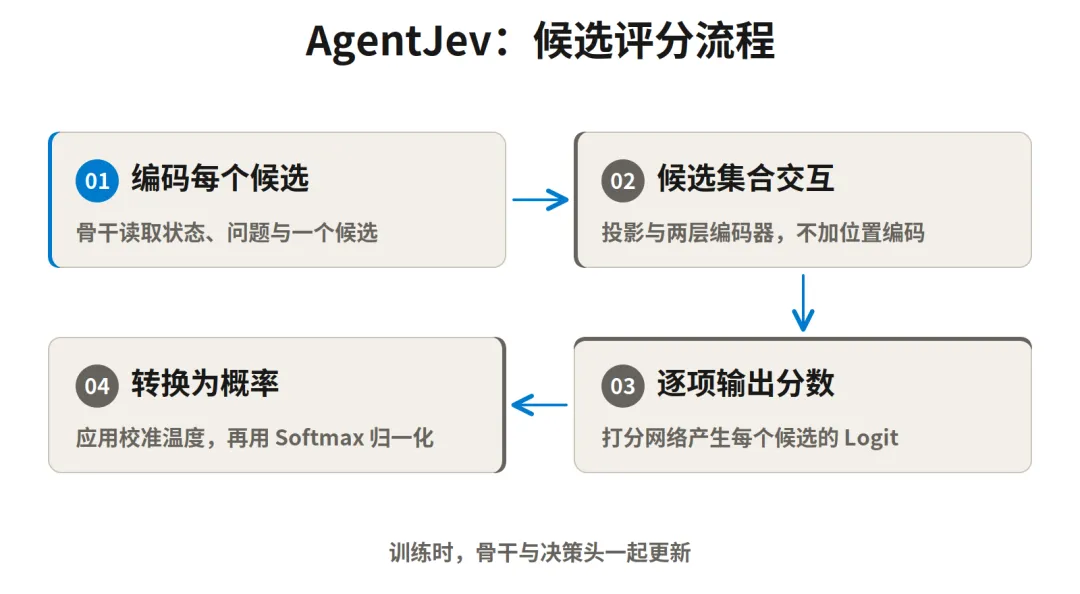
XiaokeAILabs 的公开实验基于 AgentJev 模型代码,使用 Qwen3-0.6B-Base 骨干。它去掉语言模型生成头,让每个“状态、问题、候选”组合先得到特征,再通过投影层、两层候选集合 Transformer 和打分网络输出候选分数。
候选集合编码器不使用位置编码,调换候选顺序时,输出跟着候选对应变化。候选分数经 Softmax 转换为概率,再用于选择与校准。训练同时更新骨干与决策头,属于全参数微调。
输入包含状态、类型化问题和目标概率分布。公开流程先按案例切分,再展开每个案例的五道问题:960 个案例用于训练,120 个用于开发集选优,120 个用于概率校准,400 个测试案例保持独立。
训练损失同时约束目标概率分布与预测偏差。先在开发集选检查点,再用独立校准集拟合温度,最后读取测试集。这样的顺序减少评测泄漏,文本哈希检查也用于防止相同状态跨集合重复。
仓库报告:在 DGX Spark 的 GB10、128 GB 统一内存设备上,600 步训练约耗时 49 分钟,峰值 GPU 内存占用约 34 GB;测试集 2000 道题的准确率为 78.05%。底座文件约 1.5 GB,但文件大小不能直接换算成训练或服务内存。
这里还有一个关键口径:typed-decisions 的目标分布来自教师模型采样,准确率衡量的是与教师标签的一致程度。它能用于检查复现结果,业务迁移后还要验证真实任务正确率。
训练产物可通过仓库的服务脚本提供本地 HTTP 接口。小底座为降低常驻资源需求提供了可能,但端到端延迟还受输入长度、候选编码和并发影响。训练代码当前仍按候选分别编码公共前缀,不能只凭 0.6B 参数量就承诺高吞吐。
怎么选:先看数据和部署条件,再看模型大小
先用业务样本评估现成模型:判断正确率、阈值下的错误率和覆盖率,以及端到端耗时与服务成本是否达标。达标时保持现有方案即可。
需要适配时,区分问题:答案基本正确、概率过于自信,优先验证校准;业务规则持续被判断错,则评估训练能否带来改善。本地部署和接口条件也会影响选择。
下面比较两种自行适配方案:差别在于参数是否更新,以及团队要长期维护什么。
| 比较维度 | AnyJev v0.2.0 冻结底座路线 | AgentJev 专用微调路线 |
|---|
| 参数更新 | L0/L1 调整分数;L2 拟合额外打分头 | 同时更新骨干与决策头 |
| 数据需求 | L0 无标签;L1/L2 按问题准备少量标签 | 准备训练、开发、校准与测试数据 |
| 推理开销 | L0/L1 多轮轮转;L2 单 prompt,可截断层数 | 小骨干打分;关注候选数与前缀重复计算 |
| 接入条件 | 标签分数访问;L2 另需隐藏状态接口 | 部署专用权重与决策服务 |
| 维护重点 | 问题对应的先验、温度或打分头 | 业务数据、模型版本与训练流程 |
已有通用大语言模型、能读取候选标签分数且标签很少时,可先用 L0 检查顺序偏置;需要自动分流,再准备独立标签验证概率校准。候选很多时,把轮转成本一起算进去。
业务问题稳定、能访问隐藏状态,又有少量标签时,旧版 L2 值得作为基线。它能测试现有特征是否已经够用,但每个问题的打分头都要维护,换题后不能默认沿用。
现成方案在业务术语和判断规则上仍有缺口,或需要自主管理本地专用服务,且能持续准备数据时,微调小底座值得评估。它提供业务适配空间,是否比冻结底座更准、更快,要在同一份测试集和同一套服务条件下比较。
先证明现成方案哪里不满足需求,再决定是否适配。自行适配时,也可以先做冻结底座基线,再用业务错误样本判断更新底座的增量。
把决策接入工作流,才能验证选型
mu 提供了一个落地例子。它把判断放进 Harness,也就是模型外组织工具调用、上下文和任务流程的执行框架:工具输出哪些值得保留、任务是否完成,都可以交给独立的 Judge(判定模型)。每个决策点能分别配置 Jev、本地 Laya 或普通大模型。
它的 shadow(影子)模式也值得借鉴:只记录判断,先不改变 Agent 行为。更换模型前,可以用相同输入比较判断与延迟,再验证启用后的任务表现。单次判断更快,还要看整个工作流是否完成得更好。
Jev-Mem 则把相近思路用于记忆管理:判定模型决定检索哪些关系、是否继续扩展,最后由生成模型根据证据回答。其公开实现支持 Jev 或本地 Laya,共用记忆与检索流程;论文公布的性能使用 Jev,不能直接套到 Laya 上。
这些实现提示我们:决策接口与下游动作可以独立设计,更换后端后再验证判断质量和门控阈值。
Jev 未开源完整模型,社区却跑出了三条复现路线
想动手,可以从 Jev Cookbook 开始
Datawhale 开源的 Jev Cookbook 提供中文教程与可运行的 Jupyter Notebook,涵盖三类决策接口、工具路由、引用核查、防护栏,以及模型评测和 Agent 集成。
本地模型章节介绍 Laya 的微调与部署,适合作为动手入口;它与本文的 AgentJev 实验使用不同训练路线,需按各自实现运行。
开源地址: https://github.com/datawhalechina/jev-cookbook
参考资料
• AnyJev v0.2.0 方法与评测: https://github.com/nokia-applied-research/AnyJev/tree/v0.2.0
• AnyJev 版本变更说明: https://github.com/nokia-applied-research/AnyJev/blob/main/CHANGELOG.md
• AnyJev Technical Report: https://arxiv.org/html/2610.00831v1
• XiaokeAILabs 专用决策模型训练实验: https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/text_jev_train
• typed-decisions 数据集与评测口径: https://huggingface.co/datasets/LocalLLaMA/typed-decisions
• Datawhale Jev Cookbook: https://github.com/datawhalechina/jev-cookbook
• mu 的可配置判定模型与影子模式: https://github.com/qybaihe/mu
• Jev-Mem 的记忆控制与本地后端: https://github.com/libingzheren/Jev-Mem
• Jev-Mem 原始论文: https://arxiv.org/html/2609.23986v1
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!