导读:阿里通义 OpenJudge 团队 2026 年 6 月开源的评测基准,业界首批把「运行框架」当正式被测对象。150 道真实任务、9 个模型、3 个框架、4050 个测试单元,最有名的结论是同一个模型换个框架最多掉 11.5 分。8 节讲清它解决什么问题、怎么测、发现了什么、怎么用。 📖 本篇目录 01 先把问题摆正:Agent 失败了,锅是谁的 02 解法:把两个变量塞进同一个实验室 03 评分机制:判完成用证据,判质量用裁判 04 核心发现一:框架差距到底有多大 05 核心发现二:切片下钻,总榜之外全是信息 06 轨迹归因:五类框架通病与四条设计原则 07 上手:六步跑通,成本账很省 08 边界,以及五条可以直接搬走的结论 01 先把问题摆正:Agent 失败了,锅是谁的
Agent 从不裸奔。模型外面永远包着一层运行框架(Harness):系统提示词怎么拼、挂哪些工具、工作区怎么组织、Skill 怎么发现、出错给不给重试、任务算不算完成,都是框架说了算。可以把模型理解为发动机,框架是传动系统、车架和方向盘,没有好的整车工程,再强的发动机也跑不快。
麻烦在于,传统基准(MMLU、SWE-bench 这类)只考模型本身。于是一个评测真空出现了:模型榜单分数,和 Agent 系统的实际表现对不上。一次任务失败,至少有六个候选凶手:模型没想明白、工具没给对、Skill 没被发现、工作区没读懂、Web 访问不稳、完成判定太宽松。
传统评测只能告诉你「挂了」,回答不了「谁的锅」。选模型的榜单一大把,选框架的基准长期是空白。
02 解法:把两个变量塞进同一个实验室
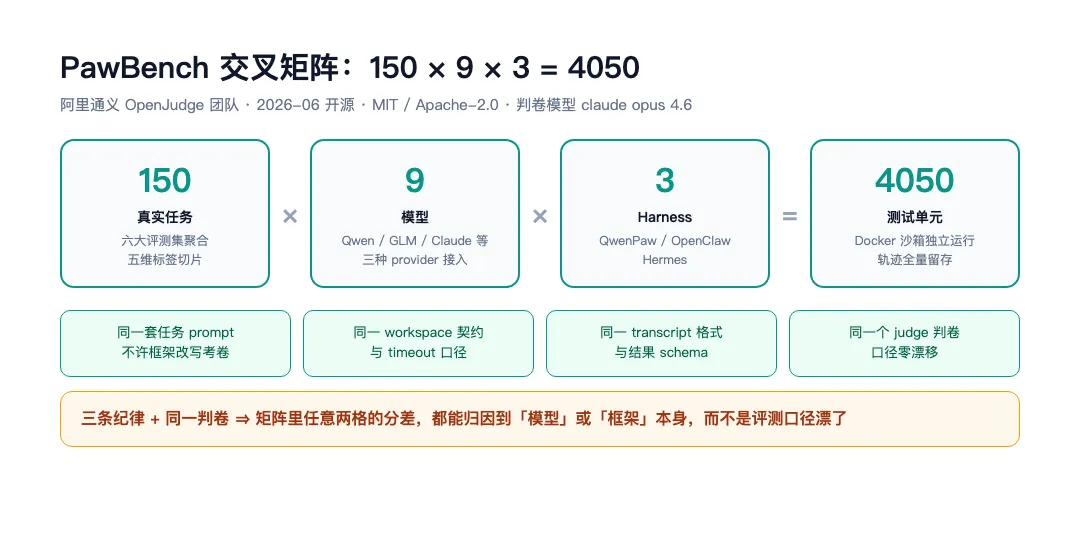
PawBench 的做法一句话讲完:模型和框架同时当被测对象,放进同一张交叉矩阵。150 道真实任务从 claweval、skillsbench 等六大评测集聚合而来,每道带五维标签(场景、能力、复杂度、模态、环境);9 个模型分别跑在 3 个框架上,即阿里自家的 QwenPaw、开源的 OpenClaw、社区对照组 Hermes。9×3×150 = 4050 个测试单元,每个单元跑在独立 Docker 容器里,环境隔离、随时重建。
固定模型看框架贡献,固定框架看模型贡献,控制变量,这是方法论上最核心的一步。
交叉矩阵要成立,前提是口径不漂移。官方给贡献者立了四条规矩:换框架不许换考卷——同一套任务 prompt,不许框架侧改写优化;同一 workspace 契约与超时口径,避免靠放宽约束刷分;同一 transcript 格式与结果 schema,轨迹可逐字段对比;再加同一个 judge 判卷。四条齐全,矩阵里任意两格的分差,才能归因到模型或框架本身。
▲ 交叉矩阵:150 任务 × 9 模型 × 3 框架,四条口径纪律保可比性
03 评分机制:判完成用证据,判质量用裁判
判分有三种模式,由每道任务自己声明。automated 靠规则断言,查硬指标:文件落盘没有、字段匹配没有、exit code 是不是 0。llm_judge 用 LLM 裁判按 rubric 评语义质量,v1.0 的判卷模型是 claude opus 4.6。hybrid 两者混合,分数区间 0-1。
产物级硬校验是它最实用的一刀:Agent 声称「已完成」不算数,文件真的写进工作区、diff 真的生成,才给分。专门治大模型的汇报式完成。
证据留存做了三层:transcript 加 metrics 默认保存,--save-workspace 保留工作区现场,--save-docker-image 连整个容器都存下来,失败可以逐层回放。
还有个容易被忽略的评测哲学:官方强调还原 fresh clone 的默认体验,不追求配齐所有 API key 的理论上限。缺省体验差,就是真差距。
04 核心发现一:框架差距到底有多大
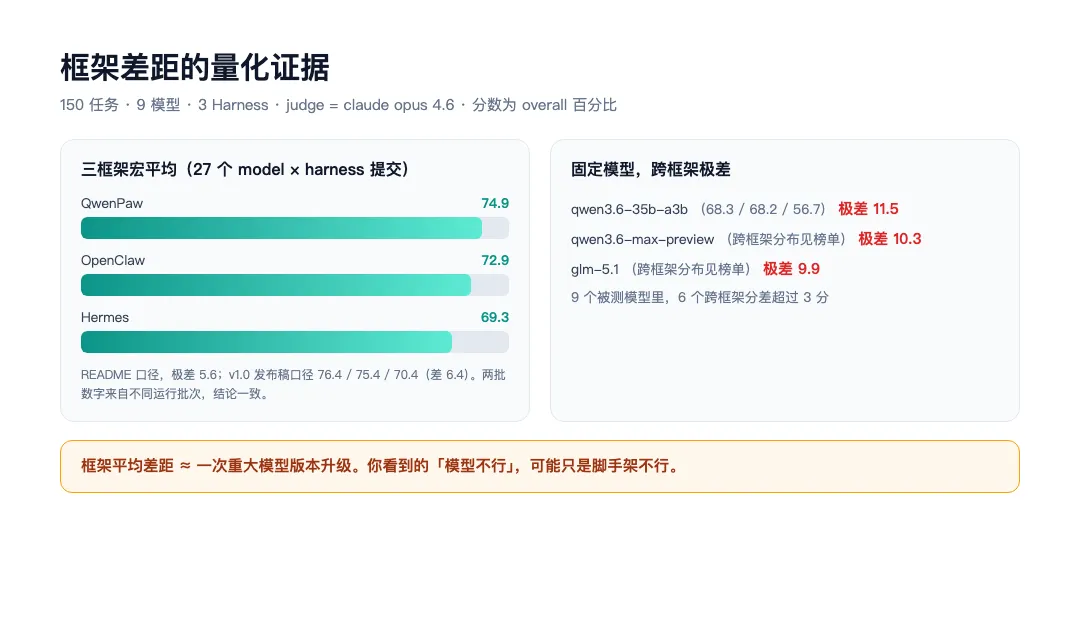
先给宏平均。27 个 model × harness 组合:QwenPaw 74.9、OpenClaw 72.9、Hermes 69.3(README 口径;v1.0 发布稿口径为 76.4 / 75.4 / 70.4,差 6.4。两批数字来自不同运行批次,结论一致)。框架平均差距,量级约等于一次重大的模型版本升级。
更扎眼的是固定模型看框架:qwen3.6-35b-a3b 在 QwenPaw 上得 68.3,换到 Hermes 只剩 56.7,极差 11.5 分;qwen3.6-max-preview 极差 10.3,glm-5.1 极差 9.9。9 个被测模型里,6 个跨框架分差超过 3 分。框架差距是系统性现象:6/9 的模型都在踩,跟选了哪家模型关系不大。
还有两个发现值得单独说。其一,小模型能下克上:Hermes 框架上的 GLM 5.1 得 68.2,QwenPaw 框架上的小尺寸模型得 70.4,小模型配好框架,赢了大模型配差框架。严谨备注:这是模型与框架同时变化的对比,不能把分差全记在框架头上,但它足以说明框架的影响力大到能部分拉平参数代差。
其二,Agent 任务会压缩模型间差距。纯文本生成任务上模型差异很大,进入真实 Agent 任务后差距被明显压缩,系统工程能力的权重上升。当模型都过了能力门槛,prompt 组织、工具调度、状态管理、错误处理这些工程环节决定最终成绩。标题里那句「框架的差距,比模型大得多」,数据支撑就在这里。
▲ 三框架宏平均与固定模型跨框架极差:6/9 模型分差超 3 分
05 核心发现二:切片下钻,总榜之外全是信息
总榜只是第一层。PawBench 支持九个切片维度:来源、场景、能力、复杂度、模态、环境、判分类型、模型、框架,任意切分看分数。切片里的信息量比总榜大得多。
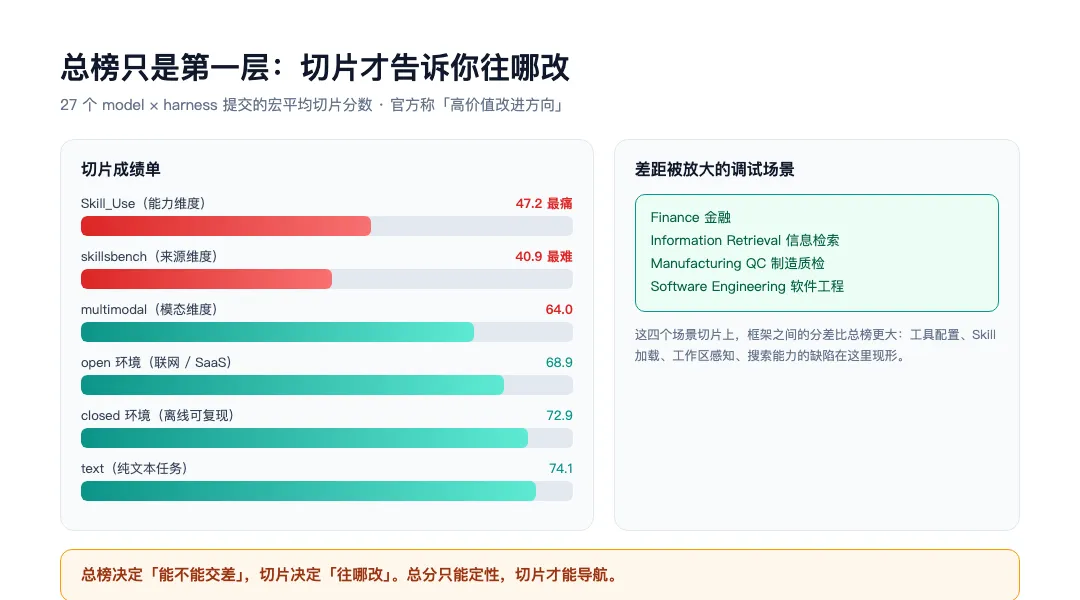
切片成绩单:Skill_Use 47.2,全部能力维度里最痛的一刀,Skill 的发现、加载、按流程执行依然脆弱;skillsbench 来源集 40.9,全场最难考卷,印证上一条;multimodal 64.0,比 text 的 74.1 差 10 分;open 环境 68.9,比 closed 的 72.9 低 4 分,联网和真实 SaaS API 的摩擦是真实的。
官方还点名了四个框架差距被放大的场景:金融、信息检索、制造质检、软件工程。工具配置、Skill 加载、工作区感知、搜索能力的缺陷,在这些切片上现形。
切片怎么用?官方的读法可以抄:总榜落后 3 分 → 能力切片发现 Skill_Use 掉分最狠,提出假设:本地 Skill 主动发现缺失 → 来源切片 40.9 确认方向 → 精读该来源任务的 transcript → 修复后只重跑目标切片,看差值回不回血。总榜决定能不能交差,切片决定往哪改。
▲ 切片成绩单:Skill_Use 47.2 是全部能力维度里最痛的一刀
06 轨迹归因:五类框架通病与四条设计原则
发布稿对 4050 个单元的运行轨迹做了归因分析,框架间的分数差落到工程行为上,是五件事:工作区产物缺乏实质校验,模型说写完了,框架不查文件;工具路径约束宽松;工具表过大,几十个工具一次性塞进上下文,注意力稀释;本地 Skill 主动发现弱;Web 搜索零配置不可用。
五条通病本质相同:该告诉模型的信息没告诉,该收窄的自由度没收窄,该验的产物没验。框架工程不是给模型加功能,而是在信息完整度和决策负担之间找平衡。
由此官方给出四条设计原则。充分告知:cwd、工作区等环境上下文显式注入,别让模型做对话考古。按需装备:控制工具数量,砍低频工具反而提分,搜索这类关键能力零配置开箱。主动监控:产物校验、每 N 步方向性检查,执行与监控分离。弹性恢复:重试、上下文压缩、状态回滚、循环熔断,这些与模型能力无关,是纯工程能力,也是生产级和玩具级的分水岭。
两喂两管:喂是释放模型能力,管是不让工程拖后腿,四条全部指向同一个目标。评测什么,框架就会治理什么——产物级校验间接推动了框架侧完成判定收紧,这是评测反过来塑造工程的活例子。
07 上手:六步跑通,成本账很省
上手门槛不高,Python 3.11+ 加 Docker 就能跑,入口是 run_bench.py(不少自媒体写成 run.py,以官方 README 为准)。六步:pip 装依赖、写 .env 凭证(被测模型 key + judge key);docker build 构建框架镜像;冒烟跑单任务 T053 确认链路;--agents qwenpaw openclaw hermes 三框架横评,--model 可多选顺序评测;本地 npm run build:data 汇总日志再 npm run dev 起榜单站,矩阵、榜单、切片分析器、任务库四个视图随便看;结果归档成 submissions/*.json,按官网指引提交就能进榜单。
成本账很省:框架改了之后,只重跑目标切片就能验证有没有修到点子上,不用全量 4050 个单元。这是诊断型基准相对「跑分即结束」榜单的成本优势。五种官方玩法对应五个目标:选模型、选框架、调试框架、扩数据集、提交结果。
08 边界,以及五条可以直接搬走的结论
边界也要说清楚。v1.0 的框架只覆盖 3 款,Claude Code、Cursor Agent 等主流脚手架还在路线图上,结论外推要谨慎;150 道任务规模有限,open 环境与多模态任务待扩容;判卷依赖单一模型,方差校准在路上;切片数字是 27 个提交的宏平均,指方向,不指精确效应量。
抛开局限,这五条可以直接搬走:
1. 评测矩阵必须 model × harness 交叉:6.4 分的框架差距,足够把框架的锅甩给模型;2. 完成判定必须落到产物级证据:文件落盘、diff 生成、exit code 为零,模型汇报不算数;3. 总榜定交差,切片定改哪:总分只能定性,切片才能导航;4. 默认体验才是真实体验:fresh clone 跑不通,配齐 key 的理论上限没有意义;5.买模型看榜单,搭系统看框架:模型是下限,框架是方差。 ▲ 本篇金句
参考资料:PawBench 官方仓库 README(github.com/agentscope-ai/PawBench,中英文版)|PawBench 榜单站点(agentscope-ai.github.io/PawBench/)|v1.0 发布稿(2026-06-05,四项设计原则与 76.4/75.4/70.4 口径出处)|OpenJudge 官方文档 —— END ——